

We zetten de serie artikelen voort die gewijd zijn aan het onderzoeken van minder bekende manieren om de prestaties van "ogenschijnlijk eenvoudige" queries in PostgreSQL te verbeteren:
Denk niet dat ik zo'n hekel heb aan JOIN… 🙂
Maar vaak is de query zonder hem merkbaar sneller dan met hem. Daarom proberen we vandaag ons te ontdoen van de hulpbronintensieve JOIN — met behulp van een woordenboek.
Vanaf PostgreSQL 12 kunnen sommige van de onderstaande situaties iets anders worden weergegeven door . Dit gedrag kan worden teruggebracht naar het oude door de sleutel op te geven
MATERIALIZED.
Veel "feiten" over een beperkt woordenboek
Laten we een tamelijk praktische taak nemen — we moeten een lijst weergeven van of actieve taken met de afzenders:
25.01 | Ivanov I.I. | Beschrijving van het nieuwe algoritme voorbereiden.
22.01 | Ivanov I.I. | Artikel voor Habr schrijven: leven zonder JOIN.
20.01 | Petrov P.P. | Helpen bij het optimaliseren van de query.
18.01 | Ivanov I.I. | Artikel voor Habr schrijven: JOIN met inachtneming van gegevensdistributie.
16.01 | Petrov P.P. | Helpen bij het optimaliseren van de query.
In een abstracte wereld zouden de auteurs van taken gelijkmatig verdeeld moeten zijn over alle medewerkers van onze organisatie, maar in de werkelijkheid komen taken meestal van een vrij beperkt aantal mensen — "van het management" hogerop in de hiërarchie of "van collega's" uit aangrenzende afdelingen (analisten, ontwerpers, marketing, …).
Laten we aannemen dat er in onze organisatie van de 1000 mensen slechts 20 auteurs (vaak zelfs minder) taken voor elk specifiek uitvoerder indienen en , om de "traditionele" query te versnellen.
Script-generator
-- medewerkers
CREATE TABLE person AS
SELECT
  id
, repeat(chr(ascii('a') + (id % 26)), (id % 32) + 1) "name"
, '2000-01-01'::date - (random() * 1e4)::integer birth_date
FROM
  generate_series(1, 1000) id;

ALTER TABLE person ADD PRIMARY KEY(id);

-- taken met opgegeven verdeling
CREATE TABLE task AS
WITH aid AS (
  SELECT
    id
  , array_agg((random() * 999)::integer + 1) aids
  FROM
    generate_series(1, 1000) id
  , generate_series(1, 20)
  GROUP BY
    1
)
SELECT
  *
FROM
  (
    SELECT
      id
    , '2020-01-01'::date - (random() * 1e3)::integer task_date
    , (random() * 999)::integer + 1 owner_id
    FROM
      generate_series(1, 100000) id
  ) T
, LATERAL(
    SELECT
      aids[(random() * (array_length(aids, 1) - 1))::integer + 1] author_id
    FROM
      aid
    WHERE
      id = T.owner_id
    LIMIT 1
  ) a;

ALTER TABLE task ADD PRIMARY KEY(id);
CREATE INDEX ON task(owner_id, task_date);
CREATE INDEX ON task(author_id);
Laten we de laatste 100 taken voor een specifieke uitvoerder tonen:
SELECT
  task.*
, person.name
FROM
  task
LEFT JOIN
  person
    ON person.id = task.author_id
WHERE
  owner_id = 777
ORDER BY
  task_date DESC
LIMIT 100; 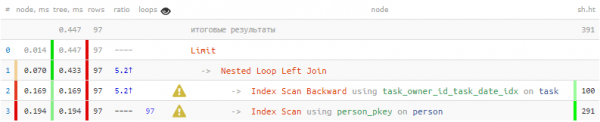
Het blijkt dat 1/3 van de totale tijd en 3/4 van de leestijd de gegevenspagina's zijn alleen gemaakt om 100 keer naar de auteur te zoeken - voor elke weergegeven taak. Maar we weten dat er onder deze honderd in totaal 20 verschillende — kunnen we deze kennis niet gebruiken?
hstore-woordenboek
Laten we het gebruiken om een 'woordenboek' sleutel-waarde te genereren:
CREATE EXTENSION hstoreHet enige wat we in het woordenboek moeten plaatsen, is de ID van de auteur en zijn naam, zodat we later op deze sleutel kunnen extraheren:
-- doelset selecteren
WITH T AS (
  SELECT
    *
  FROM
    task
  WHERE
    owner_id = 777
  ORDER BY
    task_date DESC
  LIMIT 100
)
-- woordenboek voor unieke waarden vormen
, dict AS (
  SELECT
    hstore( -- hstore(keys::text[], values::text[])
      array_agg(id)::text[]
    , array_agg(name)::text[]
    )
  FROM
    person
  WHERE
    id = ANY(ARRAY(
      SELECT DISTINCT
        author_id
      FROM
        T
    ))
)
-- verwante waarden van het woordenboek verkrijgen
SELECT
  *
, (TABLE dict) -> author_id::text -- hstore -> key
FROM
T; 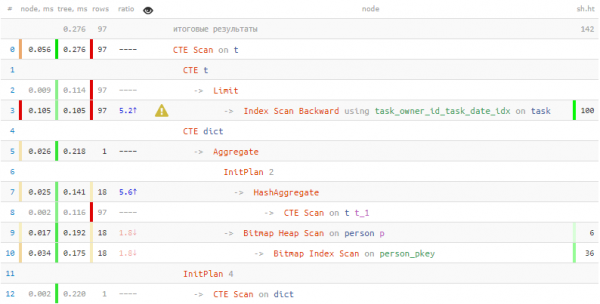
Voor het verkrijgen van informatie over personen is er twee keer minder tijd en zeven keer minder gegevens gelezen! Behalve 'woordenboeken', hebben deze resultaten ons ook geholpen met massale extractie van records uit de tabel in één enkele doorloop met behulp van = ANY(ARRAY(...)).
Tabelrecord: serialisatie en deserialisatie
Maar wat als we in het woordenboek niet één tekstveld, maar een hele record willen opslaan? In dat geval helpt PostgreSQL ons om met een tabelrecord als één enkele waarde te werken:
...
, dict AS (
  SELECT
    hstore(
      array_agg(id)::text[]
    , array_agg(p)::text[] -- magie #1
    )
  FROM
    person p
  WHERE
    ...
)
SELECT
  *
, (((TABLE dict) -> author_id::text)::person).* -- magie #2
FROM
  T;
Laten we ontleden wat hier eigenlijk gebeurde:
- We namen p als alias voor de volledige record van de tabel person en hebben we er een array van gemaakt.
- Deze array van records is omgezet in een array van tekstuele strings (person[]::text[]), zodat we het in een hstore-woordenboek kunnen plaatsen als een array van waarden.
- Bij het ophalen van de gerelateerde record hebben we deze uit het woordenboek gehaald op basis van de sleutel als een tekstuele string.
- We moeten de tekst omzetten naar een waarde van het type tabel person (voor elke tabel wordt automatisch een overeenkomstig type aangemaakt).
- We hebben het getypeerde record 'uitgeklapt' in kolommen met behulp van
(...).*.
json-woordenboek
Maar zo'n truc, zoals we hierboven hebben toegepast, werkt niet als er geen bijpassend tabeltype is om een 'cast' te maken. Een soortgelijke situatie zal zich ook voordoen als we als gegevensbron voor serialisatie proberen een CTE-string te gebruiken, in plaats van een 'echte' tabel..
In dit geval kunnen we gebruik maken van :
...
, p AS ( -- dit is al CTE
  SELECT
    *
  FROM
    person
  WHERE
    ...
)
, dict AS (
  SELECT
    json_object( -- nu is dit al json
      array_agg(id)::text[]
    , array_agg(row_to_json(p))::text[] -- en binnen json voor elke regel
    )
  FROM
    p
)
SELECT
  *
FROM
  T
, LATERAL(
    SELECT
      *
    FROM
      json_to_record(
        ((TABLE dict) ->> author_id::text)::json -- uit het woordenboek als json gehaald
      ) AS j(name text, birth_date date) -- vulde de benodigde structuur in
  ) j;
Het is belangrijk op te merken dat we bij het beschrijven van de doelsstructuur niet alle velden van de bronregels hoeven te vermelden, maar alleen de velden die we echt nodig hebben. Als we echter een 'native' tabel hebben, is het beter om de functie json_populate_record.
De toegang tot het woordenboek gebeurt nog steeds eenmaal, maar de kosten voor json-[de]serialisatie zijn behoorlijk hoog, daarom is het verstandig om deze methode alleen in bepaalde gevallen te gebruiken, wanneer een 'eerlijk' CTE-scan slechter presteert.
We testen de prestaties
Dus hebben we twee manieren om gegevens te serialiseren in een woordenboek — hstore / json_object. Naast dit kunnen de arrays van sleutels en waarden ook op twee manieren worden gegenereerd, met interne of externe conversie naar tekst: array_agg(i::text) / array_agg(i)::text[].
Laten we de efficiëntie van verschillende soorten serialisatie testen aan de hand van een puur synthetisch voorbeeld — we serialiseren verschillende aantallen sleutels:
WITH dict AS (
  SELECT
    hstore(
      array_agg(i::text)
    , array_agg(i::text)
    )
  FROM
    generate_series(1, ...) i
)
TABLE dict;
Schatting script: serialisatie
MET T ALS (
  SELECT
    *
  , (
      SELECT
        regexp_replace(ea[array_length(ea, 1)], '^Execution Time: (d+.d+) ms$', '1')::real et
      FROM
        (
          SELECT
            array_agg(el) ea
          FROM
            dblink('port= ' || current_setting('port') || ' dbname=' || current_database(), $$
              explain analyze
              WITH dict AS (
                SELECT
                  hstore(
                    array_agg(i::text)
                  , array_agg(i::text)
                  )
                FROM
                  generate_series(1, $$ || (1 << v) || $$) i
              )
              TABLE dict
            $$) T(el text)
        ) T
    ) et
  FROM
    generate_series(0, 19) v
  ,   LATERAL generate_series(1, 7) i
  ORDER BY
    1, 2
)
SELECT
  v
, avg(et)::numeric(32,3)
FROM
  T
GROUP BY
  1
ORDER BY
1; 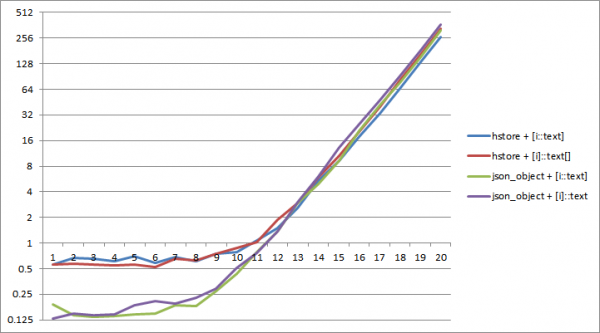
Op PostgreSQL 11 is het ongeveer tot de grootte van de woordenlijst in 2^12 sleutels. serialisatie naar json kost minder tijd.. De meest effectieve combinatie is json_object en een 'interne' typeconversie. array_agg(i::text).
Laten we nu proberen de waarde van elke sleutel 8 keer te lezen - als we de woordenlijst niet gebruiken, waarom hebben we deze dan?
Schatting script: lezen uit de woordenlijst.
MET T ALS (
  SELECT
    *
  , (
      SELECT
        regexp_replace(ea[array_length(ea, 1)], '^Execution Time: (d+.d+) ms$', '1')::real et
      FROM
        (
          SELECT
            array_agg(el) ea
          FROM
            dblink('port= ' || current_setting('port') || ' dbname=' || current_database(), $$
              explain analyze
              WITH dict AS (
                SELECT
                  json_object(
                    array_agg(i::text)
                  , array_agg(i::text)
                  )
                FROM
                  generate_series(1, $$ || (1 < (i % ($$ || (1 << v) || $$) + 1)::text
              FROM
                generate_series(1, $$ || (1 << (v + 3)) || $$) i
            $$) T(el text)
        ) T
    ) et
  FROM
    generate_series(0, 19) v
  , LATERAL generate_series(1, 7) i
  ORDER BY
    1, 2
)
SELECT
  v
, avg(et)::numeric(32,3)
FROM
  T
GROUP BY
  1
ORDER BY
1; 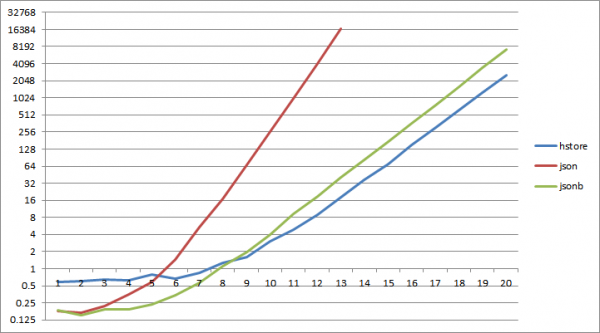
En... ongeveer. Bij 2^6 sleutels begint het lezen uit de json-woordenlijst aanzienlijk slechter te presteren. vergeleken met hstore; hetzelfde gebeurt met jsonb bij 2^9.
Conclusies:
- als je een JOIN moet maken met meerdere herhalingen. is het beter om de tabel te 'woordenlijsten'. Als je woordenlijst verwacht.
- klein is en je er niet veel uit zult lezen. kun je json[b] gebruiken. In alle andere gevallen.
- hstore + array_agg(i::text) zal efficiënter zijn. 🥇PostgreSQL Antipatterns: laten we met de woordenlijst een zware JOIN aanpakken | ProHoster
Bron: habr.com
