

Bij het opzetten van een Kubernetes-cluster kunnen vragen opkomen: hoeveel werkknopen moeten we instellen en welk type? Wat is beter voor een on-premise cluster: enkele krachtige servers kopen of een dozijn oude machines in uw datacenter gebruiken? En in de cloud, moeten we dan acht enkel-core of twee vier-core instanties nemen?
De antwoorden op deze vragen zijn te vinden in het artikel gepubliseerd door het team .
De capaciteit van het cluster
In het algemeen kan een Kubernetes-cluster worden beschouwd als een grote 'superknoop'. De totale rekenkracht is de som van de rekenkracht van alle componentknopen.
Er zijn verschillende manieren om de gewenste doelcapaciteit van het cluster te bereiken. Stel dat we een cluster nodig hebben met een totale capaciteit van 8 CPU-kernen en 32 GB RAM, omdat de applicatiebundel zoveel middelen vereist. Dan kunnen we twee knopen van 16 GB geheugen installeren of vier knopen van 8 GB geheugen, met twee vier-core processors of vier twee-core processors.
Hier zijn slechts twee mogelijke manieren om een cluster te creëren:
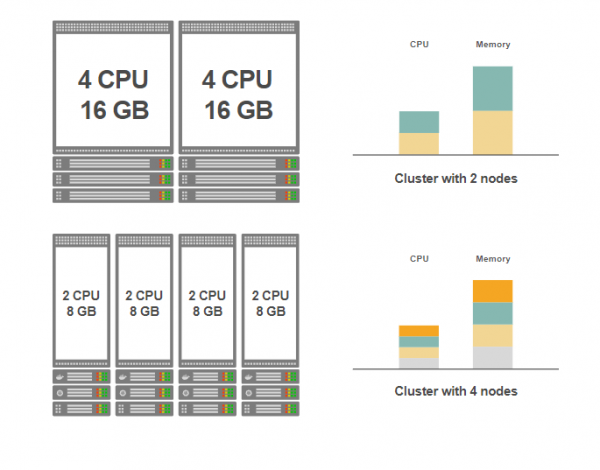
Beide opties geven een cluster met dezelfde capaciteit, maar in de onderste configuratie zijn er vier kleinere knopen geïnstalleerd, terwijl er in de bovenste configuratie twee grotere staan.
Welke optie is beter?
Om deze vraag te beantwoorden, laten we de voordelen van beide opties bekijken. We hebben ze in een tabel samengebracht.
Enkele grote knopen
Veel kleine knopen
Eenvoudiger clusterbeheer (als het on-premise is)
Vloeiende autoscaling
Goedkoper (als het on-premise is)
Prijs verschilt nauwelijks (in de cloud)
Kan middelenintensievere applicaties uitvoeren
Volledige replicatie
Middelen worden efficiënter gebruikt (minder overhead voor systeemdaemonen)
Hogere beschikbaarheid van het cluster
Let op dat we alleen over werkknopen spreken. De keuze van het aantal en de grootte van de hoofdknooppunten is een totaal ander onderwerp.
Laten we elk punt in de tabel nader bespreken.
Eerste optie: enkele grote knopen
De meest extreme optie is één werkknop voor de volledige capaciteit van het cluster. In het bovenstaande voorbeeld zou dit één werkknop zijn met 16 CPU-kernen en 16 GB RAM.
Voordelen
Pluspunt #1. Eenvoudiger beheer
Het is eenvoudiger om meerdere machines te beheren dan een hele vloot. Updates en patches sneller doorvoeren en eenvoudiger synchroniseren. Het aantal storingen in absolute cijfers is ook lager.
Houd er rekening mee dat alles wat hierboven is gezegd betrekking heeft op je eigen hardware, je eigen servers, en niet op cloud-instanties.
In de cloud is de situatie anders. Daar wordt het beheer uitgevoerd door de cloudprovider. Dus het beheren van tien knooppunten in de cloud verschilt niet veel van het beheren van één knooppunt.
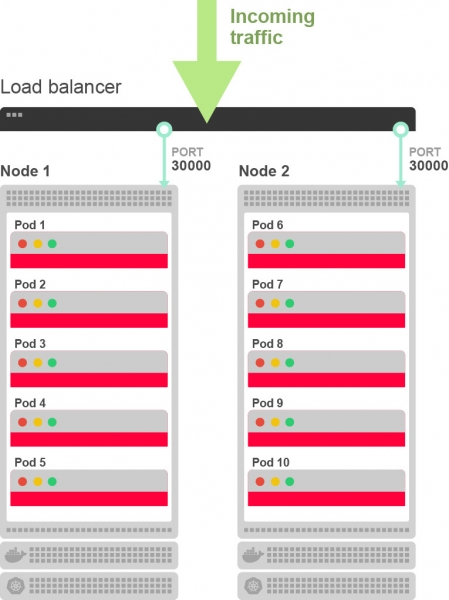
Het routeren van verkeer en het verdelen van de belasting tussen pods in de cloud : binnenkomend verkeer van het internet wordt naar de hoofd-loadbalancer gestuurd, die het verkeer naar de poort van een van de knooppunten leidt (de NodePort-service stelt een poort in het bereik van 30000-32767 in op elk knooppunt van de cluster). De regels die door kube-proxy zijn ingesteld, leiden het verkeer van het knooppunt naar de pod. Zo ziet het eruit voor tien pods op twee knooppunten:
Plus #2. Lagere kosten per knooppunt
Een krachtige machine is duurder, maar de prijsstijging is niet noodzakelijk lineair. Met andere woorden, één tienkernige server met 10 GB geheugen is meestal goedkoper dan tien enkelkernige met hetzelfde aantal geheugen.
Maar let op dat deze regel meestal niet geldt voor cloudservices. In de huidige prijsmodellen stijgen de prijzen bij alle grote cloudproviders lineair met de capaciteit.
Daarom is het in de cloud meestal niet mogelijk om te besparen op krachtigere servers.
Plus #3. Je kunt resource-intensieve applicaties draaien
Sommige applicaties vereisen krachtige servers in de cluster. Als een machine learning-systeem bijvoorbeeld 8 GB geheugen nodig heeft, kun je het niet draaien op knooppunten met 1 GB, maar alleen als er ten minste één grote werkknop beschikbaar is.
Nadelen
Minpunt #1. Veel pods op één knooppunt
Als dezelfde taak op een kleiner aantal knooppunten wordt uitgevoerd, zullen er vanzelfsprekend meer pods op elk van hen zijn.
Dit kan problematisch worden.
De reden hiervoor is dat elke module enige overhead met zich meebrengt voor de container runtime-omgeving (bijvoorbeeld Docker), evenals kubelet en cAdvisor.
Bijvoorbeeld, kubelet controleert regelmatig de levensvatbaarheid van alle containers op het knooppunt – hoe meer containers, hoe meer werk voor kubelet.
CAdvisor verzamelt statistieken over het gebruik van bronnen van alle containers op de node, terwijl kubelet deze informatie regelmatig opvraagt en via de API beschikbaar stelt. Nogmaals, hoe meer containers, hoe meer werk voor zowel cAdvisor als kubelet.
Als het aantal modules toeneemt, kan dit het systeem vertragen en zelfs de betrouwbaarheid aantasten.
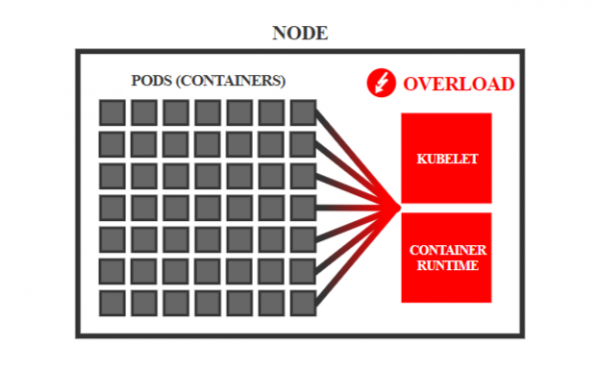
In de Kubernetes-repository hebben sommigen , dat nodes tussen de status Ready/NotReady springen, omdat de reguliere controles van kubelet op alle containers op de node te veel tijd in beslag nemen.
Om deze reden . Afhankelijk van de prestaties van de node, kunt u meer pods per node draaien, maar het is moeilijk te voorspellen of er problemen optreden of dat alles goed zal werken. Het is verstandig om dit van tevoren te testen.
Minpunt nummer 2. Beperking van replicatie
Een te klein aantal nodes beperkt de effectieve replicatiegraad van applicaties. Bijvoorbeeld, als u een applicatie met hoge beschikbaarheid heeft van vijf replicas, maar slechts twee nodes, dan vermindert de effectieve replicatiegraad van de applicatie tot twee.
Vijf replicas kunnen alleen over twee nodes worden verdeeld, en als een van hen uitvalt, gaan er onmiddellijk meerdere replicas verloren.
Als je vijf of meer nodes hebt, zal elke replica op een aparte node draaien, en de storing van een node zorgt ervoor dat er niet meer dan één replica wordt verwijderd.
Daarom kunnen de eisen voor hoge beschikbaarheid een bepaald minimumaantal nodes in het cluster vereisen.
Minpunt nummer 3. Slechtere gevolgen van falen
Bij een klein aantal nodes heeft elke storing ernstigere gevolgen. Als u bijvoorbeeld maar twee nodes hebt en een van hen uitvalt, verliest u meteen de helft van uw modules.
Natuurlijk zal Kubernetes de belasting van de defecte node naar andere nodes verplaatsen. Maar als er maar weinig zijn, kan de beschikbare capaciteit ontoereikend zijn. Als gevolg hiervan zullen sommige van uw applicaties niet beschikbaar zijn totdat u de defecte node opnieuw opstart.
Hoe meer nodes er zijn, hoe minder impact hardwarestoringen hebben.
Minpunt nummer 4. Grotere stappen in autoscaling
In Kubernetes, there is an automatic cluster scaling system for cloud infrastructure that allows for the automatic addition or removal of nodes based on current needs. With larger nodes, scaling becomes more abrupt and clumsy. For example, adding an additional node to a two-node setup increases the cluster capacity by 50% immediately. You will have to pay for these resources even if they're not needed.
Thus, if you plan to use automatic cluster scaling, the smaller the nodes, the more flexible and cost-effective your scaling will be.
Now let's consider the advantages and disadvantages of having many small nodes.
The second option: many small nodes
The advantages of this approach essentially stem from the disadvantages of the opposite option with several large nodes.
Voordelen
Advantage No. 1. Lower impact of failure
The more nodes there are, the fewer pods on each node. For example, if you have one hundred modules across ten nodes, then on each node there will be an average of ten modules.
Thus, if one of the nodes goes down, you only lose 10% of the workload. There’s a chance that only a small number of replicas will be affected, and the applications overall will remain operational.
Moreover, the remaining nodes will likely have enough free resources for the workload of the failed node, so Kubernetes can freely reschedule the pods, and your applications will return to a functional state relatively quickly.
Advantage No. 2. Good replication
If there are enough nodes, the Kubernetes scheduler can assign different nodes to all replicas. Thus, in the event of a node failure, only one replica will be affected, and the application will remain accessible.
Nadelen
Disadvantage No. 1. More difficult management
Managing a large number of nodes is more challenging. For example, each Kubernetes node must interact with all the others, meaning the number of connections grows quadratically, and all those connections must be monitored.
The node controller in the Kubernetes controller manager regularly checks the health of all nodes in the cluster — the more nodes there are, the greater the load on the controller.
The load on the etcd database also increases — every kubelet and kube-proxy calls voor etcd (via API), waarnaar etcd objectupdates moet vertalen.
Over het algemeen legt elke werkende node extra belasting op de systeemcomponenten van de hoofdknopen.
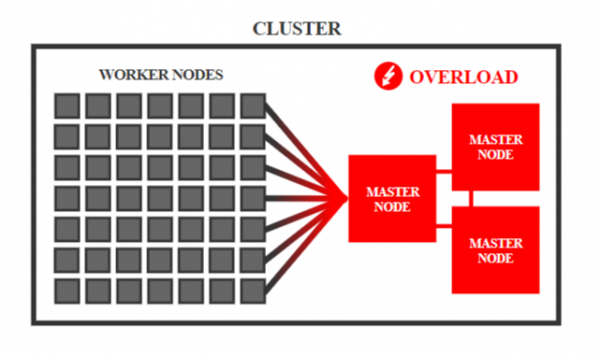
Officieel ondersteunt Kubernetes clusters met Echter, in de praktijk kunnen al 500 knopen .
Voor het beheer van een groot aantal werkende knopen moeten krachtigere hoofdknopen worden gekozen. Bijvoorbeeld, kube-up de juiste VM-grootte voor de hoofdknop afhankelijk van het aantal werkende knopen. Dit betekent dat hoe meer werkende knopen, hoe krachtiger de hoofdknopen moeten zijn.
Om deze specifieke problemen op te lossen, zijn er speciale ontwikkelingen, zoals Dit systeem maakt het mogelijk om beperkingen te omzeilen en clusters te bouwen met een enorm aantal werkende knopen.
Nadeel #2. Meer overhead.
Op elke werkende node draait Kubernetes een reeks systeemdaemonen - dit omvat een container-runtime (zoals Docker), kube-proxy en kubelet, inclusief cAdvisor. Samen verbruiken ze een bepaalde vaste hoeveelheid middelen.
Als je veel kleine knopen hebt, is het aandeel van deze overhead per node groter. Stel je bijvoorbeeld voor dat alle systeemdaemonen van één node samen 0,1 CPU-kern en 0,1 GB geheugen gebruiken. Als je één deca-core node met 10 GB geheugen hebt, verbruiken de daemon 1% van de clustercapaciteit. Aan de andere kant, op tien single-core knopen met elk 1 GB geheugen, nemen de daemon 10% van de clustercapaciteit in beslag.
Dus, hoe minder knopen, hoe efficiënter de infrastructuur wordt benut.
Nadeel #3. Inefficiënt gebruik van middelen.
Op kleine knopen kan het voorkomen dat de resterende fragmenten van middelen te klein zijn om enige werklast aan toe te wijzen, waardoor ze ongebruikt blijven.
Bijvoorbeeld, elke pod heeft 0,75 GB geheugen nodig. Als je tien knopen hebt en elke node 1 GB geheugen heeft, kun je tien pod’s draaien - uiteindelijk blijft er 0,25 GB ongebruikt geheugen op elke node.
Dit betekent dat 25% van het geheugen van de totale cluster nutteloos wordt besteed.
Op een grote node met 10 GB geheugen kun je 13 van dergelijke modules draaien - en dan blijft er slechts één ongebruikte fragment van 0,25 GB over.
In dit geval wordt slechts 2,5% van het geheugen verspild.
Op deze manier worden resources efficiënter gebruikt op grote knooppunten.
Meerdere grote knooppunten of veel kleine?
Wat is beter: meerdere grote knooppunten in een cluster of veel kleine? Zoals altijd is er geen eenduidig antwoord. Veel hangt af van het type applicatie.
Bijvoorbeeld, als een applicatie 10 GB geheugen nodig heeft, is de keuze voor grote knooppunten overduidelijk. Maar als de applicatie tienvoudige replicatie voor hoge beschikbaarheid vereist, is het onwaarschijnlijk dat het verstandig is om replica's op slechts twee knooppunten te plaatsen — er moeten minimaal tien knooppunten in het cluster zijn.
In tussenliggende situaties moet je kiezen op basis van de voor- en nadelen van elk alternatief. Misschien zijn sommige argumenten relevanter voor jouw situatie dan andere.
Het is helemaal niet nodig om alle knooppunten dezelfde grootte te geven. Niets staat je in de weg om eerst met knooppunten van dezelfde grootte te experimenteren en daarna knooppunten van andere grootte toe te voegen, waardoor je ze in het cluster combineert. Werkende knooppunten in een Kubernetes-cluster kunnen volledig heterogeen zijn. Dus je kunt proberen de voordelen van beide benaderingen te combineren.
Er bestaat geen universeel recept, en elke situatie heeft zijn eigen nuances, alleen de productie zal de waarheid onthullen.
Vertaling verzorgd door het cloudplatformteam. .
Meer over Kubernetes: .
Bron: habr.com
