

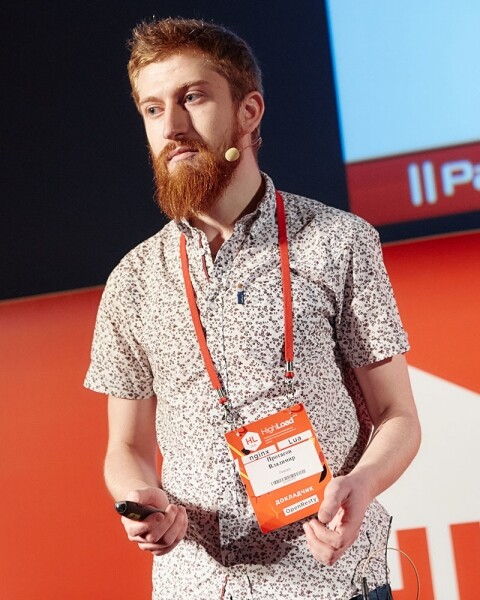
 We publiceren opnieuw de transcriptie van de presentatie op de conferentie 2016, die plaatsvond in het Moskouse Skolkovo van 7 tot 8 november vorig jaar. legt uit hoe je de functionaliteit van NGINX kunt uitbreiden met OpenResty en Lua.
Hallo allemaal, mijn naam is Vladimir Protasov, ik werk bij Parallels. Ik vertel jullie iets over mezelf. Drie kwart van mijn leven schrijf ik code. Ik ben letterlijk tot op het bot een programmeur: soms zie ik code zelfs in mijn dromen. Een kwart van mijn leven - industriële ontwikkeling, schrijven van code die direct in productie gaat. Code waar sommigen van jullie gebruik van maken, zonder het te beseffen.
Om je te laten begrijpen hoe erg het was. Toen ik een kleine junior was, kwam ik binnen en kreeg ik zulke twee terabyte databases. Iedereen heeft hier nu highload. Ik ging naar conferenties, vroeg: "Hé guys, vertel, jullie hebben big data, dat is geweldig? Hoeveel data hebben jullie in jullie databases?" Ze antwoordden: "Wij hebben 100 gigabyte!" Ik zei: "Wauw, 100 gigabyte!" Maar dacht bij mezelf, hoe houd ik mijn pokerface in stand. Je denkt, ja, die gasten zijn geweldig, en daarna ga je terug en blijf je rommelen met die multiterabyte databases. En dat als junior. Kun je je voorstellen hoe hard dat is?
Ik spreek meer dan 20 programmeertalen. Dat is iets wat ik moest leren tijdens mijn werk. Je krijgt code op Erlang, C, C++, Lua, Python, Ruby, en nog meer, en je moet daarmee aan de slag. Kortom, dat moest ik. Het exacte aantal kon ik nog steeds niet tellen, maar ik ben ergens rond de 20 het overzicht kwijtgeraakt.
Aangezien iedereen hier weet wat Parallels is en wat we doen, ga ik niet vertellen hoe geweldig we zijn en wat we doen. Ik zal alleen zeggen dat we 13 kantoren wereldwijd hebben, meer dan 300 medewerkers, en ontwikkeling in Moskou, Tallinn en Malta. Als je wilt, kun je naar Malta verhuizen, als het in de winter koud is en je de warmte wilt opzoeken.
Specifiek schrijft onze afdeling in Python 2. We doen zaken en hebben geen tijd om trendy technologieën te implementeren, dus we lijden. We hebben Django, omdat daarin alles zit, en het overbodige hebben we eruit gegooid. Ook MySQL, Redis en NGINX. Verder hebben we veel andere geweldige dingen. We hebben MongoDB, we hebben konijnen die rondrennen, we hebben van alles - maar dat is niet mijn deel, en daar houd ik me niet mee bezig.
OpenResty
Ik heb iets over mezelf verteld. Laten we kijken waar ik het vandaag over ga hebben:
- Wat is OpenResty en hoe werkt het?
- Waarom nog een fiets uitvinden als we Python, NodeJS, PHP, Go en andere geweldige dingen hebben waar iedereen tevreden mee is?
- En een paar voorbeelden uit het leven. Ik moest mijn presentatie sterk inkorten omdat deze 3,5 uur duurde, dus er zullen niet veel voorbeelden zijn.
OpenResty is NGINX. Dankzij dit hebben we een volwaardige webserver die goed geschreven is, hij werkt snel. Ik denk dat de meesten van ons NGINX in productie gebruiken. Iedereen weet dat het snel en geweldig is. Het heeft coole synchronisatie invoer/uitvoer, dus we hoeven niets zelf te bouwen zoals we in Python met gevent hebben gedaan. Gevent is geweldig, maar als je C-code schrijft en er gaat iets mis, word je gek van het debuggen met gevent. Ik heb het zo meegemaakt: het kostte me twee dagen om uit te zoeken wat er mis was gegaan. Als iemand niet weken had geknutseld, het probleem niet had gevonden en online had geschreven, en Google het niet had ontdekt, zouden we echt gek geworden zijn.
NGINX heeft al caching en statische content ingebouwd. Je hoeft je geen zorgen te maken over hoe je dit op een menselijke manier doet, zodat het ergens niet vertraagt of je ergens descriptors verliest. Nginx is erg eenvoudig te implementeren, je hoeft je niet af te vragen wat je moet kiezen - WSGI, PHP-FPM, Gunicorn, Unicorn. Nginx wordt geïnstalleerd, aan de beheerders gegeven, zij weten hoe ze ermee moeten werken. Nginx verwerkt aanvragen gestructureerd. Daarover zal ik later iets meer vertellen. In het kort heeft het een fase waarin het de aanvraag heeft ontvangen, wanneer het deze heeft verwerkt en wanneer het de content aan de gebruiker heeft gegeven.
Nginx is geweldig, maar er is één probleem: het is niet flexibel genoeg, zelfs met al die geweldige functies die de jongens in de configuratie hebben gestopt, hoewel het configureerbaar is. Deze kracht reikt niet ver genoeg. Daarom hebben de jongens van Taobao ooit, geloof ik, acht jaar geleden, Lua ingebouwd. Wat brengt dat?
- Grootte. Het is klein. LuaJIT heeft ongeveer 100-200 kilobyte overhead qua geheugen en een minimale overhead qua prestaties.
- Snelheid. De LuaJIT-interpreter is in veel situaties dicht bij C, in sommige situaties verliest het van Java, en in andere situaties wint het. Een tijdlang werd het beschouwd als state of the art, de beste JIT-compiler. Nu zijn er coolere, maar die zijn erg zwaar, zoals V8. Sommige JS-interpreters en de Java HotSpot zijn op sommige punten sneller, maar op andere plaatsen verliezen ze nog steeds.
- Gemak van gebruik. Stel dat je codebase in Perl is en je bent geen Booking, dan vind je geen Perl-programmeurs. Omdat ze er niet zijn, zijn ze allemaal weg, en het kost veel tijd en moeite om ze op te leiden. Als je programmeurs in iets anders wilt, moet je ze misschien ook omtrainen of vinden. Bij Lua is het eenvoudig. Lua kan iedere junior in drie dagen leren. Ik had ongeveer twee uur nodig om het te begrijpen. Na twee uur schreef ik al code in productie. Ongeveer een week later kwam het al in productie.
Dit is hoe het eruit ziet:
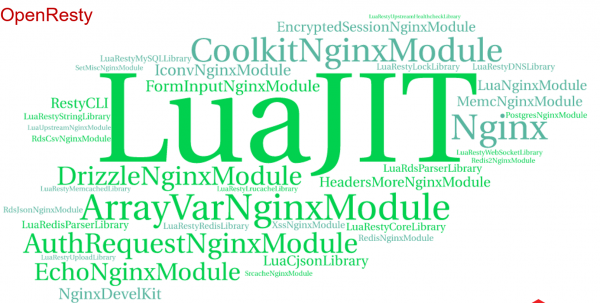
Er is veel gaande. In OpenResty hebben ze een heleboel modules verzameld, zowel van Lua als van EngineX. En alles is klaar - je deplooit het en het werkt.
Voorbeelden
Genug met de poëzie, laten we naar de code gaan. Hier is een klein Hello World:
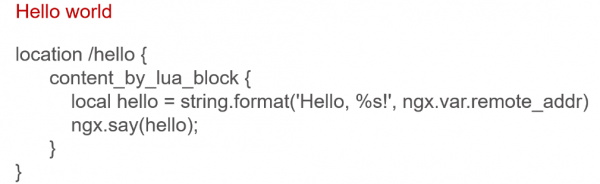
Wat staat hier? Dit is een EngineX-locatie. We maken ons geen zorgen, we schrijven onze eigen routing niet, we nemen geen kant-en-klare oplossing - we hebben al wat in NGINX, we leven goed en lui.
content_by_lua_block is een blok dat aangeeft dat we content leveren met behulp van een Lua-script. We nemen de EngineX-variabele remote_addr en voegen deze in string.format. Dit is precies hetzelfde als sprintf, alleen in Lua, alleen correct. En we sturen het naar de klant.
Dit zal er als volgt uitzien:
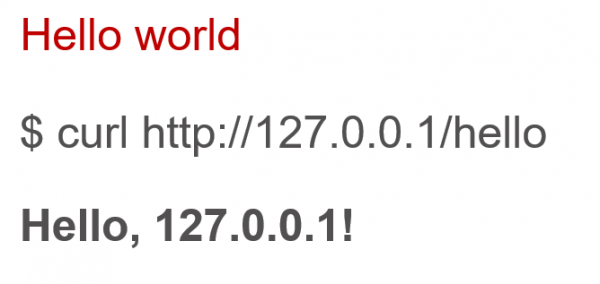
Maar laten we teruggaan naar de echte wereld. In productie deploiten we nooit Hello World. Onze applicatie maakt meestal verbinding met een database of ergens anders en wacht het grootste deel van de tijd op een antwoord.
Het zit gewoon te wachten. Dit is niet ideaal. Wanneer 100.000 gebruikers binnenkomen, wordt het erg moeilijk voor ons. Dus laten we een eenvoudig voorbeeld maken van een applicatie. We gaan afbeeldingen zoeken, bijvoorbeeld van katten. Maar we gaan niet zomaar zoeken, we gaan zoekwoorden uitbreiden, en als de gebruiker zoekt naar 'kitten', dan zoeken we naar katten, fluffy's en dergelijke. Allereerst moeten we de querygegevens op de backend ophalen. Het ziet er zo uit:
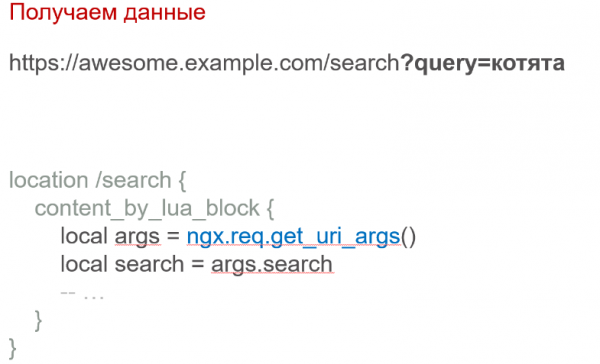
Met twee regels kun je de GET-parameters ophalen, geen moeilijkheden. Daarna halen we, bijvoorbeeld, via een SQL-query deze informatie uit een database met een tabel voor zoekwoorden en extensies. Heel eenvoudig. Dit is hoe het eruit ziet:
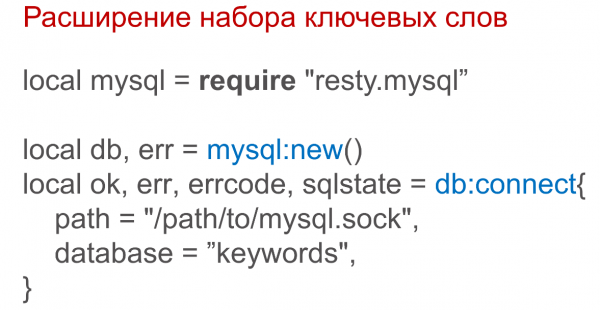
We verbinden de bibliotheek resty.mysql, die we al in het pakket hebben. We hoeven niets te installeren, alles is klaar. We geven aan hoe te verbinden en doen de SQL-query:
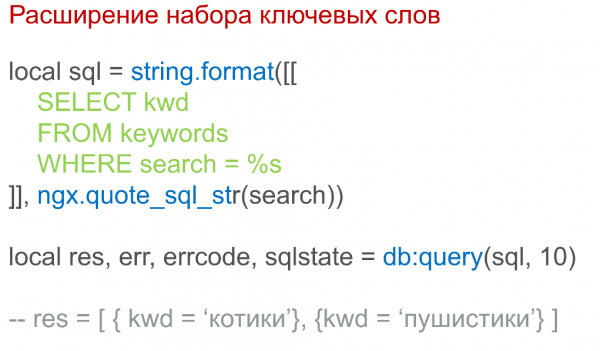
Het is hier een beetje eng, maar alles werkt. Hier is 10 - dat is de limiet. We halen 10 records op, we zijn lui, we willen niet meer laten zien. Ik ben vergeten over de limiet in SQL.
Daarna vinden we afbeeldingen op alle verzoeken. We verzamelen een stapel verzoeken en vullen een Lua-tabel in die heet reqs, en we doen ngx.location.capture_multi.
Alle deze verzoeken gaan parallel, en we krijgen antwoorden terug. De verwerkingstijd is gelijk aan de responstijd van de traagste. Als alles binnen 50 milliseconden terugkomt en we hebben honderd verzoeken verzonden, dan krijgen we het antwoord na 50 milliseconden.
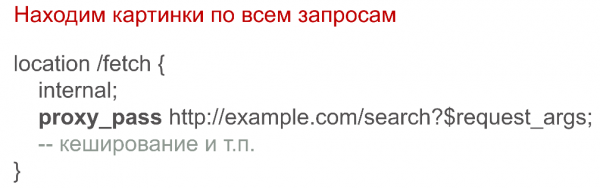
Omdat we lui zijn en geen HTTP-verwerking en caching willen schrijven, laten we NGINX alles voor ons doen. Zoals je hebt gezien, was er een verzoek naar url/fetch, dat is het:
We doen een simpele proxy_pass, geven aan waar we moeten cachen, hoe dit te doen, en dan werkt alles.
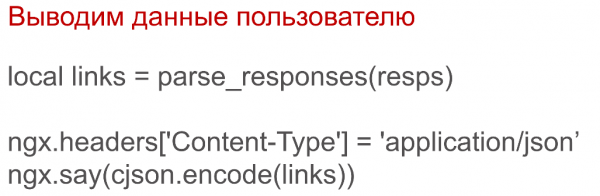
Maar dat is niet genoeg, we moeten ook de gegevens aan de gebruiker teruggeven. Het simpelste idee is om alles in JSON te serialiseren, eenvoudig, in twee regels. Geef de Content-Type terug, geef JSON terug.
Maar er is één complicatie: de gebruiker wil geen JSON lezen. We moeten front-end ontwikkelaars erbij betrekken. Soms willen we dit in eerste instantie niet doen. En zoekmachine optimalisatoren zullen zeggen dat als we afbeeldingen zoeken, het hen niet uitmaakt. Maar als we hen bepaalde inhoud geven, zullen ze zeggen dat zoekmachines niets indexeren.
Wat doen we hiermee? Uiteraard geven we HTML aan de gebruiker terug. Handmatig genereren is niet ideaal, dus willen we sjablonen gebruiken. Hiervoor is er een bibliotheek lua-resty-template.
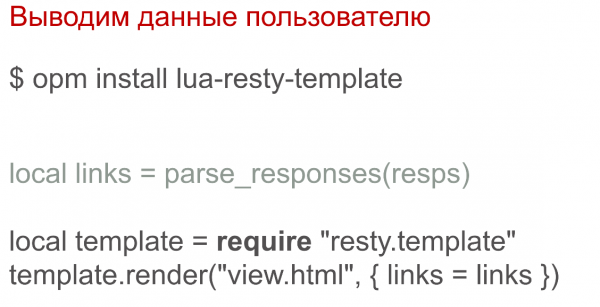
Jullie hebben misschien de drie enge letters OPM gezien. OpenResty komt met zijn eigen pakketbeheerder waarmee je nog veel andere modules kunt installeren, in het bijzonder lua-resty-template. Dit is een eenvoudige sjabloonmotor, vergelijkbaar met Django-sjablonen. Je kunt code schrijven en variabelen substitueren.
Het resultaat zal er ongeveer zo uitzien:
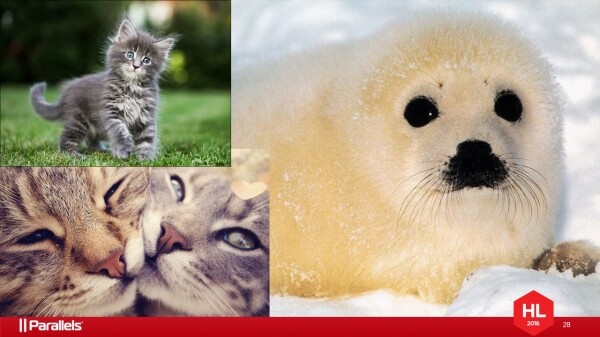
We hebben de gegevens gepakt en het sjabloon opnieuw gerenderd in twee regels. De gebruiker is gelukkig, hij heeft kittens gekregen. Aangezien we de zoekopdracht hebben uitgebreid, kreeg hij naast de kittens ook een zeeleeuw. Je weet maar nooit, misschien zocht hij precies die, maar kon hij zijn verzoek niet correct formuleren.
Alles is geweldig, maar we zijn in de ontwikkeling en willen nog niet dat gebruikers het zien. Laten we authenticatie implementeren. Om dit te doen, laten we eens kijken hoe NGINX het verzoek afhandelt in termen van OpenResty:
- De eerste fase - access, wanneer de gebruiker net is aangekomen, en we hem hebben bekeken aan de hand van de kopteksten, het IP-adres, en andere gegevens. We kunnen hem meteen uitschakelen als hij ons niet bevalt. Dit kan worden gebruikt voor autorisatie, of als we veel verzoeken binnenkrijgen, kunnen we deze gemakkelijk in deze fase blokkeren.
- rewrite. We herschrijven enkele gegevens van het verzoek.
- content. We geven de inhoud terug aan de gebruiker.
- headers filter. We kunnen de antwoordheaders aanpassen. Als we
proxy_pass, kunnen we enkele headers herschrijven voordat we deze aan de gebruiker geven. - body filter. We kunnen de body aanpassen.
- log — logging. We kunnen logboeken schrijven in elasticsearch zonder een extra laag.
Onze autorisatie zal er ongeveer zo uitzien:
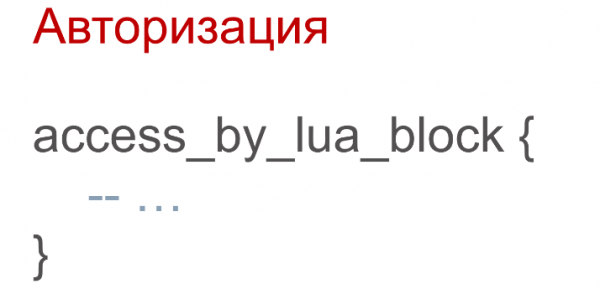
We voegen dit toe in de locatie, die we eerder hebben beschreven, en stoppen er deze code in:
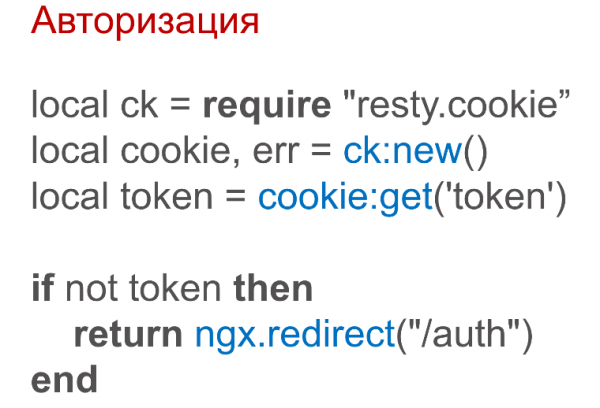
We kijken of we een cookie token hebben. Als dat niet het geval is, sturen we naar de autorisatie. Gebruikers zijn slim en kunnen raden dat ze een cookie token moeten instellen. Daarom leggen we deze ook in Redis:
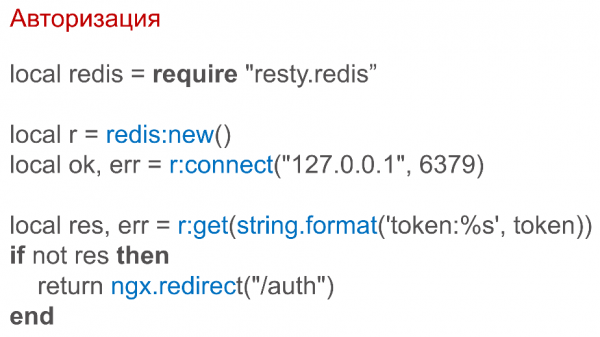
De code voor het werken met Redis is erg eenvoudig en verschilt niet van andere talen. Bovendien zijn alle invoer/uitvoer daar en hier niet-blokkerend. Als je synchrone code schrijft, werkt het asynchroon. Ongeveer zoals met gevent, alleen dan goed gedaan.
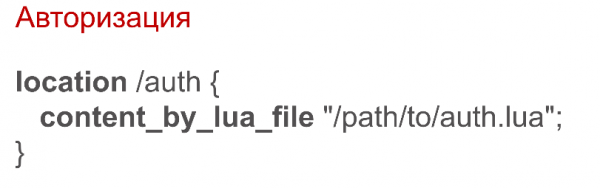
Laten we de autorisatie zelf gaan doen:
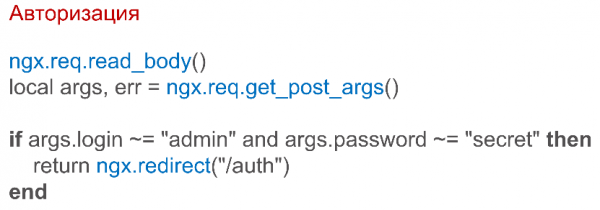
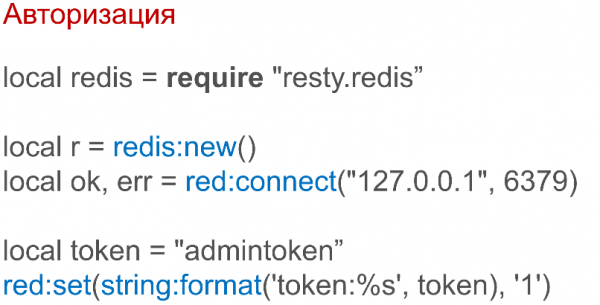
We geven aan dat we de body van het verzoek moeten lezen. We ontvangen de POST-argumenten, controleren of de gebruikersnaam en het wachtwoord correct zijn. Als ze onjuist zijn, sturen we naar de autorisatie. En als ze correct zijn, schrijven we de token in Redis:
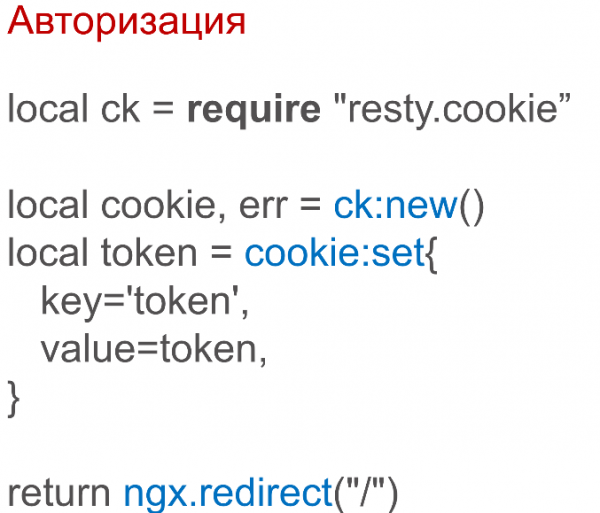
Vergeet niet de cookie in te stellen, dit kan ook in twee regels worden gedaan:
Voorbeeld is eenvoudig en theoretisch. We zullen natuurlijk geen service creëren die mensen katten laat zien. Maar wie weet. Laten we dus eens kijken naar wat we in productie kunnen doen.
- Minimalistische backend. Soms moeten we de backend een klein beetje gegevens geven: waar we ergens een datum moeten invullen, ergens een lijst moeten tonen, moeten zeggen hoeveel gebruikers momenteel op de site zijn, een teller of statistiek moeten koppelen. Gewoon iets kleins. Minimale stukjes kunnen heel gemakkelijk worden gemaakt. Dit zal snel, eenvoudig en geweldig zijn.
- Voorbewerking van gegevens. Soms willen we reclame in onze pagina inbouwen, en deze reclame halen we via API-aanroepen. Dit is heel eenvoudig hier te doen. We belasten onze backend niet, die al hard aan het werk is. We kunnen alles hier samenstellen. We kunnen wat JS samenvoegen of, omgekeerd, splitsen, en iets preprocessen voordat we het aan de gebruiker geven.
- Facade voor de microservice. Dit is ook een heel goede case, ik heb het geïmplementeerd. Hiervoor werkte ik bij Tenzor, dat zich bezighoudt met elektronische rapportages en de rapportage voor ongeveer de helft van de rechtspersonen in het land verzorgt. We hebben een service gemaakt waarbij veel dingen zijn gedaan met hetzelfde mechanisme: routering, autorisatie en meer.
OpenResty kan worden gebruikt als lijm voor uw microservices, die een uniforme toegang en interface biedt. Aangezien microservices zo kunnen worden geschreven dat je hier Node.js hebt, daar PHP, hier Python, en daar iets op Erlang, begrijpen we dat we niet dezelfde code overal willen herschrijven. Daarom kan OpenResty aan de voorkant worden gezet. - Statistieken en analyse. Gewoonlijk staat NGINX aan de voorkant en gaan alle aanvragen via hem. Juist op deze plek is het heel handig om iets te verzamelen. Je kunt iets meteen berekenen en ergens naartoe sturen, bijvoorbeeld naar Elasticsearch, Logstash of gewoon in een log schrijven en het later ergens naartoe sturen.
- Multiplayer systemen. Bijvoorbeeld, online games zijn ook heel goed te maken. Vandaag in Kaapstad zal Alexander Gladys vertellen hoe je snel een multiplayer spel kunt prototypen met behulp van OpenResty.
- Aanvraagfiltering (WAF). Het is tegenwoordig trendy om allerlei webapplicatiefirewalls te maken, er zijn veel diensten die deze aanbieden. Met OpenResty kun je je eigen webapplicatiefirewall maken, die eenvoudig en snel aanvragen kan filteren volgens jouw vereisten. Als je Python hebt, begrijp je dat PHP zeker niet geïnjecteerd kan worden, tenzij je het ergens vanuit de console spawnt. Je weet dat je MySQL en Python hebt. Waarschijnlijk kunnen ze hier proberen een soort directory traversal te maken en iets in de database te injecteren. Daarom kun je verdachte aanvragen snel en goedkoop direct aan de voorkant filteren.
- Gemeenschap. Omdat OpenResty is gebouwd op basis van NGINX, heeft het een bonus – dit is NGINX-gemeenschapHet is erg groot, en een aanzienlijk deel van de vragen die je in het begin zult hebben, zijn al opgelost door de NGINX-gemeenschap.
Lua-ontwikkelaarsGisteren sprak ik met de jongens die naar de HighLoad++ opleidingsdag kwamen en hoorde ik dat alleen Tarantool in Lua is geschreven. Dat is niet waar, er is veel meer in Lua geschreven. Voorbeelden: OpenResty, XMPP-server Prosody, game engine Love2D, Lua is gescript in Warcraft en op andere plaatsen. Er zijn veel Lua-ontwikkelaars, ze hebben een grote en responsieve community. Al mijn vragen over Lua werden binnen een paar uur beantwoord. Wanneer je naar de mailinglijst schrijft, krijg je letterlijk binnen enkele minuten een heleboel antwoorden, waarin wordt uitgelegd wat en hoe, wat welk. Dat is echt geweldig. Helaas is het niet overal zo'n vriendelijke en behulpzame community.
Er is een GitHub voor OpenResty, waar je een issue kunt aanmaken als er iets kapot is. Er is een mailinglijst op Google Groups, waar algemene vragen besproken kunnen worden, en er is een mailinglijst in het Chinees — wie weet, misschien beheers je geen Engels, maar heb je enige kennis van het Chinees.
Conclusies
- Ik hoop dat ik heb overgebracht dat OpenResty een zeer handige framework is, gericht op web.
- Het heeft een lage instapdrempel, omdat de code lijkt op wat we schrijven, de taal is behoorlijk eenvoudig en minimalistisch.
- Het biedt asynchrone I/O zonder callbacks, we zullen geen spaghetti-code hebben zoals we soms in NodeJS kunnen schrijven.
- Het heeft een eenvoudige implementatie, omdat we alleen NGINX met de benodigde module en onze code nodig hebben, en dan werkt alles meteen.
- Een grote en responsieve gemeenschap.
Ik heb niet in detail verteld hoe de routering werkt, dat zou een erg lang verhaal zijn geworden.
Bedankt voor uw aandacht!
Bron: habr.com
