

Wanneer je werk het creëren van iets moois is, hoeft daar eigenlijk niet veel over gezegd te worden, want het resultaat spreekt voor zichzelf. Maar als je teksten van muren afveegt, merkt niemand je werk op, zolang de muren er netjes uitzien of totdat je iets ongepast wegveegt.
Elke dienst waar je een opmerking, beoordeling, bericht kunt achterlaten of afbeeldingen kunt uploaden, krijgt vroeg of laat te maken met problemen zoals spam, fraude en onbehoorlijke inhoud. Dit is onvermijdelijk, maar we moeten er wel tegen vechten.
Mijn naam is Michail, ik werk in het Antispam-team dat gebruikers van Yandex-diensten beschermt tegen dergelijke problemen. Ons werk is vaak niet zichtbaar (en dat is goed!), daarom zal ik er vandaag meer over vertellen. Je zult leren in welke gevallen moderatie nutteloos is en waarom nauwkeurigheid niet de enige maatstaf is voor de effectiviteit ervan. We zullen ook over scheldwoorden praten aan de hand van katten en honden en waarom het soms nuttig is om 'te denken als een schelderaar'.
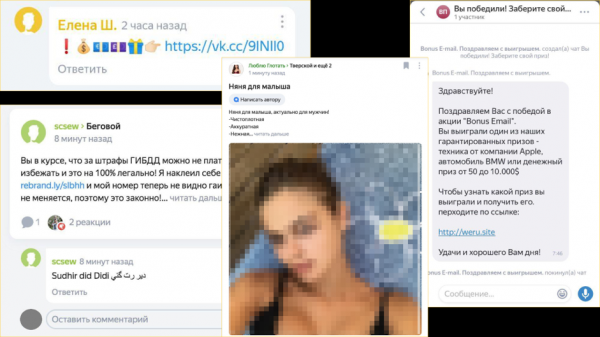
Er komen steeds meer diensten bij Yandex waar gebruikers hun inhoud publiceren. Je kunt vragen stellen of antwoorden geven op Yandex.Q, buurtnieuws bespreken op Yandex.District en verkeerssituaties delen in gesprekken op Yandex.Maps. Maar zodra het publiek van de dienst groeit, wordt het aantrekkelijk voor oplichters en spammers. Ze komen binnen en vullen de reacties met aanbiedingen voor gemakkelijke verdiensten, adverteren wondermiddelen en beloven sociale uitkeringen. Door spammers verliezen sommige gebruikers geld, terwijl anderen de motivatie verliezen om tijd door te brengen op een verwaarloosde, door spam overwoekerde dienst.
En dit is niet het enige probleem. We streven er niet alleen naar om gebruikers te beschermen tegen oplichters, maar ook om een comfortabele sfeer voor communicatie te creëren. Als mensen in de reacties geconfronteerd worden met scheldwoorden en beledigingen, is de kans groot dat ze vertrekken en niet meer terugkomen. Dus we moeten hier ook mee leren omgaan.
Schone Web
Zoals het vaak bij ons het geval is, zijn de eerste ontwikkelingen ontstaan in de Zoekfunctie, in het deel dat zich bezighoudt met het bestrijden van spam in de resultaten. Tien jaar geleden ontstond daar de taak om volwassen inhoud te filteren voor gezinsgerichte zoekopdrachten en voor aanvragen die geen antwoorden uit de categorie 18+ zouden moeten bevatten. Zo kwamen de eerste handmatig samengestelde woordenlijsten voor porno en scheldwoorden tot stand, die werden aangevuld door analisten. De belangrijkste taak was het classificeren van aanvragen in die waar het toegestaan is om volwassen inhoud weer te geven en die waar dit niet is. Voor dit doel verzamelden ze markup, bouwden ze heuristieken en trainden ze modellen. Zo ontstonden de eerste ontwikkelingen voor het filteren van ongewenste inhoud.
In de loop der tijd is er bij Yandex UGC (user generated content) verschenen — berichten die door de gebruikers zelf worden geschreven, en Yandex publiceert ze alleen. Om de hierboven beschreven redenen konden veel berichten niet zomaar gepubliceerd worden — moderatie was vereist. Daarom besloten ze een service te creëren die bescherming biedt tegen spam en kwaadwillenden voor alle UGC-producten van Yandex en gebruik maakte van de ontwikkelingen voor het filteren van ongewenste inhoud in de Zoekfunctie. Deze service werd 'Schone Web' genoemd.
Nieuwe taken en hulp van tolken
Aanvankelijk gebruikten we alleen simpele automatisering: de services stuurden ons teksten, en wij voerden ze door de woordenlijsten voor scheldwoorden, woordenlijsten voor porno en reguliere expressies — analisten stelden alles handmatig samen. Maar na verloop van tijd werd de service in een steeds groter aantal producten van Yandex toegepast, en moesten we leren omgaan met nieuwe problemen.
Vaak plaatsen gebruikers in plaats van een beoordeling een zinloze reeks letters om hun prestaties op te krikken, soms adverteren ze hun bedrijf in beoordelingen over een concurrent, en soms verwarren ze gewoon organisaties en schrijven in een beoordeling van een huisdierenwinkel: 'Heerlijk bereidde vis!'. Misschien zal kunstmatige intelligentie ooit in staat zijn om perfect de betekenis van elke tekst te begrijpen, maar op dit moment is de automatisering soms minder nauwkeurig dan een mens.
Het is duidelijk geworden dat handmatige tagging onontkoombaar is, en daarom hebben we een tweede stap aan ons proces toegevoegd: verzending voor handmatige controle door een persoon. Hierin werden de gepubliceerde teksten opgenomen waarover de classifier geen problemen zag. De omvang van deze taak kunt u zich gemakkelijk voorstellen, waardoor we niet alleen op beoordelaars hebben vertrouwd, maar ook de 'wijsheid van de massa' hebben benut door hulp in te roepen van talokaars. Zij helpen ons om te identificeren wat de machine heeft gemist en trainen haar daarmee.
Slimme caching en LSH-hashing
Een ander probleem waarmee we te maken kregen bij het werken met opmerkingen, is spam, en meer specifiek, de volumes en de snelheid van verspreiding. Toen het publiek van Yandex.Region snel begon te groeien, kwamen de spammers. Ze leerden om de reguliere expressies te omzeilen door de tekst iets te wijzigen. Spam werd natuurlijk nog steeds gevonden en verwijderd, maar in de schaal van Yandex kon een ongepaste boodschap, zelfs als deze slechts 5 minuten zichtbaar was, door honderden mensen worden gezien.
Dit was voor ons uiteraard onacceptabel, en daarom introduceerden we slimme caching van teksten op basis van LSH (). Dit werkt als volgt: we normaliseren de tekst, verwijderen links en splitsen deze in n-grammen (reeksen van n letters). Daarna berekenen we hashes van de n-grammen en construeren we vervolgens de LSH-vector van het document. Het idee is dat vergelijkbare teksten, zelfs als ze enigszins zijn gewijzigd, worden omgezet in vergelijkbare vectoren.
Deze oplossing stelde ons in staat om de uitspraken van classifiers en talokaarsen te hergebruiken voor vergelijkbare teksten. Bij een spam-aanval, zodra het eerste bericht de controle doorstond en in de cache met het oordeel 'spam' terechtkwam, kregen alle nieuwe vergelijkbare berichten, zelfs de gewijzigde, hetzelfde oordeel en werden automatisch verwijderd. Later leerden we classifiers voor spam automatisch te trainen en opnieuw te trainen, maar deze 'slimme cache' is bij ons gebleven en komt ons nog vaak van pas.
Classifier voor goede teksten
Nog niet hersteld van de strijd tegen spam, beseften we dat 95% van de inhoud handmatig wordt gemodereerd: classifiers reageren alleen op overtredingen, terwijl de meeste teksten goed zijn. We belasten evaluators, die in 95 van de 100 gevallen de beoordeling "Alles OK" geven. We moesten ons bezighouden met ongebruikelijk werk — we maken classifiers voor goede inhoud, toevallig hebben we in de tussentijd voldoende aantekeningen verzameld.
De eerste classifier zag er als volgt uit: we lemmatizeren de tekst (brengen woorden terug naar hun basisvorm), verwijderen alle functionele woorden en passen een vooraf opgestelde "woordenlijst van goede lemmas" toe. Als alle woorden in de tekst "goed" zijn, betekent dat dat de tekst als geheel geen overtredingen bevat. Deze aanpak zorgde direct voor 25 tot 35% automatisering van handmatige annotatie op verschillende diensten. Natuurlijk is deze aanpak niet perfect: het is eenvoudig om verschillende onschuldige woorden te combineren en een zeer kwetsende uitspraak te creëren, maar het stelde ons in staat om snel een goed niveau van automatisering te bereiken en gaf ons tijd om complexere modellen te trainen.
De volgende versies van classifiers voor goede teksten omvatten al lineaire modellen, beslissingsbomen en hun combinaties. Voor het annoteren van grove en beledigende uitspraken proberen we bijvoorbeeld het neurale netwerk BERT. Hier is het belangrijk om de betekenis van een woord in de context te vangen en de verbinding tussen woorden in verschillende zinnen, en BERT doet dit behoorlijk goed. (Overigens, onlangs deelden collega's van Nieuws, hoe ze de technologie toepassen voor een ongewone taak — het zoeken naar fouten in koppen.) Uiteindelijk lukte het om tot 90% van de stroom te automatiseren, afhankelijk van de service. Nauwkeurigheid, volledigheid en snelheid
Om te groeien, moeten we begrijpen welke voordelen bepaalde automatische classifiers bieden, veranderingen daarin en of de kwaliteit van handmatige controles niet achteruitgaat. Hiervoor gebruiken we nauwkeurigheid- en volledigheidsmetingen.
Om te kunnen groeien, is het belangrijk te begrijpen welke waarde de verschillende automatische classificatoren bieden, welke wijzigingen daarin plaatsvinden en of de kwaliteit van handmatige controles niet achteruitgaat. Hiervoor maken we gebruik van nauwkeurigheid- en volledigheidsmetrics.
Nauwkeurigheid is het percentage correcte uitspraken onder alle uitspraken over slechte inhoud. Hoe hoger de nauwkeurigheid, hoe minder valse positieven. Als de nauwkeurigheid niet wordt bewaakt, kan in theorie alle spam en ongepaste inhoud worden verwijderd, en daarmee ook de helft van de goede berichten. Aan de andere kant, als we alleen op nauwkeurigheid vertrouwen, zou de beste technologie degene zijn die helemaal niemand opmerkt. Daarom is er ook een maatstaf voor volledigheid: het percentage gevonden slechte inhoud onder het totale volume van slechte inhoud. Deze twee metrische gegevens balanceren elkaar.
Voor de meting monsters van de hele inkomende stroom van elke dienst nemen we en geven we steekproeven van de inhoud aan beoordelaars voor deskundige evaluatie en vergelijking met de beslissingen van de machine.
Maar er is nog een belangrijke maatstaf.
Boven heb ik geschreven dat een ongepaste boodschap zelfs binnen 5 minuten door honderden mensen kan worden gezien. Daarom tellen we hoeveel keer we slechte inhoud aan mensen hebben laten zien voordat we het verborgen hebben. Dit is belangrijk, omdat het niet genoeg is om kwalitatief hoogwaardig te werken — we moeten ook snel werken. Toen we de bescherming tegen ongepaste taal bouwden, voelden we dit ten volle.
Antischennis met katten en honden als voorbeeld
Een kleine lyrische afleiding. Iemand kan zeggen dat ongepaste taal en beledigingen niet zo gevaarlijk zijn als schadelijke links, en niet zo irritant als spam. Maar we willen aangename omstandigheden voor communicatie voor miljoenen gebruikers behouden, en mensen houden er niet van om terug te keren naar plaatsen waar ze beledigd worden. Niet voor niets is het verbod op ongepaste taal en beledigingen opgenomen in de regels van veel gemeenschappen, inclusief Habra. Maar we zijn afgeweken van het onderwerp.
Woordenboeken voor ongepaste taal kunnen niet omgaan met de rijkdom van de Russische taal. Ondanks dat er maar vier basis scheldwoorden zijn, kunnen daar ontelbare woorden uit worden gevormd die je met geen enkele reguliere expressie kunt vangen. Bovendien kan een deel van een woord in transliteratie worden geschreven, letters kunnen door vergelijkbare combinaties worden vervangen, letters kunnen worden verplaatst, sterretjes en dergelijke kunnen worden toegevoegd. Soms is het überhaupt niet mogelijk om zonder context te bepalen wat de gebruiker bedoelde met een scheldwoord. We respecteren de regels van Habra, dus we zullen dit demonstreren niet met echte voorbeelden, maar met katten en honden.
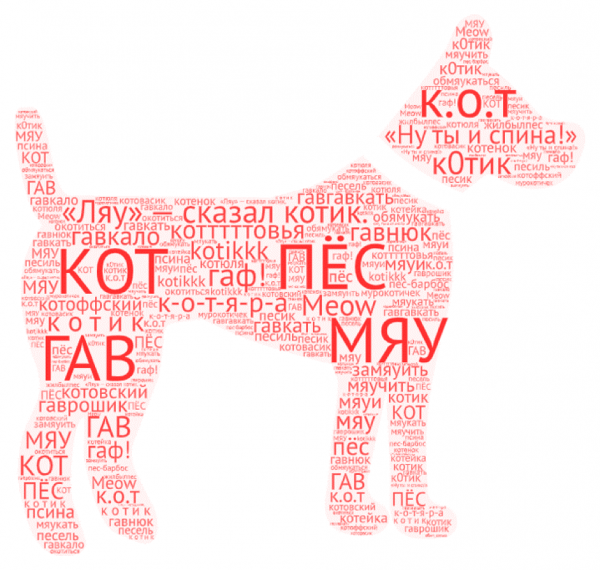
„Miauw”, zei het katje. Maar we begrijpen dat het katje een ander woord zei...
We started thinking about the algorithms for 'fuzzy matching' in our vocabulary and about more intelligent preprocessing: we standardized transliteration, merged spaces and punctuation, looked for patterns, and wrote separate regular expressions for them. This approach yielded results, but often decreased accuracy, not providing the desired completeness.
Then we decided to 'think like foul-mouthed people'. We began to introduce noise into the data ourselves: rearranging letters, generating typos, replacing letters with similar ones, and so on. We took the initial markup for this by applying profanity dictionaries to large corpuses of text. If you take one sentence and distort it in several ways, you'll end up with many sentences. This way, we can increase the training sample by tens of times. All that was left was to train some reasonably intelligent model on the dataset, taking context into account.
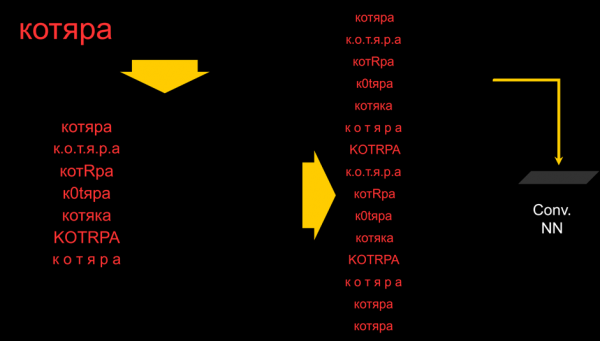
It's still too early to talk about the final solution. We are still experimenting with approaches to this problem, but we already see that a simple character convolutional network with several layers significantly outperforms dictionaries and regular expressions: it increases both accuracy and completeness.
Of course, we understand that there will always be ways to bypass even the most advanced automation, especially when it comes to something so engaging: writing in a way that a dumb machine doesn't understand. Here, just like in the fight against spam, our goal is not to eradicate the possibility of writing something inappropriate, but to ensure that the game is not worth the candle.
Opening up the opportunity to share opinions, communicate, and comment is not difficult. What’s much harder is achieving safe, comfortable conditions and a respectful attitude towards people. Without that, no community can develop.
Bron: habr.com
