

Hallo! Mijn naam is Aleksey Pjankov, ik ben ontwikkelaar bij Sportmaster. In deze vertel ik hoe het werk aan de Sportmaster-website in 2012 begon, welke initiatieven we konden 'doorvoeren' en welke obstakels we tegenkwamen.
Vandaag wil ik mijn gedachten delen over een ander onderwerp - de keuze van een caching-systeem voor de Java-backend in de admin van de website. Dit onderwerp is bijzonder belangrijk voor mij - hoewel het verhaal slechts 2 maanden duurt, hebben we deze 60 dagen 12-16 uur per dag gewerkt zonder een enkele vrije dag. Ik had nooit gedacht of me kunnen voorstellen dat je zo veel kunt werken.
Daarom deel ik de tekst op in 2 delen, zodat het niet te veel wordt. Integendeel, het eerste deel zal zeer licht zijn - een voorbereiding, een inleiding, enkele overpeinzingen over wat caching is. Als je al een ervaren ontwikkelaar bent of met caches hebt gewerkt, zul je technisch gezien waarschijnlijk niets nieuws in dit artikel vinden. Maar voor een junior kan zo'n klein overzicht je wellicht helpen in welke richting je moet kijken als je voor zo'n kruispunt komt.
Toen de nieuwe versie van de Sportmaster-website in productie werd genomen, kwamen de gegevens op een manier binnen die, zacht gezegd, niet erg handig was. De basis bestond uit tabellen die waren voorbereid voor de eerdere versie van de website (Bitrix), die in ETL moesten worden getrokken, omgevormd en verrijkt met allerlei snufjes uit een dozijn andere systemen. Om ervoor te zorgen dat een nieuwe afbeelding of productbeschrijving op de website kwam, moest je wachten tot de volgende dag - de updates vonden slechts 's nachts, eenmaal per dag, plaats.
In het begin waren er zoveel zorgen in de eerste weken na de lancering, dat de ongemakken voor contentmanagers slechts een kleinigheid waren. Maar zodra alles zich stabiliseerde, ging de ontwikkeling van het project verder – enkele maanden later, begin 2015, begonnen we actief aan de adminomgeving te werken. In 2015 en 2016 ging alles goed, we brachten regelmatig releases uit, de adminomgeving dekte steeds meer van de data-voorbereiding en we maakten ons klaar voor het moment waarop ons team het belangrijkste en meest complexe ook zou toevertrouwd krijgen – de productcyclus (volledige voorbereiding en beheer van gegevens over alle producten). Maar in de zomer van 2017, net voor de lancering van de productcyclus, kwam het project in een erg moeilijke situatie terecht – juist vanwege problemen met caching. Over dit hoofdstuk wil ik in het tweede deel van deze tweedelige publicatie vertellen.
Maar in deze post begin ik van verre, zal ik enkele ideeën samenvatten – opvattingen over caching, dat het vooraf scrollen door een groot project een goede stap zou zijn.
Wanneer de taak van caching zich voordoet
De taak van caching komt niet zomaar uit de lucht vallen. Wij zijn ontwikkelaars, we schrijven software en willen dat deze gewild is. Als het product gewild en succesvol is, komen de gebruikers. En nog meer gebruikers. En er komen steeds meer, en dan zijn er zoveel gebruikers dat het product uiteindelijk hoogbelast wordt.
In de eerste fasen denken we niet aan optimalisatie en prestatie van de code. Het belangrijkste is functionaliteit, snel een pilot uitrollen en hypotheses testen. En als de belasting toeneemt – dan updaten we de hardware. We verhogen het aantal, tweemaal, driemaal, vijfmaal, misschien zelfs tienmaal. Maar ergens hier – zullen financiën niet meer toelaten. En hoeveel keer zal het aantal gebruikers toenemen? Het zal niet 2-5-10 zijn, maar in het geval van succes kan het wel 100-1000 tot 100.000 keer zijn. Dus, vroeg of laat, zullen we ons met optimalisatie moeten bezighouden.
Stel dat een deel van de code (laten we dit deel een functie noemen) belachelijk lang doet over het uitvoeren, en we willen de uitvoeringstijd verkorten. Een functie kan toegang tot een database zijn, of het uitvoeren van complexe logica – het belangrijkste is dat het lang duurt. Hoever kunnen we de uitvoeringstijd verkorten? In theorie kan het tot nul gereduceerd worden, niet verder. Maar hoe kunnen we de uitvoeringstijd tot nul reduceren? Antwoord: door de uitvoering helemaal te vermijden. In plaats daarvan: direct het resultaat teruggeven. Maar hoe weten we het resultaat? Antwoord: of we berekenen het, of we kijken ergens anders. Berekenen is langdurig. En om te kijken — dat betekent bijvoorbeeld dat we het resultaat onthouden dat de functie de vorige keer gaf bij dezelfde parameters.
Dat wil zeggen, de implementatie van de functie is voor ons niet belangrijk. Het is voldoende om te weten van welke parameters het resultaat afhankelijk is. Als we de waarden van de parameters weergeven als een object dat kan worden gebruikt als sleutel in een soort opslag — dan kunnen we het resultaat van de berekening opslaan en bij het volgende verzoek teruglezen. Als deze opslag-en-lezen operaties sneller zijn dan het uitvoeren van de functie — dan hebben we winst in snelheid. De winst kan oplopen tot 100, 1000 of zelfs 100.000 keer (10^5 is eerder een uitzondering, maar in het geval van een zwaar vertraagde database is dat goed mogelijk).
De belangrijkste vereisten voor het cachesysteem
De eerste vereiste voor het cachesysteem is snelle leessnelheid en in iets mindere mate – schrijfsnelheid. Dat is zo, maar alleen zolang we het systeem niet in productie nemen.
Laten we een case uitspelen.
Stel dat we de huidige belasting met hardware hebben gedekt en nu geleidelijk aan caching implementeren. Het aantal gebruikers groeit een beetje, de belasting neemt toe – we voegen een beetje caching toe en koppelen het hier en daar aan. Dit gaat enige tijd door, en op een gegeven moment worden zware functies nauwelijks nog uitgevoerd — de meeste belasting komt op de cache te liggen. Het aantal gebruikers is in die tijd met N keer toegenomen.
En als de aanvankelijke hardwarecapaciteit 2-5 keer kon zijn, dan konden we met behulp van caching de prestaties met 10 keer verhogen, of in een goed geval met 100, en op sommige momenten mogelijk zelfs met 1000. Dat wil zeggen, op dezelfde hardware verwerken we 100 keer meer aanvragen. Geweldig, dat verdient een beloning!
Maar nu, op een mooie dag, crashte het systeem per ongeluk en viel de cache uit. Niets bijzonders - de cache werd gekozen op basis van de eis 'hoge lees- en schrijfsnelheid, de rest is niet belangrijk'.
Wat betreft de initiële belasting hadden we een hardware reserve van 2-5 keer, terwijl de belasting in die tijd met 10-100 keer is toegenomen. Met behulp van de cache konden we aanroepen voor zware functies uitsluiten en daardoor draaide alles soepel. En nu, zonder cache – hoe ver zal ons systeem zakken? Wat gaat er gebeuren? Het systeem zal neervallen.
Zelfs als onze cache niet is uitgevallen, maar slechts tijdelijk is gewist – moet deze opnieuw worden opgewarmd, wat enige tijd zal duren. Gedurende deze tijd – zal de hoofdlast op de functionaliteit liggen.
Conclusie: hoogbelaste projecten in productie vereisen van het systeem niet alleen hoge lees- en schrijfsnelheid, maar ook dataverliesbescherming en weerstand tegen uitval.
De strijd om een keuze
In het project met een admin-paneel verliep de keuze als volgt: we installeerden eerst Hazelcast, omdat we al bekend waren met dit product op basis van de ervaring met de hoofdwebsite. Maar, deze keuze bleek ongeldig – voor ons belastingprofiel werkt Hazelcast niet alleen traag, maar vreselijk traag. En op dat moment hadden we al getekend voor de lanceertijden naar productie.
Spoiler: hoe de omstandigheden zich ontwikkelden, waardoor we deze misser hebben gemist en in een scherpe en spannende situatie terechtkwamen – ik zal het in het tweede deel vertellen — hoe we daar terechtkwamen en hoe we eruit zijn gekomen. Maar nu – ik zal alleen zeggen dat het een sterke stress was, en 'denken - soms denkt men niet, we schudden de fles'. 'We schudden de fles' - dit is ook een spoiler, daarover later meer.
Wat we gedaan hebben:
- We maken een lijst van alle systemen die Google en StackOverflow voorstellen. Iets meer dan 30.
- We schrijven tests met een belasting die kenmerkend is voor productie. Hiervoor hebben we gegevens vastgelegd die in het productie-omgeving door het systeem gaan - een soort sniffer voor gegevens die niet in het netwerk, maar binnen het systeem zijn. In de tests hebben we precies deze gegevens gebruikt.
- Als team kiest iedereen het volgende systeem uit de lijst, stelt het in en voert de tests uit. Testen die niet slagen of de belasting niet aankunnen – gooien we weg en gaan we verder met de volgende in de rij.
- Bij het 17e systeem werd het duidelijk dat alles hopeloos was. Genoeg met 'de fles schudden', het is tijd om serieus na te denken.
Maar dit is een optie wanneer je een systeem moet kiezen dat "door de snelheid past" in vooraf voorbereide tests. Maar wat als er nog geen dergelijke tests zijn en je wilt sneller kiezen?
Laten we zo'n scenario modelleren (het is moeilijk voor te stellen dat een mid-level ontwikkelaar in een vacuüm leeft en op het moment van kiezen nog geen voorkeur heeft ingesteld voor welk product eerst te proberen — daarom zijn de verdere overpeinzingen eerder theoretisch/filosofisch/over junioren).
Zodra we de vereisten hebben vastgesteld, beginnen we een oplossing uit de doos te kiezen. Waarom het wiel opnieuw uitvinden: we gaan een kant-en-klaars cachesysteem nemen.
Als je net begint en gaat googelen, dan uiteraard plus of min de volgorde, maar in grote lijnen zullen dit de richtlijnen zijn. Eerst kom je Redis tegen, dat is overal bekend. Vervolgens ontdek je dat er EhCache is, als het meest langdurige en bewezen systeem. Daarna wordt Tarantool besproken — een binnenlandse ontwikkeling met een uniek aspect van de oplossing. En ook Ignite, omdat het momenteel aan populariteit wint en wordt ondersteund door SberTech. Tot slot is er ook Hazelcast, omdat het in de enterprise-wereld vaak voorkomt bij grote bedrijven.
Deze lijst is niet uitputtend; er bestaan tientallen systemen. We zullen er echter maar één kiezen. Laten we de gekozen 5 systemen in een "schoonheidswedstrijd" brengen en een selectie maken. Wie zal de winnaar zijn?
Redis
Laten we lezen wat er op de officiële website staat.
— open-source project. Biedt een in-memory gegevensopslag, de mogelijkheid om on-disk op te slaan, automatische partitionering, hoge beschikbaarheid en herstel na netwerkonderbrekingen.
Het lijkt prima te zijn, je kunt het gebruiken en integreren — alles wat nodig is, doet het. Maar laten we, louter uit nieuwsgierigheid, naar de andere kandidaten kijken.
EhCache
— "de meest gebruikte cache voor Java" (vertaling van de slogan van de officiële website). Ook open-source. En hier begrijpen we dat Redis niet voor Java is, maar algemeen, en dat er een wrapper nodig is voor interactie ermee. EhCache zal handiger zijn. Wat belooft dit systeem nog? Betrouwbaarheid, bewezen werking, volledige functionaliteit. En bovendien is het de meest verspreide. En het cachet terabytes aan gegevens.
Redis is vergeten, ik ben bereid om EhCache te kiezen.
Maar een gevoel van patriottisme drijft me om te kijken wat Tarantool goed maakt.
Tarantool
— ontmoet de aanduiding ‘Realtime data-integratieplatform’. Het klinkt allemaal erg ingewikkeld, dus laten we de pagina aandachtig lezen en het opvallende statement vinden: ‘Cacheert 100% van de gegevens in het RAM-geheugen.’ Dit zou vragen moeten oproepen, want de hoeveelheid gegevens kan aanzienlijk groter zijn dan het geheugen. Wat ermee wordt bedoeld, is dat Tarantool geen serialisatie uitvoert bij het schrijven van gegevens van het geheugen naar de schijf. In plaats daarvan maakt het gebruik van laag-niveau systeemkenmerken, waarbij het geheugen eenvoudigweg wordt gemapt op het bestandssysteem met zeer goede I/O-prestaties. Over het geheel genomen is het op een geweldige manier gedaan.
Laten we eens kijken naar de implementaties: Mail.ru bedrijfsnetwerk, Avito, Beeline, Megafon, Alfa-Bank, Gazprom…
Als er nog enige twijfels over Tarantool waren, dan maakt de implementatiecase bij Mastercard me overtuigd. Ik kies voor Tarantool.
Maar toch…
Ignite
… is nog een optie , gepresenteerd als ‘in-memory rekplatform… in-memory snelheden op petabytes aan gegevens’. Hier zijn ook veel voordelen: gedistribueerde in-memory cache, het snelste key-value-opslag en cache, horizontale schaalbaarheid, hoge beschikbaarheid, strikte integriteit. Over het geheel genomen blijkt dat Ignite het snelste is.
Implementaties: Sberbank, American Airlines, Yahoo! Japan. En dan ontdek ik ook dat Ignite niet alleen bij Sberbank is geïmplementeerd, maar dat het SberTech-team ook hun mensen naar Ignite stuurt om het product verder te ontwikkelen. Dit overtuigt me volledig en ik ben bereid Ignite te gebruiken.
Volledig onduidelijk waarom, kijk ik naar punt vijf.
Hazelcast
Ik ga naar de website , lees. En het blijkt dat de snelste oplossing voor gedistribueerde caching — Hazelcast is. Het is vele malen sneller dan alle andere oplossingen en over het algemeen is het een leider op het gebied van in-memory data grid. Op de achtergrond zou je iets anders kiezen — dat zou jezelf geen respect geven. Bovendien maakt het gebruik van redundante gegevensopslag voor continue werking van de cluster zonder dataverlies.
Dat is het, ik ben bereid Hazelcast te gebruiken.
Vergelijking
Maar als we kijken, zijn al vijf kandidaten zo beschreven dat elke kandidaat de beste is. Hoe kies je? We kunnen kijken welke het populairst is, vergelijkingen zoeken, en de hoofdpijn zal verdwijnen.
Laten we zo'n , onze 5 systemen kiezen.
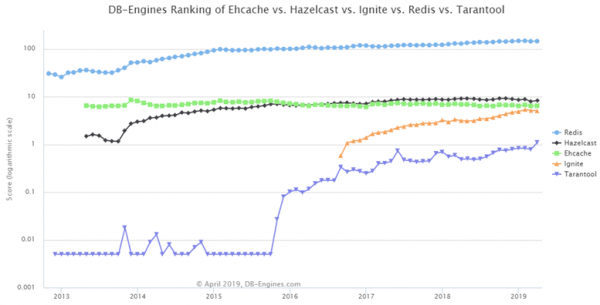
Hier zijn ze gesorteerd: bovenaan Redis, op de tweede plaats — Hazelcast, Tarantool en Ignite winnen aan populariteit, EhCache blijft zoals het was.
Maar laten we eens kijken naar : links naar websites, algemene interesse in het systeem, vacatures - geweldig! Dus als mijn systeem uitvalt, zeg ik: 'Nee, het is betrouwbaar! Kijk hoeveel vacatures er zijn...'. Zo'n simpele vergelijking is niet genoeg.
Al deze systemen zijn niet zomaar caching-systemen. Ze hebben ook veel functionaliteit, waaronder – wanneer er geen gegevens naar de klant worden gestuurd voor verwerking, maar in plaats daarvan de code die uitgevoerd moet worden op de gegevens, naar de server verhuist, daar wordt uitgevoerd en het resultaat wordt teruggestuurd. Als een apart systeem voor caching worden ze niet zo vaak beschouwd.
Oké, we geven niet op, we zullen een directe vergelijking van systemen vinden. Laten we de twee beste opties nemen - Redis en Hazelcast. We zijn geïnteresseerd in snelheid, op dit criterium zullen we ze vergelijken.
Hz vs Redis
We vinden dit :
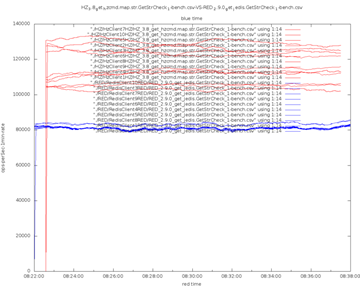
Blauw is Redis, rood is Hazelcast. Hazelcast wint overal, en daar is een verklaring voor: het is multi-threaded, zeer geoptimaliseerd, elke thread werkt met zijn eigen partitie, zodat er geen blokkades zijn. En Redis is single-threaded, dus het haalt geen voordeel uit moderne multi-core CPU's. Hazelcast gebruikt asynchrone I/O, terwijl Redis-Jedis blokkerende sockets gebruikt. Uiteindelijk gebruikt Hazelcast een binair protocol, en Redis is tekst-georiënteerd, wat wil zeggen dat het inefficiënt is.
Laten we voor de zekerheid nog een andere source voor vergelijking raadplegen. Wat zal hij ons tonen?
Redis vs Hz
Nog één :
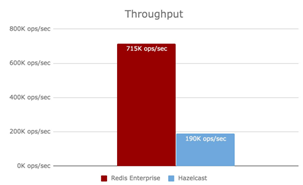
Hier is het omgekeerd, rood is Redis. Dat betekent dat Redis in prestaties wint van Hazelcast. In de eerste vergelijking won Hazelcast, in de tweede - Redis. is heel precies uitgelegd waarom Hazelcast de vorige vergelijking heeft gewonnen.
Het blijkt dat het resultaat van de eerste vergelijking feitelijk gemanipuleerd was: Redis werd in de basisconfiguratie genomen, terwijl Hazelcast was afgestemd op de testomstandigheden. Dus, ten eerste, niemand kan je vertrouwen, ten tweede, wanneer we uiteindelijk een systeem kiezen, moeten we het ook goed instellen. Deze instellingen omvatten tientallen, bijna honderd parameters.
Schud de fles
En het hele proces dat we nu hebben doorlopen, kan ik uitleggen met de metafoor 'Schud de fles'. Dus nu is programmeren niet het belangrijkste, nu is het belangrijkste - leren om stackoverflow te lezen. En in mijn team is er een professional die precies zo werkt in kritieke momenten.
Wat doet hij? Hij ziet een niet-functionerend ding, ziet de stack trace, pakt enkele woorden eruit (welke precies - dat is zijn expertise in het programma), zoekt het op Google, en vindt Stack Overflow tussen de antwoorden. Zonder te lezen, zonder erover na te denken, kiest hij iets dat het meest lijkt op de zin ‘dit en dat doen’ (het kiezen van zo'n antwoord is zijn talent, want het is niet altijd het antwoord dat de meeste likes heeft), past het toe, kijkt: als er iets veranderd is, is dat geweldig. Als er niets veranderd is - rollen we het terug. En we herhalen de start-controle-zoektocht. En op deze intuïtieve manier bereikt hij dat de code na een tijdje werkt. Hij weet niet waarom, hij weet niet wat hij heeft gedaan, hij kan het niet uitleggen. Maar! Deze ellende werkt. En ‘de brand is geblust’. Nu begrijpen we wat we hebben gedaan. Wanneer het programma werkt - is het vele malen gemakkelijker. En het bespaart aanzienlijk tijd.
Deze methode wordt heel goed uitgelegd aan de hand van een voorbeeld.
Vroeger was het heel populair om een zeilschip in een fles te bouwen. Het zeilschip is groot en kwetsbaar, en de opening van de fles is heel smal, je kunt het er niet in duwen. Hoe bouw je het?
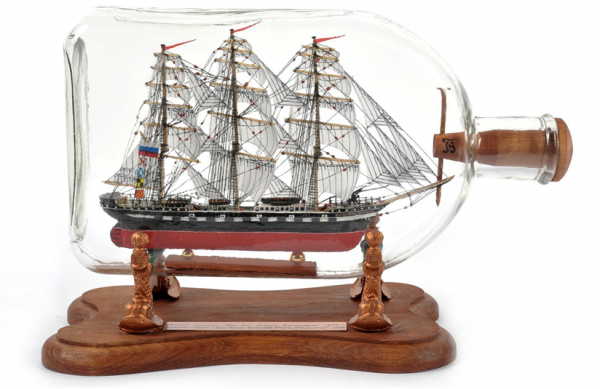
Er is een methode, heel snel en heel effectief.
Het schip bestaat uit een hoop kleine dingen: stokjes, touwtjes, zeilen, lijm. Dit alles leggen we in de fles.
We nemen de fles met beide handen en beginnen te schudden. We schudden en schudden. En meestal - krijgt dat natuurlijk totale onzin. Maar soms. Soms komt er een schip uit! Juist, iets dat lijkt op een schip.
We tonen dat iets aan iemand: 'Serega, zie je!?'. En inderdaad, van een afstand – lijkt het op een schip. Maar verder mag je het niet laten gaan.
Er is nog een manier. Meer geavanceerde jongens gebruiken deze, zoals hackers.
Ik gaf zo'n jongen een taak, hij heeft alles gedaan en is weggegaan. En je kijkt - het lijkt gedaan. Maar na een tijdje, wanneer je de code moet aanpassen - begint er zo'n toestand door hem... Gelukkig is hij al ver weg. Dit zijn jongens die bijvoorbeeld aan de fles laten zien: zie je, waar de bodem is - buigt het glas. En het is niet helemaal duidelijk of het doorzichtig is of niet. Dan slijpen de ‘hackers’ deze bodem af, steken het schip erin, plakken de bodem weer vast, en alsof het zo bedoeld is.
Vanuit het perspectief van het stellen van een taak lijkt alles in orde. Maar als we het voorbeeld van de schepen bekijken: waarom zou je dit schip maken, wie heeft het eigenlijk nodig? Het heeft totaal geen functionaliteit. Dergelijke schepen zijn meestal geschenken voor zeer hooggeplaatste personen, die het op een plank boven zich zetten, als een soort symbool, als een teken. En als zo'n persoon, een leider van een groot bedrijf of een hooggeplaatste ambtenaar, zo'n prutswerk als een vlag ziet waarop de hals is afgekapt? Het is beter als hij daar nooit achter komt. Dus, hoe worden deze schepen uiteindelijk gemaakt die aan een belangrijk persoon kunnen worden gegeven?
De enige plek, de sleutelplek, waar echt niets aan te doen is, is de romp. En de romp van het schip gaat precies door de hals. Terwijl het schip buiten de fles wordt samengesteld. Maar het is niet gewoon een schip bouwen, het is een ware kunstvaardigheid. Aan de onderdelen worden speciale hendels toegevoegd, die het vervolgens mogelijk maken om ze op te tillen. Bijvoorbeeld, de zeilen worden opgevouwen, voorzichtig naar binnen gebracht, en daarna met een pincet heel secuur, precies, opgetild en omhooggetild. Hierdoor ontstaat er een kunstwerk dat je met een gerust hart en trots kunt cadeau geven.
En als we willen dat het project succesvol is – moet er minstens één juwelier in het team zijn. Iemand die zorgt voor de kwaliteit van het product en al deze aspecten in overweging neemt, zonder iets op te offeren, zelfs niet op momenten van stress, wanneer omstandigheden vereisen dat snelle beslissingen ten koste gaan van wat belangrijk is. Alle succesvolle projecten die duurzaam zijn, die de tand des tijds hebben doorstaan, zijn op dit principe gebaseerd. Ze hebben iets heel precieze en unieks, iets dat alle beschikbare mogelijkheden benut. In het voorbeeld van het schip in de fles wordt gespeeld met het feit dat de romp van het schip door de hals gaat.
Terugkomend op de taak om onze cache-server te kiezen, hoe zou deze methode kunnen worden toegepast? Ik stel voor om uit alle systemen te kiezen — schud de fles niet, kies niet, maar kijk wat er in feite is, waar je op moet letten bij het kiezen van een systeem.
Waar de bottleneck te vinden?
Laten we proberen de fles niet te schudden en niet alles één voor één door te nemen, maar kijken welke taken zich voordoen als we plotseling zelf een systeem willen ontwerpen. We zullen de fiets natuurlijk niet opnieuw uitvinden, maar we gebruiken dit schema om te bepalen waarop we moeten letten in de productbeschrijvingen. Laten we zo'n schema opstellen.
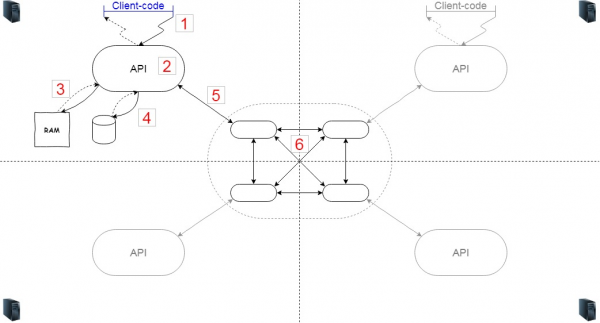
Als het systeem gedistribueerd is, hebben we meerdere servers (6). Laten we aannemen dat er vier zijn (dit is handig om op de afbeelding weer te geven, maar natuurlijk kan het er zoveel zijn als nodig is). Als de servers op verschillende knooppunten staan, draait er op al deze servers een bepaalde code die ervoor zorgt dat deze knooppunten een cluster vormen en in geval van een storing verbinding maken en elkaar herkennen.
Daarnaast is er code-logica (2) nodig die specifiek met caching te maken heeft. Met deze code communiceren de clients via een bepaalde API. De clientcode (1) kan zich zowel binnen dezelfde JVM bevinden als via het netwerk aanspreken. De logica die intern is geïmplementeerd, beslist welke objecten in de cache blijven en welke worden verwijderd. Voor het opslaan van de cache gebruiken we geheugen (3), maar als dat nodig is, kunnen we ook een deel van de gegevens op de schijf opslaan (4).
Laten we kijken in welke delen de belasting zal ontstaan. In feite zal elke pijl en elk knooppunt belast worden. Ten eerste kan er tussen de clientcode en de API, indien dit een netwerkinteractie is, een merkbare vertraging optreden. Ten tweede, binnen de API zelf – als we overcomplexe logica implementeren, kunnen we tegen de CPU aanlopen. Het zou goed zijn als de logica het geheugen niet onnodig belast. En we blijven met de interactie met het bestandssysteem – in de normale variant is dit serialiseren / herstellen en schrijven / lezen.
Vervolgens de interactie met het cluster. Het is waarschijnlijk dat het in hetzelfde systeem zal zijn, maar het kan ook apart zijn. Hier moet ook de gegevensoverdracht naar het cluster worden overwogen, evenals de snelheid van gegevensserialisatie en de interactie tussen de clusters.
Nu, aan de ene kant – kunnen we ons voorstellen 'welke tandwielen zullen draaien' in het cachesysteem bij het verwerken van verzoeken van onze code, en aan de andere kant – kunnen we inschatten welke en hoeveel verzoeken onze code naar dit systeem zal genereren. Dit is voldoende om een redelijk weloverwogen keuze te maken - een systeem kiezen dat past bij ons gebruiksscenario.
Hazelcast
Laten we eens kijken hoe deze decompositie toegepast kan worden op onze lijst. Bijvoorbeeld, Hazelcast.
Om gegevens in Hazelcast op te slaan of op te halen, communiceert de clientcode (1) met de API. Hz stelt je in staat om de server als embedded te draaien, en in dat geval is de oproep naar de API een methodenaanroep binnen de JVM, wat als gratis beschouwd kan worden.
Om de logica in (2) goed te laten functioneren, vertrouwt Hz op een hash van de byte-array van de serialiseerde sleutel – dit betekent dat de serialisatie van de sleutel in elk geval zal plaatsvinden. Dit is onvermijdelijke overhead voor Hz.
Eviction-strategieën zijn goed geïmplementeerd, maar voor speciale gevallen kun je je eigen strategieën toevoegen. Daar hoef je je niet druk om te maken.
De opslag (4) kan verbonden worden. Uitstekend. De interactie (5) voor embedded kan als onmiddellijk worden beschouwd. Gegevensuitwisseling tussen de knooppunten in de cluster (6) is er wel. Dit draagt bij aan de redundantie ten koste van snelheid. De Hz-functie Near-cache helpt de kosten te verlagen – gegevens verkregen van andere knooppunten in de cluster zullen worden(Cache)gecached.
Wat kan gedaan worden om de snelheid in deze omstandigheden te verhogen?
Bijvoorbeeld, om de serialisatie van de sleutel in (2) te vermijden – voeg nog een cache bovenop Hazelcast toe voor de meest intensieve gegevens. Bij Sportmaster hebben ze hiervoor Caffeine gekozen.
Voor optimalisatie op niveau (6) biedt Hz twee soorten opslag aan: IMap en ReplicatedMap.
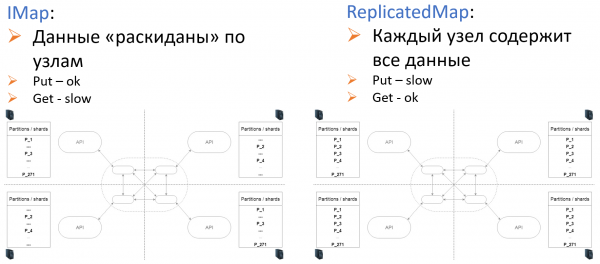
Het is goed om te vermelden hoe Hazelcast in de technologie-stack van Sportmaster terechtkwam.
In 2012, toen we aan de allereerste pilot van de toekomstige website werkten, bleek Hazelcast de eerste link te zijn die de zoekmachine gaf. Onze kennismaking begon ‘bij de eerste poging’ – we waren overtuigd omdat hij al werkte binnen twee uur nadat we Hz aan het systeem hadden toegevoegd. En hij werkte goed. Tegen het einde van de dag hadden we een aantal tests geschreven en waren blij. En die dosis enthousiasme was voldoende om de verrassingen van Hz in de loop van de tijd te doorstaan. Tegenwoordig heeft het Sportmaster-team geen redenen meer om afstand te nemen van Hazelcast.
Maar argumenten zoals ‘de eerste link in de zoekmachine’ en ‘we hebben snel HelloWorld verzameld’ zijn natuurlijk een uitzondering en een bijzondere eigenschap van het moment waarop de keuze werd gemaakt. De echte tests voor het gekozen systeem beginnen bij de productie, en die fase moet goed overwogen worden bij de keuze voor elk systeem, ook voor caches. Eigenlijk kan je zeggen dat we Hazelcast per ongeluk gekozen hebben, maar het blijkt dat we de juiste keuze hebben gemaakt.
Voor productie zijn monitoring, foutverwerking op afzonderlijke knooppunten, dat replicatie en schaalbaarheidskosten veel belangrijker. Dit betekent dat je moet letten op de problemen die zich zullen voordoen bij het onderhouden van het systeem - wanneer de belasting tientallen keren groter is dan gepland, wanneer we per ongeluk iets verkeerd en op de verkeerde plaats uploaden, en wanneer we een nieuwe versie van de code moeten uitrollen, gegevens vervangen en dit onopgemerkt voor klanten moeten doen.
Voor al deze eisen is Hazelcast zeker geschikt.
Wordt vervolgd
Maar Hazelcast is geen wondermiddel. In 2017 kozen we Hazelcast voor de cache in de admin omgeving, simpelweg gebaseerd op de goede indruk van eerdere ervaringen. Dit speelde een cruciale rol in een slechte grap, waardoor we in een moeilijke situatie terechtkwamen en 'heldhaftig' 60 dagen nodig hadden om eruit te komen. Maar daarover meer in het volgende deel.
Maar intussen... Happy New Code!
Bron: habr.com
