

De analytische database ClickHouse verwerkt veel verschillende strings en verbruikt middelen. Om de prestaties van het systeem te versnellen, worden er voortdurend nieuwe optimalisaties toegevoegd. Ontwikkelaar ClickHouse Nikolay Kochetov legt het string datatypesysteem uit, inclusief het nieuwe type LowCardinality, en hoe je de prestaties bij het werken met strings kunt verbeteren.
Laten we eerst eens bekijken hoe we strings kunnen opslaan.
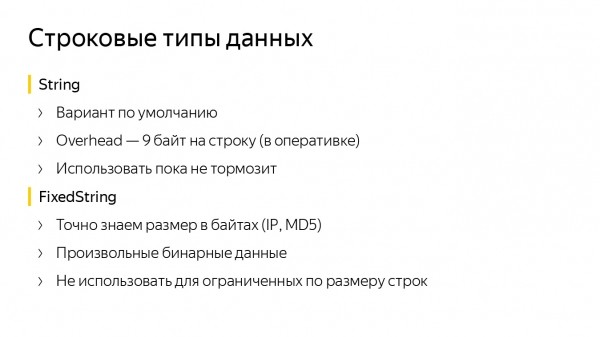
We hebben stringdatatypen. String is standaard goed geschikt en moet bijna altijd worden gebruikt. Het heeft een kleine overhead van 9 bytes per string. Als we willen dat de grootte van de strings vast en vooraf bekend is, is het beter om FixedString te gebruiken. Hiermee kun je het gewenste aantal bytes instellen, wat handig is voor gegevens zoals IP-adressen of hash-functies.
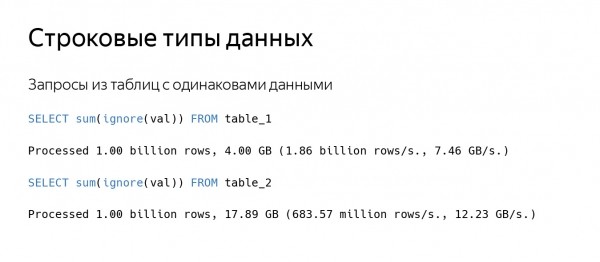
Natuurlijk, soms verloopt het wel traag. Stel je voor dat je een query naar een tabel uitvoert. ClickHouse leest een vrij grote hoeveelheid data, laten we zeggen, met een snelheid van 100 GB/s, terwijl er weinig strings worden verwerkt. We hebben twee tabellen die bijna dezelfde gegevens opslaan. ClickHouse leest gegevens uit de tweede tabel sneller, maar het aantal strings per seconde is drie keer lager.
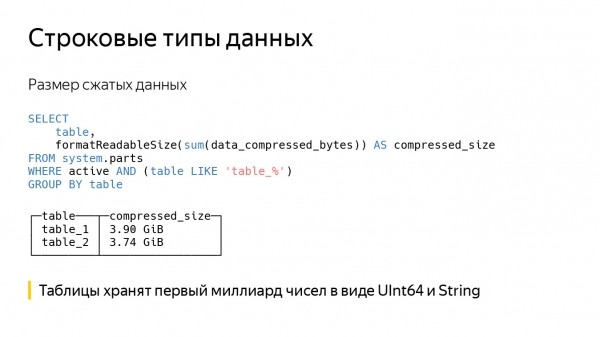
Als we naar de grootte van de gecomprimeerde gegevens kijken, zal deze vrijwel gelijk zijn. In werkelijkheid zijn in de tabellen dezelfde gegevens opgeslagen - de eerste miljard nummers - alleen zijn ze in de eerste kolom opgeslagen als UInt64, en in de tweede als String. Dit zorgt ervoor dat de tweede query langer nodig heeft om gegevens van de schijf te lezen en deze te decomprimeren.
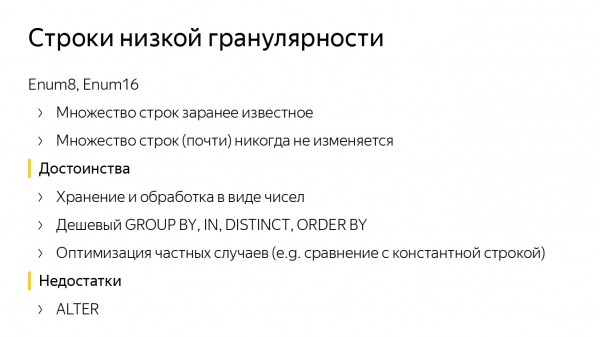
Hier is een ander voorbeeld. Stel dat er een vooraf bekende verzameling strings is, die beperkt is tot een constante van 1000 of 10.000 en praktisch nooit verandert. Voor deze situatie is het datatype Enum geschikt; ClickHouse heeft er twee - Enum8 en Enum16. Door op te slaan in Enum kunnen we de queries snel verwerken.
In ClickHouse zijn er versnellingen voor GROUP BY, IN, DISTINCT en optimalisaties voor sommige functies, bijvoorbeeld voor vergelijking met een constante string. Natuurlijk worden de getallen in de string niet geconverteerd, maar daarentegen wordt de constante string omgezet naar de Enum-waarde. Daarna worden alle vergelijkingen snel uitgevoerd.
Maar er zijn ook minpunten. Zelfs als we de exacte verzameling strings kennen, moet deze soms worden aangevuld. Een nieuwe string is binnengekomen - we moeten ALTER uitvoeren.
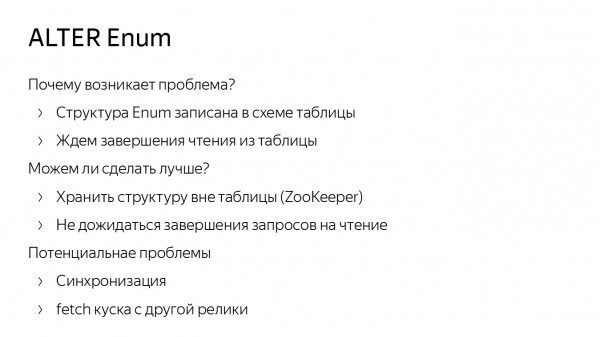
De ALTER voor Enum in ClickHouse is optimaal geïmplementeerd. We herschrijven de gegevens niet op de schijf, maar ALTER kan langzaam zijn omdat de Enum-structuren binnen het schema van de tabel worden opgeslagen. Daarom moeten we wachten op leesverzoeken uit de tabel, bijvoorbeeld.
De vraag rijst of het beter kan. Waarschijnlijk wel. We kunnen de Enum-structuur niet in het tabelschema opslaan, maar in ZooKeeper. Er kunnen echter synchronisatieproblemen optreden. Bijvoorbeeld, als de ene replica de gegevens heeft ontvangen en de andere niet, en als deze een oude Enum heeft, zal er iets misgaan. (In ClickHouse zijn we bijna klaar met niet-blokkerende ALTER-verzoeken. Wanneer we deze volledig hebben afgerond, hoeven we niet meer te wachten op leesverzoeken.)
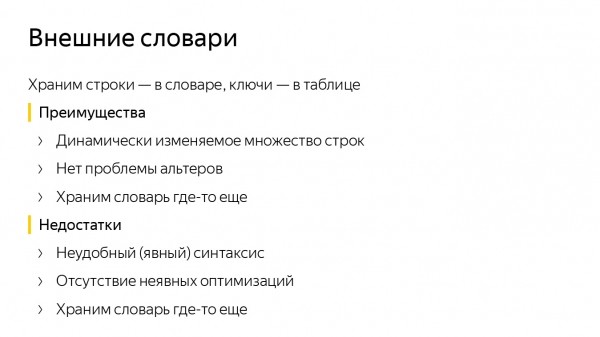
Om niet te rommelen met ALTER Enum, kunnen we externe woordenboeken in ClickHouse gebruiken. Ter herinnering, dit is een key-value datastructuur binnen ClickHouse waarmee je gegevens van externe bronnen kunt ophalen, zoals MySQL-tabellen.
In het ClickHouse-woordenboek slaan we veel verschillende strings op, terwijl we in de tabel hun identificatoren als getallen hebben. Als we een string willen ophalen, roepen we de functie dictGet aan en werken we ermee. Daarna hoeven we geen ALTER uit te voeren. Om iets aan de Enum toe te voegen, voegen we dit toe aan dezelfde MySQL-tabel.
Maar er ontstaan andere problemen. Ten eerste is er een ongemakkelijke syntaxis. Als we een string willen ophalen, moeten we dictGet aanroepen. Ten tweede ontbreken sommige optimalisaties. Vergelijkingen met een constante string voor woordenboeken kunnen niet zo snel worden gemaakt.
Er kunnen ook problemen zijn met updates. Stel dat we een string in het cache-woordenboek hebben opgevraagd, maar deze is niet in de cache terechtgekomen. Dan moeten we wachten totdat de gegevens van de externe bron zijn geladen.
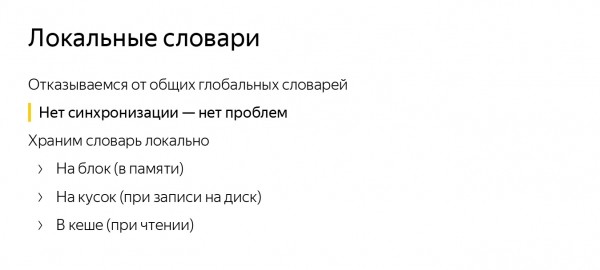
Een algemeen nadeel van beide methoden is dat we alle sleutels op één plek opslaan en deze synchroniseren. Waarom zouden we de woordenboeken niet lokaal opslaan? Geen synchronisatie betekent geen problemen. We kunnen het woordenboek lokaal opslaan in een stuk op de schijf. Dat wil zeggen, we hebben een Insert gedaan, het woordenboek genoteerd. Als we met gegevens in het geheugen werken, kunnen we het woordenboek of in een datablok opslaan, of in een kolomstuk, of in een cache om de berekeningen te versnellen.
Woordcodering van strings
Zo zijn we gekomen tot de creatie van een nieuw datatypes in ClickHouse - LowCardinality. Dit is een gegevensopslagformaat: hoe ze op de schijf worden geschreven en gelezen, hoe ze in het geheugen zijn weergegeven en het schema voor hun verwerking.
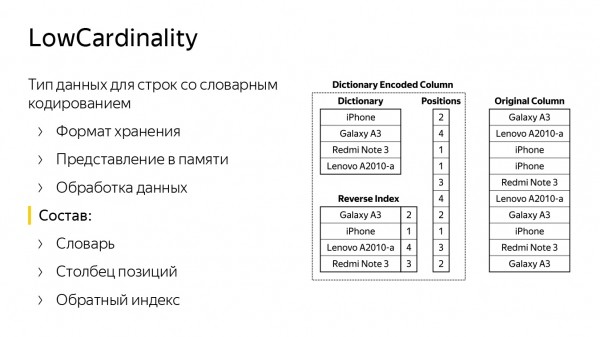
De diafragma bevat twee kolommen. Aan de rechterkant worden de rijen standaard opgeslagen als type String. Het lijkt erop dat het om mobiele telefoons gaat. Aan de linkerkant is er precies dezelfde kolom, maar dan in het type LowCardinality. Deze bestaat uit een woordenboek met verschillende rijen (de rijen uit de kolom aan de rechterkant) en een lijst van posities (rijnummers).
Met behulp van deze twee structuren kan de oorspronkelijke kolom worden hersteld. Er is ook een omgekeerde index - een hash-tabel die helpt om via een rij de positie in het woordenboek te vinden. Dit is nodig om sommige query's te versnellen. Bijvoorbeeld, als we een rij in onze kolom willen vergelijken of zoeken, of ze samen willen voegen.
LowCardinality is een parametertype. Het kan een nummer zijn, of iets dat als een nummer is opgeslagen, of een string, of Nullable van deze types.
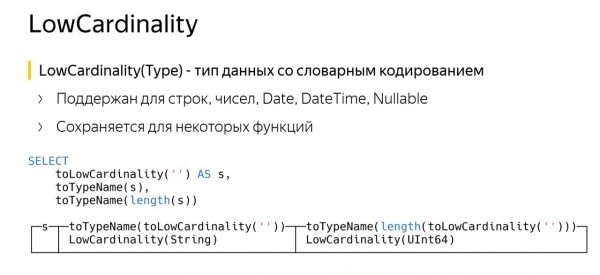
Kenmerk van LowCardinality is dat het opgeslagen kan worden voor bepaalde functies. Op de diafragma is een voorbeeld van een query te zien. In de eerste regel heb ik een kolom van het type LowCardinality van String gemaakt, deze genoemd S. Vervolgens vroeg ik de naam ervan - ClickHouse zei dat het LowCardinality van String is. Dat klopt.
De derde regel is bijna hetzelfde, alleen hebben we de functie length aangeroepen. In ClickHouse retourneert de functie length het datatype UInt64. Maar nu hebben we LowCardinality van UInt64. Wat is het doel hiervan?
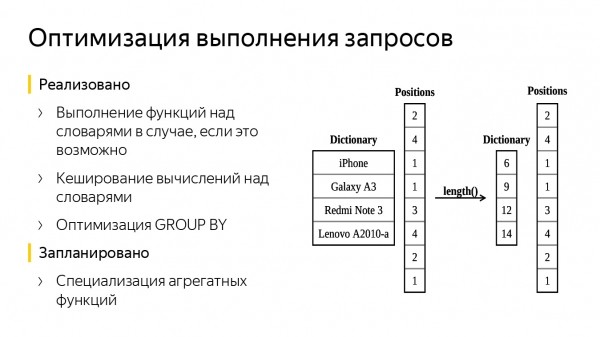
In het woordenboek stonden de namen van mobiele telefoons, we hebben de functie length toegepast. Nu hebben we een vergelijkbaar woordenboek, bestaande alleen uit cijfers - dit zijn de lengtes van de rijen. De kolom met posities is onveranderd gebleven. Uiteindelijk hebben we minder data verwerkt, wat tijd bespaarde bij de query.
Er kunnen ook andere optimalisaties zijn, bijvoorbeeld het toevoegen van een eenvoudige cache. Bij het berekenen van de waarde van een functie kan deze worden onthouden en kan een vergelijkbare worden gemaakt zonder het opnieuw te berekenen.
Er kan ook een optimalisatie van GROUP BY worden uitgevoerd, omdat onze kolom met het woordenboek al gedeeltelijk is geaggregeerd - het kan sneller worden om de waarden van hash-functies te berekenen en ongeveer te vinden in welke bucket de volgende rij moet worden geplaatst. Bovendien kunnen sommige aggregatiefuncties worden gespecialiseerd, bijvoorbeeld uniq, aangezien alleen het woordenboek kan worden verzonden en de posities intact blijven - zo werkt alles sneller. De eerste twee optimalisaties hebben we al in ClickHouse toegevoegd.
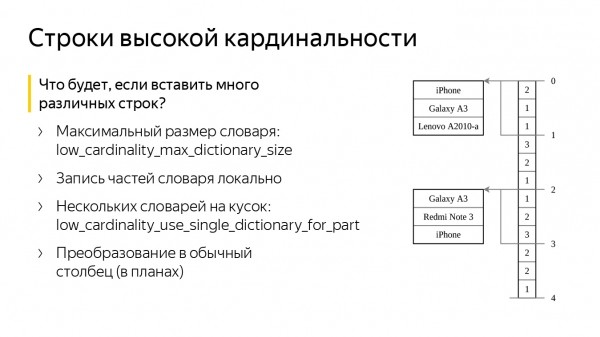
Wat als we een kolom creëren met ons datatypen en we daar veel slechte, verschillende regels in invoegen? Vul ik dan ons geheugen niet te vol? Nee, daarvoor zijn er in ClickHouse twee speciale instellingen. De eerste is low_cardinality_max_dictionary_size. Dit is de maximale grootte van het woordenboek dat op de schijf kan worden geschreven. De invoeging gebeurt als volgt: wanneer we gegevens invoegen, komen er een stroom van regels naar ons toe, waaruit we een groot gezamenlijke woordenboek kunnen vormen. Als het woordenboek groter wordt dan de waarde van de instelling, schrijven we het huidige woordenboek naar de schijf en de andere regels worden ergens "naast" bewaard, naast de indexen. Uiteindelijk zullen we nooit een groot woordenboek opnieuw tellen en zullen we geen geheugenproblemen krijgen.
De tweede instelling heet low_cardinality_use_single_dictionary_for_part. Stel je voor dat in het vorige schema, toen we gegevens invoegden, ons woordenboek vol raakte en we het naar de schijf hebben geschreven. De vraag rijst, waarom zouden we nu niet nog een precies hetzelfde woordenboek vormen?
Wanneer het vol is, schrijven we het opnieuw naar de schijf en beginnen we met het vormen van een derde. Deze instelling schakelt standaard deze mogelijkheid uit.
Eigenlijk kunnen veel woordenboeken nuttig zijn als we een bepaalde set regels willen invoegen, maar per ongeluk "afval" hebben ingevoerd. Laten we zeggen dat we eerst slechte regels hebben ingevoegd en daarna goede. Dan zal het woordenboek zich opsplitsen in veel kleine woordenboeken. Een deel daarvan bevat "afval", maar de laatste zal goede regels bevatten. En als we bijvoorbeeld alleen de laatste fractie lezen, zal alles ook snel werken.
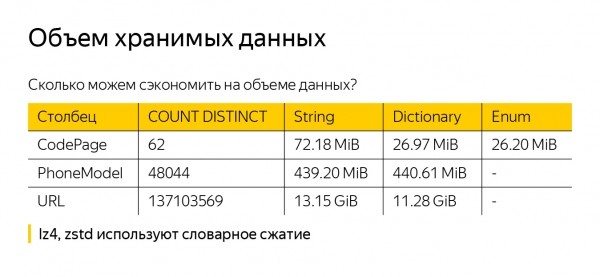
Voordat ik het heb over de voordelen van LowCardinality, moet ik meteen zeggen dat we waarschijnlijk geen vermindering van de gegevens op de schijf zullen bereiken (hoewel dit kan gebeuren), omdat ClickHouse gegevens comprimeert. Er is een standaardoptie — LZ4. Je kunt ook compressie toepassen met ZSTD. Maar beide algoritmes implementeren al woordenboekcompressie, dus ons externe woordenboek ClickHouse zal niet veel helpen.
Om niet ongeldig te zijn, heb ik enkele gegevens uit de metriek genomen — String, LowCardinality(String) en Enum — en deze in verschillende datatypes opgeslagen. Dit resulteerde in drie kolommen met elk één miljard rijen. In de eerste kolom, CodePage, zijn er in totaal 62 waarden. Het is duidelijk dat we ze beter hebben gecomprimeerd in LowCardinality(String). String presteert iets slechter, maar dat komt waarschijnlijk omdat de strings kort zijn; we slaan hun lengte op, en die nemen veel ruimte in beslag en worden slecht gecomprimeerd.
Als we kijken naar PhoneModel, zijn dat er 48.000 — al meer, en de verschillen tussen String en LowCardinality(String) zijn bijna niet merkbaar. Voor URL hebben we ook maar 2 GB bespaard — ik denk niet dat we daarop moeten vertrouwen.
Beoordeling van de snelheid
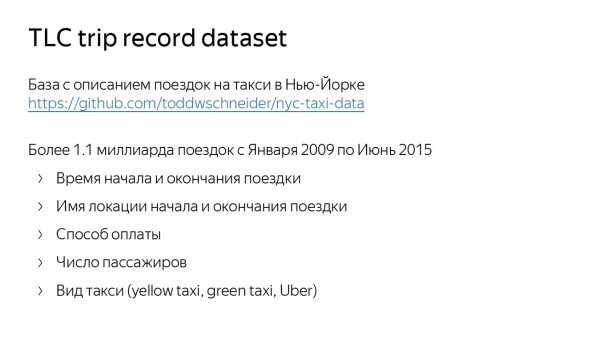
Laten we nu de snelheid beoordelen. Om dit te doen, heb ik een dataset gebruikt met beschrijvingen van taxiritten in New York. Deze is op GitHub. Deze bevat net iets meer dan een miljard ritten. Hierin zijn locatie, start- en eindtijd van de rit, betalingsmethode, aantal passagiers en zelfs het soort taxi — groen, geel en Uber — opgenomen.
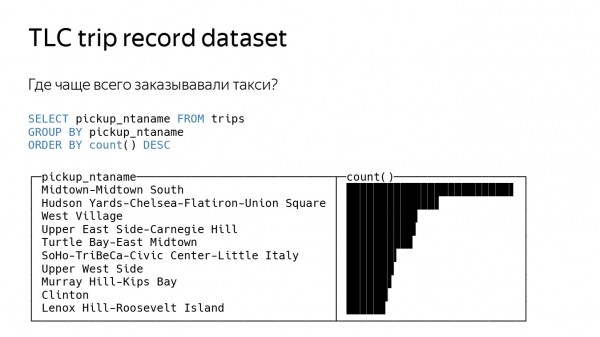
Mijn eerste query heb ik vrij eenvoudig gemaakt — ik vroeg waar het vaakst taxi's worden besteld. Hiervoor moet je de locatie nemen van waar de bestellingen zijn gedaan, deze met GROUP BY groeperen en de functie count tellen. Dit geeft iets terug in ClickHouse.
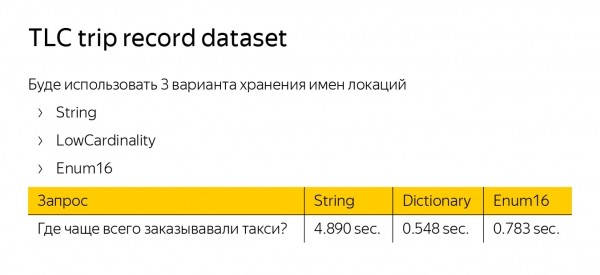
Om de snelheid van de queryverwerking te meten, heb ik drie tabellen gemaakt met dezelfde gegevens, maar heb ik voor onze startlocatie drie verschillende datatypes gebruikt — String, LowCardinality en Enum. LowCardinality en Enum waren vijf keer sneller dan String. Enum is sneller omdat het met nummers werkt. LowCardinality is sneller vanwege de implementatie van de GROUP BY-optimalisatie.
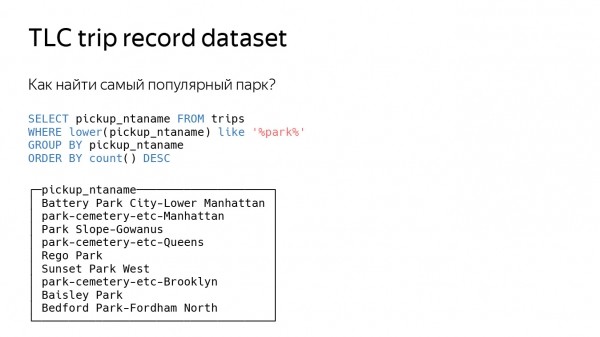
Laten we de query nog ingewikkelder maken — we vragen waar het populairste park in New York is. We zullen opnieuw meten waar de meeste taxi's worden besteld, maar we filteren alleen de locaties met het woord "park". We voegen ook de functie like toe.
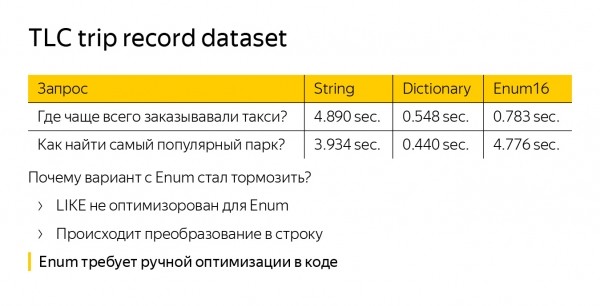
We kijken naar de tijd — we zien dat Enum plotseling trager begon te worden. Het werkt zelfs trager dan het standaard datatype String. Dit gebeurt omdat de functie like helemaal niet is geoptimaliseerd voor Enum. We moeten onze strings van Enum naar gewone strings converteren — we doen meer werk. LowCardinality(String) is ook niet standaard geoptimaliseerd, maar daar werkt like op het woordenboek, waardoor de query versneld wordt in vergelijking met String.
Bij het werken met Enum is er een groter probleem. Als we het willen optimaliseren, moeten we dit op elke plek in de code doen. Stel dat we een nieuwe functie schrijven — we moeten altijd een optimalisatie voor Enum bedenken. Bij LowCardinality is dit standaard geoptimaliseerd.
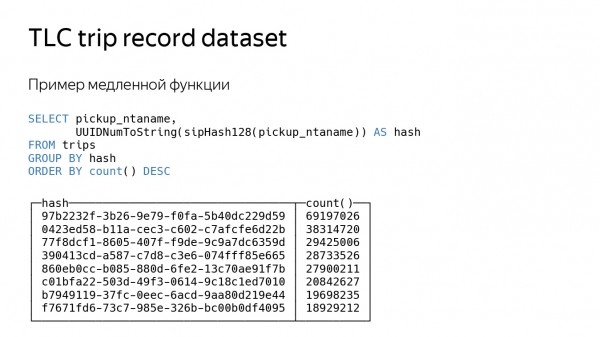
Laten we kijken naar de laatste query, die meer kunstmatig is. We zullen simpelweg de hash-functie van onze locatie berekenen. De hash-functie is een vrij langzame aanvraag, het duurt even, dus alles zal ongeveer drie keer vertraging oplopen.
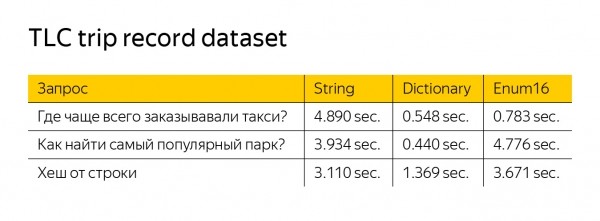
LowCardinality werkt nog steeds sneller, ook al is er geen filtering. Dit komt omdat onze functies alleen op het woordenboek werken. De hash-berekeningsfunctie heeft één argument — deze kan minder gegevens verwerken en ook LowCardinality teruggeven.
Ons mondiale plan is om een snelheid te bereiken die niet lager is dan die van String in welke situatie dan ook, en om de versnellingsvoordelen te behouden. En misschien zullen we op een dag String vervangen door LowCardinality, u werkt ClickHouse bij, en alles zal een beetje sneller werken.
Bron: habr.com
