

De kanarie is een klein vogeltje dat voortdurend zingt. Deze vogeltjes zijn gevoelig voor methaan en koolmonoxide. Zelfs bij een lage concentratie van gasvervuiling in de lucht kunnen ze bewusteloos raken of sterven. Goudzoekers en mijnwerkers namen kanaries mee in de mijn: zolang de kanaries zingen, kan er gewerkt worden; als ze zwijgen, is er gas in de mijn en is het tijd om te vertrekken. Mijnwerkers offerden een klein vogeltje op om levend uit de mijn te komen.
Een soortgelijke praktijk heeft ook zijn weg gevonden in de IT. Bijvoorbeeld bij de standaard taak om een nieuwe versie van een dienst of applicatie naar productie te implementeren, met voorafgaand testen. Een testomgeving kan te duur zijn, geautomatiseerde tests dekken niet alles wat gewenst is, en niet testen terwijl je kwaliteit op het spel zet is riskant. In dergelijke gevallen helpt de approach van Canary Deployment, waarbij een beetje van de echte productie-verkeer op de nieuwe versie wordt losgelaten. Deze aanpak helpt veilig de nieuwe versie in productie, en biedt een kleine opoffering voor een groot doel. Meer details over hoe de aanpak werkt, wat de voordelen zijn en hoe deze geïmplementeerd kan worden, worden gegeven door Andrey Markelov (), aan de hand van een implementatievoorbeeld bij Infobip.
Andrey Markelov — hoofdsysteemingenieur bij Infobip, hij houdt zich al 11 jaar bezig met de ontwikkeling van Java-applicaties in de financiële en telecommunicatiemarkt. Hij ontwikkelt Open Source-producten, neemt actief deel aan de Atlassian Community en schrijft plugins voor Atlassian-producten. Evangelist van Prometheus, Docker en Redis.
Over Infobip
Het is een wereldwijd telecommunicatieplatform dat banken, detailhandel, webshops en transportbedrijven in staat stelt berichten naar hun klanten te sturen via SMS, push, e-mail en spraakberichten. In dit soort bedrijven zijn stabiliteit en betrouwbaarheid cruciaal om ervoor te zorgen dat klanten op tijd berichten ontvangen.
De IT-infrastructuur van Infobip in cijfers:
- 15 datacenters over de hele wereld;
- 500 unieke services in gebruik;
- 2500 exemplaren van services, wat veel meer is dan het aantal teams;
- 4,5 Tbyte maandverkeer;
- 4,5 miljard telefoonnummers;
Het bedrijf groeit, en daarmee het aantal releases. We voeren gemiddeld 60 releases per dag, omdat klanten meer mogelijkheden en capaciteiten willen. Maar dit is moeilijk — er zijn veel services en te weinig teams. We moeten snel code schrijven die zonder fouten in productie werkt.
Releases
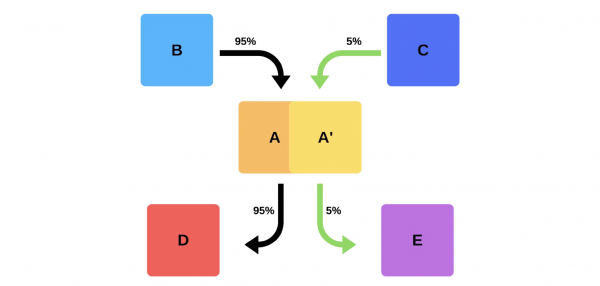
Een typische release bij ons verloopt als volgt. Bijvoorbeeld, er zijn de services A, B, C, D en E, waarvan elke afzonderlijk door een team wordt ontwikkeld.
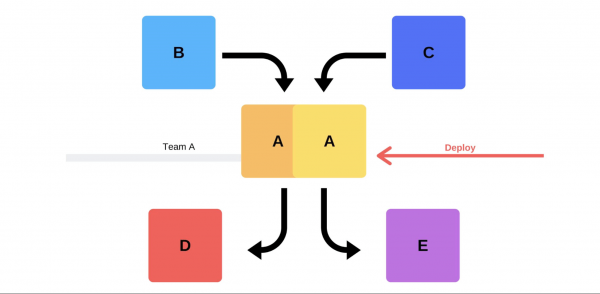
Op een bepaald moment besluit het team van service A een nieuwe versie te deployen, maar de teams van de services B, C, D en E zijn daarvan niet op de hoogte. Er zijn twee mogelijkheden waar het team van service A voor kan kiezen.
Ze zullen een incrementele release uitvoeren: eerst vervangen ze één versie, en daarna de tweede.
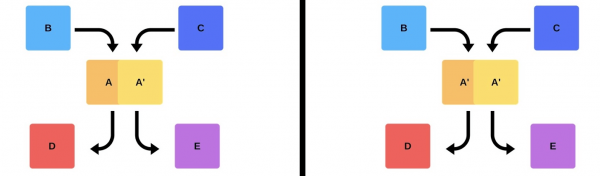
Maar er is een tweede optie: het team vindt extra capaciteit en machines, deployt de nieuwe versie en schakelt vervolgens de router om, zodat de versie live gaat.
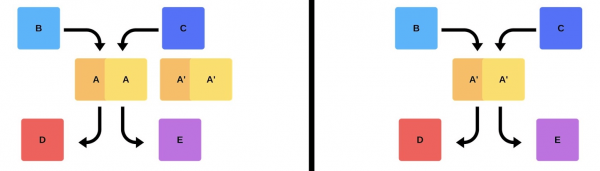
In elk geval ontstaan er bijna altijd problemen na de deploy, zelfs als de versie is getest. Testen kan handmatig, automatisch, of helemaal niet — problemen zullen hoe dan ook optreden. De eenvoudigste en juiste manier om ze op te lossen is om terug te keren naar een werkende versie. Pas daarna kan men zich bezighouden met de schade, de oorzaken en deze verhelpen.
Dus, wat willen we?
We willen geen problemen. Als klanten deze sneller ontdekken dan wij, zal dat onze reputatie schaden. Daarom moeten we problemen eerder vinden dan de klanten.Door proactief te werken, minimaliseren we de schade.
Tegelijk willen we de deploy versnellen,zodat dit snel, eenvoudig, vanzelfsprekend en zonder druk van het team gebeurt. Ingenieurs, DevOps-ingenieurs en programmeurs moeten we koesteren — het uitbrengen van een nieuwe versie is stressvol. Het team is geen verbruiksgoed; we streven ernaar om de menselijke hulpbronnen efficiënt te gebruiken..
Deployproblemen
Het klantverkeer is onvoorspelbaar.Het is onmogelijk te voorspellen wanneer het klantverkeer op zijn laagst zal zijn. We weten niet waar en wanneer klanten hun campagnes starten — misschien vannacht in India, en morgen in Hongkong. Gezien het grote tijdsverschil garandeert een deploy om 2 uur 's nachts niet dat klanten er niet onder lijden.
Problemen met providers.Messengers en providers zijn onze partners. Soms hebben zij storingen die fouten veroorzaken tijdens de deploy van nieuwe versies.
Verspreide teams.De teams die de klantkant en de backend ontwikkelen, bevinden zich in verschillende tijdzones. Hierdoor kunnen ze vaak niet goed met elkaar communiceren.
Datacenters zijn niet te repliceren op de staging.In één datacenter zijn er 200 racks — dit zelfs ongeveer repliceren in een sandbox is niet mogelijk.
Downtimeis unacceptable! We have an acceptable level of availability (Error Budget), where we operate 99.99% of the time, for example, and the remaining percentage is the 'right to fail.' Achieving 100% reliability is impossible, but it's important to constantly monitor for failures and downtime.
Classical solutions
Write code without bugs. When I was a young developer, managers would approach me asking to release without bugs, but that's not always possible.
Write tests. Tests work, but sometimes not in the way the business wants. Making money is not the job of tests.
Test on staging. In my 3.5 years at Infobip, I have never seen staging even partially match production.
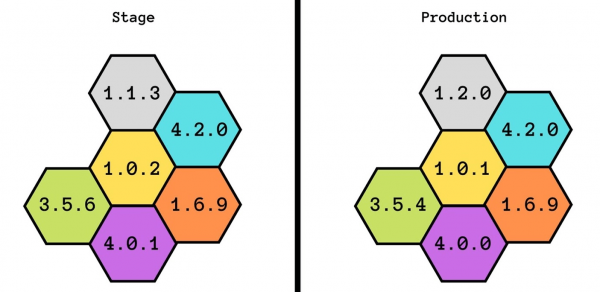
We even tried to develop this idea: first we had staging, then pre-production, and then pre-production of pre-production. But that didn't help either — they didn't even match in capacity. With staging, we can guarantee basic functionality, but we don't know how it will perform under load.
The release is done by the one who developed it. This is good practice: even if someone changes a comment's title, they immediately add it to production. This helps develop accountability and not forget about the changes made.
Additional complexities also exist. For a developer, it's stressful to spend a lot of time checking everything manually.
Coordinated releases. This option is usually proposed by management: 'Let's agree that you'll test and add new versions every day.' This doesn't work: there is always a team waiting for everyone else or vice versa.
Smoke tests
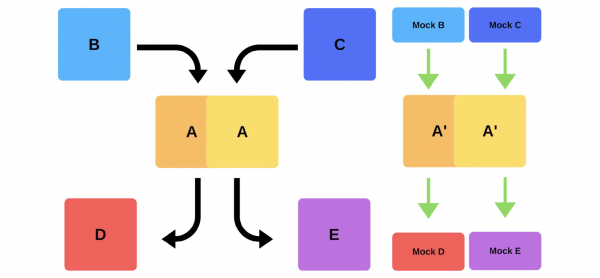
Another way to solve our deployment issues. Let's consider how smoke tests work in the previous example when Team A wants to deploy a new version.
First, the team deploys one instance to production. Messages in the instance from mocks simulate real traffic, so it matches normal daily traffic. If everything is fine, the team switches the new version to user traffic.
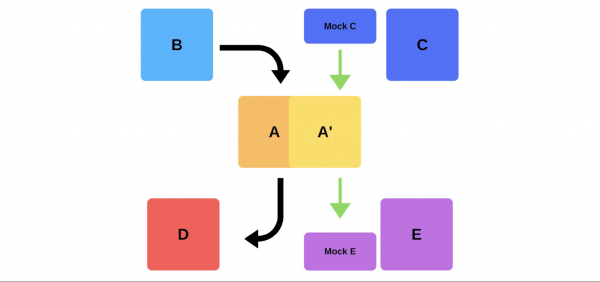
The second option is to deploy with additional hardware. The team tests it in production, then switches it, and everything works.
Disadvantages of smoke tests:
- Je kunt niet vertrouwen op tests. Waar vind je hetzelfde verkeer als in productie? Je kunt het verkeer van gisteren of van een week geleden gebruiken, maar dat komt niet altijd overeen met het huidige.
- Moeilijk te onderhouden. Je moet testaccounts blijven onderhouden en deze steeds opnieuw instellen voor elke deploy, wanneer actieve records naar de opslag worden gestuurd. Dit is moeilijker dan het schrijven van een test in je eigen sandbox.
De enige bonus hier is je kunt de prestaties testen.
Canary-releases
Vanwege de tekortkomingen van smoke-tests zijn we begonnen met het gebruiken van canary-releases.
Een praktijkt die vergelijkbaar is met hoe mijnwerkers kanaries gebruikten om het gasniveau aan te geven, heeft ook zijn weg gevonden in IT. We laten een beetje echt productie-verkeer naar de nieuwe versie gaan, terwijl we proberen binnen de Service Level Agreement (SLA) te blijven. SLA is ons 'recht op fouten', dat we één keer per jaar (of op een andere tijdsperiode) kunnen gebruiken. Als alles goed gaat, voegen we meer verkeer toe. Als dat niet het geval is, zetten we de vorige versies terug.
Implementatie en nuances
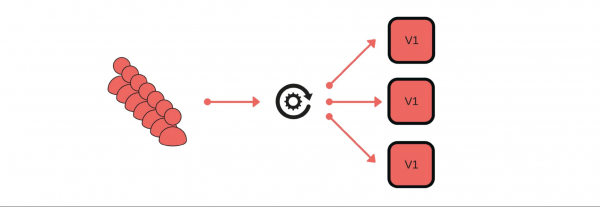
Hoe hebben we canary-releases geïmplementeerd? Bij voorbeeld, een groep klanten verzendt berichten via onze service.
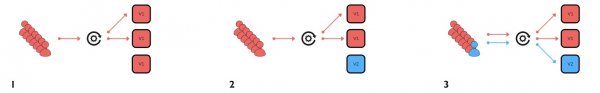
De deploy gebeurt als volgt: we halen één knooppunt uit de load balancer (1), we updaten de versie (2) en laten apart een beetje verkeer gaan (3).
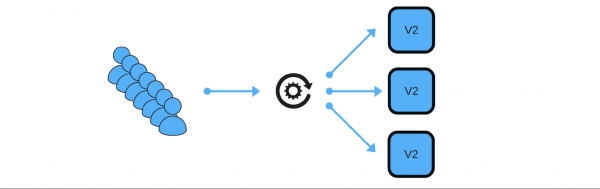
Over het algemeen zullen alle leden van de groep gelukkig zijn, zelfs als één gebruiker niet tevreden is. Als alles goed gaat, updaten we alle versies.
Ik zal schematisch laten zien hoe dit in de meeste gevallen voor microservices eruit ziet.
Er is Service Discovery en nog twee services: S1N1 en S2. De eerste service (S1N1) informeert Service Discovery wanneer hij start, en Service Discovery onthoudt dat. De tweede service met twee knooppunten (S2N1 en S2N2) informeert ook Service Discovery bij de start.
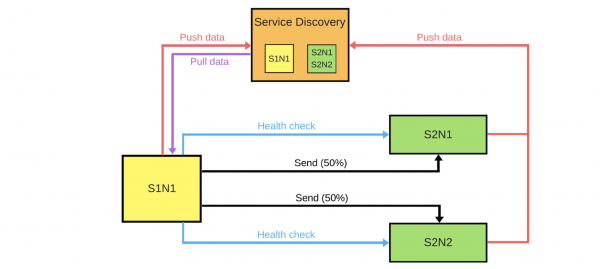
De tweede service functioneert voor de eerste als server. De eerste vraagt Service Discovery om informatie over zijn servers en zoekt en controleert ze wanneer hij deze ontvangt ('health check'). Wanneer dit is gebeurd, stuurt hij berichten naar hen.
Wanneer iemand een nieuwe versie van de tweede service wil deployen, laat hij Service Discovery weten dat de tweede node een canary-node zal zijn: er zal minder verkeer naar deze node worden gestuurd omdat de deploy nu zal plaatsvinden. We halen de canary-node uit de load balancer en de eerste service stuurt geen verkeer naar deze node.
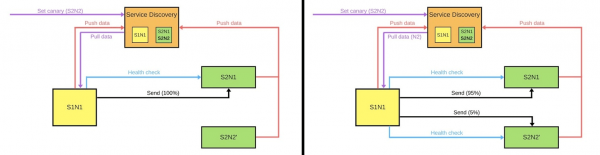
We change the version, and Service Discovery knows that the second node is now a canary — we can give it less load (5%). If everything goes well, we change the version, restore the load, and continue working.
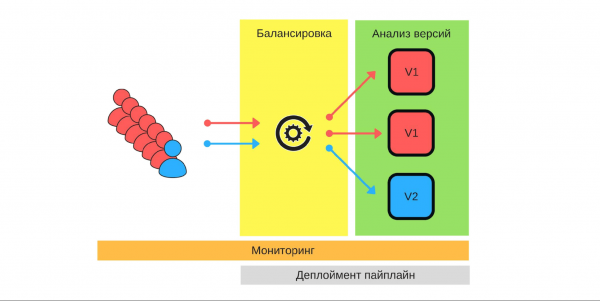
To implement all this, we need:
- load balancing;
- monitoring, as it’s important to know what each user expects and how our services are functioning in detail;
- version analysis, to understand how well the new version will perform in production;
- die het mogelijk maakt om veel sneller nieuwe functionaliteit te testen, in te zetten en aan gebruikers te leveren. Bijvoorbeeld, in al onze projecten wordt bij elke commit automatisch een CI-pijplijn aangemaakt. Hierin wordt een beeld opgebouwd, getest, uitgerold in verschillende Kubernetes-omgevingen voor debugging en resterende controles, en als alles goed is — komen de wijzigingen bij de eindgebruiker aan. En dit is al lang geen rocket science meer, maar dagelijkse kost voor velen — waarschijnlijk ook voor u, aangezien u dit artikel leest. — we write the deployment sequence (deployment pipeline).
Load Balancing
This is the first thing we need to consider. There are two balancing strategies.
The simplest option is where one node is always a canary. This node always receives less traffic, and we start the deployment from it. In case of issues, we can compare its performance before and during the deployment. For example, if errors double, then the damage has also doubled.
The canary node is determined during the deployment. Once the deployment finishes and we remove the canary status from it, the traffic balance is restored. With fewer machines, we achieve a fair distribution.
Monitoring
The cornerstone of canary releases. We must clearly understand why we are doing this and what metrics we want to collect.
Examples of metrics that we gather from our services.
- The number of errors, which are logged. This is an obvious indicator that everything is functioning as it should. Overall, it’s a good metric.
- Response time (latency). This metric is monitored by everyone because everyone wants to work quickly.
- Queue size (throughput).
- The number of successful responses per second.
- Response time for 95% of all requests.
- Business metrics: how much money the business earns over a certain period or user churn. These metrics for our new version may be more important than those provided by engineers.
Examples of metrics in most popular monitoring systems.
Counter. This is an increasing value, for example, the number of errors. This metric is easy to interpolate and study the graph: there were 2 errors yesterday, and today there are 500, which means something went wrong.
The number of errors per minute or second is a crucial indicator that can be calculated using the Counter. This data provides a clear picture of the system's performance over time. Let's consider an example of the error rate per second for two versions of the production system.
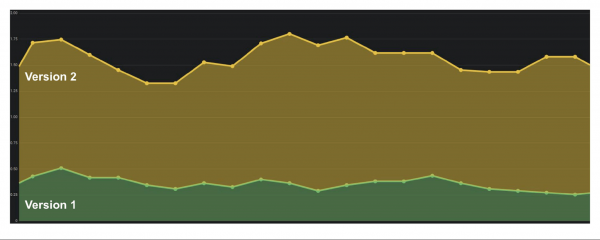
In de eerste versie waren er weinig fouten, mogelijk werkte de audit niet. In de tweede versie is alles veel erger. We kunnen met zekerheid zeggen dat er problemen zijn, dus we moeten deze versie terugdraaien.
Gauge. Metrics lijken op Counter, maar we registreren waarden die zowel kunnen toenemen als afnemen. Bijvoorbeeld de verwerkingstijd van verzoeken of de grootte van de wachtrij.
Op de grafiek staat een voorbeeld van de responstijd (latency). Aan de grafiek is te zien dat de versies vergelijkbaar zijn, en ermee kan worden gewerkt. Maar als je goed kijkt, zie je hoe de waarde verandert. Als de verwerkingstijd toeneemt bij het toevoegen van gebruikers, dan is het duidelijk dat er problemen zijn — dat was eerder niet zo.
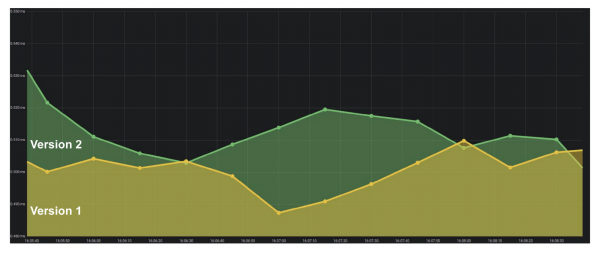
Summary. Een van de belangrijkste indicatoren voor het bedrijf zijn percentielen. De metric toont aan dat in 95% van de gevallen ons systeem werkt zoals we willen. We kunnen ermee omgaan als er hier en daar problemen zijn, omdat we de algemene trend begrijpen, hoe goed of slecht alles gaat.
Hulpmiddelen
ELK Stack. Canary kan worden geïmplementeerd met Elasticsearch — we registreren fouten daarin wanneer zich gebeurtenissen voordoen. Met een eenvoudige API-aanroep kun je het aantal fouten op elk moment ophalen en vergelijken met eerdere periodes: GET /applg/_cunt?q=level:errr.
Prometheus. Werd goed gebruikt in Infobip. Het stelt ons in staat om multidimensionale metrics te realiseren, omdat labels worden gebruikt.
We kunnen gebruiken level, instance, voor het SystemD-initiesysteem:, deze combineren in één systeem. Met offset kun je bijvoorbeeld de waarde van een metric van een week geleden bekijken met slechts één opdracht GET /api/v1/query?query={query}, waar {query}:
rate(logback_appender_total{
    level="error",
    instance=~"$instance"
}[5m] offset $offset_value)
Versie-analyse
Er zijn verschillende analysemethoden voor versies.
Kijk alleen naar de metrics van de canary-node. Een van de eenvoudigste opties: we hebben een nieuwe versie uitgerold en bestuderen alleen de werking. Maar als een ingenieur in die tijd de logs gaat bekijken en nerveus pagina's blijft vernieuwen, dan verschilt deze aanpak niet van de andere.
De canary-node wordt vergeleken met elke andere node. Dit is een vergelijking met andere instanties die op volledige traffic draaien. Als de prestaties met een klein verkeer slechter zijn, of niet beter dan op de echte instanties, dan klopt er iets niet.
De canary-node wordt vergeleken met zichzelf in het verleden. Nodes assigned for canary can be compared with historical data. For example, if everything was fine a week ago, we can use this data to understand the current situation.
Automatisering
We want to free engineers from manual comparison, so it's important to implement automation. The deployment process usually looks like this:
- start;
- remove the node from the load balancer;
- set up the canary node;
- enable the load balancer with a limited amount of traffic;
- compare.
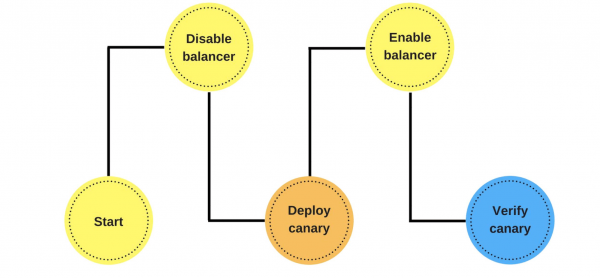
At this stage, we implement automatic comparison. What it can look like and why it's better than post-deployment checks will be discussed with an example from Jenkins.
This is a pipeline to Groovy.
while (System.currentTimeMillis() < endCanaryTs) {
    def isOk = compare(srv, canary, time, base, offset, metrics)
    if (isOk) {
        sleep DEFAULT SLEEP
    }   else {
        echo "Canary failed, need to revert"
        return false
    }
}
Here, in the loop, we specify that we will compare the new node for an hour. If the canary process has not finished yet, we call the function. It reports whether everything is okay or not: def isOk = compare(srv, canary, time, base, offset, metrics).
If everything is fine — sleep DEFAULT SLEEP, for example, for a second, and continue. If not, we exit — the deployment failed.
Description of the metric. Let's look at how the function compare can look like with a DSL example.
metric(
    'errorCounts',
    'rate(errorCounts{node=~"$canaryInst"}[5m] offset $offset)',
    {   baseValue, canaryValue ->
        if (canaryValue > baseValue * 1.3) return false
        return true
    }
)
Suppose we are comparing the number of errors and want to find out the number of errors per second over the last 5 minutes.
We have two values: base and canary node. The value at the canary node is the current one. The base is baseValue — this is the value of any other non-canary node. We compare the values against the formula we set based on our experience and observations. If the value of canaryValue is poor, then the deployment failed and we roll back.
Why do we need all this?
A person cannot check hundreds or thousands of metrics, especially not quickly. Automatic comparison helps check all metrics and alerts about problems rapidly. The notification time is critical: if something happened in the last 2 seconds, the damage will not be as significant as if it had occurred 15 minutes ago. By the time someone notices the issue, contacts support, and support tells us to roll back, we could lose clients.
Als het proces is verlopen en alles goed is, implementeren we automatisch alle andere knooppunten. In die tijd doen ingenieurs niets. Alleen wanneer ze de canary starten, beslissen ze welke metrics ze moeten nemen, hoe lang de vergelijking moet duren en welke strategie te gebruiken.
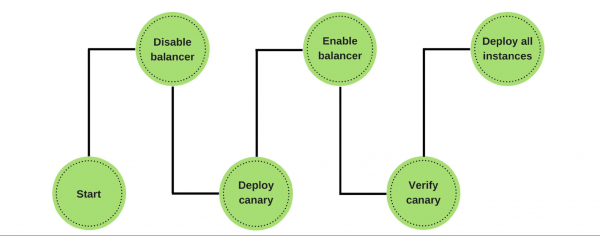
Als er problemen zijn, rollen we de canary-knoop automatisch terug, werken we met eerdere versies en lossen we de gevonden fouten op. Aan de hand van de metrics zijn ze gemakkelijk te vinden en de schade door de nieuwe versie te zien.
Obstakels
Dit is natuurlijk niet eenvoudig te realiseren. Allereerst is er een gemeenschappelijk monitoringssysteem. Ingenieurs hebben hun eigen metrics, het ondersteuningsteam en de analisten hebben andere, en de business weer derde. Een gemeenschappelijk systeem is de gemeenschappelijke taal waarmee business en ontwikkeling communiceren.
We moeten het in de praktijk controleren de stabiliteit van de metrics. De controle helpt te begrijpen, welk minimaal aantal metrics nodig is om kwaliteit te waarborgen..
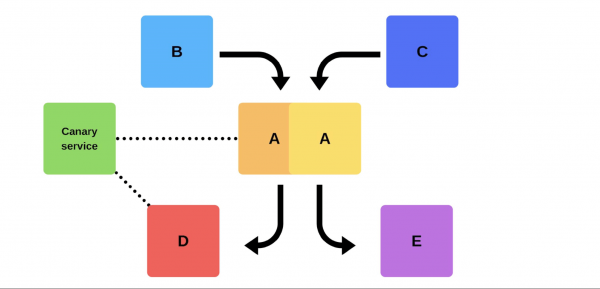
Hoe bereiken we dit? Gebruik de canary-service niet op het moment van implementatie. We voegen een bepaalde service op de oude versie toe, die op elk moment een voorgeschreven knoop kan nemen en het verkeer kan verminderen zonder te implementeren. Vervolgens vergelijken we: bestuderen we de fouten en zoeken we naar de grens waarop we de kwaliteit bereiken.
Wat voor voordelen hebben we gehaast met canary-releases?
We hebben het percentage schade door bugs geminimaliseerd. De meeste implementatiefouten ontstaan door inconsistentie in bepaalde gegevens of prioriteiten. Dergelijke fouten zijn veel minder geworden, omdat we problemen in de eerste seconden kunnen oplossen.
We hebben de werking van teams geoptimaliseerd. Nieuwe medewerkers hebben een 'recht op een fout': ze kunnen implementeren in productie zonder bang te zijn om fouten te maken, wat extra initiatief en motivatie om te werken met zich meebrengt. Als ze iets stuk maken, is het niet kritiek en worden ze niet ontslagen.
We hebben de implementatie geautomatiseerd.Het is al geen handmatig proces meer, zoals vroeger, maar een echte geautomatiseerde. Maar het duurt langer.
We hebben belangrijke metrics выделили.Het hele bedrijf, van de business tot de ingenieurs, begrijpt wat echt belangrijk is in ons product, welke metrics, zoals het verloop en de instroom van gebruikers. We controleren het proces: testen metrics, introduceren nieuwe, bekijken hoe de oude werken, om een systeem te bouwen dat efficiënter geld verdient.
Wij hebben veel handige praktijken en systemen die ons helpen. Desondanks streven we ernaar professionals te zijn en ons werk van hoge kwaliteit te doen, ongeacht of we een systeem hebben dat ons ondersteunt of niet.
Engineeringsbenaderingen en praktijken — . Als je successen hebt behaald op weg naar technische perfectie en bereid bent te delen wat je daarbij heeft geholpen, — .
We zijn van plan om 8 juni te houden. We begrijpen dat het momenteel moeilijk is om beslissingen te nemen over deelname aan conferenties. Maar tegelijkertijd denken we dat quarantaine geen reden is om professioneel contact en ontwikkeling stop te zetten. Daarom zullen we op de een of andere manier een manier vinden om de uitdagingen van een techlead en de benaderingen voor het oplossen daarvan te bespreken — als dat nodig is, gaan we online en zetten we netwerken daar op!
Bron: habr.com
