

Deze notitie is interessant voor degenen die de data-verwerkingsbibliotheek voor R - data.table gebruiken, en misschien blij zijn met de flexibiliteit van het gebruik ervan aan de hand van verschillende voorbeelden.
Geïnspireerd door een goed voorbeeld , en hopend dat je zijn artikel al hebt gelezen, stel ik voor om dieper in te gaan op code-optimalisatie en prestaties op basis van data.table.
Inleiding: waar komt data.table vandaan?
Het is het beste om de bibliotheek iets van een afstand te leren kennen, namelijk via de datastructuren waaruit een data.table-object (verder, DT) kan worden verkregen.
Array
Code
## arrays ---------

arrmatr <- array(1:20, c(4,5))

class(arrmatr)

typeof(arrmatr)

is.array(arrmatr)

is.matrix(arrmatr)
Een van zulke structuren is een array (?base::array). Net als in andere talen zijn arrays hier meer-dimensionaal. Interessant is echter dat, bijvoorbeeld, een twee-dimensionale array eigenschappen begint over te nemen van de matrix-klasse (?base::matrix), terwijl een één-dimensionale array, wat ook belangrijk is, geen eigenschappen overneemt van een vector (?base::vector).
Het is belangrijk om te begrijpen dat het type gegevens in een object moet worden gecontroleerd met de functie base::typeof, die een interne beschrijving van het type retourneert volgens R Internals — het algemene protocol van de taal, gerelateerd aan de oorsprong. C.
Een ander commando om de klasse van een object te bepalen, base::class, retourneert in het geval van vectoren het vector-type (dat verschilt in naam van de interne, maar helpt ook om het datatype te begrijpen).
Lijst
Van een twee-dimensionale array, ook wel matrix genoemd, kan men naar een lijst gaan (?base::list).
Code
## lists ------------------

mylist <- as.list(arrmatr)

is.vector(mylist)

is.list(mylist)
Bij dit proces gebeurt er meerdere dingen tegelijkertijd:
- De tweede dimensie van de matrix wordt samengevoegd, wat betekent dat we tegelijkertijd zowel een lijst als een vector ontvangen.
- Een lijst, zo gezien, erft van deze klassen. Men moet zich realiseren dat een element van de lijst correspondeert met één (scalair) waarde uit de cel van de matrix-array.
Aangezien de lijst ook een vector is, kunnen sommige functies voor vectoren op hem worden toegepast.
Dataframe
Van een lijst, matrix of vector kan men naar een dataframe (?base::data.frame).
Code
## data.frames ------------

df <- as.data.frame(arrmatr)
df2 <- as.data.frame(mylist)

is.list(df)

df$V6 <- df$V1 + df$V2
Wat interessant is: een dataframe erft van een lijst! De kolommen van het dataframe zijn cellen van de lijst. Dit zal belangrijk zijn in de toekomst, wanneer we functies gebruiken die voor lijsten zijn bedoeld.
data.table
Een DT (?data.table::data.table) kan worden verkregen uit een dataframe, een lijst, vector of matrix. Bijvoorbeeld, zo (in place).
Code
## data.tables -----------------------
library(data.table)

data.table::setDT(df)

is.list(df)

is.data.frame(df)

is.data.table(df)
Nuttig is dat, net als een dataframe, een DT eigenschappen erft van een lijst.
DT en geheugen
In tegenstelling tot alle andere objecten in R base, worden data.tables per referentie doorgegeven. Als je een kopie naar een nieuw geheugengebied wilt maken, heb je een functie nodig data.table::copy of je moet een selectie uit het oude object maken.
Code
df2 <- df

df[V1 == 1, V2 := 999]

data.table::fsetdiff(df, df2)

df2 <- data.table::copy(df)

df[V1 == 2, V2 := 999]

data.table::fsetdiff(df, df2)
Met deze inleiding komen we aan het einde. Data.table is een voortzetting van de ontwikkeling van gegevensstructuren in R, die voornamelijk plaatsvindt door het uitbreiden en versnellen van de bewerkingen die worden uitgevoerd op objecten van de klasse dataframe. Hierbij blijft de erfelijkheid van andere primitieven behouden.
Enkele voorbeelden van het gebruik van de eigenschappen van data.table
Als een lijst...
Itereren over de rijen van een dataframe of data.table is meestal geen goed idee, omdat de code van de lus in de taal R veel langzamer is C, maar het doorlopen van kolommen, die meestal veel minder zijn, is prima mogelijk. Als we door de kolommen gaan, moeten we ons herinneren dat elke kolom een element van de lijst is, dat meestal een vector bevat. Bewerkingen op vectoren zijn goed gevectoriseerd in de basale functies van de taal. Ook kunnen we de selectieoperatoren gebruiken die kenmerkend zijn voor lijsten en vectors: `[[`, `$`.
Code
## operations on data.tables ------------

#using list properties

df$'V1'[1]

df[['V1']]

df[[1]][1]

sapply(df, class)

sapply(df, function(x) sum(is.na(x)))
Vectorisatie
Als het nodig is om door de rijen van een grote data.table te lopen, is het beste om een functie met vectorisatie te schrijven. Maar als dit niet lukt, moet je je herinneren dat de lus binnenin data.table nog steeds sneller is dan de lus in R, omdat het wordt uitgevoerd op C.
Laten we een groter voorbeeld proberen met 100K rijen. We gaan de eerste letter uit de woorden in de vector-kolom halen w.
Bijgewerkt
Code
library(magrittr)
library(microbenchmark)

## Groter voorbeeld ----

rown <- 100000

dt %
	.[, d := 1 + b + c + rnorm(nrow(.))]

# vectorisatie

microbenchmark({
	dt[
		, first_l := unlist(strsplit(w, split = ' ', fixed = T))[1]
		, by = 1:nrow(dt)
	   ]
})

# tweede

first_l_f %
		do.call(rbind, .) %>%
		`[`(,1)
}

dt[, first_l := NULL]

microbenchmark({
	dt[
		, first_l := .(first_l_f(w))
		]
})

# derde

first_l_f2 %
		unlist %>%
		matrix(nrow = 3) %>%
		`[`(1,)
}

dt[, first_l := NULL]

microbenchmark({
	dt[
		, first_l := .(first_l_f2(w))
		]
})
Eerste run met iteratie over de rijen:
Eenheden: milliseconden
expr min
{ dt[, `:=`(first_l, unlist(strsplit(w, split = " ", fixed = T))[1]), by = 1:nrow(dt)] } 439.6217
lq mean median uq max neval
451.9998 460.1593 456.2505 460.9147 621.4042 100
De tweede ronde, waarbij de vectorisatie gebeurt door de lijst om te zetten naar een matrix en het nemen van elementen bij index 1 (dat is in feite de vectorisatie). Laat me dit verduidelijken: vectorisatie op functieniveau. strsplit, die in staat is een vector als invoer te accepteren. Blijkt dat de procedure om een lijst om te zetten naar een matrix veel zwaarder is dan de vectorisatie zelf, maar in dit geval ook veel sneller dan de niet-gevectoriseerde variant.
Eenheden: milliseconden
expr min lq mean median uq max neval
{ dt[, `:=`(first_l, .(first_l_f(w)))] } 93.07916 112.1381 161.9267 149.6863 185.9893 442.5199 100
Versnelling op de mediaan met 3 keer.
De derde ronde, waar het schema voor het omzetten naar een matrix is veranderd.
Eenheden: milliseconden
expr min lq mean median uq max neval
{ dt[, `:=`(first_l, .(first_l_f2(w)))] } 32.60481 34.13679 40.4544 35.57115 42.11975 222.972 100
Versnelling op de mediaan met 13 keer.
Wat betreft deze kwestie moet geëxperimenteerd worden, hoe meer, hoe beter.
Nog een voorbeeld van vectorisatie, waar ook tekst in voorkomt, maar dichter bij de werkelijke omstandigheden: verschillende woordlengtes, een verschillend aantal woorden. We moeten de eerste 3 woorden eruit halen. Zo:
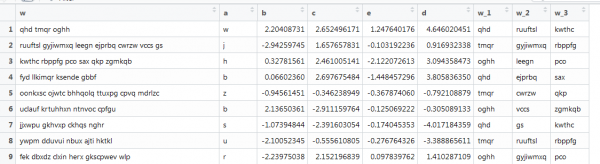
Hier werkt de vorige functie niet meer, omdat de vectoren verschillende lengtes hebben, terwijl we de matrixgrootte hebben gedefinieerd. We zullen dit aanpassen, door op internet te zoeken.
Code
# fourth

rown <- 100000

words <-
	sapply(
		seq_len(rown)
		, function(x){
			nwords <- rbinom(1, 10, 0.5)
			paste(
				sapply(
					seq_len(nwords)
					, function(x){
						paste(sample(letters, rbinom(1, 10, 0.5), replace = T), collapse = '')
					}
				)
				, collapse = ' '
			)
		}
	)

dt <-
	data.table(
		w = words
		, a = sample(letters, rown, replace = T)
		, b = runif(rown, -3, 3)
		, c = runif(rown, -3, 3)
		, e = rnorm(rown)
	) %>%
	.[, d := 1 + b + c + rnorm(nrow(.))]

first_l_f3 <- function(sd, n)
{
	l <- strsplit(sd, split = ' ', fixed = T)

	maxl <- max(lengths(l))

	sapply(l, "length<-", maxl) %>%
		`[`(n,) %>%
		as.character
}

microbenchmark({
	dt[
		, (paste0('w_', 1:3)) := lapply(1:3, function(x) first_l_f3(w, x))
		]
})

dt[
	, (paste0('w_', 1:3)) := lapply(1:3, function(x) first_l_f3(w, x))
	]
Eenheden: milliseconden
expr min lq mean median
{ dt[, `:=`((paste0(«w_», 1:3)), strsplit(w, split = " ", fixed = T))] } 851.7623 916.071 1054.5 1035.199
uq max neval
1178.738 1356.816 100
Het script draaide met een gemiddelde snelheid van 1 seconde. Niet slecht.
Verbanden in een keten...
Met DT-objecten kan gewerkt worden door chaining. Dit ziet eruit als het aanhangen van haakjes rechts, eigenlijk is het suiker.
Code
# chaining

res1 <- dt[a == 'a'][sample(.N, 100)]

res2 <- dt[, .N, a][, N]

res3 <- dt[, coefficients(lm(e ~ d))[1], a][, .(letter = a, coef = V1)]
Stroomt door de buizen...
Dergelijke bewerkingen kunnen via piping worden uitgevoerd, het ziet er vergelijkbaar uit, maar is functioneel rijker, omdat je elk methoden kunt gebruiken, en niet alleen DT. We zullen de coëfficiënten van de logistische regressie voor onze synthetische gegevens met verschillende filters op DT afleiden.
Code
# piping

samplpe_b <- dt[a %in% head(letters), sample(b, 1)]

res4 <-
	dt %>%
	.[a %in% head(letters)] %>%
	.[,
	  {
	  	dt0 <- .SD[1:100]

	  	quants <-
	  		dt0[, c] %>%
	  		quantile(seq(0.1, 1, 0.1), na.rm = T)

	  	.(q = quants)
	  }
	  , .(cond = b > samplpe_b)
	  ] %>%
	glm(
		cond ~ q -1
		, family = binomial(link = "logit")
		, data = .
	) %>%
	summary %>%
	.[[12]]
Statistieken, machine learning en meer binnen DT
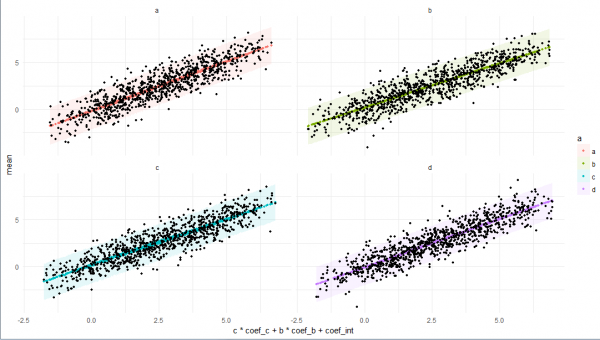
Lambda-functies kunnen worden gebruikt, maar soms is het beter om ze apart te creëren, de hele gegevensanalyse-pijplijn vast te leggen en vooruit — ze werken binnen DT. Het voorbeeld is verrijkt met alle hierboven genoemde functies, plus een paar nuttige dingen uit de DT-arsenaal (zoals toegang tot DT zelf binnen DT via referentie, soms niet opvolgend, maar om het te laten werken).
Code
# function

rm(lm_preds)

lm_preds <- function(
	sd, by, n
)
{

	if(
		n < 100 |
		!by[['a']] %in% head(letters, 4)
	   )
	{

		res <-
			list(
				low = NA
				, mean = NA
				, high = NA
				, coefs = NA
			)

	} else {

		lmm <-
			lm(
				d ~ c + b
				, data = sd
			)

		preds <-
			stats::predict.lm(
				lmm
				, sd
				, interval = "prediction"
				)

		res <-
			list(
				low = preds[, 2]
				, mean = preds[, 1]
				, high = preds[, 3]
				, coefs = coefficients(lmm)
			)
	}

	res

}

res5 <-
	dt %>%
	.[e < 0] %>%
	.[.[, .I[b > 0]]] %>%
	.[, `:=` (
		low = as.numeric(lm_preds(.SD, .BY, .N)[[1]])
		, mean = as.numeric(lm_preds(.SD, .BY, .N)[[2]])
		, high = as.numeric(lm_preds(.SD, .BY, .N)[[3]])
		, coef_c = as.numeric(lm_preds(.SD, .BY, .N)[[4]][1])
		, coef_b = as.numeric(lm_preds(.SD, .BY, .N)[[4]][2])
		, coef_int = as.numeric(lm_preds(.SD, .BY, .N)[[4]][3])
	)
	, a
	] %>%
	.[!is.na(mean), -'e', with = F]


# plot

plo <-
	res5 %>%
	ggplot +
	facet_wrap(~ a) +
	geom_ribbon(
		aes(
			x = c * coef_c + b * coef_b + coef_int
			, ymin = low
			, ymax = high
			, fill = a
		)
		, size = 0.1
		, alpha = 0.1
	) +
	geom_point(
		aes(
			x = c * coef_c + b * coef_b + coef_int
			, y = mean
			, color = a
		)
		, size = 1
	) +
	geom_point(
		aes(
			x = c * coef_c + b * coef_b + coef_int
			, y = d
		)
		, size = 1
		, color = 'black'
	) +
	theme_minimal()

print(plo)
Conclusie
Ik hoop dat ik een samenhangend, maar natuurlijk niet volledig, beeld heb kunnen schetsen van een object zoals data.table, beginnend bij de eigenschappen die te maken hebben met de erfelijkheid van R-klassen en eindigend bij de eigen functies en omgeving van de elementen van tidyverse. Ik hoop dat dit je helpt om deze bibliotheek beter te leren gebruiken voor werk en vermaak.
Bedankt!
Volledige code
Code
## load libs ----------------

library(data.table)
library(ggplot2)
library(magrittr)
library(microbenchmark)


## arrays ---------

arrmatr <- array(1:20, c(4,5))

class(arrmatr)

typeof(arrmatr)

is.array(arrmatr)

is.matrix(arrmatr)


## lists ------------------

mylist <- as.list(arrmatr)

is.vector(mylist)

is.list(mylist)


## data.frames ------------

df <- as.data.frame(arrmatr)

is.list(df)

df$V6 <- df$V1 + df$V2


## data.tables -----------------------

data.table::setDT(df)

is.list(df)

is.data.frame(df)

is.data.table(df)

df2 <- df

df[V1 == 1, V2 := 999]

data.table::fsetdiff(df, df2)

df2 <- data.table::copy(df)

df[V1 == 2, V2 := 999]

data.table::fsetdiff(df, df2)


## operations on data.tables ------------

#using list properties

df$'V1'[1]

df[['V1']]

df[[1]][1]

sapply(df, class)

sapply(df, function(x) sum(is.na(x)))


## Bigger example ----

rown <- 100000

dt <-
	data.table(
		w = sapply(seq_len(rown), function(x) paste(sample(letters, 3, replace = T), collapse = ' '))
		, a = sample(letters, rown, replace = T)
		, b = runif(rown, -3, 3)
		, c = runif(rown, -3, 3)
		, e = rnorm(rown)
	) %>%
	.[, d := 1 + b + c + rnorm(nrow(.))]

# vectorization

# zero - for loop

microbenchmark({
	for(i in 1:nrow(dt))
		{
		dt[
			i
			, first_l := unlist(strsplit(w, split = ' ', fixed = T))[1]
		]
	}
})

# first

microbenchmark({
	dt[
		, first_l := unlist(strsplit(w, split = ' ', fixed = T))[1]
		, by = 1:nrow(dt)
	   ]
})

# second

first_l_f <- function(sd)
{
	strsplit(sd, split = ' ', fixed = T) %>%
		do.call(rbind, .) %>%
		`[`(,1)
}

dt[, first_l := NULL]

microbenchmark({
	dt[
		, first_l := .(first_l_f(w))
		]
})

# third

first_l_f2 <- function(sd)
{
	strsplit(sd, split = ' ', fixed = T) %>%
		unlist %>%
		matrix(nrow = 3) %>%
		`[`(1,)
}

dt[, first_l := NULL]

microbenchmark({
	dt[
		, first_l := .(first_l_f2(w))
		]
})

# fourth

rown <- 100000

words <-
	sapply(
		seq_len(rown)
		, function(x){
			nwords <- rbinom(1, 10, 0.5)
			paste(
				sapply(
					seq_len(nwords)
					, function(x){
						paste(sample(letters, rbinom(1, 10, 0.5), replace = T), collapse = '')
					}
				)
				, collapse = ' '
			)
		}
	)

dt <-
	data.table(
		w = words
		, a = sample(letters, rown, replace = T)
		, b = runif(rown, -3, 3)
		, c = runif(rown, -3, 3)
		, e = rnorm(rown)
	) %>%
	.[, d := 1 + b + c + rnorm(nrow(.))]

first_l_f3 <- function(sd, n)
{
	l <- strsplit(sd, split = ' ', fixed = T)

	maxl <- max(lengths(l))

	sapply(l, "length<-", maxl) %>%
		`[`(n,) %>%
		as.character
}

microbenchmark({
	dt[
		, (paste0('w_', 1:3)) := lapply(1:3, function(x) first_l_f3(w, x))
		]
})

dt[
	, (paste0('w_', 1:3)) := lapply(1:3, function(x) first_l_f3(w, x))
	]


# chaining

res1 <- dt[a == 'a'][sample(.N, 100)]

res2 <- dt[, .N, a][, N]

res3 <- dt[, coefficients(lm(e ~ d))[1], a][, .(letter = a, coef = V1)]

# piping

samplpe_b <- dt[a %in% head(letters), sample(b, 1)]

res4 <-
	dt %>%
	.[a %in% head(letters)] %>%
	.[,
	  {
	  	dt0 <- .SD[1:100]

	  	quants <-
	  		dt0[, c] %>%
	  		quantile(seq(0.1, 1, 0.1), na.rm = T)

	  	.(q = quants)
	  }
	  , .(cond = b > samplpe_b)
	  ] %>%
	glm(
		cond ~ q -1
		, family = binomial(link = "logit")
		, data = .
	) %>%
	summary %>%
	.[[12]]


# function

rm(lm_preds)

lm_preds <- function(
	sd, by, n
)
{

	if(
		n < 100 |
		!by[['a']] %in% head(letters, 4)
	   )
	{

		res <-
			list(
				low = NA
				, mean = NA
				, high = NA
				, coefs = NA
			)

	} else {

		lmm <-
			lm(
				d ~ c + b
				, data = sd
			)

		preds <-
			stats::predict.lm(
				lmm
				, sd
				, interval = "prediction"
				)

		res <-
			list(
				low = preds[, 2]
				, mean = preds[, 1]
				, high = preds[, 3]
				, coefs = coefficients(lmm)
			)
	}

	res

}

res5 <-
	dt %>%
	.[e < 0] %>%
	.[.[, .I[b > 0]]] %>%
	.[, `:=` (
		low = as.numeric(lm_preds(.SD, .BY, .N)[[1]])
		, mean = as.numeric(lm_preds(.SD, .BY, .N)[[2]])
		, high = as.numeric(lm_preds(.SD, .BY, .N)[[3]])
		, coef_c = as.numeric(lm_preds(.SD, .BY, .N)[[4]][1])
		, coef_b = as.numeric(lm_preds(.SD, .BY, .N)[[4]][2])
		, coef_int = as.numeric(lm_preds(.SD, .BY, .N)[[4]][3])
	)
	, a
	] %>%
	.[!is.na(mean), -'e', with = F]


# plot

plo <-
	res5 %>%
	ggplot +
	facet_wrap(~ a) +
	geom_ribbon(
		aes(
			x = c * coef_c + b * coef_b + coef_int
			, ymin = low
			, ymax = high
			, fill = a
		)
		, size = 0.1
		, alpha = 0.1
	) +
	geom_point(
		aes(
			x = c * coef_c + b * coef_b + coef_int
			, y = mean
			, color = a
		)
		, size = 1
	) +
	geom_point(
		aes(
			x = c * coef_c + b * coef_b + coef_int
			, y = d
		)
		, size = 1
		, color = 'black'
	) +
	theme_minimal()

print(plo)
Bron: habr.com
