

Berkeley Packet Filters (BPF) is eine Linux-Kernel-Technologie, die schon seit einigen Jahren in den Schlagzeilen englischsprachiger Fachzeitschriften steht. Konferenzen sind voll von Vorträgen über die Nutzung und Entwicklung von BPF. David Miller, der Wartende des Linux-Netzwerksystems, nennt seinen Vortrag auf den Linux Plumbers 2018 (XDP ist eine von BPF genutzte Option). Brendan Gregg hält Vorträge mit dem Titel . Toke Høiland-Jørgensen , der sagt, dass der Kernel jetzt ein Mikrokernel ist. Thomas Graf bewirbt die Idee, dass .
Es gibt bisher keine systematische Beschreibung von BPF auf Habré, und deshalb werde ich in einer Reihe von Artikeln die Geschichte der Technologie erzählen, die Architektur und Entwicklungswerkzeuge beschreiben, Anwendungsbereiche und Praktiken zur Nutzung von BPF skizzieren. Der vorliegende, nullte Artikel dieser Reihe behandelt die Geschichte und Architektur des klassischen BPF und enthüllt die Geheimnisse seiner Funktionsweise tcpdump, seccomp, strace, und vieles mehr.
Die Entwicklung von BPF wird von der Linux-Community kontrolliert, und die Hauptanwendungen von BPF sind mit Netzwerken verbunden. Daher, mit Genehmigung von , habe ich die Reihe "BPF für die Kleinsten" genannt, in Anlehnung an die großartige Reihe .
Eine kurze Geschichte des BPF (c)
Die moderne BPF-Technologie ist eine verbesserte und erweiterte Version der alten Technologie mit demselben Namen, die heutzutage, um Verwechslungen zu vermeiden, klassisches BPF genannt wird. Auf der Grundlage des klassischen BPF wurden die bekannte Utility tcpdump, das Mechanismus seccomp, sowie die weniger bekannte Modulation xt_bpf voor iptables und Klassifikator cls_bpf. In modernem Linux werden klassische BPF-Programme automatisch in eine neue Form übersetzt, jedoch blieb aus der Sicht der Benutzer die API gleich, und neue Anwendungen des klassischen BPF sind, wie wir in diesem Artikel sehen werden, weiterhin vorhanden. Aus diesem Grund, sowie weil das Verfolgen der Entwicklungsgeschichte des klassischen BPF in Linux deutlich macht, wie und warum es sich zur modernen Form entwickelt hat, habe ich mich entschieden, genau mit einem Artikel über das klassische BPF zu beginnen.
Aan het einde van de jaren tachtig raakten ingenieurs van het beroemde Lawrence Berkeley Laboratory geïnteresseerd in hoe netwer pakketten correct gefilterd konden worden op de voor die tijd moderne hardware. Het basisidee van filtering, oorspronkelijk geïmplementeerd in de CSPF-technologie (CMU/Stanford Packet Filter), was om ongewenste pakketten zo vroeg mogelijk te filteren, dat wil zeggen in de kernelruimte, omdat dit voorkomt dat onnodige gegevens naar de gebruikersruimte worden gekopieerd. Om de uitvoeringstijd van gebruikerscode in de kernelruimte veilig te stellen, werd een virtuele machine — sandbox — gebruikt.
Echter, de virtuele machines voor bestaande filters waren ontworpen om te draaien op machines met een stack-architectuur en werkten niet zo efficiënt op nieuwe RISC-machines. Uiteindelijk ontwikkelden ingenieurs van Berkeley Labs een nieuwe technologie genaamd BPF (Berkeley Packet Filters), waarvan de architectuur van de virtuele machine was ontworpen op basis van de Motorola 6502-processor — de betrouwbare krachtbron achter bekende producten zoals of . De nieuwe virtuele machine verhoogde de prestaties van filters tientallen keren vergeleken met bestaande oplossingen.
Architectuur van de BPF-machine
We zullen de architectuur praktisch verkennen aan de hand van voorbeelden. Maar laten we eerst zeggen dat de machine twee beschikbare 32-bits registers voor de gebruiker had: een accumulator A en een indexregister X, 64 bytes geheugen (16 woorden) beschikbaar voor lezen en schrijven, en een klein instructiesysteem om met deze objecten te werken. In programma's waren ook spronginstructies beschikbaar om voorwaardelijke uitspraken te realiseren, maar om een tijdige beëindiging van het programma te garanderen, kon er alleen vooruit worden gesprongen; het was bijvoorbeeld verboden om lussen te creëren.
Het algemene schema voor het starten van de machine is als volgt. De gebruiker maakt een programma voor de BPF-architectuur en laadt het, via een kernmechanisme (bijvoorbeeld een systeemaanroep), en koppelt het programma aan een gebeurtenisgenerator in de kernel (bijvoorbeeld een gebeurtenis is de ontvangst van een nieuw pakket op de netwerkinterface). Wanneer er een gebeurtenis optreedt, start de kernel het programma (bijvoorbeeld in de interpreter), waarbij het geheugen van de machine overeenkomt met een geheugenregio van de kern (bijvoorbeeld de gegevens van het ontvangen pakket).
Wat hierboven is gezegd is voldoende om voorbeelden te bekijken: we zullen het systeem en het formaat van de opdrachten uitzoeken indien nodig. Als je echter meteen de systeemopdrachten van de virtuele machine wilt leren en alles over zijn mogelijkheden wilt weten, kun je het originele artikel lezen. en/of de eerste helft van het bestand uit de documentatie van de kern. Daarnaast kun je de presentatie bestuderen , waarin McCanne, een van de auteurs van BPF, vertelt over de geschiedenis van de oprichting. libpcap.
Wij gaan verder met het bekijken van alle belangrijke voorbeelden van het gebruik van klassieke BPF in Linux: tcpdump (libpcap), seccomp, xt_bpf, cls_bpf.
tcpdump
De ontwikkeling van BPF vond parallel plaats met de ontwikkeling van de frontend voor pakketfiltering - de welbekende tool tcpdump. En aangezien dit het oudste en meest bekende voorbeeld van het gebruik van klassieke BPF is, beschikbaar op vele besturingssystemen, beginnen we onze studie van de technologie hiermee.
(Alle voorbeelden in dit artikel zijn uitgevoerd op Linux 5.6.0-rc6. De uitvoer van sommige opdrachten is bewerkt voor betere leesbaarheid.)
Voorbeeld: we observeren IPv6-pakketten
Stel dat we alle IPv6-pakketten op de interface willen bekijken. eth0Om dit te doen, kunnen we het programma starten tcpdump met de eenvoudigste filter ip6:
$ sudo tcpdump -i eth0 ip6Tegelijkertijd kunnen meerdere mensen aan hetzelfde project werken tcpdump compileren de filter ip6 naar bytecode van de BPF-architectuur en stuurt deze naar de kernel (zie details in de sectie ). De geladen filter zal worden uitgevoerd voor elk pakket dat door de interface gaat. eth0Als de filter een niet-nul waarde retourneert n, worden tot n bytes van het pakket gekopieerd naar de gebruikersruimte en we zien het in de uitvoer. tcpdump.
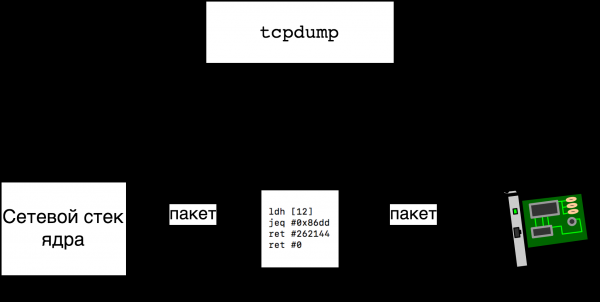
Het blijkt dat we gemakkelijk kunnen achterhalen welke bytecode naar de kernel is gestuurd tcpdump met behulp van dezelfde tcpdump, als we het uitvoeren met de optie -d:
$ sudo tcpdump -i eth0 -d ip6
(000) ldh      [12]
(001) jeq      #0x86dd          jt 2    jf 3
(002) ret      #262144
(003) ret      #0
Op regel nul starten we de opdracht ldh [12], die wordt geïnterpreteerd als "laad in de register A half-woord (16 bits) vanaf adres 12" en de enige vraag is - wat voor geheugen adresseren we? Het antwoord is dat op adres x de (x+1)-de byte van het te analyseren netwerkpakket begint. We lezen pakketten vanaf de Ethernet-interface eth0, en dat betekent , dat het pakket er als volgt uitziet (ter vereenvoudiging gaan we ervan uit dat er geen VLAN-tags in het pakket zijn):
       6              6          2
|Bestemmings MAC|Bron MAC|Ether Type|...|
Dus na het uitvoeren van de opdracht ldh [12] in het register A komt het veld Ether Type — type van het in dit Ethernet-frame verzonden pakket. In regel 1 vergelijken we de inhoud van het register A (pakket type) met 0x86dd, en dat betekent het type IPv6 dat we willen. In regel 1 is er naast de vergelijkingsopdracht ook nog een twee kolommen — jt 2 en jf 3 — labels waarheen we moeten springen in geval van een succesvolle vergelijking (A == 0x86dd) en in geval van een mislukking. Dus, in het geval van succes (IPv6) springen we naar regel 2, en in geval van mislukking springen we naar regel 3. In regel 3 eindigt het programma met code 0 (kopieer het pakket niet), in regel 2 eindigt het programma met code 262144 (kopieer maximaal 256 kilobyte van het pakket).
Een iets ingewikkelder voorbeeld: we kijken naar TCP-pakketten op de doelf poort
Laten we bekijken hoe de filter eruitziet die alle TCP-pakketten met doelf port 666 kopieert. We zullen de IPv4 situatie bekijken, aangezien de IPv6 situatie eenvoudiger is. Na het bestuderen van dit voorbeeld, kunt u als oefening zelf de filter voor IPv6 bestuderen (ip6 and tcp dst port 666) en de filter voor de algemene situatie (tcp dst port 666). Dus, de filter die we willen, ziet er als volgt uit:
$ sudo tcpdump -i eth0 -d ip and tcp dst port 666
(000) ldh      [12]
(001) jeq      #0x800           jt 2    jf 10
(002) ldb      [23]
(003) jeq      #0x6             jt 4    jf 10
(004) ldh      [20]
(005) jset     #0x1fff          jt 10   jf 6
(006) ldxb     4*([14]&0xf)
(007) ldh      [x + 16]
(008) jeq      #0x29a           jt 9    jf 10
(009) ret      #262144
(010) ret      #0
Wat de regels 0 en 1 doen, weten we al. In regel 2 hebben we al gecontroleerd dat het een IPv4-pakket is (Ether Type = 0x800) en laden we in het register A de 24e byte van het pakket. Ons pakket ziet eruit als
       14            8      1     1
|ethernet header|ip velden|ttl|protocol|...
en dus laden we in het register A het Protocol-veld van de IP-header, wat logisch is, aangezien we alleen TCP-pakketten willen kopiëren. We vergelijken het Protocol met 0x6 () in regel 3.
In regels 4 en 5 laden we de halve woorden die zich op adres 20 bevinden, en met behulp van de opdracht jset controleren we of een van de drie — in de gegeven maskers jset de drie hoogste bits zijn gewist. Twee van de drie bits vertellen ons of het pakket deel uitmaakt van een gefragmenteerd IP-pakket, en als dat het geval is, of het het laatste fragment is. De derde bit is gereserveerd en moet gelijk zijn aan nul. We willen geen onvolledige of corrupte pakketten controleren, dus controleren we alle drie de bits.
Regel 6 is het interessantste in deze listing. De uitdrukking ldxb 4*([14]&0xf) betekent dat we in het register laden X de vier laagste bits van de vijftiende byte van het pakket, vermenigvuldigd met 4. De vier laagste bits van de vijftiende byte vormen een veld van de IPv4 header, waarin de lengte van de header in woorden is opgeslagen, daarom moeten we dit later met 4 vermenigvuldigen. Het is interessant dat de uitdrukking 4*([14]&0xf) — dit is een aanduiding van een speciale adresseringsschema, dat alleen op deze manier kan worden gebruikt en alleen voor de register X, d.w.z. we kunnen niet zeggen ldb 4*([14]&0xf) of ldxb 5*([14]&0xf) (we kunnen alleen een andere offset aangeven, bijvoorbeeld, ldxb 4*([16]&0xf)). Het is duidelijk dat dit adresseringsschema in BPF is toegevoegd om de lengte van de IPv4 header te verkrijgen. X (indexregister).
Dus proberen we op regel 7 een half woord te laden op het adres (X+16). Als we ons herinneren dat 14 bytes gewijd zijn aan de Ethernet header, en X de lengte van de IPv4 header bevat, begrijpen we dat op A de bestemming TCP-poort wordt geladen:
       14           X           2             2
|ethernet header|ip header|source port|destination port|
Ten slotte vergelijken we op regel 8 de bestemmingspoort met de gezochte waarde en geven we op regels 9 of 10 het resultaat terug — of we het pakket kopiëren of niet.
Tcpdump: laden
In de voorgaande voorbeelden hebben we bewust niet in detail stilgestaan bij hoe we BPF bytecode in de kernel laden voor het filteren van pakketten. Over het algemeen tcpdump is geport naar veel systemen en voor het werken met filters gebruik de bibliotheek . Samengevat, om een filter op een interface te plaatsen met behulp van libpcap, moet je het volgende doen:
- een descriptor van het type
pcap_taanmaken uit de interface naam: , - de interface activeren: ,
- de filter compileren: ,
- de filter aansluiten: .
Om te zien hoe de functie pcap_setfilter in Linux is geïmplementeerd, gebruiken we strace (enkele regels zijn verwijderd):
$ sudo strace -f -e trace=%network tcpdump -p -i eth0 ip
socket(AF_PACKET, SOCK_RAW, 768)        = 3
bind(3, {sa_family=AF_PACKET, sll_protocol=htons(ETH_P_ALL), sll_ifindex=if_nametoindex("eth0"), sll_hatype=ARPHRD_NETROM, sll_pkttype=PACKET_HOST, sll_halen=0}, 20) = 0
setsockopt(3, SOL_SOCKET, SO_ATTACH_FILTER, {len=4, filter=0xb00bb00bb00b}, 16) = 0
...
Op de eerste twee regels van de uitvoer creëren we een om alle Ethernet-frames te lezen en verbinden deze met de interface eth0. Uit weten we dat de filter ip zal bestaan uit vier BPF-instructies, en op de derde regel zien we hoe we met behulp van de optie systeemoproep setsockopt de filter van lengte 4 laden en aansluiten. Dit is onze filter.
Het is vermeldenswaard dat in de klassieke BPF de belading en het aansluiten van de filter altijd als een atomische operatie plaatsvindt, terwijl in de nieuwe versie van BPF de belading van het programma en de binding aan de gebeurtenisgenerator in de tijd zijn gescheiden.
De verborgen waarheid
Een iets uitgebreidere versie van de output ziet er als volgt uit:
$ sudo strace -f -e trace=%network tcpdump -p -i eth0 ip
socket(AF_PACKET, SOCK_RAW, 768)        = 3
bind(3, {sa_family=AF_PACKET, sll_protocol=htons(ETH_P_ALL), sll_ifindex=if_nametoindex("eth0"), sll_hatype=ARPHRD_NETROM, sll_pkttype=PACKET_HOST, sll_halen=0}, 20) = 0
setsockopt(3, SOL_SOCKET, SO_ATTACH_FILTER, {len=1, filter=0xbeefbeefbeef}, 16) = 0
recvfrom(3, 0x7ffcad394257, 1, MSG_TRUNC, NULL, NULL) = -1 EAGAIN (Resource tijdelijk onbeschikbaar)
setsockopt(3, SOL_SOCKET, SO_ATTACH_FILTER, {len=4, filter=0xb00bb00bb00b}, 16) = 0
...
Zoals eerder vermeld, laden we onze filter op en verbinden deze met de socket in regel 5, maar wat gebeurt er in regels 3 en 4? Blijkbaar is het zo dat libpcap het voor ons zorgt — om ervoor te zorgen dat er geen pakketten in de output van onze filter komen die daar niet aan voldoen, zorgt de bibliotheek een nep-filter ret #0 (negeer alle pakketten), zet de socket in niet-blokkerende modus en probeert alle pakketten te lezen die mogelijk achtergebleven zijn van eerdere filters.
Samengevat, om pakketten op Linux te filteren met behulp van klassieke BPF, dient men een filter in de vorm van een structuur zoals struct sock_fprog en een geopende socket te hebben, waarna de filter via een systeemaanroep aan de socket kan worden gekoppeld. setsockopt.
Interessant is dat filters aan elke socket kunnen worden gekoppeld, niet alleen aan raw. Hier is een programma dat alles afsnijdt behalve de eerste twee bytes van alle inkomende UDP-datagrammen. (Ik heb opmerkingen toegevoegd in de code om het artikel niet te overladen.)
Meer over het gebruik van setsockopt voor het aansluiten van filters zie , en over het schrijven van eigen filters met de stijl van struct sock_fprog zonder hulp tcpdump gaan we het hebben in de sectie .
Klassieke BPF en de 21e eeuw
BPF werd in 1997 in Linux opgenomen en bleef lange tijd een werkpaard libpcap zonder grote veranderingen (Linux-specifieke wijzigingen, uiteraard, , maar die veranderden het globale plaatje niet). De eerste serieuze tekenen dat BPF zou evolueren verschenen in 2011, toen Eric Dumazet voorstelde , het toevoegen van een Just In Time Compiler aan de kernel — een vertaler voor het omzetten van BPF bytecode naar native x86_64 code.
De JIT-compiler was de eerste in de keten van veranderingen: in 2012 de mogelijkheid om filters voor , met behulp van BPF, in januari 2013 werd module xt_bpf, een systeem dat het schrijven van regels voor iptables met behulp van BPF mogelijk maakte, en in oktober 2013 was er ook een module cls_bpf, waarmee het mogelijk is om traffic classifiers te schrijven met behulp van BPF.
We zullen al deze voorbeelden binnenkort in detail bekijken, maar eerst is het nuttig om te leren hoe we willekeurige programma's voor BPF kunnen schrijven en compileren, aangezien de mogelijkheden die door de bibliotheek worden aangeboden libpcap beperkt zijn (een eenvoudig voorbeeld: een filter dat is gegenereerd libpcap kan slechts twee waarden retourneren — 0 of 0x40000) of helemaal niet toepasbaar is, zoals in het geval van seccomp.
Programmeren van BPF met eigen handen
Laten we kennismaken met het binaire formaat van BPF-instructies, het is heel eenvoudig:
   16    8    8     32
| code | jt | jf |  k  |
Elke instructie neemt 64 bits in beslag, waarvan de eerste 16 bits de opcode zijn, gevolgd door twee 8-bits sprongen, jt en jf, en 32 bits voor het argument K, waarvan de bestemming varieert van instructie tot instructie. Bijvoorbeeld, de instructie ret, die het programma beëindigt, heeft de opcode 6, en de geretourneerde waarde komt van de constante K. In de C-taal wordt één BPF-instructie weergegeven als een structuur
struct sock_filter {
        __u16   code;
        __u8    jt;
        __u8    jf;
        __u32   k;
}
en een volledig programma als een structuur
struct sock_fprog {
        unsigned short len;
        struct sock_filter *filter;
}
Dus kunnen we al programma's schrijven (de instructiecodes kennen we, laten we zeggen, uit ). Zo zou het filter eruitzien ip6 uit :
struct sock_filter code[] = {
        { 0x28, 0, 0, 0x0000000c },
        { 0x15, 0, 1, 0x000086dd },
        { 0x06, 0, 0, 0x00040000 },
        { 0x06, 0, 0, 0x00000000 },
};
struct sock_fprog prog = {
        .len = ARRAY_SIZE(code),
        .filter = code,
};
Programma prog kunnen we legaal gebruiken in de aanroep
setsockopt(sk, SOL_SOCKET, SO_ATTACH_FILTER, &prog, sizeof(prog))Programma's schrijven in de vorm van machinecodes is niet erg handig, maar soms is het nodig (bijvoorbeeld voor debugging, het maken van unittests, het schrijven van artikelen op Habr, enz.). Voor het gemak zijn in het bestand <linux/filter.h> hulpmacro's gedefinieerd — hetzelfde voorbeeld dat hierboven werd gegeven, kon worden herschreven als
struct sock_filter code[] = {
        BPF_STMT(BPF_LD|BPF_H|BPF_ABS, 12),
        BPF_JUMP(BPF_JMP|BPF_JEQ|BPF_K, ETH_P_IPV6, 0, 1),
        BPF_STMT(BPF_RET|BPF_K, 0x00040000),
        BPF_STMT(BPF_RET|BPF_K, 0),
}
Echter, deze variant is ook niet erg handig. Dit dachten de Linux-kernelprogrammeurs ook en daarom kunt u in de map van de kernel assembler en debugger vinden om met klassieke BPF te werken.
De assemblertaal lijkt veel op de debug-uitvoer tcpdump, maar daarnaast kunnen we symbolische labels aangeven. Bijvoorbeeld, hier is een programma dat alle pakketten weggooit, behalve TCP/IPv4:
$ cat /tmp/tcp-over-ipv4.bpf
ldh [12]
jne #0x800, drop
ldb [23]
jneq #6, drop
ret #-1
drop: ret #0
Standaard genereert de assembler code in het formaat , ,..., voor ons voorbeeld met TCP krijgen we
$ tools/bpf/bpf_asm /tmp/tcp-over-ipv4.bpf
6,40 0 0 12,21 0 3 2048,48 0 0 23,21 0 1 6,6 0 0 4294967295,6 0 0 0,
Voor de gemak van C programmeurs kan een andere uitvoerformaat worden gebruikt:
$ tools/bpf/bpf_asm -c /tmp/tcp-over-ipv4.bpf
{ 0x28,  0,  0, 0x0000000c },
{ 0x15,  0,  3, 0x00000800 },
{ 0x30,  0,  0, 0x00000017 },
{ 0x15,  0,  1, 0x00000006 },
{ 0x06,  0,  0, 0xffffffff },
{ 0x06,  0,  0, 0000000000 },
Deze tekst kan worden gekopieerd naar de definitie van een type structuur struct sock_filter, zoals we in het begin van deze sectie hebben gedaan.
Linux uitbreidingen en netsniff-ng
Naast de standaard BPF-instructies, ondersteunen Linux en tools/bpf/bpf_asm ook . In hoofdzaak dienen de instructies voor toegang tot de velden van de structuur struct sk_buff, die een netwerkpakket in de kernel beschrijft. Er zijn echter ook helper-instructies van een ander type, zoals ldw cpu die het resultaat van de functie kernel A raw_smp_processor_id() in het register laadt. (In de nieuwe versie van BPF zijn deze niet-standaard uitbreidingen uitgebreid door kernhelperfuncties voor toegang tot geheugen, structuren en het genereren van gebeurtenissen aan programma's te verstrekken.) Hier is een interessant voorbeeld van een filter, waarbij we alleen de headers van pakketten naar de gebruikersruimte kopiëren met behulp van de uitbreidingpoff , payload offset:ld poff ret a
BPF uitbreidingen kunnen niet worden gebruikt in, maar dit is een goede reden om kennis te maken met het pakket hulpprogramma's tcpdumpnetsniff-ng , dat, naast filtering met behulp van BPF, ook een effectieve traffic generator bevat, en een meer geavanceerde BPF assembler genaamd , dat, naast alles, een geavanceerd programma bevatbpfc tools/bpf/bpf_asm. Het pakket bevat vrij gedetailleerde documentatie, zie ook de links aan het einde van het artikel. Dus weten we nu hoe we BPF programma's van willekeurige complexiteit kunnen schrijven en zijn we klaar om nieuwe voorbeelden te bekijken, waarvan de eerste technologie seccomp is, die met behulp van BPF-filters de controle over veel en een set argumenten van systeemaanroepen die voor dit proces en zijn nakomelingen beschikbaar zijn, mogelijk maakt.De eerste versie van seccomp werd in 2005 aan de kernel toegevoegd en had niet veel populariteit, omdat het slechts één mogelijkheid bood - het beperken van het aantal systeemaanroepen dat voor het proces beschikbaar was, naar de volgende:
seccomp
sigreturn
, en een proces dat de regels overtrad, werd gedood. read, write, exit en sigreturn, en een proces dat de regels overtrad, werd gedood bij gebruik van SIGKILLIn 2012, the seccomp feature was enhanced by the addition of BPF filters, allowing for the specification of multiple allowed system calls and even checks on their arguments. Interestingly, one of the first users of this functionality was Chrome, which is currently developing the KRSI mechanism, based on a new version of BPF that allows for customization of Linux Security Modules. Links to additional documentation can be found at the end of the article.
It should be noted that there have already been articles on Habr about the use of seccomp, which some might want to read before (or instead of) going through the following subsections. In the article , examples of using seccomp are provided, both from the 2007 version and from the version using BPF (filters are generated using libseccomp), discussing the relationship between seccomp and Docker, along with many useful links. In the article , it discusses, among other things, how to add black or white lists of system calls for daemons managed by systemd.
Next, we will see how to write and load filters for seccomp in plain C and using the library libseccomp , and the pros and cons of each option, and finally, we will look at how seccomp is used by the program strace.
Writing and Loading Filters for Seccomp
We already know how to write BPF programs, so we will first look at the seccomp API. A filter can be set at the process level, where all child processes will inherit the limits. This is done using the system call :
seccomp(SECCOMP_SET_MODE_FILTER, flags, &filter)waar &filter — this is a pointer to the familiar structure struct sock_fprog, i.e., a BPF program.
What distinguishes programs for seccomp from programs for sockets? The context being passed. In the case of sockets, a memory area containing the packet was passed, while in the case of seccomp, a structure of type
struct seccomp_data {
    int   nr;
    __u32 arch;
    __u64 instruction_pointer;
    __u64 args[6];
};
Hier nr — this is the number of the invoked system call, arch — the current architecture (more on this below), args — up to six arguments of the system call, and instruction_pointer — dit is een aanwijzing naar de instructie in de gebruikersruimte die deze systeemaanroep heeft gemaakt. Dus, bijvoorbeeld, om het nummer van de systeemaanroep in het register te laden, A moeten we zeggen
ldw [0]Voor seccomp-programma's zijn er ook andere bijzonderheden, zoals dat toegang tot de context alleen mogelijk is met een 32-bits uitlijning en dat je geen half woord of byte kunt laden — bij poging tot het laden van de filter, ldh [0] de systeemaanroep seccomp zal teruggeven EINVAL. De controle van de geladen filters wordt uitgevoerd door de functie van de kernel. (Grappig genoeg, in de originele commit die de seccomp-functionaliteit toevoegt, werd er vergeten om toestemming te geven voor het gebruik van de instructie mod (resterend van de deling) en nu is het niet beschikbaar voor seccomp BPF-programma's, omdat toevoeging ervan In principe weten we al alles wat nodig is om seccomp-programma's te schrijven en te lezen. Gewoonlijk is de logica van het programma opgezet als een witte of zwarte lijst van systeemaanroepen, bijvoorbeeld het programma
ld [0] jeq #304, bad jeq #176, bad jeq #239, bad jeq #279, bad good: ret #0x7fff0000 /* SECCOMP_RET_ALLOW */ bad: ret #0
controleert de zwarte lijst van vier systeemaanroepen met de nummers 304, 176, 239, 279. Wat zijn dit voor systeemaanroepen? We kunnen dat niet precies zeggen, omdat we niet weten voor welke architectuur het programma is geschreven. Daarom raden de auteurs van seccomp aanom alle programma's te beginnen met het controleren van de architectuur (de huidige architectuur wordt in de context aangegeven als een veld van de structuur arch struct seccomp_data ). Met de architectuurcontrole zou het begin van het voorbeeld er als volgt uitzien:ld [4] jne #0xc000003e, bad_arch ; SCMP_ARCH_X86_64
en dan zouden onze nummers van systeemaanroepen bepaalde waarden krijgen.We schrijven en laden filters voor seccomp met behulp van
Het schrijven van filters in machinetaal of voor BPF-assembly maakt volledige controle over het resultaat mogelijk, maar soms is het ook beter om draagbare en/of leesbare code te hebben. De bibliotheek libseccomp
, die een standaardinterface biedt voor het schrijven van zwarte of witte filters. Laten we bijvoorbeeld een programma schrijven dat een binaire bestanden uitvoert op basis van de keuze van de gebruiker, met eerst een zwarte lijst van systeemaanroepen van
het bovengenoemde artikel Eerst definiëren we een array ):
#include <seccomp.h>
#include <unistd.h>
#include <err.h>

static int sys_numbers[] = {
        __NR_mount,
        __NR_umount2,
       // ... еще 40 системных вызовов ...
        __NR_vmsplice,
        __NR_perf_event_open,
};

int main(int argc, char **argv)
{
        scmp_filter_ctx ctx = seccomp_init(SCMP_ACT_ALLOW);

        for (size_t i = 0; i < sizeof(sys_numbers)/sizeof(sys_numbers[0]); i++)
                seccomp_rule_add(ctx, SCMP_ACT_TRAP, sys_numbers[i], 0);

        seccomp_load(ctx);

        execvp(argv[1], &argv[1]);
        err(1, "execlp: %s", argv[1]);
}
sys_numbers sys_numbers uit meer dan 40 nummers van systeemoproepen om te blokkeren. Vervolgens initialiseren we de context ctx en vertellen we de bibliotheek dat we willen toestaan (SCMP_ACT_ALLOW) alle systeemoproepen standaard (het is eenvoudiger om zwarte lijsten op te stellen). Vervolgens voegen we een voor een alle systeemoproepen van de zwarte lijst toe. In reactie op een systeemoproep uit de lijst vragen we SCMP_ACT_TRAP, in welk geval seccomp het proces een signaal zal sturen SIGSYS met een beschrijving van welke specifieke systeemoproep de regels heeft geschonden. Ten slotte laden we het programma in de kernel met behulp van seccomp_load, dat het programma compileert en het aan het proces koppelt via een systeemoproep seccomp(2).
Voor een succesvolle compilatie moet het programma worden gelinkt aan de bibliotheek libseccomp, bijvoorbeeld:
cc -std=c17 -Wall -Wextra -c -o seccomp_lib.o seccomp_lib.c
cc -o seccomp_lib seccomp_lib.o -lseccomp
Voorbeeld van een succesvolle uitvoering:
$ ./seccomp_lib echo ok
ok
Voorbeeld van een geblokkeerde systeemoproep:
$ sudo ./seccomp_lib mount -t bpf bpf /tmp
Slechte systeemoproep
We gebruiken strace, om details te achterhalen:
$ sudo strace -e seccomp ./seccomp_lib mount -t bpf bpf /tmp
seccomp(SECCOMP_SET_MODE_FILTER, 0, {len=50, filter=0x55d8e78428e0}) = 0
--- SIGSYS {si_signo=SIGSYS, si_code=SYS_SECCOMP, si_call_addr=0xboobdeadbeef, si_syscall=__NR_mount, si_arch=AUDIT_ARCH_X86_64} ---
+++ gedood door SIGSYS (core gedumpt) +++
Slechte systeemoproep
waarmee we kunnen zien dat het programma is beëindigd vanwege het gebruik van een verboden systeemoproep mount(2).
Kortom, we hebben een filter geschreven met de bibliotheek libseccomp, waarbij niet-triviale code in vier regels past. In het bovenstaande voorbeeld kan de uitvoeringstijd aanzienlijk dalen bij een groot aantal systeemoproepen, aangezien de controle eenvoudigweg een lijst van vergelijkingen is. Onlangs is er in libseccomp een , die ondersteuning toevoegt voor het filteratrribuut SCMP_FLTATR_CTL_OPTIMIZE. Als je deze attribuut instelt op 2, zal het filter worden omgevormd tot een binaire zoekprogramma.
Als je wilt zien hoe filters met binaire zoeken zijn opgebouwd, kijk dan naar , dat zulke programma's in BPF-assembler genereert op basis van een set nummers van systeemoproepen, bijvoorbeeld:
$ echo 1 3 6 8 13 | ./generate_bin_search_bpf.py
ld [0]
jeq #6, bad
jgt #6, check8
jeq #1, bad
jeq #3, bad
ret #0x7fff0000
check8:
jeq #8, bad
jeq #13, bad
ret #0x7fff0000
bad: ret #0
Je kunt niets wezenlijk snellers schrijven, aangezien BPF-programma's geen sprongen op een offset kunnen maken (we kunnen bijvoorbeeld niet doen, jmp A of jmp [label+X]) en daarom zijn alle sprongen statisch.
seccomp en strace
Iedereen kent de utiliteit strace — een onmisbaar hulpmiddel bij het onderzoeken van procesgedrag op Linux. Veel mensen zijn echter ook bekend met bij het gebruik van deze tool. Dit komt omdat strace is geïmplementeerd met behulp van ptrace(2), en in dit mechanisme kunnen we niet opgeven op welke specifieke set van systeemaanroepen we het proces moeten stoppen, dat wil zeggen, bijvoorbeeld de opdrachten
$ time strace du /usr/share/ >/dev/null 2>&1

real    0m3.081s
user    0m0.531s
sys     0m2.073s
en
$ time strace -e open du /usr/share/ >/dev/null 2>&1

real    0m2.404s
user    0m0.193s
sys     0m1.800s
worden uitgevoerd in ongeveer dezelfde tijd, terwijl we in het tweede geval slechts één systeemaanroep willen traceren.
Nieuwe optie --seccomp-bpf, toegevoegd in strace versie 5.3, maakt het proces vele malen sneller en de opstarttijd onder tracing van één systeemaanroep is nu vergelijkbaar met de tijd van een gewone opstart:
$ time strace --seccomp-bpf -e open du /usr/share/ >/dev/null 2>&1

real    0m0.148s
user    0m0.017s
sys     0m0.131s

$ time du /usr/share/ >/dev/null 2>&1

real    0m0.140s
user    0m0.024s
sys     0m0.116s
(Hier is er natuurlijk een kleine misleiding in dat we de primaire systeemaanroep van dit commando niet traceren. Als we bijvoorbeeld zouden traceren, newfsstat, dan strace zou het net zo traag zijn als zonder. --seccomp-bpf.)
Hoe werkt deze optie? Zonder deze strace verbindt zich met het proces en start het met behulp van PTRACE_SYSCALL. Wanneer het beheerde proces een (of andere) systeemaanroep uitvoert, wordt de controle overgedragen strace, die naar de argumenten van de systeemaanroep kijkt en deze uitvoert met behulp van PTRACE_SYSCALL. Na enige tijd voltooit het proces de systeemaanroep en bij het verlaten ervan wordt de controle opnieuw overgedragen strace, die de teruggegeven waarden bekijkt en het proces weer uitvoert met behulp van PTRACE_SYSCALL, enz.
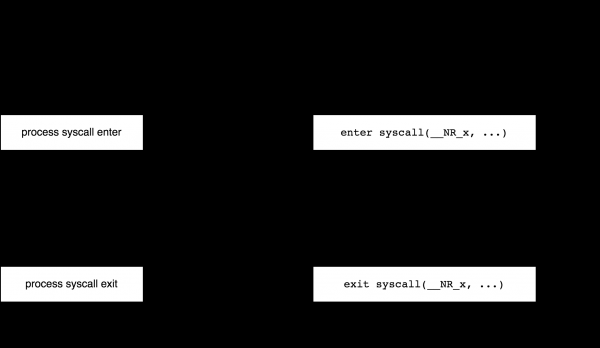
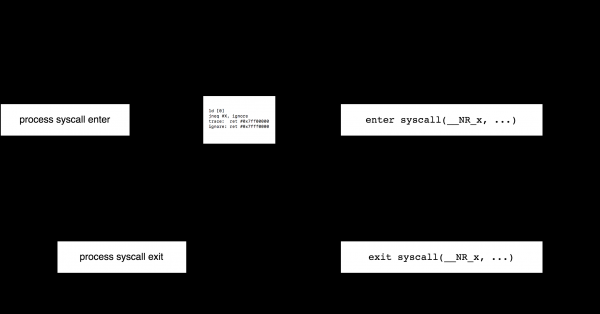
Met behulp van seccomp kan dit proces echter precies zo worden geoptimaliseerd als we zouden willen. Dat wil zeggen, als we alleen naar de systeemaanroep willen kijken X, kunnen we een BPF-filter schrijven, dat voor X de waarde SECCOMP_RET_TRACEteruggeeft, en voor systeemaanroepen die ons niet interesseren — SECCOMP_RET_ALLOW:
ld [0]
jneq #X, ignore
trace: ret #0x7ff00000
ignore: ret #0x7fff0000
In dit geval strace start aanvankelijk het proces als PTRACE_CONT, voor elke systeemaanroep voert ons filter uit; als de systeemaanroep niet X, blijft het proces doorgaan, maar als dat zo is X, dan zal seccomp de controle overdragen strace, die naar de argumenten kijkt en het proces opstart als PTRACE_SYSCALL (omdat seccomp geen mogelijkheid heeft om een programma uit te voeren bij het verlaten van een systeemaanroep). Wanneer de systeemaanroep terugkeert, strace zal het proces opnieuw worden gestart met behulp van PTRACE_CONT en zal het wachten op nieuwe berichten van seccomp.
Bij het gebruik van de optie --seccomp-bpf zijn er twee beperkingen. Ten eerste kun je geen verbinding maken met een al bestaand proces (optie -p van het programma strace), omdat dit niet wordt ondersteund door seccomp. Ten tweede is er geen mogelijkheid niet om naar kindprocessen te kijken, omdat seccomp-filteren door alle kindprocessen worden overgenomen zonder de mogelijkheid om dit uit te schakelen.
Een beetje meer details over hoe precies strace werkt met seccomp is te vinden in . Voor ons is het meest interessante feit dat de klassieke BPF in de vorm van seccomp nog steeds wordt toegepast.
xt_bpf
Laten we nu teruggaan naar de wereld van netwerken.
Achtergrond: heel lang geleden, in 2007, werd er in de kernel module xt_u32 voor netfilter. Het was geschreven naar analogie met de nog oudere verkeersclassificator cls_u32 en stelde gebruikers in staat om willekeurige binaire regels voor iptables te schrijven met behulp van de volgende eenvoudige bewerkingen: laad 32 bits uit het pakket en voer een reeks wiskundige bewerkingen uit. Bijvoorbeeld,
sudo iptables -A INPUT -m u32 --u32 "6&0xFF=1" -j LOG --log-prefix "seen-by-xt_u32"Laadt 32 bits van de IP-header, beginnend vanaf offset 6, en past een masker toe 0xFF (de laagste byte nemen). Dit is het veld protocol van de IP-header en we vergelijken het met 1 (ICMP). In een regel kun je veel controles combineren, en je kunt ook de operator uitvoeren @ — ga naar X bytes naar rechts. Bijvoorbeeld, de regel
iptables -m u32 --u32 "6&0xFF=0x6 && 0>>22&0x3C@4=0x29"controleert of de TCP Sequence Number 0x29niet gelijk is aan. Ik ga niet verder in detail treden, aangezien het al duidelijk is dat het niet erg handig is om zulke regels handmatig te schrijven. In het artikel , zijn er verschillende links met voorbeelden van het gebruik en genereren van regels voor xt_u32. Zie ook de links aan het einde van dit artikel.
Beginnend in 2013 kan de module in plaats van de module xt_u32 een op BPF gebaseerde module gebruiken. xt_bpfVoor iedereen die tot hier is gelezen, zou het principe van zijn werking al duidelijk moeten zijn: voer BPF-bytecode uit als iptables-regels. Een nieuwe regel kan bijvoorbeeld zo worden gemaakt:
iptables -A INPUT -m bpf --bytecode -j LOGhier <байткод> is de code in het formaat van de assembleroutput bpf_asm standaard, bijvoorbeeld,
$ cat /tmp/test.bpf
ldb [9]
jneq #17, ignore
ret #1
ignore: ret #0

$ bpf_asm /tmp/test.bpf
4,48 0 0 9,21 0 1 17,6 0 0 1,6 0 0 0,

# iptables -A INPUT -m bpf --bytecode "$(bpf_asm /tmp/test.bpf)" -j LOG
In dit voorbeeld filteren we alle UDP-pakketten. De context voor het BPF-programma in de module xt_bpf, verwijst natuurlijk naar de gegevens van het pakket, in het geval van iptables — naar het begin van de IPv4-header. De retourwaarde uit het BPF-programma , waar false betekent dat het pakket niet overeenkomt.
Het is duidelijk dat de module xt_bpf meer geavanceerde filters ondersteunt dan in het bovenstaande voorbeeld. Laten we kijken naar echte voorbeelden van Cloudflare. Tot voor kort gebruikten zij de module xt_bpf ter bescherming tegen DDoS-aanvallen. In het artikel wordt uitgelegd hoe (en waarom) zij BPF-filters genereren en publiceren zij links naar een set hulpprogramma's voor het maken van dergelijke filters. Bijvoorbeeld, met het hulpprogramma bpfgen kun je een BPF-programma maken dat een DNS-aanroep matcht met de naam habr.com:
$ ./bpfgen --assembly dns -- habr.com
ldx 4*([0]&0xf)
ld #20
add x
tax

lb_0:
    ld [x + 0]
    jneq #0x04686162, lb_1
    ld [x + 4]
    jneq #0x7203636f, lb_1
    ldh [x + 8]
    jneq #0x6d00, lb_1
    ret #65535

lb_1:
    ret #0
In het programma laden we eerst het X adres van het begin van de string x04habrx03comx00 binnen de UDP-datagram en controleren dan de aanvraag: 0x04686162 "x04hab" enzovoorts.
Een beetje later heeft Cloudflare de code van de p0f-compiler gepost -> BPF. In het artikel wordt uitgelegd wat p0f is en hoe je p0f-handtekeningen naar BPF kunt omzetten:
$ ./bpfgen p0f -- 4:64:0:0:*,0::ack+:0
39,0 0 0 0,48 0 0 8,37 35 0 64,37 0 34 29,48 0 0 0,
84 0 0 15,21 0 31 5,48 0 0 9,21 0 29 6,40 0 0 6,
...
Op dit moment gebruikt Cloudflare niet meer xt_bpf, omdat zij zijn overgestapt op XDP — een van de opties voor het gebruik van de nieuwe versie van BPF, zie .
cls_bpf
Het laatste voorbeeld van het gebruik van klassieke BPF in de kernel is een classifier cls_bpf voor de verkeerscontrolegesystemen in Linux, toegevoegd in Linux aan het einde van 2013 en conceptueel de oude vervangen. cls_u32.
We zullen echter niet nu de werking beschrijven cls_bpf, omdat we op basis van kennis van klassieke BPF hier niets aan hebben — we zijn al vertrouwd met de volledige functionaliteit. Bovendien komen we in de latere artikelen die over Extended BPF gaan, nog vaak tegen deze classifier.
Een andere reden om niet over het gebruik van klassieke BPF te vertellen cls_bpf is dat in vergelijking met Extended BPF het toepassingsgebied hierin drastisch wordt beperkt: klassieke programma's kunnen de inhoud van pakketten niet wijzigen en kunnen de status niet bewaren tussen aanroepen.
Dus het is tijd om afscheid te nemen van klassieke BPF en naar de toekomst te kijken.
Afscheid van classic BPF
We looked at how the BPF technology, developed in the early nineties, has successfully lasted a quarter of a century and still finds new applications. However, similar to the transition from stack machines to RISC, which sparked the development of classic BPF, in the 2000s there was a shift from 32-bit to 64-bit machines, and classic BPF began to become obsolete. Moreover, the capabilities of classic BPF are severely limited, and besides the outdated architecture, we lack the ability to maintain state between BPF program calls, we cannot directly interact with the user, and we cannot interact with the kernel except for reading a limited number of fields of the structure. sk_buff and launching simple helper functions, we cannot modify the contents of packets or redirect them.
In fact, currently there is only the API interface left from classic BPF in Linux, and within the kernel, all classic programs, be they socket filters or seccomp filters, are automatically translated into the new format, Extended BPF. (We will explain how this exactly happens in the next article.)
The transition to the new architecture began in 2013 when Alexey Starovoitov proposed a schema for updating BPF. In 2014, the corresponding patches in the kernel. As far as I understand, the initial plan was only to optimize the architecture and JIT-compiler for more efficient operation on 64-bit machines, but instead, these optimizations laid the foundation for a new chapter in Linux development.
Further articles in this series will discuss the architecture and applications of the new technology, initially known as internal BPF, then extended BPF, and now simply BPF.
Links
- Steven McCanne and Van Jacobson, "The BSD Packet Filter: A New Architecture for User-level Packet Capture",
https://www.tcpdump.org/papers/bpf-usenix93.pdf - Steven McCanne, "libpcap: An Architecture and Optimization Methodology for Packet Capture",
https://sharkfestus.wireshark.org/sharkfest.11/presentations/McCanne-Sharkfest'11_Keynote_Address.pdf tcpdump,libpcap:- .
- BPF — the forgotten bytecode:
https://blog.cloudflare.com/bpf-the-forgotten-bytecode/ - Introducing the BPF Tool:
https://blog.cloudflare.com/introducing-the-bpf-tools/ bpf_cls:http://man7.org/linux/man-pages/man8/tc-bpf.8.html- A seccomp overview:
https://lwn.net/Articles/656307/ https://github.com/torvalds/linux/blob/master/Documentation/userspace-api/seccomp_filter.rst- Paul Chaignon, "strace —seccomp-bpf: a look under the hood",
https://fosdem.org/2020/schedule/event/debugging_strace_bpf/ , dat, naast alles, een geavanceerd programma bevat:http://netsniff-ng.org/
Bron: habr.com
