

Ik bied aan om de transcriptie van het rapport van Roman Khavronenko "ExtendedPromQL" te bekijken.
Een korte introductie over mij. Mijn naam is Roman. Ik werk bij CloudFlare en woon in Londen. Maar ik ben ook de maintainer van VictoriaMetrics.
En ik ben de auteur voor Grafana en Dat is een kleine proxy voor ClickHouse.
We beginnen met het eerste deel, dat "De complicaties van vertaling" heet, waarin ik zal uitleggen dat elke taal, of zelfs gewoon de communicatietaal, erg belangrijk is. Omdat dit de manier is waarop je jouw gedachten aan een andere persoon of systeem overbrengt, hoe je een verzoek formuleert. Mensen op internet botsen vaak over welke taal beter is - Java of een andere. Voor mij heb ik besloten dat je moet kiezen op basis van de taak, omdat alles specifiek is.
Laten we bij het begin beginnen. Wat is PromQL? PromQL is de Prometheus Query Language. Dit is hoe we verzoeken formuleren in Prometheus om time series data te verkrijgen.
Wat zijn time series data? Als je het letterlijk neemt, zijn dit drie parameters.
Dit zijn:
- Waar we naar kijken.
- Wanneer we ernaar kijken.
- En welke waarde wordt weergegeven.
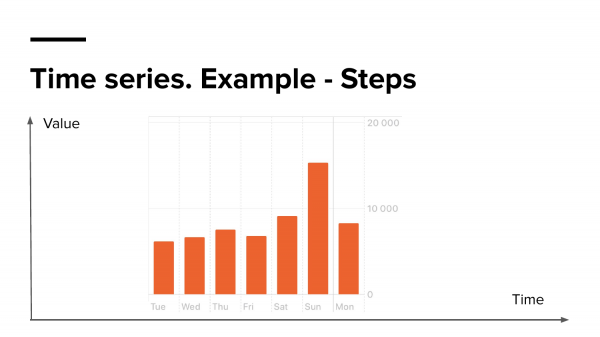
Als we naar deze grafiek kijken (deze grafiek komt van mijn telefoon en toont de statistieken van mijn stappen), kunnen we snel deze vragen beantwoorden.
We kijken naar de stappen. We zien de waarde en we zien de tijd waarop we dit bekijken. Dat wil zeggen, door naar deze grafiek te kijken, kunnen we gemakkelijk zeggen dat ik op zondag ongeveer 15.000 stappen heb gezet. Dit zijn time series data.
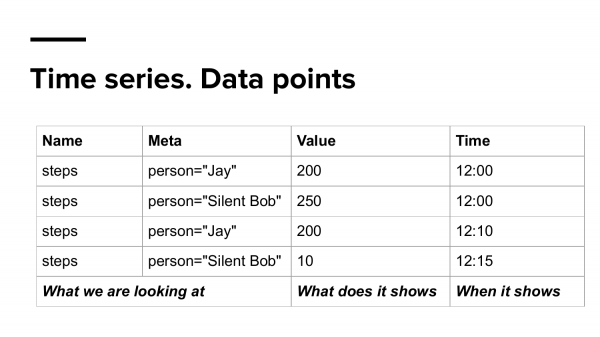
Laten we nu deze data 'splitsen' (omzetten) naar een ander datamodel in de vorm van een tabel. Hier hebben we ook datgene waar we naar kijken. Ik heb hier wat extra data toegevoegd, die we meta-data zullen noemen, dat wil zeggen, dit zijn niet alleen mijn stappen, maar van twee personen, laten we zeggen, Jay en Silent Bob. Dit is wat we bekijken; wat het toont en wanneer het deze waarde toont.
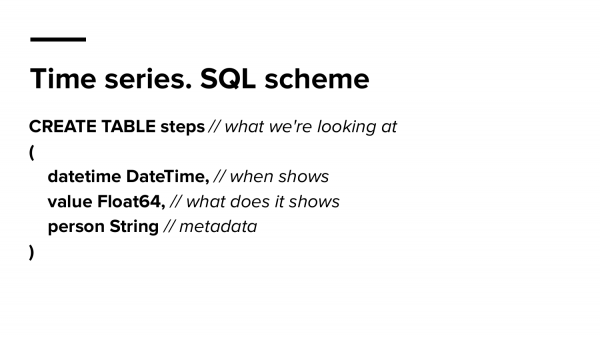
Laten we nu proberen al deze data in een database op te slaan. Voor dit voorbeeld heb ik de ClickHouse-syntaxis genomen. En hier creëren we één tabel die "Steps" heet, dat wil zeggen, datgene waar we naar kijken. Hier is de tijd dat we dit bekijken; wat het toont en enige meta-data, waarin we zullen opslaan wie dit is: Jay en Silent Bob.
En om te proberen dit alles te visualiseren, zullen we Grafana gebruiken, omdat het ten eerste mooi is.
We zullen ook deze plugin gebruiken. Er zijn twee redenen voor. Ten eerste omdat ik het geschreven heb. En ik weet precies hoe moeilijk het is om time series-gegevens uit ClickHouse te halen om ze in Grafana te tonen.
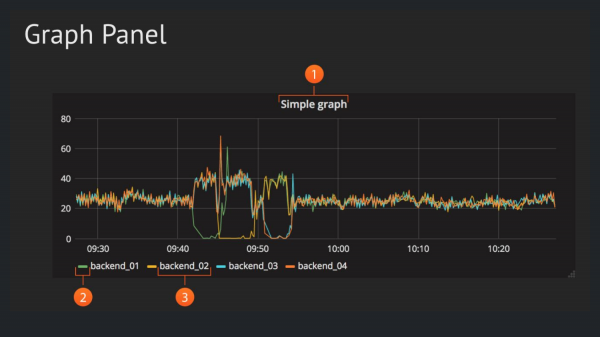
We zullen ze weergeven in het Graph Panel. Dit is het populairste paneel in Grafana, dat de afhankelijkheid van een waarde in de tijd toont, dus we hebben slechts twee parameters nodig.
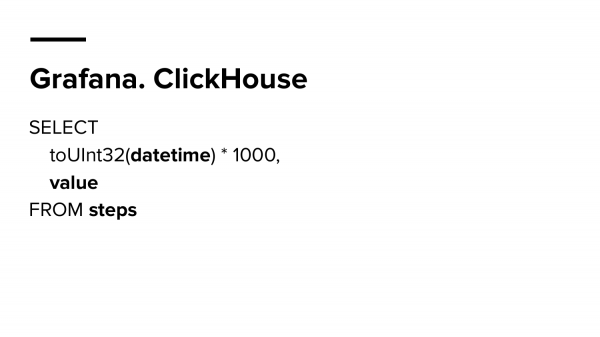
Laten we de eenvoudigste query schrijven — hoe de stapgegevens in Grafana te tonen, terwijl we deze gegevens in ClickHouse opslaan in de tabel die we gemaakt hebben. We schrijven een eenvoudige query. We selecteren uit stappen. We selecteren de waarde en we selecteren de tijd van die waarden, dat wil zeggen de drie parameters waar we het over hadden.
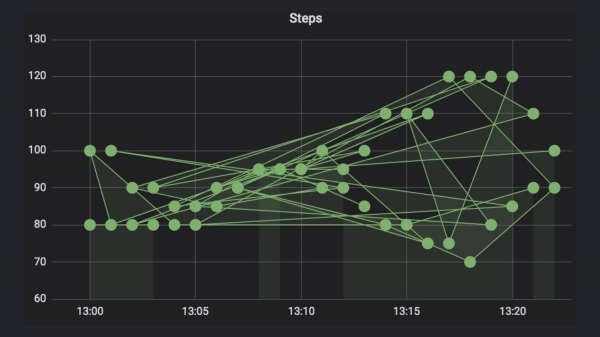
En als resultaat krijgen we zo'n grafiek. Wie weet waarom hij zo vreemd is?
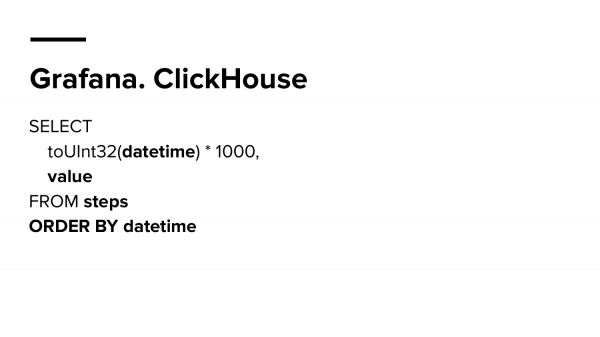
Precies, we moeten sorteren op tijd.
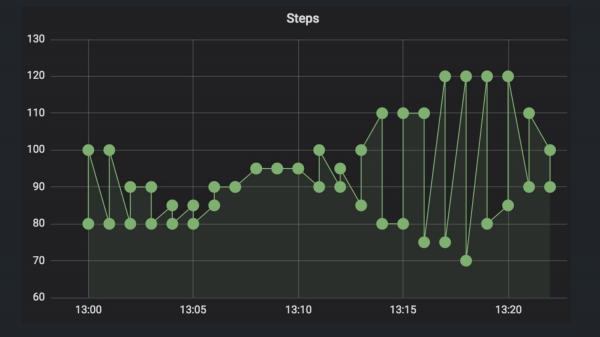
En uiteindelijk krijgen we iets beter, maar nog steeds een vreemde grafiek. Wie weet waarom? Juist, er zijn twee deelnemers, en we geven in Grafana twee time series door, omdat als we naar het datamodel kijken, elke time series een unieke combinatie van naam en alle sleutel-waarde labels is.
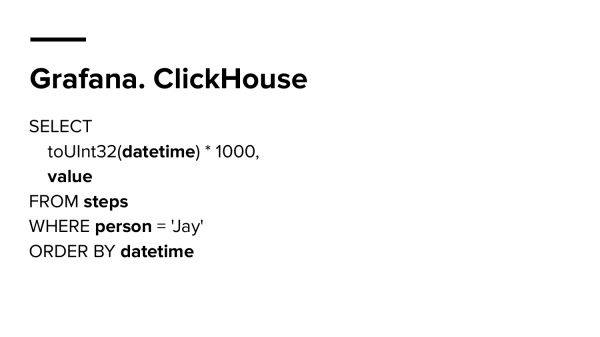
Dus we moeten een specifieke persoon kiezen. We kiezen Jay.

En we tekenen het nogmaals. Nu lijkt de grafiek op de waarheid. Nu is het een normale grafiek en alles werkt goed.
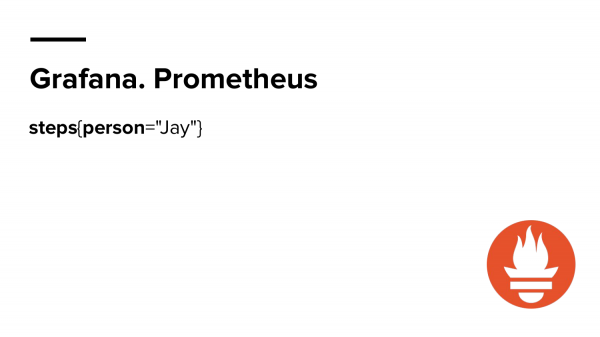
En waarschijnlijk weet je hoe je ongeveer hetzelfde kunt doen, maar in Prometheus via PromQL. Ongeveer zo. Een beetje eenvoudiger. En we splitsen dit allemaal. We hebben Steps genomen. En filteren op Jay. Hier geven we niet aan dat we de waarde willen krijgen en we selecteren geen tijd.
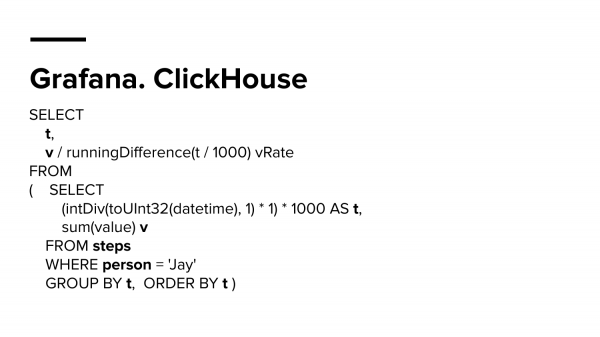
Laten we nu proberen de snelheid van Jay of Silent Bob te berekenen. In ClickHouse moeten we runningDifference maken, dat wil zeggen het verschil tussen paren van punten berekenen en deze delen door de tijd om een nauwkeurige snelheid te krijgen. De query zou er ongeveer zo uitzien.
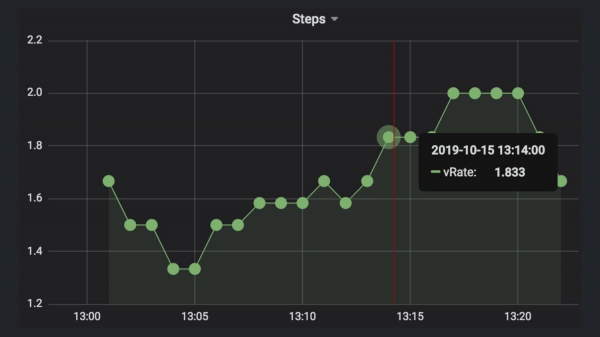
En het zal ongeveer zulke waarden tonen, dat wil zeggen dat Silent Bob of Jay ongeveer 1,8 stappen per seconde maakt.
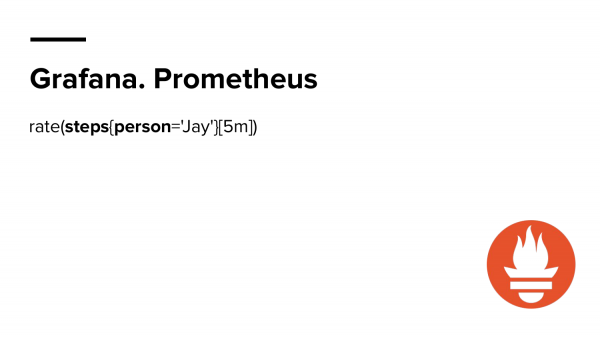
En in Prometheus weet je ook hoe je dit doet. Veel gemakkelijker dan voorheen.
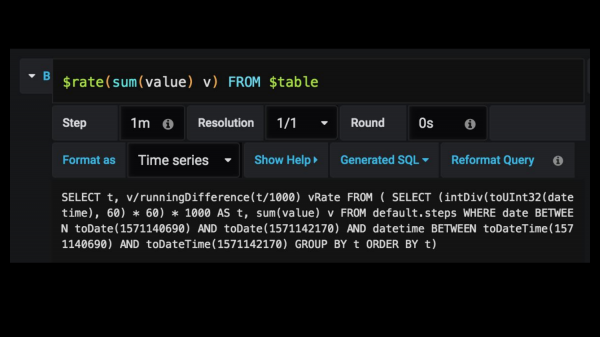 En om dit ook zo eenvoudig te houden in Grafana, heb ik deze wrapper toegevoegd, die sterk lijkt op PromQL. Het heet Rate Macros of hoe je het ook wilt noemen. In Grafana schrijf je gewoon "rate", maar ergens diep van binnen transformeert het in zo'n grote query. En je hoeft er zelfs niet naar te kijken, hij is ergens daar, maar je bespaart een hoop tijd, omdat het schrijven van zulke enorme SQL-queries altijd kostbaar is. Je kunt gemakkelijk een fout maken en dan lang niet begrijpen wat er aan de hand is.
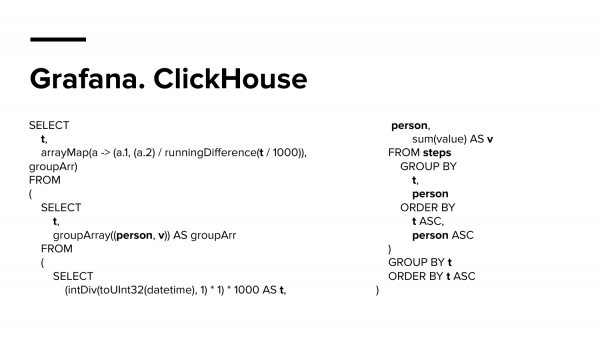
En dit is een query die zelfs niet op één dia paste, ik moest hem zelfs opsplitsen in twee kolommen. Dit is ook een query in ClickHouse, die hetzelfde rate doet, maar voor beide tijdseries: zowel Silent Bob als Jay, zodat we op ons paneel twee tijdseries hebben. En dit is al heel moeilijk, vind ik.
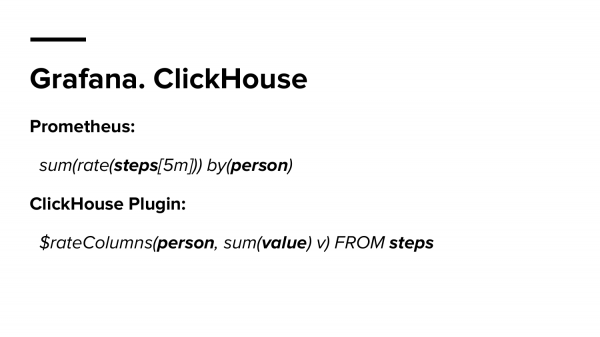
En voor Prometheus zou dit sum (rate) zijn. Voor ClickHouse heb ik een aparte macro gemaakt, die RateColumns heet, die eruitziet als een query in Prometheus.
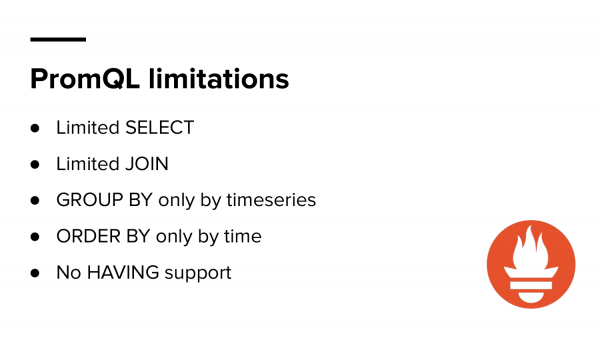
We hebben gekeken en hoewel PromQL er geweldig uitziet, heeft het natuurlijk zijn beperkingen.
Dit zijn:
- Beperkte SELECT.
- Grenzen aan JOIN.
- Geen ondersteuning voor HAVING.
En als je er lang mee gewerkt hebt, weet je dat het soms heel moeilijk is om iets te doen in PromQL, terwijl je in SQL praktisch alles kunt doen, omdat al deze opties die we nu bespraken, in SQL konden worden uitgevoerd. Maar zou het handig zijn om dit te gebruiken? En dat brengt me op de gedachte dat niet altijd de krachtigste taal de handigste kan zijn.
Daarom moet je soms de taal kiezen op basis van de taken. Het is als de strijd tussen Batman en Superman. Het is duidelijk dat Superman sterker is, maar Batman kon hem verslaan omdat hij praktischer was en precies wist wat hij deed.
En het volgende deel is het uitbreiden van PromQL.
Nogmaals over VictoriaMetrics. Wat is VictoriaMetrics? Het is een tijdreeksdatabase, open source, we distribueren het in single en cluster-versies. Volgens onze benchmarks is het de snelste op de markt momenteel en ook qua compressie, dat is, echte mensen rapporteren compressie van ongeveer 0,4 byte per punt, terwijl bij Prometheus het 1,2-1,4 is.
We ondersteunen niet alleen Prometheus. We ondersteunen ook InfluxDB, Graphite, OpenTSDB.
Met ons kun je "schrijven", dat wil zeggen, je kunt oude gegevens migreren.
En we werken ook perfect samen met Prometheus en Grafana, dat wil zeggen, we ondersteunen de PromQL-engine. En in Grafana kun je gewoon de Prometheus-eindpunt vervangen door VictoriaMetrics en al je dashboards blijven functioneren zoals ze deden.
Maar u kunt ook gebruikmaken van extra functies die VictoriaMetrics biedt.
Laten we snel de functies doornemen die we hebben toegevoegd.
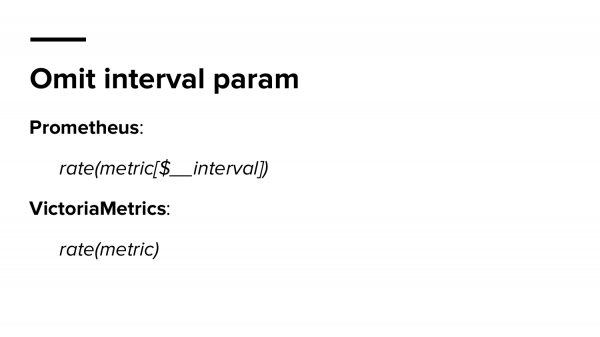
Omit interval param – u kunt de intervallen in Grafana overslaan. Wanneer u geen vreemde grafieken wilt krijgen bij het in- of uitzoomen op het paneel, wordt het aanbevolen om de variabele $__interval. Dit is een interne variabele van Grafana en zij bepaalt zelf het datumbereik. VictoriaMetrics kan ook zelf begrijpen welk bereik nodig is. U hoeft al uw verzoeken niet te updaten. Het wordt veel eenvoudiger.
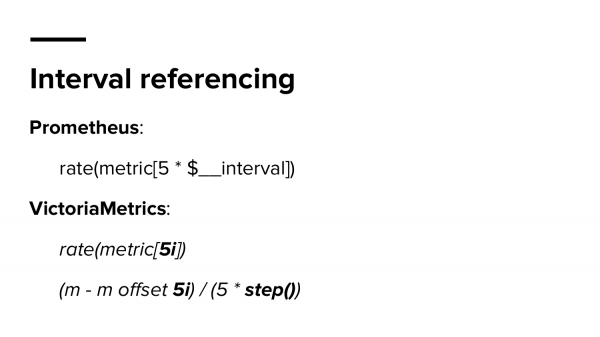
De tweede functie is intervalreferentie. U kunt deze interval in uw uitdrukkingen gebruiken. U kunt vermenigvuldigen, delen, doorgeven, ernaar verwijzen.
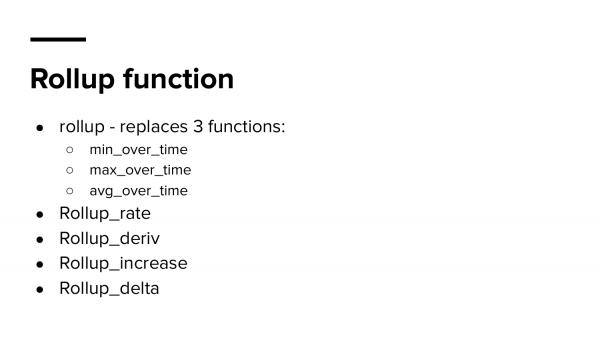
Daarna de familie van rollup-functies. Rollup-functies transformeren uw tijdreeks naar drie aparte tijdreeksen: min, max en avg. Ik vind dit erg handig, omdat het soms afwijkingen (uitbijters) en onnauwkeurigheden kan aangeven.
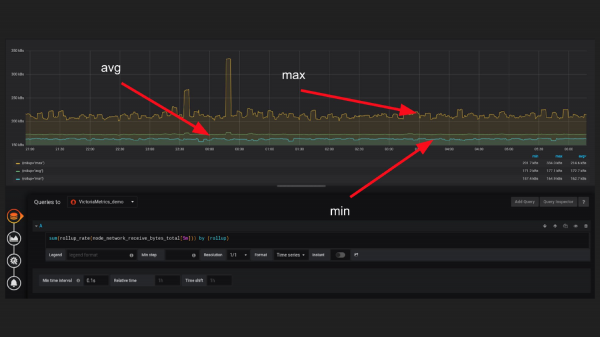
En als u gewoon irate of rate toepast, kunt u waarschijnlijk sommige gevallen missen waarin de tijdreeks zich niet gedraagt zoals u verwachtte. Met deze functie is het veel eenvoudiger om bijvoorbeeld te zien dat max veel sterker aan avg hangt.
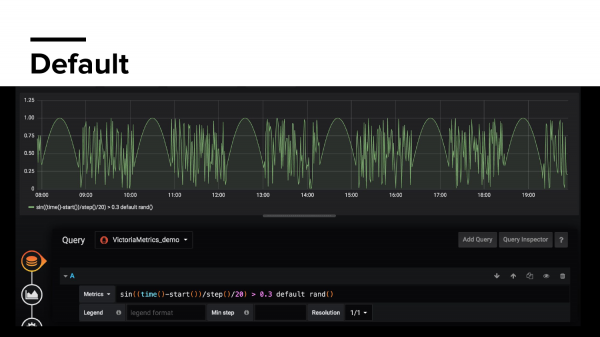
Verder is er de variabele default. Default betekent welke waarde we in Grafana moeten weergeven als we op dat moment geen tijdreeks hebben. Wanneer gebeurt dit? Stel dat u een bepaalde foutmetric exporteert. En u heeft zo'n geweldig programma dat wanneer u start, er geen fouten zijn, zelfs niet in de volgende drie uur of zelfs een dag. En u heeft dashboards die de verhouding tussen success en error laten zien. En zij tonen u niets omdat u geen foutmetric heeft. Met default kunt u iets opgeven.
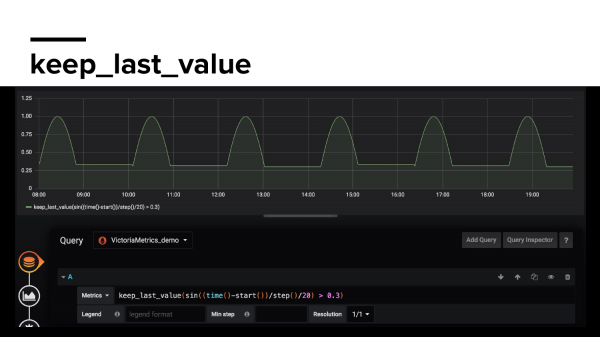
Keep_last_Value – slaat de laatste waarde van de metric op als deze wegvalt. Als Prometheus deze na de volgende scrape binnen 5 minuten niet vindt, onthouden we hier de laatste waarde, zodat uw grafieken niet opnieuw kapot gaan.
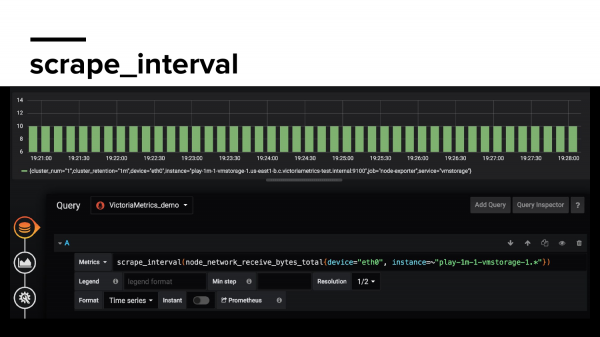
Scrape_interval – toont hoe vaak Prometheus gegevens verzamelt van uw metric, met welke frequentie. Hier kunt u bijvoorbeeld een gemiste waarde zien.
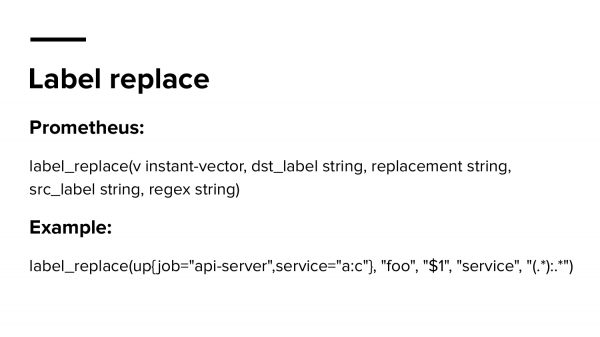
Label replace – een populaire functie. Maar wij vinden dat deze een beetje ingewikkeld is omdat deze meerdere argumenten vereist. U moet niet alleen 5 argumenten onthouden, maar ook de volgorde ervan.
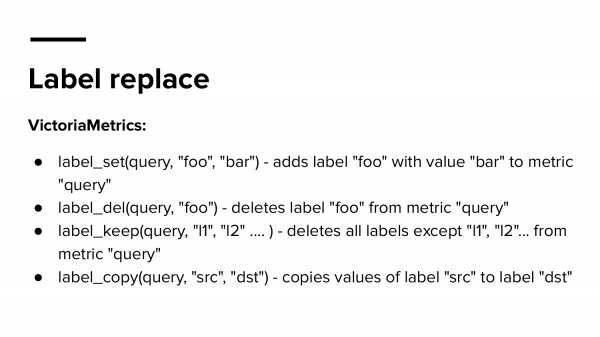
Waarom zouden we het dan niet eenvoudiger maken? Dat wil zeggen, opsplitsen in kleine functies met een duidelijke syntaxis.
En nu het spannendste. Waarom beschouwen we dit als extended PromQL? Omdat we Common Table Expressions ondersteunen. U kunt de QR-code scannen (), de links met voorbeelden bekijken, met een playground waar u queries direct in VictoriaMetrics kunt uitvoeren zonder het te installeren, gewoon in uw browser.
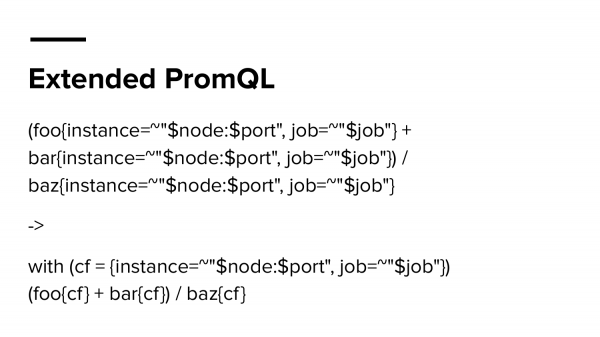
Wat is dit precies? Deze query hierboven is een vrij populaire query. Ik denk dat u in elk dashboard van veel bedrijven dezelfde filter voor alles gebruikt. Gewoonlijk is dat zo. Maar als u een nieuwe filter moet toevoegen, moet u elk paneel bijwerken of het dashboard downloaden, openen in JSON, en een zoek-en-vervang uitvoeren, wat ook tijd kost. Waarom niet deze waarde in een variabele opslaan en hergebruiken? Dat lijkt veel eenvoudiger en duidelijker.
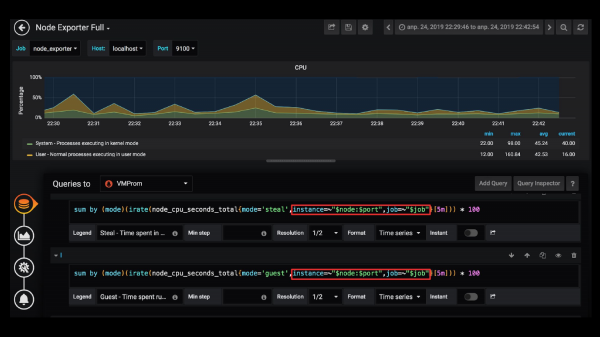
Bijvoorbeeld, wanneer ik filters in Grafana over alle queries moet bijwerken, terwijl het dashboard enorm kan zijn of zelfs meerdere dashboards kunnen zijn. Hoe zou ik dit probleem in Grafana willen oplossen?
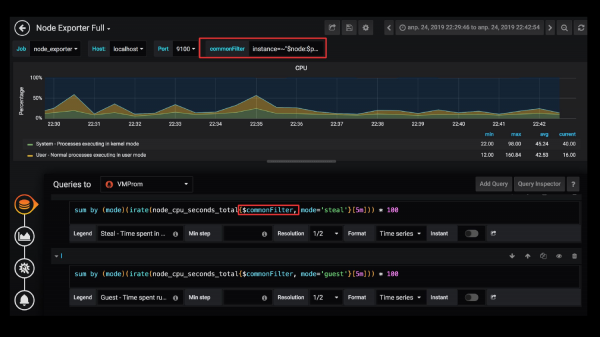
Ik los dit probleem op als volgt: ik maak een commonFilter en definieer daarin deze filter, en gebruik het vervolgens weer in de queries. Maar als u het nu op dezelfde manier doet, werkt het niet, omdat Grafana u niet toestaat variabelen binnen variabele queries te gebruiken. En dat is een beetje vreemd.
Daarom heb ik een optie gemaakt die dit mogelijk maakt. En als je geïnteresseerd bent of je wilt zo'n functie, ondersteun het of geef een dislike als je het idee niet leuk vindt.
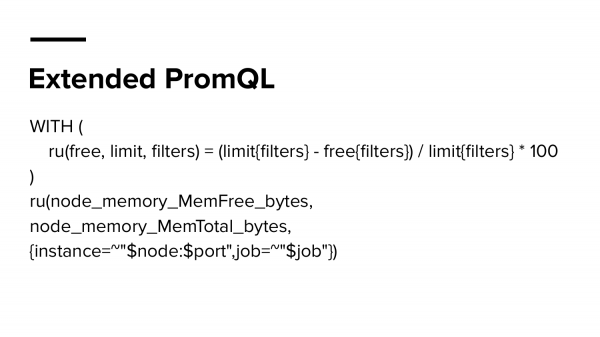
Verder over PromQL extended. Hier definiëren we niet alleen een variabele, maar een hele functie. We noemen het ru (resource usage). Deze functie accepteert vrije middelen, resourcebeperkingen en een filter. De syntaxis is eigenlijk gewoon. Het is heel gemakkelijk om deze functie te gebruiken en het percentage vrije geheugen voor ons te berekenen. Dat wil zeggen, hoeveel geheugen we hebben, wat de beperking is en hoe te filteren. Dit lijkt veel handiger, als u dit allemaal zou schrijven door dezelfde filters opnieuw te gebruiken, omdat het een grote, grote query zou worden.
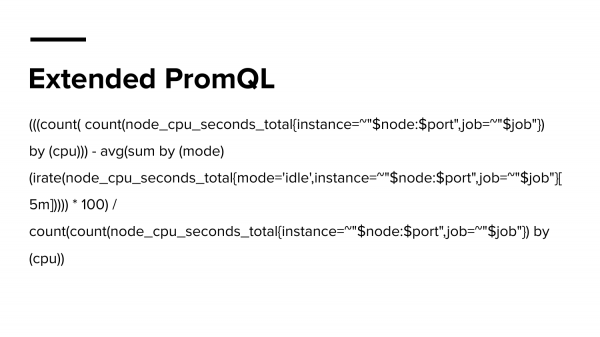
En hier is een voorbeeld van zo'n grote, grote query. Het komt uit het officiële dashboard van NodeExporter voor Grafana. Maar ik begrijp niet goed wat hier aan de hand is. Dat wil zeggen, ik begrijp het wel als ik goed kijk, maar het aantal haakjes kan mijn motivatie om te begrijpen wat hier aan de hand is onmiddellijk verlagen. En waarom zouden we het niet eenvoudiger en begrijpelijker maken?
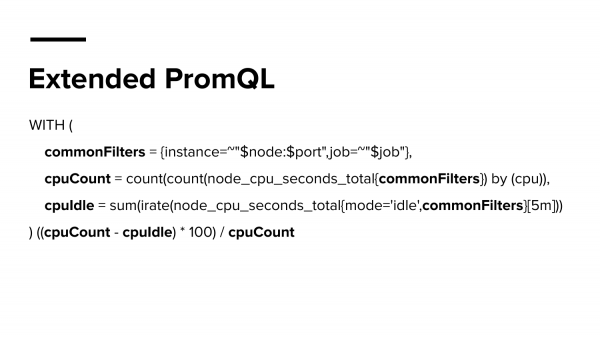
Bijvoorbeeld zo, door belangrijke dingen of delen in variabelen uit te lichten. En dan je basiswiskunde uit te voeren. Dit lijkt al meer op programmeren, dat is wat ik in de toekomst in Grafana zou willen zien.
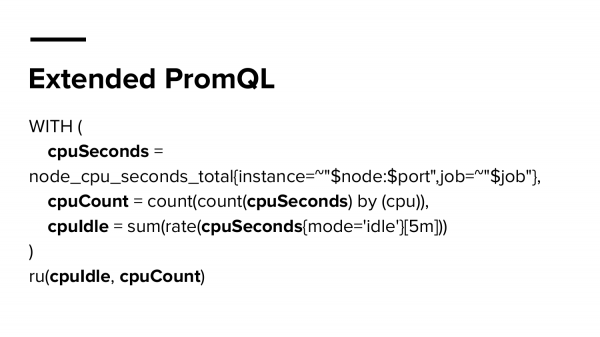
Hier is het tweede voorbeeld, hoe we dit nog eenvoudiger kunnen maken als we deze functie ru al hadden, en die is er al in VictoriaMetrics. Dan geef je gewoon de gecachete waarde door die je in de CTE hebt verklaard.
Ik heb al eerder gezegd hoe belangrijk het is om de juiste programmeertaal te gebruiken. En waarschijnlijk gebeurt er in elk bedrijf iets nieuws in Grafana. En misschien geef je ook toegang tot Grafana aan je ontwikkelaars, en maken de ontwikkelaars iets voor zichzelf. En zij doen dit allemaal op een andere manier. Het zou mooi zijn als het op een bepaalde manier zou gaan, dat wil zeggen, tot een gemeenschappelijke norm te komen.
Stel dat je niet alleen systeemingenieurs hebt, misschien heb je zelfs experts, DevOps of SRE. Misschien heb je experts die weten wat monitoring is, weten wat Grafana is, dat wil zeggen, ze werken hier al jaren mee en ze weten echt hoe het goed moet. En ze hebben dit al 100 keer geschreven en iedereen het uitgelegd, maar om een of andere reden luistert niemand.
En wat als zij deze kennis direct in Grafana konden leggen, zodat andere gebruikers de functies konden hergebruiken? En als ze het percentage vrij geheugen moesten berekenen, zouden ze gewoon de functie toepassen. En wat als de makers van exporteurs samen met hun product ook een set functies zouden aanbieden van hoe met hun metrics te werken, omdat zij precies weten wat voor metrics dit zijn en hoe deze op de juiste manier te berekenen?
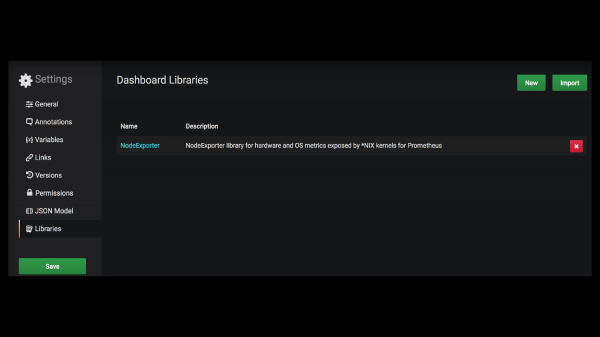
Dit bestaat eigenlijk niet. Dit heb ik zelf gedaan. Dit is de ondersteuning van bibliotheken in Grafana. Stel dat de jongens die NodeExporter hebben gemaakt, hebben gedaan wat ik heb vertelt. En ook een set functies hebben aangeboden.
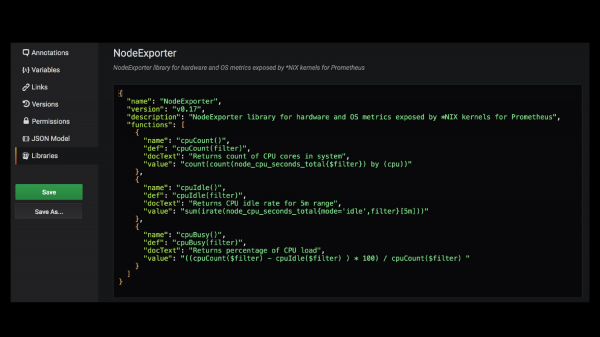
Het ziet er ongeveer zo uit. Je sluit deze bibliotheek aan in Grafana, je gaat naar de bewerking en daar staat heel eenvoudig in JSON beschreven hoe je met deze metric kunt werken. Dat wil zeggen, een set functies, hun beschrijving en hoe ze worden weergegeven.
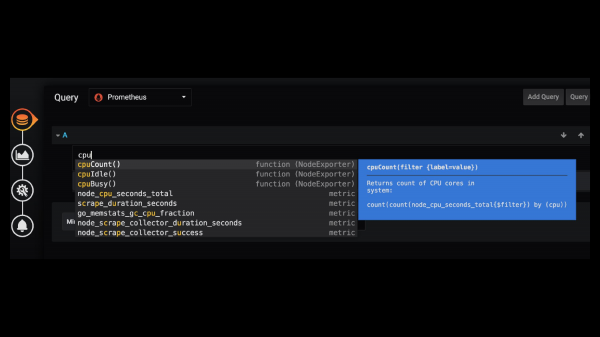
Ik denk dat dit nuttig kan zijn, want dan zou je in Grafana gewoon zo kunnen schrijven. En Grafana 'zegt' je dat er zo'n functie in zo'n bibliotheek is - laten we die gebruiken. Ik denk dat dat geweldig zou zijn.
Een beetje over VictoriaMetrics. We doen veel interessante dingen. Lees onze artikelen over compressie, over onze concurrentie met andere time series datatoepassingen, onze uitleg over hoe je met PromQL moet werken, omdat er nog veel nieuwkomers zijn, en ook over verticale schaalbaarheid en onze strijd met Thanos.
Vragen:
Ik begin mijn vraag met een simpel levensverhaal. Toen ik Grafana voor het eerst begon te gebruiken, schreef ik een zeer overtuigende query van vijf regels. Uiteindelijk kreeg ik een zeer overtuigende grafiek. Deze grafiek stond bijna op het punt om in productie te gaan. Maar bij nader inzien bleek dat deze grafiek absolute nonsens toonde, die helemaal niets met de werkelijkheid te maken had, hoewel de cijfers binnen het verwachte bereik vielen. En mijn vraag. We hebben bibliotheken, we hebben functies, maar hoe schrijven we tests voor Grafana? Je hebt een complexe query geschreven waarop een zakelijke beslissing is gebaseerd - een echte servercontainer bestellen of niet. En hoe weten we dat die functie, die de grafiek tekent, lijkt op de waarheid. Dank je.
Dank voor de vraag. Er zijn twee delen. Ten eerste krijg ik de indruk, op basis van mijn ervaring, dat de meeste gebruikers, wanneer ze naar hun grafieken kijken, niet begrijpen wat ze hen vertellen. Om de een of andere reden zijn mensen heel goed in het verzinnen van excuses voor elke anomalie die op de grafieken verschijnt, zelfs als het een fout in de functie betreft. En het tweede deel - ik denk dat het gebruik van zulke functies veel beter zou zijn om je probleem op te lossen, in plaats van dat elke ontwikkelaar zijn eigen capaciteitsplanning maakt en er een bepaalde kans op fouten is.
Hoe te controleren?
Hoe te controleren? Waarschijnlijk helemaal niet.
In de vorm van een test in Grafana.
Wat heeft Grafana hiermee te maken? Grafana vertaalde deze query rechtstreeks naar de DataSource.
Door een beetje toe te voegen aan de parameters.
Nee, in Grafana wordt niets toegevoegd. Er kunnen GET-parameters zijn, zoals bijvoorbeeld step. Het wordt niet expliciet opgegeven, maar je kunt het overschrijven of niet, maar het wordt automatisch toegevoegd. Je kunt hier geen tests schrijven. Ik denk niet dat je in dit geval op Grafana moet vertrouwen als bron van waarheid.
Bedankt voor de presentatie! Bedankt voor de compressie! Je had het over het mappen van variabelen in de grafiek, dat je in Grafana geen variabele in een variabele kunt gebruiken. Begrijp je wat ik bedoel?
Ja.
Dit was aanvankelijk een hoofdpijn punt, toen ik een alert in Grafana wilde maken. En je moet een alert apart voor elke host maken. Werkt dat ding dat je gemaakt hebt voor alerts in Grafana?
Als Grafana niet op een andere manier met variabelen omgaat, dan – ja, zal het werken. Maar mijn advies is om alerting in Grafana helemaal niet te gebruiken, je kunt beter alertmanager gebruiken.
Ja, ik gebruik het, maar het leek gewoon makkelijker om in Grafana in te stellen, maar bedankt voor de tip!
Bron: habr.com
