

Enkele maanden geleden — een openbare voor PostgreSQL.
In de tussentijd hebt u er al meer dan 6000 keer gebruik van gemaakt, maar een van de handige functies is misschien niet opgemerkt — dit is structurele hints, die er ongeveer zo uitzien:
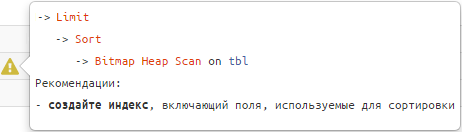
Luister ernaar en uw verzoeken zullen "glad en soepel" worden. 🙂
En om serieus te zijn, veel situaties die een verzoek traag en "resource-intensief" maken, zijn typisch en kunnen worden herkend aan de structuur en gegevens van het plan..
In dit geval hoeft elke afzonderlijke ontwikkelaar niet zelf naar een optimalisatie-oplossing te zoeken op basis van zijn eigen ervaring — we kunnen hem vertellen wat er aan de hand is, wat de oorzaak kan zijn en hoe hij dit kan benaderen.. Wat we ook gedaan hebben.
Laten we deze gevallen iets gedetailleerder bekijken — hoe ze worden gedefinieerd en welke aanbevelingen ze opleveren.
Voor een betere kennismaking met het onderwerp kan je eerst de bijbehorende sectie uit , en dan verder gaan naar de gedetailleerde analyse van elk voorbeeld:
#1: индексная «недосортировка»
Wanneer er ontstaat
Toon het laatste factuur voor klant "LLC Bell".
Hoe te herkennen
-> Limit
   -> Sort
      -> Index [Only] Scan [Backward] | Bitmap Heap Scan
Aanbevelingen
De gebruikte index uitbreiden met sorteervelden.
Voorbeeld:
CREATE TABLE tbl AS
SELECT
  generate_series(1, 100000) pk  -- 100K "feiten"
, (random() * 1000)::integer fk_cli; -- 1K verschillende vreemde sleutels

CREATE INDEX ON tbl(fk_cli); -- index voor vreemde sleutel

SELECT
  *
FROM
  tbl
WHERE
  fk_cli = 1 -- selectie op specifieke relatie
ORDER BY
  pk DESC -- we willen slechts één "laatste" record
LIMIT 1; 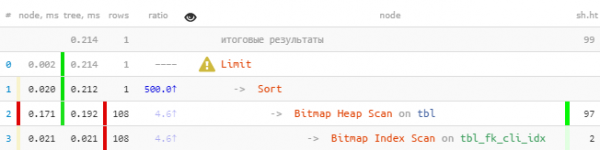
Je zult meteen opmerken dat er meer dan 100 records uit de index zijn gelezen, die vervolgens allemaal zijn gesorteerd, en daarna is er slechts één overgebleven.
Oplossing:
DROP INDEX tbl_fk_cli_idx;
CREATE INDEX ON tbl(fk_cli, pk DESC); -- sorteer sleutel toegevoegd
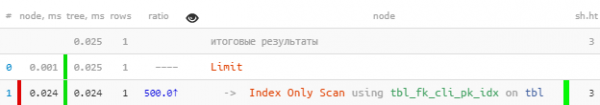
Zelfs op zo'n primitieve selectie — 8,5 keer sneller en 33 keer minder leesacties.. Het effect zal des te duidelijker zijn, naarmate je meer "feiten" hebt voor elke waarde fk.
Ik merk op dat deze index net zo goed zal functioneren als "prefix" voor andere verzoeken met fk, waarbij er geen sorteringen op pk waren en zijn (meer hierover kun je lezen ). Bovendien zal het ook zorgen voor een normale ondersteuning van de expliciete vreemde sleutel voor dit veld.
#2: пересечение индексов (BitmapAnd)
Wanneer er ontstaat
Toon alle contracten voor klant "LLC Bell", afgesloten namens "JSC Buttercup".
Hoe te herkennen
-> BitmapAnd
   -> Bitmap Index Scan
   -> Bitmap Index Scan
Aanbevelingen
Creëren samengestelde index over velden uit beide bronnen of breid een van de bestaande uit met velden uit de tweede.
Voorbeeld:
CREATE TABLE tbl AS
SELECT
  generate_series(1, 100000) pk      -- 100K "feiten"
, (random() *  100)::integer fk_org  -- 100 verschillende externe sleutels
, (random() * 1000)::integer fk_cli; -- 1K verschillende externe sleutels

CREATE INDEX ON tbl(fk_org); -- index voor foreign key
CREATE INDEX ON tbl(fk_cli); -- index voor foreign key

SELECT
  *
FROM
  tbl
WHERE
(fk_org, fk_cli) = (1, 999); -- selectie op een specifieke paar 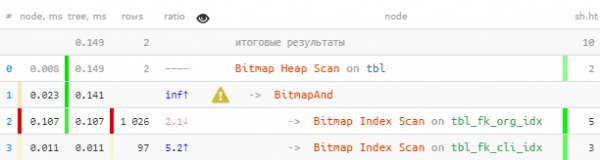
Oplossing:
DROP INDEX tbl_fk_org_idx;
CREATE INDEX ON tbl(fk_org, fk_cli);
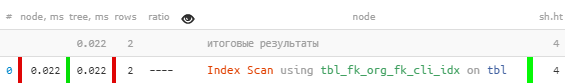
Hier is de winst minder, omdat Bitmap Heap Scan vrij efficiënt op zichzelf is. Maar toch 7 keer sneller en 2,5 keer minder lezingen.
#3: объединение индексов (BitmapOr)
Wanneer er ontstaat
Toon de eerste 20 oudste "eigen" of niet toegewezen aanvragen voor verwerking, waarbij eigen de prioriteit heeft.
Hoe te herkennen
-> BitmapOr
   -> Bitmap Index Scan
   -> Bitmap Index Scan
Aanbevelingen
Gebruik UNION [ALL] voor de combinatie van subquery's voor elk van de OR-blokken van voorwaarden.
Voorbeeld:
CREATE TABLE tbl AS
SELECT
  generate_series(1, 100000) pk  -- 100K "feiten"
, CASE
    WHEN random() < 1::real/16 THEN NULL -- met een kans van 1:16 een "gelijkspel"
    ELSE (random() * 100)::integer -- 100 verschillende externe sleutels
  END fk_own;

CREATE INDEX ON tbl(fk_own, pk); -- index met "blijkbaar passende" sortering

SELECT
  *
FROM
  tbl
WHERE
  fk_own = 1 OR -- eigen
  fk_own IS NULL -- ... of "gelijkspel"
ORDER BY
  pk
, (fk_own = 1) DESC -- eerst "eigen"
LIMIT 20;
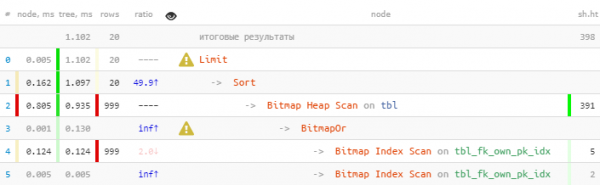
Oplossing:
(
  SELECT
    *
  FROM
    tbl
  WHERE
    fk_own = 1 -- eerst "eigen" 20
  ORDER BY
    pk
  LIMIT 20
)
UNION ALL
(
  SELECT
    *
  FROM
    tbl
  WHERE
    fk_own IS NULL -- dan "gelijkspel" 20
  ORDER BY
    pk
  LIMIT 20
)
LIMIT 20; -- maar in totaal - 20, meer is niet nodig 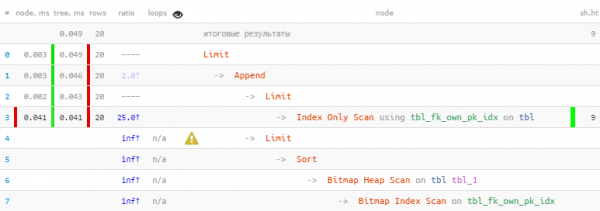
We hebben gebruikgemaakt van het feit dat alle 20 benodigde records al in het eerste blok waren verkregen, waardoor het tweede blok met de meer "kostbare" Bitmap Heap Scan zelfs niet werd uitgevoerd - uiteindelijk 22 keer sneller, 44 keer minder lezingen!
Een gedetailleerder verhaal over deze optimalisatiemethode aan de hand van concrete voorbeelden kan worden gelezen in artikelen en .
Algemene variant van geordende selectie op meerdere sleutels (en niet alleen op het paar const/NULL) is besproken in het artikel .
#4: читаем много лишнего
Wanneer er ontstaat
Meestal ontstaat dit wanneer er een "extra filter" aan de bestaande query wil worden toegevoegd.
"Heeft u ook zoiets, maar met parelmoeren knopen?» film "De Diamanten Hand"
Bijvoorbeeld, door de eerdere taak aan te passen, toon de eerste 20 oudste "kritische" aanvragen voor verwerking, ongeacht hun toewijzing.
Hoe te herkennen
-> Seq Scan | Bitmap Heap Scan | Index [Only] Scan [Backward]
   && 5 × rijen 80% gelezen
   && loops × RRbF > 100 -- en tegelijkertijd meer dan 100 records in totaal
Aanbevelingen
Maak [meer] gespecialiseerde index met WHERE-voorwaarde of extra fields in the index.
If the filtering condition is "static" for your tasks — that is, does not imply expansion of the list of values in the future — it is better to use a WHERE index. Different boolean/enum statuses fit well into this category.
If the filtering condition can take different values,, then it is better to expand the index with these fields — as in the situation with BitmapAnd above.
Voorbeeld:
CREATE TABLE tbl AS
SELECT
  generate_series(1, 100000) pk -- 100K "facts"
, CASE
    WHEN random() < 1::real/16 THEN NULL
    ELSE (random() * 100)::integer -- 100 different foreign keys
  END fk_own
, (random() < 1::real/50) critical; -- 1:50, that the request is "critical"

CREATE INDEX ON tbl(pk);
CREATE INDEX ON tbl(fk_own, pk);

SELECT
  *
FROM
  tbl
WHERE
  critical
ORDER BY
  pk
LIMIT 20; 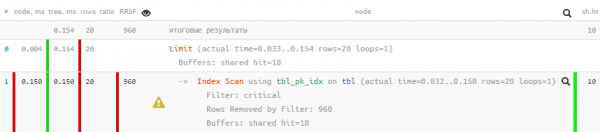
Oplossing:
CREATE INDEX ON tbl(pk)
  WHERE critical; -- added a "static" filtering condition
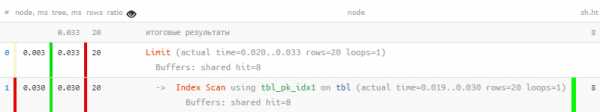
As we can see, the filtering has completely disappeared from the plan, and the query has become 5 times faster.
#5: разреженная таблица
Wanneer er ontstaat
Various attempts to create a custom task processing queue, when a large number of updates/deletions of records in the table result in a situation with a large number of "dead" records.
Hoe te herkennen
-> Seq Scan | Bitmap Heap Scan | Index [Only] Scan [Backward]
   && loops × (rows + RRbF)  64
Aanbevelingen
Regularly perform manually VACUUM [FULL] or achieve adequately frequent operation by finely tuning its parameters, including .
In most cases, such problems are caused by poor query assembly in calls from business logic like those discussed in .
But it should be understood that even VACUUM FULL may not always help. For such cases, it's worth reviewing the algorithm from the article .
#6: чтение с «середины» индекса
Wanneer er ontstaat
It seems that we've read a little, everything is indexed, and no unnecessary filters were applied — yet significantly more pages were read than desired.
Hoe te herkennen
-> Index [Only] Scan [Backward]
   && loops × (rows + RRbF)  64
Aanbevelingen
Carefully examine the structure of the index used and the key fields defined in the query — most likely, part of the index is not defined.Most likely, you will need to create a similar index, but without prefix fields or .
Voorbeeld:
MAAK TABEL tbl AS
SELECT
  generate_series(1, 100000) pk      -- 100K "feiten"
, (random() *  100)::integer fk_org  -- 100 verschillende externe sleutels
, (random() * 1000)::integer fk_cli; -- 1K verschillende externe sleutels

MAAK INDEX OP tbl(fk_org, fk_cli); -- bijna alles zoals in #2
-- alleen hebben we de aparte index op fk_cli als overbodig beschouwt en verwijderd

SELECT
  *
FROM
  tbl
WHERE
  fk_cli = 999 -- en fk_org is niet opgegeven, hoewel het eerder in de index staat
LIMIT 20; 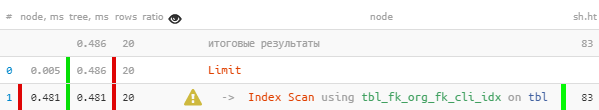
Alles lijkt goed, zelfs met de index, maar het is een beetje verdacht — voor elk van de 20 gelezen records moesten we 4 pagina's gegevens doorlezen, 32KB per record — is dat niet teveel? En de naam van de index tbl_fk_org_fk_cli_idx roept vragen op.
Oplossing:
MAAK INDEX OP tbl(fk_cli); 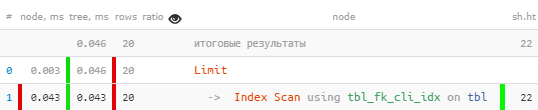
Plotseling — 10 keer sneller, en 4 keer minder te lezen!
Andere voorbeelden van inefficiënt gebruik van indexen zijn te zien in het artikel .
#7: CTE × CTE
Wanneer er ontstaat
In de query hebben we "dikke" CTE's verzameld uit verschillende tabellen, en toen besloten we om ze tussen elkaar te maken JOIN.
Deze case is relevant voor versies onder v12 of queries met MET MATERIALIZED.
Hoe te herkennen
-> CTE Scan
   && loops > 10
   && loops × (rows + RRbF) > 10000
      -- te grote cartesiaanse product CTE
Aanbevelingen
Analyseer de query zorgvuldig — en ? Если все-таки да, то toepassen van "woordenboeken" in hstore/json volgens het model beschreven in .
#8: swap на диск (temp written)
Wanneer er ontstaat
Een eenmalige verwerking (sorteren of uniek maken) van een groot aantal records past niet in het daarvoor toegewezen geheugen.
Hoe te herkennen
-> *
   && temp written > 0
Aanbevelingen
Als de hoeveelheid geheugen die door de operatie is gebruikt niet veel hoger is dan de ingestelde waarde van de parameter , is het verstandig om deze aan te passen. Dit kan meteen in de configuratie voor iedereen, of via SET [LOCAL] voor een specifieke query/transactie.
Voorbeeld:
TOON work_mem;
-- "16MB"

SELECT
  random()
FROM
  generate_series(1, 1000000)
ORDER BY
1; 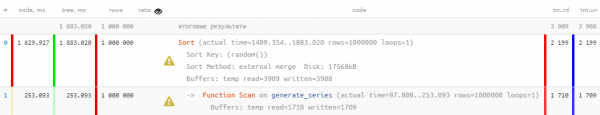
Oplossing:
SET work_mem = '128MB'; -- vóór het uitvoeren van de query 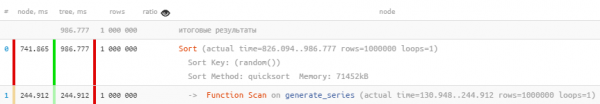
Om begrijpelijke redenen, als alleen geheugen wordt gebruikt en geen schijf, zal de query veel sneller worden uitgevoerd. Daarnaast wordt ook een deel van de belasting van de HDD verminderd.
Maar het moet duidelijk zijn dat je niet eenvoudigweg veel geheugen kunt toewijzen — er is simpelweg niet genoeg voor iedereen.
#9: неактуальная статистика
Wanneer er ontstaat
Er is veel tegelijk in de database geladen, maar er was geen tijd om ANALYZE.
Hoe te herkennen
-> Seq Scan | Bitmap Heap Scan | Index [Only] Scan [Backward]
   && ratio >> 10
Aanbevelingen
Ongetwijfeld ANALYZE.
Deze situatie wordt uitgebreider besproken in .
#10: «что-то пошло не так»
Wanneer er ontstaat
Er was een blokkering die werd verwacht, opgelegd door een concurrerende query, of er waren niet genoeg hardwarebronnen beschikbaar voor CPU/hypervisor.
Hoe te herkennen
-> *
   && (gedeeld hit / 8K) + (gedeeld lezen / 1K)  100ms -- we hebben weinig gelezen, maar te lang
Aanbevelingen
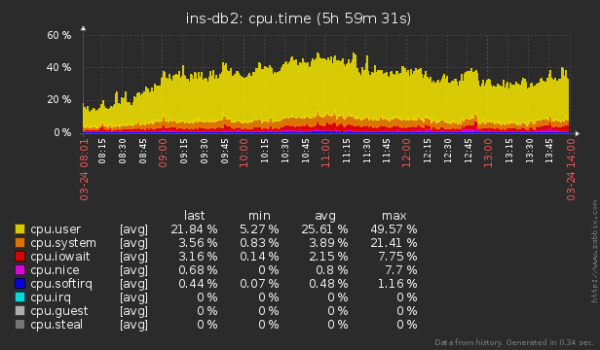
Gebruik een externe systeem voor monitoring van servers om blokkades of onregelmatig middelenverbruik te detecteren. Over onze aanpak voor het organiseren van dit proces voor honderden servers hebben we al verteld. en .
Bron: habr.com
