

Kube-scheduler is een essentieel onderdeel van Kubernetes dat verantwoordelijk is voor het plannen van pods op knooppunten volgens vastgestelde beleidsregels. Vaak hoeven we ons tijdens de werking van een Kubernetes-cluster geen zorgen te maken over de specifieke beleidsregels volgens welke de pods worden gepland, omdat de standaardset van kube-scheduler voor de meeste dagelijkse taken geschikt is. Er zijn echter situaties waarin we de verdeling van pods nauwkeuriger willen beheren, en er zijn twee wegen om deze taak uit te voeren:
- Een kube-scheduler creëren met een aangepaste set regels
- Een eigen scheduler schrijven en deze leren werken met verzoeken van de API-server
In dit artikel zal ik de implementatie van de eerste optie beschrijven om het probleem van ongelijkmatige podplanning in een van onze projecten op te lossen.
Korte inleiding tot de werking van kube-scheduler
Het is belangrijk om op te merken dat kube-scheduler niet verantwoordelijk is voor het directe plannen van pods — het is alleen verantwoordelijk voor het bepalen van het knooppunt waar een pod moet worden geplaatst. Met andere woorden, het resultaat van de werking van kube-scheduler is de naam van het knooppunt, die terug wordt gegeven aan de API-server op een planning verzoek, en daarmee eindigt zijn taak.
Eerst stelt kube-scheduler een lijst op van knooppunten waarop een pod volgens de predicates beleid kan worden gepland. Vervolgens krijgt ieder knooppunt in deze lijst een bepaald aantal punten op basis van de priorites beleid. Uiteindelijk wordt het knooppunt gekozen dat de meeste punten heeft verzameld. Als er knooppunten zijn die hetzelfde maximale aantal punten hebben, wordt er een willekeurige gekozen. Voor de lijst en beschrijving van de predicates (filtering) en priorites (scoring) beleid kan worden bekeken in .
Beschrijving van het probleem
Ondanks het grote aantal verschillende Kubernetes-clusters dat wij onderhouden bij Nixys, zijn we pas recentelijk voor het eerst met het probleem van podplanning geconfronteerd, toen voor een van onze projecten de noodzaak ontstond om een groot aantal periodieke taken (~100 CronJob-entiteiten) uit te voeren. Om de probleemomschrijving zo eenvoudig mogelijk te maken, nemen we als voorbeeld een microservice, waarbij elke minuut een cron-taak wordt uitgevoerd die een bepaalde belasting op de CPU genereert. Voor de uitvoering van de cron-taak zijn drie volledig identieke knooppunten (elke met 24 vCPU) toegewezen.
Het is echter niet precies te zeggen hoe lang een CronJob zal duren, aangezien de hoeveelheid inkomende data constant verandert. Gemiddeld, bij normale werking van de kube-scheduler, draait er op elke node 3-4 exemplaren van de taak, die ~20-30% belasting op de CPU van elke node veroorzaken.
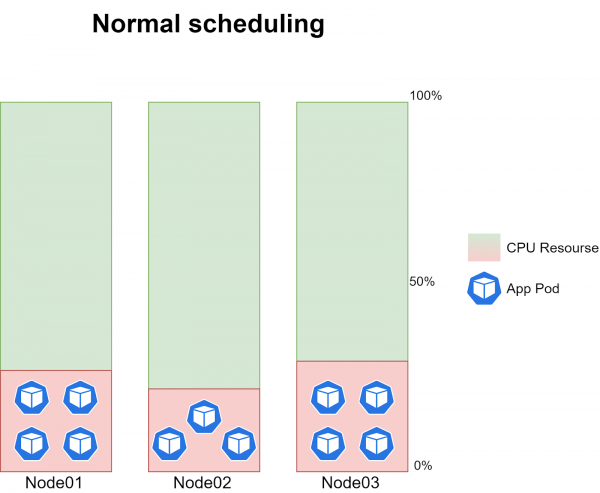
Het probleem is dat af en toe de pods van de cron-taak niet werden gepland op een van de drie nodes. Met andere woorden, op een bepaald moment werd er op een van de nodes geen enkele pod gepland, terwijl er op de andere twee nodes 6-8 exemplaren van de taak draaiden, wat ~40-60% belasting op de CPU veroorzaakte.
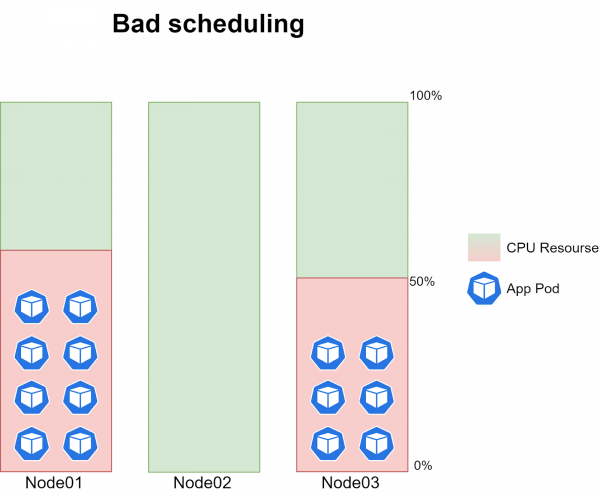
Het probleem deed zich voor met absoluut willekeurige periodiciteit en korreleerde zelden met het moment van de uitrol van een nieuwe versie van de code.
Door het logniveau van de kube-scheduler te verhogen naar niveau 10 (-v=10) begonnen we vast te leggen hoeveel punten elke node verzamelt in het beoordelingsproces. Bij normale planningswerking kon de volgende informatie in de logs worden gezien:
resource_allocation.go:78] cronjob-1574828880-mn7m4 -> Node03: BalancedResourceAllocation, capaciteit 23900 millicores 67167186944 geheug Bytes, totale aanvraag 1387 millicores 4161694720 geheug Bytes, score 9
resource_allocation.go:78] cronjob-1574828880-mn7m4 -> Node02: BalancedResourceAllocation, capaciteit 23900 millicores 67167186944 geheug Bytes, totale aanvraag 1347 millicores 4444810240 geheug Bytes, score 9
resource_allocation.go:78] cronjob-1574828880-mn7m4 -> Node03: LeastResourceAllocation, capaciteit 23900 millicores 67167186944 geheug Bytes, totale aanvraag 1387 millicores 4161694720 geheug Bytes, score 9
resource_allocation.go:78] cronjob-1574828880-mn7m4 -> Node01: BalancedResourceAllocation, capaciteit 23900 millicores 67167186944 geheug Bytes, totale aanvraag 1687 millicores 4790840320 geheug Bytes, score 9
resource_allocation.go:78] cronjob-1574828880-mn7m4 -> Node02: LeastResourceAllocation, capaciteit 23900 millicores 67167186944 geheug Bytes, totale aanvraag 1347 millicores 4444810240 geheug Bytes, score 9
resource_allocation.go:78] cronjob-1574828880-mn7m4 -> Node01: LeastResourceAllocation, capaciteit 23900 millicores 67167186944 geheug Bytes, totale aanvraag 1687 millicores 4790840320 geheug Bytes, score 9
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node01: NodeAffinityPriority, Score: (0)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node02: NodeAffinityPriority, Score: (0)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node03: NodeAffinityPriority, Score: (0)
interpod_affinity.go:237] cronjob-1574828880-mn7m4 -> Node01: InterPodAffinityPriority, Score: (0)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node01: TaintTolerationPriority, Score: (10)
interpod_affinity.go:237] cronjob-1574828880-mn7m4 -> Node02: InterPodAffinityPriority, Score: (0)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node02: TaintTolerationPriority, Score: (10)
selector_spreading.go:146] cronjob-1574828880-mn7m4 -> Node01: SelectorSpreadPriority, Score: (10)
interpod_affinity.go:237] cronjob-1574828880-mn7m4 -> Node03: InterPodAffinityPriority, Score: (0)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node03: TaintTolerationPriority, Score: (10)
selector_spreading.go:146] cronjob-1574828880-mn7m4 -> Node02: SelectorSpreadPriority, Score: (10)
selector_spreading.go:146] cronjob-1574828880-mn7m4 -> Node03: SelectorSpreadPriority, Score: (10)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node01: SelectorSpreadPriority, Score: (10)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node02: SelectorSpreadPriority, Score: (10)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node03: SelectorSpreadPriority, Score: (10)
generic_scheduler.go:781] Host Node01 -> Score 100043
generic_scheduler.go:781] Host Node02 -> Score 100043
generic_scheduler.go:781] Host Node03 -> Score 100043
Dat wil zeggen, op basis van de informatie uit de logs, behaalde elke node een gelijk aantal eindpunten en werd er willekeurig gekozen voor de planning. Op het moment van de probleemplanning zagen de logs er als volgt uit:
resource_allocation.go:78] cronjob-1574211360-bzfkr -> Node02: BalancedResourceAllocation, capaciteit 23900 millicores 67167186944 geheugengegevens, totale aanvraag 1587 millicores 4581125120 geheugengegevens, score 9
resource_allocation.go:78] cronjob-1574211360-bzfkr -> Node03: BalancedResourceAllocation, capaciteit 23900 millicores 67167186944 geheugengegevens, totale aanvraag 1087 millicores 3532549120 geheugengegevens, score 9
resource_allocation.go:78] cronjob-1574211360-bzfkr -> Node02: LeastResourceAllocation, capaciteit 23900 millicores 67167186944 geheugengegevens, totale aanvraag 1587 millicores 4581125120 geheugengegevens, score 9
resource_allocation.go:78] cronjob-1574211360-bzfkr -> Node01: BalancedResourceAllocation, capaciteit 23900 millicores 67167186944 geheugengegevens, totale aanvraag 987 millicores 3322833920 geheugengegevens, score 9
resource_allocation.go:78] cronjob-1574211360-bzfkr -> Node01: LeastResourceAllocation, capaciteit 23900 millicores 67167186944 geheugengegevens, totale aanvraag 987 millicores 3322833920 geheugengegevens, score 9
resource_allocation.go:78] cronjob-1574211360-bzfkr -> Node03: LeastResourceAllocation, capaciteit 23900 millicores 67167186944 geheugengegevens, totale aanvraag 1087 millicores 3532549120 geheugengegevens, score 9
interpod_affinity.go:237] cronjob-1574211360-bzfkr -> Node03: InterPodAffinityPriority, Score: (0)
interpod_affinity.go:237] cronjob-1574211360-bzfkr -> Node02: InterPodAffinityPriority, Score: (0)
interpod_affinity.go:237] cronjob-1574211360-bzfkr -> Node01: InterPodAffinityPriority, Score: (0)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node03: TaintTolerationPriority, Score: (10)
selector_spreading.go:146] cronjob-1574211360-bzfkr -> Node03: SelectorSpreadPriority, Score: (10)
selector_spreading.go:146] cronjob-1574211360-bzfkr -> Node02: SelectorSpreadPriority, Score: (10)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node02: TaintTolerationPriority, Score: (10)
selector_spreading.go:146] cronjob-1574211360-bzfkr -> Node01: SelectorSpreadPriority, Score: (10)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node03: NodeAffinityPriority, Score: (0)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node03: SelectorSpreadPriority, Score: (10)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node02: SelectorSpreadPriority, Score: (10)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node01: TaintTolerationPriority, Score: (10)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node02: NodeAffinityPriority, Score: (0)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node01: NodeAffinityPriority, Score: (0)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node01: SelectorSpreadPriority, Score: (10)
generic_scheduler.go:781] Host Node03 -> Score 100041
generic_scheduler.go:781] Host Node02 -> Score 100041
generic_scheduler.go:781] Host Node01 -> Score 100038
Hieruit blijkt dat een van de nodes minder totale punten heeft behaald dan de andere, en daarom werd de planning alleen uitgevoerd op de twee nodes met de hoogste score. Zo hebben we met zekerheid vastgesteld dat het probleem ligt in de planning van de pods.
Het verdere algoritme om het probleem op te lossen was voor ons duidelijk — we moesten de logs analyseren, begrijpen op basis van welke prioriteit de node niet genoeg punten behaalde en, indien nodig, de standaard kube-scheduler beleidsregels aanpassen. Echter, hier stuitten we op twee aanzienlijke moeilijkheden:
- Op het hoogste logniveau (10) worden alleen scores weergegeven voor enkele prioriteiten. In het bovenstaande logfragment is te zien dat de nodes gelijk aantal punten behalen voor alle prioriteiten die in de logs worden weergegeven, zowel bij normale als problematische planning, maar het uiteindelijke resultaat verschilt in het geval van problematische planning. We kunnen dus concluderen dat er voor bepaalde prioriteiten een ‘verborgen’ puntentelling plaatsvindt, en we hebben geen mogelijkheid om te begrijpen op basis van welke prioriteit de node niet genoeg punten heeft behaald. Dit probleem hebben we gedetailleerd beschreven in de Kubernetes-repository op Github. Op het moment van schrijven van dit artikel hebben we een antwoord van de ontwikkelaars gekregen dat logondersteuning zal worden toegevoegd in de updates van Kubernetes v1.15, 1.16 en 1.17.
- Er is geen eenvoudige manier om te begrijpen met welke specifieke set beleidsregels de kube-scheduler momenteel werkt. Ja, in deze lijst zijn ze opgenomen, maar er is geen informatie over welke specifieke gewichten aan elk van de prioriteitsregels zijn toegekend. De gewichten zien of de beleidsregels van de standaard kube-scheduler aanpassen kan alleen in .
Het is vermeldenswaard dat we één keer hebben kunnen vaststellen dat de node niet genoeg punten behaalde op basis van de ImageLocalityPriority, die punten toekent aan een node als deze al een afbeelding heeft die nodig is voor de implementatie van de applicatie. Dat wil zeggen, op het moment dat een nieuwe versie van de applicatie werd uitgerold, was de cron-taak al bezig met het draaien op twee nodes, waarbij nieuwe afbeeldingen uit de docker registry werden gedownload, en zo behaalden deze twee nodes een hogere uiteindelijke score in vergelijking met de derde.
Zoals ik hierboven al schreef, zien we in de logs geen informatie over de beoordeling van het beleid ImageLocalityPriority. Daarom hebben we om onze aanname te verifiëren een afbeelding met de nieuwe versie van de applicatie naar de derde node gepusht, waarna het plannen correct werkte. De problemen met het plannen deden zich vaak voor door iets anders, eerder dan door het beleid ImageLocalityPriority, dat slechts zelden problemen veroorzaakte. Aangezien we niet elke beleidsvariant in de lijst met prioriteiten van de standaard kube-scheduler volledig konden debuggen, hadden we de noodzaak om flexibel om te gaan met het plannen van pod-beleidsregels.
Taakstelling
We wilden dat de oplossing voor het probleem zo doelgericht mogelijk was; dat wil zeggen, de belangrijkste entiteiten van Kubernetes (in dit geval de standaard kube-scheduler) moeten onveranderd blijven. We wilden het probleem niet op de ene plek oplossen en er elders een nieuw probleem mee creëren. Zo kwamen we tot twee oplossingsvarianten, die in de inleiding van het artikel zijn besproken: het creëren van een extra scheduler of het schrijven van onze eigen. De belangrijkste eis voor de planning van cron-taken is een gelijkmatige verdeling van de belasting over de drie nodes. Deze eis kan worden vervuld met de reeds bestaande beleidsregels van de kube-scheduler, dus er is geen zin in het schrijven van een eigen scheduler voor onze taak.
De instructie voor het maken en implementeren van een extra kube-scheduler wordt beschreven in . Echter, we vonden dat de entiteiten van de Deployment niet voldoende waren voor de waarborging van de beschikbaarheid van een zo cruciale service als kube-scheduler, en dus besloten we om een nieuwe kube-scheduler als Static Pod te implementeren, waar Kubelet rechtstreeks toezicht op zal hebben. We hebben daarmee de volgende vereisten aan de nieuwe kube-scheduler gesteld:
- De service moet als Static Pod op alle masters van het cluster worden geïmplementeerd.
- Er moet een failover zijn voor het geval de actieve pod met kube-scheduler onbeschikbaar is.
- Het belangrijkste prioriteit bij de planning moet de hoeveelheid beschikbare bronnen op de node zijn (LeastRequestedPriority).
Implementatie van de oplossing
Het is belangrijk om op te merken dat al het werk wordt uitgevoerd in Kubernetes v1.14.7, aangezien deze versie in het project werd gebruikt. Laten we beginnen met het schrijven van de manifest voor onze nieuwe kube-scheduler. We nemen als basis de manifest van de standaard (\/etc\/kubernetes\/manifests\/kube-scheduler.yaml) en brengen deze in de volgende vorm:
soort: Pod
metadata:
  labels:
    component: scheduler
    tier: control-plane
  naam: kube-scheduler-cron
  namespace: kube-system
spec:
      containers:
      - command:
        - /usr/local/bin/kube-scheduler
        - --address=0.0.0.0
        - --port=10151
        - --secure-port=10159
        - --config=/etc/kubernetes/scheduler-custom.conf
        - --authentication-kubeconfig=/etc/kubernetes/scheduler.conf
        - --authorization-kubeconfig=/etc/kubernetes/scheduler.conf
        - --v=2
        image: gcr.io/google-containers/kube-scheduler:v1.14.7
        imagePullPolicy: IfNotPresent
        livenessProbe:
          failureThreshold: 8
          httpGet:
            host: 127.0.0.1
            path: /healthz
            port: 10151
            scheme: HTTP
          initialDelaySeconds: 15
          timeoutSeconds: 15
        naam: kube-scheduler-cron-container
        resources:
          requests:
            cpu: '0.1'
        volumeMounts:
        - mountPath: /etc/kubernetes/scheduler.conf
          naam: kube-config
          readOnly: true
        - mountPath: /etc/localtime
          naam: localtime
          readOnly: true
        - mountPath: /etc/kubernetes/scheduler-custom.conf
          naam: scheduler-config
          readOnly: true
        - mountPath: /etc/kubernetes/scheduler-custom-policy-config.json
          naam: policy-config
          readOnly: true
      hostNetwork: true
      priorityClassName: system-cluster-critical
      volumes:
      - hostPath:
          path: /etc/kubernetes/scheduler.conf
          type: FileOrCreate
        naam: kube-config
      - hostPath:
          path: /etc/localtime
        naam: localtime
      - hostPath:
          path: /etc/kubernetes/scheduler-custom.conf
          type: FileOrCreate
        naam: scheduler-config
      - hostPath:
          path: /etc/kubernetes/scheduler-custom-policy-config.json
          type: FileOrCreate
        naam: policy-config
Korte samenvatting van de belangrijkste wijzigingen:
- We hebben de naam van de pod en container gewijzigd in kube-scheduler-cron
- We hebben de poorten 10151 en 10159 opgegeven omdat de optie is gedefinieerd
hostNetwork: trueen we kunnen dezelfde poorten niet gebruiken als de standaard kube-scheduler (10251 en 10259) - Met de parameter --config hebben we het configuratiebestand opgegeven waarmee de dienst moet worden gestart
- We hebben het monteren van het configuratiebestand (scheduler-custom.conf) en het beleidsbestand voor planning (scheduler-custom-policy-config.json) vanaf de host ingesteld
Vergeet niet dat onze kube-scheduler rechten nodig heeft die vergelijkbaar zijn met die van de standaard. We bewerken zijn clusterrol:
kubectl edit clusterrole system:kube-scheduler..
resourceNames:
- kube-scheduler
- kube-scheduler-cron
...Laten we nu bespreken wat er in het configuratiebestand en het beleidsbestand voor planning moet staan:
- Configuratiebestand (scheduler-custom.conf)
Om de configuratie van de standaard kube-scheduler te krijgen, moet je de parameter gebruiken--write-config-touit . We plaatsen de verkregen configuratie in het bestand /etc/kubernetes/scheduler-custom.conf en brengen het in de volgende vorm:
apiVersion: kubescheduler.config.k8s.io/v1alpha1
kind: KubeSchedulerConfiguration
schedulerName: kube-scheduler-cron
bindTimeoutSeconds: 600
clientConnection:
  acceptContentTypes: ""
  burst: 100
  contentType: application/vnd.kubernetes.protobuf
  kubeconfig: /etc/kubernetes/scheduler.conf
  qps: 50
disablePreemption: false
enableContentionProfiling: false
enableProfiling: false
failureDomains: kubernetes.io/hostname,failure-domain.beta.kubernetes.io/zone,failure-domain.beta.kubernetes.io/region
hardPodAffinitySymmetricWeight: 1
healthzBindAddress: 0.0.0.0:10151
leaderElection:
  leaderElect: true
  leaseDuration: 15s
  lockObjectName: kube-scheduler-cron
  lockObjectNamespace: kube-system
  renewDeadline: 10s
  resourceLock: endpoints
  retryPeriod: 2s
metricsBindAddress: 0.0.0.0:10151
percentageOfNodesToScore: 0
algorithmSource:
   policy:
     file:
       path: "/etc/kubernetes/scheduler-custom-policy-config.json"
Korte samenvatting van de belangrijkste wijzigingen:
- We hebben de naam van onze service kube-scheduler-cron ingesteld in schedulerName.
- In de parameter
lockObjectNamemoet ook de naam van onze service worden ingesteld en moet worden gecontroleerd of de parameterleaderElectis ingesteld op true (als je een enkele master-node hebt, kan dit op false worden ingesteld). - We hebben het pad naar het bestand met de beschrijving van de planningspolitiek ingesteld in de parameter
algorithmSource.
Het is de moeite waard om iets uitgebreider stil te staan bij het tweede punt, waar we de parameters voor de sleutel leaderElectionbewerken. Voor het waarborgen van de beschikbaarheid hebben we het proces van het kiezen van een leider (master) geactiveerd tussen de pods van onze kube-scheduler met behulp van een enkele endpoint voor hen (leaderElectresourceLock) met de naam kube-scheduler-cron () in de namespace kube-system (lockObjectNamelockObjectNamespace). Hoe in Kubernetes de hoge beschikbaarheid van de belangrijkste componenten (inclusief kube-scheduler) wordt gewaarborgd, kan worden geraadpleegd inHet bestand met planningspolitiek (scheduler-custom-policy-config.json) .
- Zoals eerder vermeld, kunnen we alleen door de code van de standaard kube-scheduler te analyseren, ontdekken met welke specifieke politiekagen de standaard kube-scheduler werkt. Dat wil zeggen, we kunnen het bestand met de planningspolitiek van de standaard kube-scheduler niet verkrijgen zoals bij het configuratiebestand. We zullen de interessante planningspolitiek in het bestand /etc/kubernetes/scheduler-custom-policy-config.json als volgt beschrijven:
{ "kind": "Policy", "apiVersion": "v1", "predicates": [ { "name": "GeneralPredicates" } ], "priorities": [ { "name": "ServiceSpreadingPriority", "weight": 1 }, { "name": "EqualPriority", "weight": 1 }, { "name": "LeastRequestedPriority", "weight": 1 }, { "name": "NodePreferAvoidPodsPriority", "weight": 10000 }, { "name": "NodeAffinityPriority", "weight": 1 } ], "hardPodAffinitySymmetricWeight": 10, "alwaysCheckAllPredicates": false }
{
  "kind": "Beleid",
  "apiVersion": "v1",
  "predicates": [
    {
      "name": "AlgemenePredicates"
    }
  ],
  "priorities": [
    {
      "name": "DienstVerspreidingsPrioriteit",
      "weight": 1
    },
    {
      "name": "GelijkePrioriteit",
      "weight": 1
    },
    {
      "name": "MinstAangevraagdePrioriteit",
      "weight": 1
    },
    {
      "name": "NodeVoorkeurVermijdPodsPrioriteit",
      "weight": 10000
    },
    {
      "name": "NodeAffiniteitPrioriteit",
      "weight": 1
    }
  ],
  "hardPodAffiniteitSymmetrischGewicht" : 10,
  "altijdControleerAllePredicates" : false
}
Zo kan de kube-scheduler eerst een lijst van nodes samenstellen waarop een pod kan worden gepland volgens het beleid GeneralPredicates (dat een set van beleidsregels zoals PodFitsResources, PodFitsHostPorts, HostName en MatchNodeSelector omvat). Vervolgens wordt elke node geëvalueerd op basis van een set van beleidsregels in de array priorities. Voor de voorwaarden van onze taak hebben we aangenomen dat deze set van beleidsregels een optimale oplossing zou zijn. Ter herinnering, de set van beleidsregels met hun gedetailleerde beschrijving is beschikbaar in . Voor het uitvoeren van jouw taak kun je eenvoudig de set van gebruikte beleidsregels wijzigen en hen de bijbehorende gewichten toekennen.
Het manifest van de nieuwe kube-scheduler die we aan het begin van het hoofdstuk hebben gemaakt, noemen we kube-scheduler-custom.yaml en we plaatsen het op het volgende pad /etc/kubernetes/manifests op de drie master-nodes. Als alles correct is uitgevoerd, zal Kubelet op elke node de pod starten en in de logs van onze nieuwe kube-scheduler zullen we informatie zien dat ons beleidsbestand succesvol is toegepast:
Scheduler aanmaken vanuit configuratie: {{ } [{GeneralPredicates }] [{ServiceSpreadingPriority 1 } {EqualPriority 1 } {LeastRequestedPriority 1 } {NodePreferAvoidPodsPriority 10000 } {NodeAffinityPriority 1 } }] [] 10 false}
Predikaat registreren: GeneralPredicates
Predikaat type GeneralPredicates is al geregistreerd, opnieuw gebruiken.
Prioriteit registreren: ServiceSpreadingPriority
Prioriteit type ServiceSpreadingPriority is al geregistreerd, opnieuw gebruiken.
Prioriteit registreren: EqualPriority
Prioriteit type EqualPriority is al geregistreerd, opnieuw gebruiken.
Prioriteit registreren: LeastRequestedPriority
Prioriteit type LeastRequestedPriority is al geregistreerd, opnieuw gebruiken.
Prioriteit registreren: NodePreferAvoidPodsPriority
Prioriteit type NodePreferAvoidPodsPriority is al geregistreerd, opnieuw gebruiken.
Prioriteit registreren: NodeAffinityPriority
Prioriteit type NodeAffinityPriority is al geregistreerd, opnieuw gebruiken.
Scheduler aanmaken met passende predikaten 'map[GeneralPredicates:{}]' en prioriteitsfuncties 'map[EqualPriority:{} LeastRequestedPriority:{} NodeAffinityPriority:{} NodePreferAvoidPodsPriority:{} ServiceSpreadingPriority:{}]'
Nu moeten we alleen nog opgeven in de specificatie van onze CronJob dat alle aanvragen voor het plannen van haar pods door onze nieuwe kube-scheduler moeten worden afgehandeld:
...
 jobTemplate:
    spec:
      template:
        spec:
          schedulerName: kube-scheduler-cron
...
Conclusie
Uiteindelijk hebben we een extra kube-scheduler verkregen met een unieke set van planningsregels, waarvan het werk direct door kubelet wordt gecontroleerd. Daarnaast hebben we de verkiezingen van een nieuwe leider tussen de pods van onze kube-scheduler ingesteld voor het geval de oude leider om welke reden dan ook niet meer beschikbaar is.
Reguliere applicaties en services blijven worden gepland via de standaard kube-scheduler, terwijl alle cron-taken volledig zijn overgezet naar een nieuwe scheduler. De belasting die door cron-taken wordt gecreëerd, wordt nu gelijkmatig verdeeld over alle nodes. Aangezien het grootste deel van de cron-taken wordt uitgevoerd op dezelfde nodes als de belangrijkste applicaties van het project, heeft dit het risico op het verplaatsen van pods door resource-tekort aanzienlijk verminderd. Na de implementatie van de extra kube-scheduler zijn er geen problemen meer geweest met ongelijke planning van cron-taken.
Lees ook andere artikelen op onze blog:
Bron: habr.com
