

In dit artikel wordt de implementatie van pijpen in de Unix-kernel beschreven. Ik was een beetje teleurgesteld dat een recent artikel met de titel “” bleek niet over de interne werking te gaan. Ik raakte nieuwsgierig en dook in oude bronnen om een antwoord te vinden.
Waar gaat het over?
Pijpen — “waarschijnlijk de belangrijkste uitvinding in Unix” — zijn een bepalend kenmerk van de onderliggende Unix-filosofie die kleine programma’s samenbrengt, evenals de bekende prompt in de commandoregel:
$ echo hello | wc -c
6
Deze functionaliteit is afhankelijk van de door de kernel geboden systeemaanroep pipe, die wordt beschreven op de pagina’s van de documentatie en :
Pijpen bieden een unidirectioneel kanaal voor inter-process communicatie. Een pijp heeft een ingang (write end) en een uitgang (read end). Gegevens die naar de ingang van de pijp worden geschreven, kunnen bij de uitgang worden gelezen.
Een pijp wordt gemaakt met behulp van de aanroep
pipe(2), die twee bestandsdescriptoren retourneert: één verwijst naar de ingang van de pijp, de tweede naar de uitgang.
De trace-resultaten van de bovenstaande opdracht tonen de creatie van de pijp en de stroom van gegevens erdoor van het ene proces naar het andere:
$ strace -qf -e execve,pipe,dup2,read,write
 sh -c 'echo hello | wc -c'

execve("/bin/sh", ["sh", "-c", "echo hello | wc -c"], …)
pipe([3, 4]) = 0
[pid 2604795] dup2(4, 1) = 1
[pid 2604795] write(1, "hellon", 6) = 6
[pid 2604796] dup2(3, 0) = 0
[pid 2604796] execve("/usr/bin/wc", ["wc", "-c"], …)
[pid 2604796] read(0, "hellon", 16384) = 6
[pid 2604796] write(1, "6n", 2) = 2
Het ouderproces roept pipe(), op om de gekoppelde bestandsdescriptoren te krijgen. Eén kindproces schrijft naar één descriptor, terwijl een ander proces dezelfde gegevens uit een andere descriptor leest. De shell gebruikt dup2 om de descriptoren 3 en 4 “om te benoemen” zodat ze overeenkomen met stdin en stdout.
Zonder pijpen zou de shell de uitvoer van een proces naar een bestand moeten schrijven en deze aan een ander proces moeten doorgeven, zodat deze de gegevens uit het bestand kan lezen. Dit zou ons meer middelen en schijfruimte kosten. Pijpen zijn echter niet alleen goed omdat ze het gebruik van tijdelijke bestanden vermijden:
Als een proces probeert te lezen uit een lege pijp, dan
read(2)zal blokkeren totdat de gegevens beschikbaar zijn. Als een proces probeert te schrijven naar een volle pijp, danwrite(2)blokkeert totdat er voldoende gegevens uit de pijplijn zijn gelezen om de opname uit te voeren.
Net als de POSIX-eis is dit een belangrijke eigenschap: het schrijven naar de pijplijn moet PIPE_BUF bytes (ten minste 512) atomair zijn, zodat processen met elkaar kunnen communiceren via de pijplijn, zoals gewone bestanden (die dergelijke garanties niet bieden) dat niet kunnen.
Bij het gebruik van een gewoon bestand kan een proces al zijn uitvoergegevens erin schrijven en deze aan een ander proces doorgeven. Of processen kunnen in een modus van strikte paralleliteit werken, waarbij ze elkaar met behulp van een extern signaalmechanisme (zoals een semaphore) op de hoogte stellen van de voltooiing van het schrijven of lezen. Pijplijnen besparen ons al deze rompslomp.
Wat zoeken we?
Ik zal het simpel uitleggen, zodat je je kunt voorstellen hoe een pijplijn kan werken. Je moet een buffer in het geheugen toewijzen en een bepaalde status. Je hebt functies nodig voor het toevoegen en verwijderen van gegevens uit de buffer. Er is een middel nodig om functies aan te roepen tijdens het lezen en schrijven naar bestandsdescriptoren. En je hebt vergrendelingen nodig om het hierboven beschreven speciale gedrag te realiseren.
Nu zijn we klaar om het broncode van de kernel onder heldere lampen te ondervragen, om ons vaag mentale model te bevestigen of te ontkrachten. Maar wees altijd voorbereid op verrassingen.
Waar zoeken we?
Ik weet niet waar mijn exemplaar van het beroemde boek "" met de broncode van Unix 6 ligt, maar dankzij kun je online zoeken in de van nog oudere versies van Unix.
Door de archieven van TUHS te verkennen, is vergelijkbaar met een bezoek aan een museum. We kunnen naar onze gezamenlijke geschiedenis kijken, en ik heb respect voor de jarenlange inspanningen om al dit materiaal bit voor bit terug te halen van oude banden en afdrukken. En ik ben me scherp bewust van de fragmenten die nog ontbreken.
Na mijn nieuwsgierigheid over de oude geschiedenis van pijplijnen te hebben bevredigd, kunnen we ter vergelijking naar moderne kernels kijken.
Overigens, pipe is systeemaanroep nummer 42 in de tabel sysent[]. Toeval?
Traditionele Unix-kernels (1970–1974)
Ik heb geen sporen gevonden pipe(2) noch in (januari 1970), noch in (november 1971), noch in de onvolledige broncode (juni 1972).
TUHS beweert dat (februari 1973) was de eerste versie met pijpen:
De derde editie van Unix was de laatste versie met een kernel geschreven in assembler, maar ook de eerste versie met pijpen. In 1973 werd er gewerkt aan het verbeteren van de derde editie, de kernel werd herschreven in C, en zo ontstond de vierde editie van Unix.
Een van de lezers vond een scan van een document waarin Doug McIlroy het idee voorstelde om programma's te verbinden volgens het principe van een tuinslang.
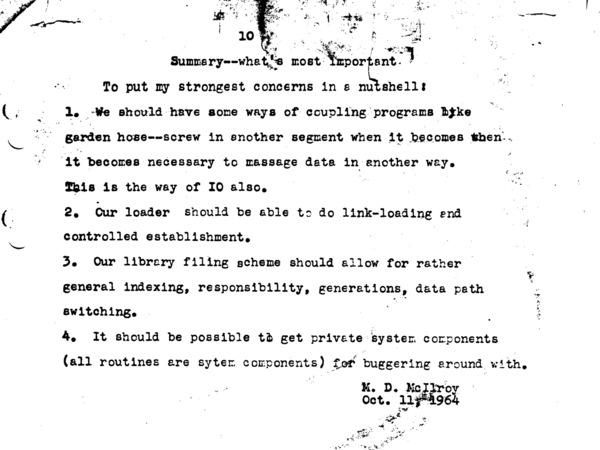
In Brian Kernighan's boek "", wordt ook dit document genoemd in de geschiedenis van het ontstaan van pijpen: "... het hing 30 jaar aan de muur in mijn kantoor bij Bell Labs." Hier is , en nog een verhaal uit :
Toen Unix verscheen, bracht mijn fascinatie voor coroutines me ertoe om de auteur van het besturingssysteem, Ken Thompson, te vragen of gegevens die in een proces werden geschreven, niet alleen naar een apparaat, maar ook naar een andere proces konden gaan. Ken besloot dat dit mogelijk was. Echter, als minimalist wilde hij dat elke systeemfunctie een aanzienlijke rol speelde. Heeft directe invoer tussen processen echt een groot voordeel ten opzichte van invoer naar een tussenbestand? Pas toen ik een concreet voorstel deed met de opvallende naam "pijplijn" en een beschrijving van de syntaxis voor procesinteractie, riep Ken eindelijk: "Ik ga dit doen!".
En hij deed het. Op een fatale avond wijzigde Ken de kernel en de shell, corrigeerde hij enkele standaardprogramma's en standaardiseerde hij hun invoerprocedures (die van een pijplijn kunnen komen), en hij veranderde ook bestandsnamen. De volgende dag werden pijpen alomtegenwoordig in toepassingen. Tegen het einde van de week gebruikten secretaresses ze om documenten van tekstverwerkers naar de printer te sturen. Kort daarna verving Ken de oorspronkelijke API en syntaxis voor het gebruik van pijpen door schonere afspraken, die sindsdien zijn toegepast.
Helaas is de broncode van de kernel van de derde editie van Unix verloren gegaan. En hoewel we de in C geschreven broncode van de die in november 1973 verscheen, kwam deze enkele maanden voor de officiële release uit en bevat deze niet de implementatie van pijpen. Het is jammer dat de broncode van deze legendarische functie van Unix verloren is gegaan, mogelijk voor altijd.
Wij hebben documentatietekst over pipe(2) uit beide releases, dus je kunt beginnen met zoeken in de documentatie (op bepaalde woorden, handmatig onderstreept, een regel van literals ^H, gevolgd door een underscores!). Deze proto-pipe(2) is geschreven in assembler en retourneert slechts één bestandshandle, maar biedt al de verwachte basisfunctionaliteit:
Systeemaanroep pipe creëert een invoer-uitvoermecanisme dat een pijpleiding wordt genoemd. De geretourneerde bestandshandle kan worden gebruikt voor lees- en schrijfoperaties. Wanneer er iets in de pijpleiding wordt geschreven, wordt het gebufferd tot 504 bytes gegevens, waarna het schrijfproces wordt gepauzeerd. Bij het lezen uit de pijpleiding worden de gebufferde gegevens opgehaald.
In het volgende jaar werd de kernel herschreven in C, en kreeg zijn moderne vorm met het prototype "pipe(fildes)»:
Systeemaanroep pipe creëert een invoer-uitvoermecanisme dat een pijpleiding wordt genoemd. De geretourneerde bestandshandles kunnen worden gebruikt in lees- en schrijfoperaties. Wanneer er iets in de pijpleiding wordt geschreven, wordt de handle die in r1 wordt geretourneerd (namelijk fildes[1]) gebruikt en gebufferd totdat 4096 bytes data zijn, waarna het schrijfproces wordt gepauzeerd. Bij het lezen uit de pijpleiding neemt de handle die in r0 wordt geretourneerd (namelijk fildes[0]) de gegevens op.
Het wordt verondersteld dat na het definiëren van de pijpleiding twee (of meer) met elkaar interactierende processen (gemaakt door opvolgende oproepen fork) gegevens uit de pijpleiding zullen doorgeven via aanroepen read en write.
In de shell is er een syntaxis voor het definiëren van een lineaire array van processen die met elkaar zijn gekoppeld via een pijpleiding.
Aanroepen om te lezen uit een lege pijpleiding (zonder gebufferde gegevens), die slechts één eind heeft (alle schrijvende bestandshandles zijn gesloten), retourneren "einde van bestand". Aanroepen om te schrijven in een soortgelijke situatie worden genegeerd.
De vroegste heeft betrekking op (juni 1974), maar deze is bijna identiek aan die welke in de volgende release verscheen. Er zijn alleen opmerkingen toegevoegd, dus de vijfde editie kan worden overgeslagen.
De zesde editie van Unix (1975)
Laten we beginnen met het lezen van de broncode van Unix (mei 1975). Voor een groot deel dankzij Lions is het veel gemakkelijker om het te vinden dan de bronbestanden van eerdere versies:
Jarenlang was het boek Lions het enige document over de kern van Unix dat buiten de muren van Bell Labs beschikbaar was. Hoewel de licentie van de zesde editie docenten toestond de broncode te gebruiken, sloot de licentie van de zevende editie deze mogelijkheid uit, waardoor het boek werd verspreid in de vorm van illegale getypte kopieën.
Vandaag de dag kunt u een herdruk van het boek kopen, waarop studenten bij een kopieerapparaat zijn afgebeeld. En dankzij Warren Toomey (die het TUHS-project startte) kunt u . Ik wil u een idee geven van hoeveel moeite het kostte om het bestand te maken:
Meer dan 15 jaar geleden typte ik een kopie van de broncode die werd gepresenteerd in Lions, omdat ik niet tevreden was met de kwaliteit van mijn kopie van een onbekend aantal andere kopieën. TUHS bestond nog niet, en ik had geen toegang tot oude bronnen. Maar in 1988 vond ik een oude tape met 9 sporen, waarop een back-up van een PDP11-computer stond. Het was moeilijk te zeggen of het werkte, maar er was een intacte boom van /usr/src/, waarin de meeste bestanden waren gemarkeerd met het jaar 1979, wat toen al als antiek aanvoelde. Dit was de zevende editie of een afgeleide PWB, zoals ik dacht.
Ik nam de vondst als basis en bewerkte de bronnen handmatig tot de staat van de zesde editie. Een deel van de code bleef hetzelfde, een deel moest lichtjes worden aangepast, waarbij de moderne token += werd veranderd in de verouderde =+. Iets heb ik gewoon verwijderd, en iets moest volledig opnieuw worden geschreven, maar niet te veel.
En vandaag kunnen we online de broncode van de zesde editie lezen op TUHS uit .
Overigens is de belangrijkste eigenschap van de C-code uit het tijdperk van Kernighan en Ritchie op het eerste gezicht de beknoptheid. Het is niet vaak dat ik codefragmenten kan invoegen zonder uitgebreide bewerking, zodat deze past in het relatief smalle weergavegebied op mijn site.
Aan het begin is er een verklarend commentaar (en ja, er is nog meer) ):
/*
 * Max allowable buffering per pipe.
 * This is also the max size of the
 * file created to implement the pipe.
 * If this size is bigger than 4096,
 * pipes will be implemented in LARG
 * files, which is probably not good.
 */
#define    PIPSIZ    4096
De buffermaat is sinds de vierde editie niet gewijzigd. Maar hier zien we zonder enige publieke documentatie dat ooit pipelines bestanden gebruikten als tijdelijke opslag!
Wat betreft de LARG-bestanden, ze komen overeen met de , die wordt gebruikt door het 'groot adresseringsalgoritme' voor verwerking om grotere bestandssystemen te ondersteunen. Aangezien Ken zei dat het beter is om ze niet te gebruiken, geloof ik hem graag op zijn woord.
Hier is een echte systeemaanroep pipe:
/*
 * The sys-pipe entry.
 * Allocate an inode on the root device.
 * Allocate 2 file structures.
 * Put it all together with flags.
 */
pipe()
{
    register *ip, *rf, *wf;
    int r;

    ip = ialloc(rootdev);
    if(ip == NULL)
        return;
    rf = falloc();
    if(rf == NULL) {
        iput(ip);
        return;
    }
    r = u.u_ar0[R0];
    wf = falloc();
    if(wf == NULL) {
        rf->f_count = 0;
        u.u_ofile[r] = NULL;
        iput(ip);
        return;
    }
    u.u_ar0[R1] = u.u_ar0[R0]; /* wf's fd */
    u.u_ar0[R0] = r;           /* rf's fd */
    wf->f_flag = FWRITE|FPIPE;
    wf->f_inode = ip;
    rf->f_flag = FREAD|FPIPE;
    rf->f_inode = ip;
    ip->i_count = 2;
    ip->i_flag = IACC|IUPD;
    ip->i_mode = IALLOC;
}
In de opmerking staat duidelijk beschreven wat hier gebeurt. Maar het is niet zo eenvoudig om de code te begrijpen, deels vanwege de manier waarop met behulp van '' en registers R0 en R1 parameters van systeemaanroepen en retourwaarden worden doorgegeven.
Laten we proberen met behulp van op de schijf te plaatsen , en met behulp van in het geheugen twee . Als alles goed gaat, geven we de vlaggen op voor het definiëren van deze bestanden als de twee uiteinden van de pijplijn, we wijzen ze toe in dezelfde inode (wiens referentieteller 2 zal worden), en markeren de inode als gewijzigd en in gebruik. Let op de aanroepen naar in foutpaden om de referentieteller in de nieuwe inode te verlagen.
pipe() moet via R0 en R1 bestanden- en schrijfnummers voor lezen en schrijven teruggeven. falloc() geeft een pointer naar een bestandsstructuur terug, maar 'geeft' ook terug via u.u_ar0[R0] en de bestandsdescriptor. Dat wil zeggen, de code slaat op , die de eerste regel van het verzoek, de headers en de gegevens scheidt. de bestandsdescriptor voor lezen en wijst de descriptor voor schrijven rechtstreeks toe vanaf u.u_ar0[R0] na de tweede aanroep falloc().
Vlag FPIPE, die we hebben ingesteld bij het maken van de pijplijn, beheert het gedrag van de functie , die specifieke invoer-/uitvoer subroutines aanroept:
/*
 * common code for read and write calls:
 * check permissions, set base, count, and offset,
 * and switch out to readi, writei, or pipe code.
 */
rdwr(mode)
{
    register *fp, m;

    m = mode;
    fp = getf(u.u_ar0[R0]);
        /* … */

    if(fp->f_flag&FPIPE) {
        if(m==FREAD)
            readp(fp); else
            writep(fp);
    }
        /* … */
}
Daarna leest de functie readp() in pipe.c gegevens uit de pijplijn. Maar het is beter om de implementatie te volgen vanaf writep(). Terugkomend op het punt, de code is ingewikkelder geworden door de details van de argumentoverdracht, maar sommige details kunnen worden weggelaten.
writep(fp)
{
    register *rp, *ip, c;

    rp = fp;
    ip = rp->f_inode;
    c = u.u_count;

loop:
    	/* Als alles gedaan is, retourneer. */

    plock(ip);
    als(c == 0) {
        prele(ip);
        u.u_count = 0;
        return;
    }

    	/*
     * Als er niet beide lees- en schrijfzijden van de
     * pijplijn actief zijn, retourneer een fout en geef ook een signaal.
     * /

    als(ip->i_count < 2) {
        prele(ip);
        u.u_error = EPIPE;
        psignal(u.u_procp, SIGPIPE);
        return;
    }

    	/*
     * Als de pijplijn vol is, wacht op lezingen om te legen
en verklein het.
     * /

    als(ip->i_size1 == PIPSIZ) {
        ip->i_mode =| IWRITE;
        prele(ip);
        slaap(ip+1, PPIPE);
        ga naar loop;
    }

    	/* Schrijf wat mogelijk is en ga terug. */

    u.u_offset[0] = 0;
    u.u_offset[1] = ip->i_size1;
    u.u_count = min(c, PIPSIZ-u.u_offset[1]);
    c =- u.u_count;
    writei(ip);
    prele(ip);
    als(ip->i_mode&IREAD) {
        ip->i_mode =& ~IREAD;
        wakker(ip+2);
    }
    ga naar loop;
}
We willen bytes naar de invoer van de pijplijn schrijven u.u_count. Eerst moeten we de indexdescriptor blokkeren (zie hieronder plock/prele).
Vervolgens controleren we de inode linkerteller. Zolang beide uiteinden van de pijplijn open blijven, moet de teller gelijk zijn aan 2. We houden één link vast (uit rp->f_inode), zodat als de teller minder dan 2 is, dit betekent dat het lezende proces zijn uiteinde van de pijplijn heeft gesloten. Met andere woorden, we proberen te schrijven naar een gesloten pijplijn, wat een fout is. De foutcode EPIPE en het signaal SIGPIPE verschenen in de zesde editie van Unix.
Maar zelfs als de pijplijn open is, kan deze vol zijn. In dit geval ontgrendelen we en gaan we slapen in de hoop dat een ander proces uit de pijplijn leest en voldoende ruimte vrijmaakt. Na het wakker worden, keren we terug naar het begin, blokkeren opnieuw en starten een nieuwe schrijfronde.
Als er genoeg vrije ruimte in de pijplijn is, schrijven we gegevens naar de pijplijn met behulp van . De parameter i_size1 van de inode (bij een lege pijplijn kan dit 0 zijn) geeft het einde aan van de gegevens die al in de pijplijn zijn opgeslagen. Als er voldoende ruimte is om te schrijven, kunnen we de pijplijn vullen van i_size1 tot PIPESIZ. Daarna ontgrendelen we en proberen we elk proces te wekken dat wacht op de mogelijkheid om uit de pijplijn te lezen. We keren terug naar het begin om te zien of we zoveel bytes hebben kunnen schrijven als we nodig hadden. Als dat niet zo is, beginnen we een nieuwe schrijfronde.
Gewoonlijk wordt de parameter i_mode van de inode gebruikt om permissies op te slaan. , die de eerste regel van het verzoek, de headers en de gegevens scheidt., w en x. Maar in het geval van pijplijnen signaleren we dat een proces wacht op schrijven of lezen met behulp van de bits IREAD en IWRITE respectievelijk. Het proces stelt een vlag in en roept sleep(), en het is de verwachting dat in de toekomst een ander proces wakeup().
zal aanroepen. Het echte magie gebeurt in sleep() en wakeup(). Ze zijn geïmplementeerd in , de bron van de beroemde opmerking "U wordt niet verwacht dit te begrijpen" (You are not expected to understand this). Gelukkig hoeven we de code niet te begrijpen, we bekijken gewoon enkele opmerkingen:
/*
 * Give up the processor till a wakeup occurs
 * on chan, at which time the process
 * enters the scheduling queue at priority pri.
 * The most important effect of pri is that when
 * pri<0 a signal cannot disturb the sleep;
 * if pri>=0 signals will be processed.
 * Callers of this routine must be prepared for
 * premature return, and check that the reason for
 * sleeping has gone away.
 */
sleep(chan, pri) /* … */

/*
 * Wake up all processes sleeping on chan.
 */
wakeup(chan) /* … */
Een proces dat sleep() aanroept voor een bepaald kanaal, kan later worden wakker gemaakt door een ander proces dat aanroept wakeup() voor hetzelfde kanaal. writep() en readp() coördineren hun acties door middel van dergelijke paarse aanroepen. Merk op dat pipe.c altijd prioriteit geeft aan PPIPE bij de oproep, dus alle sleep()kunnen worden onderbroken door een signaal. sleep() kunnen worden onderbroken door een signaal.
Nu hebben we alles om de functie te begrijpen readp():
readp(fp)
int *fp;
{
    register *rp, *ip;

    rp = fp;
    ip = rp->f_inode;

loop:
    /* Zeer conservatieve blokkering. */

    plock(ip);

    /*
     * Als het hoofd (lezen) gelijk is aan
     * de staart (schrijven), reset dan beide naar 0.
     * /

    if(rp->f_offset[1] == ip->i_size1) {
        if(rp->f_offset[1] != 0) {
            rp->f_offset[1] = 0;
            ip->i_size1 = 0;
            if(ip->i_mode&IWRITE) {
                ip->i_mode =& ~IWRITE;
                wakeup(ip+1);
            }
        }

        /*
         * Als niet zowel de lezer als
         * de schrijver actief zijn, keer dan terug zonder
         * lezen te vervullen.
         * /

        prele(ip);
        if(ip->i_count i_mode =| IREAD;
        sleep(ip+2, PPIPE);
        goto loop;
    }

    /* Lees en retourneer */

    u.u_offset[0] = 0;
    u.u_offset[1] = rp->f_offset[1];
    readi(ip);
    rp->f_offset[1] = u.u_offset[1];
    prele(ip);
}
Misschien is het makkelijker om deze functie van onder naar boven te lezen. De tak "read and return" wordt meestal gebruikt als er gegevens in de pipeline zijn. In dit geval gebruiken we om zoveel gegevens te lezen als beschikbaar is vanaf de huidige f_offset van lezen en vervolgens de waarde van de overeenkomstige offset bij te werken.
Bij een volgend lezen zal de pipeline leeg zijn als de leesoffset de waarde van i_size1 de inode heeft bereikt. We resetten de positie naar 0 en proberen elk proces te wekken dat in de pipeline wil schrijven. We weten dat wanneer de pipeline vol is, writep() het slaapt op ip+1. En nu, als de pipeline leeg is, kunnen we hem wekken zodat hij zijn schrijfcyclus kan hervatten.
Als er niets te lezen is, kan readp() een vlag instellen IREAD en slapen op ip+2. We weten dat hij gewekt zal worden writep(), wanneer hij gegevens in de pipeline schrijft.
De opmerkingen over helpen te begrijpen dat we in plaats van parameters door te geven via "u" we ermee kunnen omgaan als gewone invoer/uitvoer functies die een bestand, positie, geheugenbuffer aannemen en het aantal bytes voor lezen of schrijven tellen.
/*
 * Read the file corresponding to
 * the inode pointed at by the argument.
 * The actual read arguments are found
 * in the variables:
 *    u_base        core address for destination
 *    u_offset    byte offset in file
 *    u_count        number of bytes to read
 *    u_segflg    read to kernel/user
 */
readi(aip)
struct inode *aip;
/* … */

/*
 * Write the file corresponding to
 * the inode pointed at by the argument.
 * The actual write arguments are found
 * in the variables:
 *    u_base        core address for source
 *    u_offset    byte offset in file
 *    u_count        number of bytes to write
 *    u_segflg    write to kernel/user
 */
writei(aip)
struct inode *aip;
/* … */
Wat betreft de "conservatieve" blokkering, readp() en writep() wordt de inode geblokkeerd totdat ze klaar zijn of een resultaat krijgen (dat wil zeggen, we het aanroepen van wakeup). plock() en prele() werken gewoon: met behulp van een andere set aanroepen sleep en wakeup kunnen we elk proces wakker maken dat de blokkering nodig heeft die we net hebben opgeheven:
/*
 * Lock a pipe.
 * If its already locked, set the WANT bit and sleep.
 */
plock(ip)
int *ip;
{
    register *rp;

    rp = ip;
    while(rp->i_flag&ILOCK) {
        rp->i_flag =| IWANT;
        sleep(rp, PPIPE);
    }
    rp->i_flag =| ILOCK;
}

/*
 * Unlock a pipe.
 * If WANT bit is on, wakeup.
 * This routine is also used to unlock inodes in general.
 */
prele(ip)
int *ip;
{
    register *rp;

    rp = ip;
    rp->i_flag =& ~ILOCK;
    if(rp->i_flag&IWANT) {
        rp->i_flag =& ~IWANT;
        wakeup(rp);
    }
}
In het begin kon ik niet begrijpen waarom readp() niet aanroept prele(ip) tot het aanroepen van wakeup(ip+1). Het eerste datroept in zijn lus, is writep() plock(ip) , wat leidt tot een deadlock, alsnog niet zijn blokkering heeft opgeheven, dus de code moet op de een of andere manier correct werken. Als je kijkt naar readp() nog niet zijn blokkade heeft opgeheven, moet de code op de een of andere manier correct werken. Als we kijken naar wakeup(), dan het wordt duidelijk dat het alleen de slapende taak markeert als klaar om uitgevoerd te worden, voor de toekomst sched() werd daadwerkelijk gestart. Dus readp() roept aan wakeup(), haalt de blokkade op, stelt in IREAD en roept aan sleep(ip+2)— dit alles voordat writep() de cyclus opnieuw begint.
Hier eindigt de beschrijving van pijpen in de zesde editie. Eenvoudige code, verstrekkende gevolgen.
(januari 1979) was een nieuwe belangrijke release (vier jaar later), waarin veel nieuwe applicaties en eigenschappen van de kernel verschenen. Ook waren er aanzienlijke wijzigingen in verband met typecasting, unies en getypeerde pointers naar structuren. Echter veranderde praktisch niet. We kunnen deze editie overslaan.
Xv6, een eenvoudige Unix-achtige kernel
De creatie van de kernel werd beïnvloed door de zesde editie van Unix, maar het is geschreven in modern C, zodat het draait op x86-processors. De code is gemakkelijk te lezen, hij is begrijpelijk. Bovendien, in tegenstelling tot de Unix-bronnen van TUHS, kun je het compileren, aanpassen en draaien op iets anders dan de PDP 11/70. Daarom wordt deze kernel veel gebruikt in hoger onderwijs als leermateriaal in besturingssystemen. De bronnen .
De code bevat een duidelijke en doordachte implementatie , ondersteund door een buffer in het geheugen in plaats van een inode op de schijf. Hier geef ik alleen de definitie van een 'structurele pijp' en de functie pipealloc():
#define PIPESIZE 512

struct pipe {
  struct spinlock lock;
  char data[PIPESIZE];
  uint nread;     // number of bytes read
  uint nwrite;    // number of bytes written
  int readopen;   // read fd is still open
  int writeopen;  // write fd is still open
};

int
pipealloc(struct file **f0, struct file **f1)
{
  struct pipe *p;

  p = 0;
  *f0 = *f1 = 0;
  if((*f0 = filealloc()) == 0 || (*f1 = filealloc()) == 0)
    goto bad;
  if((p = (struct pipe*)kalloc()) == 0)
    goto bad;
  p->readopen = 1;
  p->writeopen = 1;
  p->nwrite = 0;
  p->nread = 0;
  initlock(&p->lock, "pipe");
  (*f0)->type = FD_PIPE;
  (*f0)->readable = 1;
  (*f0)->writable = 0;
  (*f0)->pipe = p;
  (*f1)->type = FD_PIPE;
  (*f1)->readable = 0;
  (*f1)->writable = 1;
  (*f1)->pipe = p;
  return 0;

 bad:
  if(p)
    kfree((char*)p);
  if(*f0)
    fileclose(*f0);
  if(*f1)
    fileclose(*f1);
  return -1;
}
pipealloc() stelt de toestand in voor de rest van de implementatie, die de functies omvat piperead(), pipewrite() en pipeclose(). De feitelijke systeemaanroep sys_pipe is een wrapper, geïmplementeerd in . Ik raad aan om de gehele code ervan te lezen. De complexiteit is op het niveau van de bronnen van de zesde editie, maar het is veel gemakkelijker en aangenamer om te lezen.
Linux 0.01
Je kunt de broncode van Linux 0.01 vinden. Het zal leerzaam zijn om de implementatie van pijpen daarin te bestuderen fs/pipe.c. Hier wordt een inode gebruikt om de pijp weer te geven, maar de pijp zelf is geschreven in modern C. Als je door de code van de zesde editie bent gekomen, zul je hier geen moeilijkheden ondervinden. Dit is hoe de functie write_pipe():
int write_pipe(struct m_inode * inode, char * buf, int count)
{
    char * b=buf;

    wake_up(&inode->i_wait);
    if (inode->i_count != 2) { /* geen lezers */
        current->signal |= (1< 0) {
        while (PIPE_FULL(*inode)) {
            wake_up(&inode->i_wait);
            if (inode->i_count != 2) {
                current->signal |= (1<i_wait);
        }
        ((char *)inode->i_size)[PIPE_HEAD(*inode)] =
            get_fs_byte(b++);
        INC_PIPE( PIPE_HEAD(*inode) );
        wake_up(&inode->i_wait);
    }
    wake_up(&inode->i_wait);
    return b-buf;
}
Zelfs zonder naar de structuren te kijken, kan men begrijpen hoe de link-teller van inode wordt gebruikt om te controleren of een schrijfoperatie leidt tot SIGPIPE. Naast bytegewijze verwerking kan deze functie eenvoudig worden vergeleken met de bovengenoemde ideeën. Zelfs de logica sleep_on/wake_up ziet er niet zo vreemd uit.
Moderne Linux-kernels, FreeBSD, NetBSD, OpenBSD
Ik heb snel enkele moderne kernels doorgenomen. Geen van hen heeft al een implementatie met diskgebruik (geen verrassing). Linux heeft zijn eigen implementatie. En hoewel de drie moderne BSD-kernels implementaties bevatten op basis van code die door John Dyson is geschreven, zijn ze in de loop der jaren te veel van elkaar gaan verschillen.
Om te lezen fs/pipe.c (op Linux) of sys/kern/sys_pipe.c (op *BSD), vergt echte toewijding. Vandaag de dag zijn prestaties en ondersteuning voor functies zoals vector- en asynchrone invoer/uitvoer cruciaal in de code. De details over geheugentoewijzing, vergrendelingen en kernelconfiguratie verschillen sterk. Dit is niet wat hogescholen nodig hebben voor een inleidende cursus in besturingssystemen.
Hoe dan ook, ik was nieuwsgierig om enkele oude patronen op te diepen (bijv. genereren SIGPIPE en retourneren EPIPE bij schrijven naar een gesloten pijp) in al deze, zo verschillende, moderne kernels. Waarschijnlijk zal ik nooit in het echt een PDP-11-computer zien, maar er is nog steeds veel te leren van de code die jaren voor mijn geboorte is geschreven.
Het artikel "" geschreven door Divi Kapoor in 2011 biedt een overzicht van hoe (tot nu toe) pijpen in Linux werken. En illustreert het pijpenmodel van interactie, wiens mogelijkheden de mogelijkheden van tijdelijke bestanden overstijgen; en toont aan hoe ver pijpen zijn geëvolueerd van de "zeer conservatieve vergrendeling" in de Unix-kernel van de zesde editie.
Bron: habr.com
