

In het rapport worden enkele benaderingen gepresenteerd die het mogelijk maken om de prestaties van SQL-query's te volgen, wanneer er dagelijks miljoenen zijn, terwijl het gecontroleerde aantal PostgreSQL-servers in de honderden ligt.
Welke technische oplossingen stellen ons in staat om deze grote hoeveelheid informatie efficiënt te verwerken, en hoe vergemakkelijkt dit het leven van de gewone ontwikkelaar.
Wie heeft interesse in de analyse van specifieke problemen en verschillende optimalisatietechnieken van SQL-query's en het oplossen van typische DBA-taken in PostgreSQL - je kunt ook over dit onderwerp.
Mijn naam is Kirill Borovikov, ik vertegenwoordig . Concreet specialiseer ik me in het werken met databases binnen ons bedrijf.
Vandaag zal ik jullie vertellen hoe we query-optimalisatie aanpakken, wanneer je niet de prestaties van slechts één enkele query hoeft te 'doorboren', maar het probleem massaal moet oplossen. Wanneer er miljoenen query's zijn, en je moet enkele benaderingen voor het oplossen van dit grote probleem vinden.
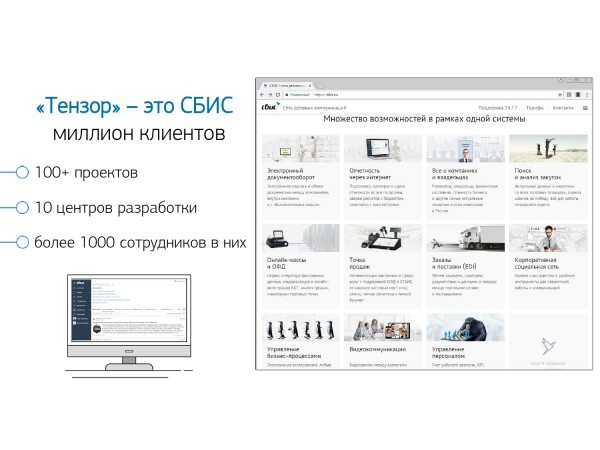
In feite is 'Tensor' voor miljoenen van onze klanten : een corporatief sociaal netwerk, oplossingen voor videocommunicatie, voor interne en externe documentstromen, boekhoudsystemen en magazijnbeheer,... Dus zo'n 'mega-combine' voor de integrale bedrijfsmanagement, waarin meer dan 100 verschillende interne projecten zitten.
Om ervoor te zorgen dat al deze projecten goed functioneren en zich ontwikkelen - hebben we 10 ontwikkelcentra in het land, met meer dan 1000 ontwikkelaars.
We werken sinds 2008 met PostgreSQL en hebben een grote hoeveelheid verwerkte data verzameld - dit zijn klantgegevens, statistische, analytische gegevens, informatie uit externe informatiesystemen - meer dan 400TB.Alleen al in productie hebben we ongeveer 250 servers, en in totaal monitoren we ongeveer 1000 DB-servers.
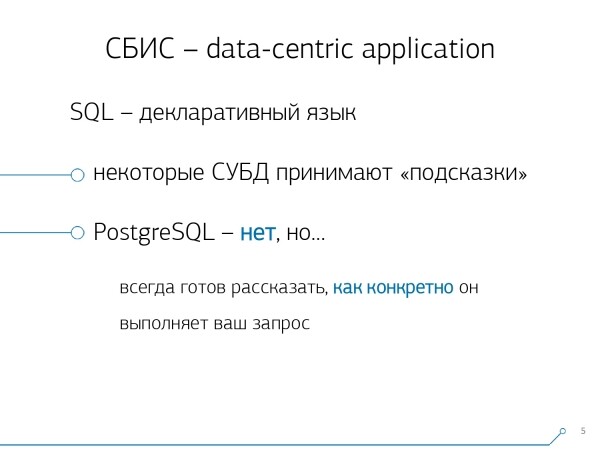
SQL is een declaratieve taal. Je beschrijft niet 'hoe' iets moet werken, maar 'wat' je wilt ontvangen. De DBMS weet beter hoe je een JOIN moet maken - hoe je tabellen met elkaar verbindt, welke voorwaarden je moet opleggen, wat door de index gaat, wat niet...
Sommige DBMS'en accepteren hints: 'Nee, verbind deze twee tabellen in deze volgorde', maar PostgreSQL kan dat niet. Dit is een bewuste positie van de hoofdontwikkelaars: 'Het is beter dat we de query-optimalisator verbeteren dan dat we ontwikkelaars laten gebruikmaken van bepaalde hints.'
Maar ondanks het feit dat PostgreSQL geen externe controle biedt, stelt het je uitstekend in staat om te zien wat er 'van binnen' gebeurt, wanneer je je verzoek uitvoert en waar de problemen zich voordoen.
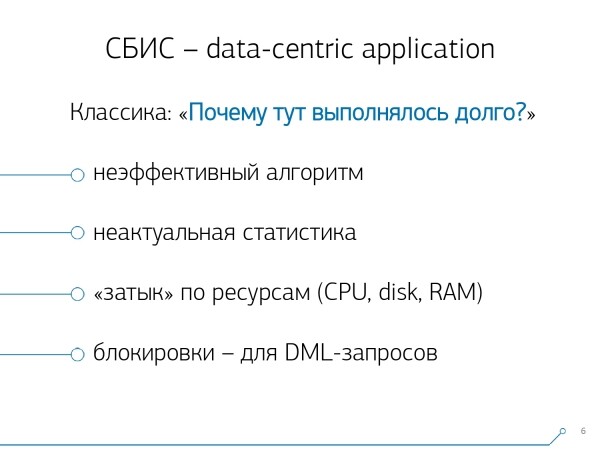
Met welke klassieke problemen komt een ontwikkelaar [bij DBA] doorgaans? 'Kijk, we hebben hier een verzoek uitgevoerd en het is allemaal traag, alles hangt, er gebeurt iets... Wat een ramp!'De oorzaken zijn vrijwel altijd dezelfde:
een inefficiënt query-algoritme
- Ontwikkelaar: 'Ik heb momenteel in SQL 10 tabellen via JOIN... en verwacht dat mijn voorwaarden op wonderbaarlijke wijze efficiënt worden "ontknoopt", en dat ik alles snel krijg. Maar wonderen komen niet voor, en elk systeem geeft bij zo'n variabiliteit (10 tabellen in één FROM) altijd enige onnauwkeurigheid. [
Het is bijzonder relevant voor PostgreSQL, wanneer je een grote dataset naar de server hebt 'gegoten', je een verzoek doet — en het doet een 'seqscan' over de tabel. Omdat er gister 10 records in stonden, en vandaag 10 miljoen, maar PostgreSQL is daar nog niet van op de hoogte, en je moet het daarover informeren. [] - verouderde statistieken
Je hebt een grote en zware database op een zwakke server ingesteld, met onvoldoende schijfruimte, geheugen, en de capaciteit van de processor. En dat is het... Er is ergens een prestatiedrempel waarboven je niet meer kunt gaan.] - „knelpunten” in de middelen
Een complex punt, maar het is vooral relevant voor verschillende modificerende queries (INSERT, UPDATE, DELETE) — dit is een apart en groot onderwerp. - blokkering
Het verkrijgen van een plan
… En voor de rest hebben we
een plan ! We moeten zien wat er binnen de server gebeurt.Het uitvoeringsplan voor een verzoek in PostgreSQL is een boomstructuur van het algoritme dat de uitvoering van het verzoek in tekstvorm weergeeft. Dat is het algoritme dat na analyse door de planner als het meest efficiënt is beschouwd.
Elke knoop in de boom is een operatie: het extraheren van gegevens uit een tabel of index, het bouwen van een bitarray, het koppelen van twee tabellen, samenvoegen, snijden of uitsluiten van datasets. De uitvoering van het verzoek is een doorgang door de knopen van deze boom.
Om een verzoekplan te verkrijgen, is de eenvoudigste manier om de operator uit te voeren
EXPLAIN . Om het met alle werkelijke attributen te krijgen, dat wil zeggen daadwerkelijk het verzoek op de database uit te voeren —EXPLAIN (ANALYZE, BUFFERS) SELECT ... VERKLAAR (ANALYSEREN, BUFFEREN) SELECT ....
Een slecht moment: wanneer je het uitvoert, gebeurt dat 'hier en nu', dus is het alleen geschikt voor lokale debugging. Maar als je een zwaar belaste server hebt die onder een sterke stroom van gegevenswijzigingen staat, en je ziet: 'Au! Hier voerde het langzaam uit.Er is een verzoek.' Een half uur, een uur geleden - terwijl je rondliep en dat verzoek uit de logs haalde, weer naar de server bracht, was je hele dataset en statistiek veranderd. Je voert het uit om te debuggen - en het voert snel uit! En je kunt niet begrijpen 'waarom', waarom hebben het langzaam is.
Om te begrijpen wat er precies op dat moment gebeurde toen het verzoek op de server werd uitgevoerd, hebben slimme mensen geschreven . Deze is aanwezig in vrijwel alle meest voorkomende distributies van PostgreSQL en kan eenvoudig worden geactiveerd in het configuratiebestand.
Als het begrijpt dat een verzoek langer duurt dan de grens die je hebt ingesteld, maakt het een 'snapshot' van het plan van dat verzoek en schrijft het samen in de log.
Het lijkt nu allemaal goed, we gaan naar de log en zien daar… [lange tekst]. Maar we kunnen er niets over zeggen, behalve dat het een uitstekend plan is, omdat het 11 ms uitvoerde.
Het lijkt allemaal goed - maar het is onduidelijk wat er daadwerkelijk gebeurde. Behalve de totale tijd zien we niet veel meer. Want het bekijken van zo'n 'lap tekst' in gewone tekst is helemaal niet inzichtelijk.
Maar zelfs al is het niet inzichtelijk, al is het onhandig, er zijn meer fundamentele problemen:
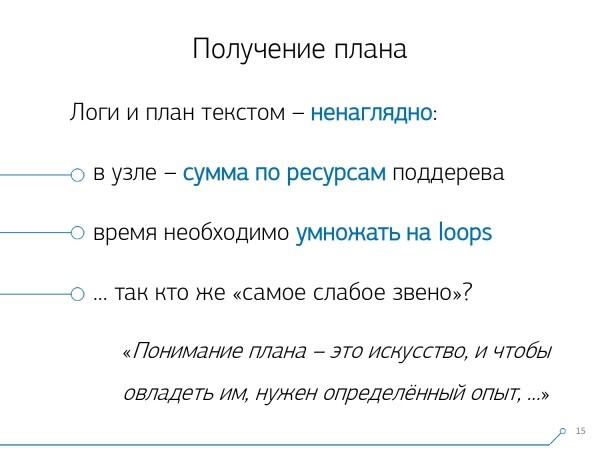
- In de knoop wordt vermeld het totaal aan middelen van het hele subtree eronder. Dat wil zeggen, om gewoon te weten hoeveel daar specifiek bij deze Index Scan aan tijd is besteed - dat kan niet, als er een genestede voorwaarde onder zit. We moeten dynamisch kijken of er 'kinderen' en voorwaardelijke variabelen zijn, CTE - en dat allemaal 'in gedachten' aftrekken.
- Een tweede punt: de tijd die op de knoop wordt aangegeven, is de tijd van één enkele uitvoering van de knoop.Als deze knoop bijvoorbeeld als gevolg van een loop door de records van de tabel meerdere keren werd uitgevoerd, vergroot de hoeveelheid loops - de cycli van deze knoop - in het plan. Maar de tijd van atomische uitvoering blijft in het plan hetzelfde. Dat wil zeggen, om te begrijpen, hoeveel die knoop in totaal is uitgevoerd, moet je het een met het ander vermenigvuldigen - opnieuw 'in gedachten'.
Bij deze omstandigheden is het praktisch onmogelijk om te begrijpen 'Wie is de zwakste schakel?'. Daarom schrijven zelfs de ontwikkelaars in de 'handleiding' dat ‘Het begrijpen van het plan is een kunst die je moet leren, een ervaring…’.
Maar we hebben 1000 ontwikkelaars, en aan ieder van hen kun je deze ervaring niet in hun hoofd overdragen. Ik, jij, hij — weten het, maar iemand daar — weet het al niet. Misschien leert hij het, misschien ook niet, maar hij moet nu al aan de slag — waar vandaan moet hij die ervaring dan halen?
Visualisatie van het plan
Daarom hebben we begrepen — om met deze problemen om te gaan, hebben we een goede visualisatie van het plan.
We zijn eerst 'op de markt' gegaan — laten we op internet kijken wat er überhaupt bestaat.
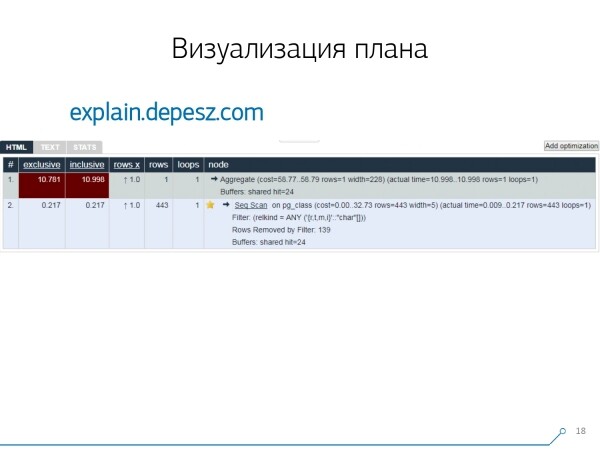
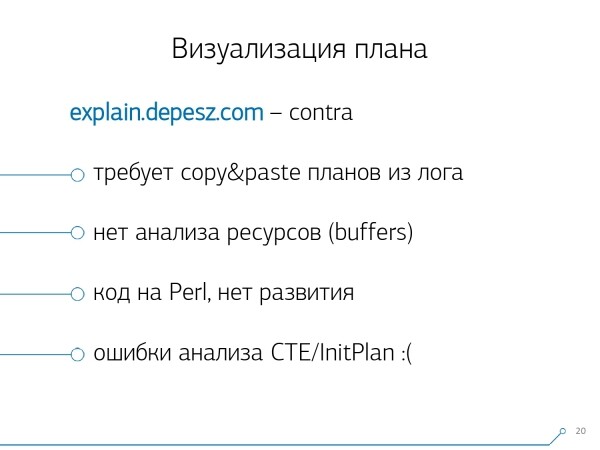
Maar, bleek, dat er relatief weinig 'live' oplossingen zijn, die zich meer of minder ontwikkelen — letterlijk, één: van Hubert Lubaczewski. In het invoerveld 'voer' je de tekstuele representatie van het plan in, en het laat je een tabel zien met de ontlede gegevens:
- eigen tijd van het verwerken van de knoop
- totaal tijd binnen de gehele subboom
- aantal records dat is opgehaald, en dat statistisch werd verwacht
- de eigenlijke inhoud van de knoop
Deze service heeft ook de mogelijkheid om een archief van links te delen. Je hebt je plan daarheen gestuurd en zegt: 'Hé, Vasya, hier is een link, daar klopt iets niet'.
Maar er zijn ook een paar kleine problemen.
Ten eerste, een enorme hoeveelheid 'copy-paste'. Je neemt een stuk van een log, steekt het daarin, en opnieuw, en opnieuw.
Ten tweede, er is geen analyse van het aantal gelezen gegevens — die buffers, die weergegeven worden door EXPLAIN (ANALYZE, BUFFERS), hier zien we niets. Hij kan ze gewoon niet ontleden, begrijpen en ermee werken. Wanneer je veel gegevens leest en beseft dat je misschien niet goed 'uitgelijnd' bent op de schijf en in het geheugen, is deze informatie heel belangrijk.
Het derde negatieve punt is de zeer beperkte ontwikkeling van dit project. Commits zijn heel klein, goed als eens in de zes maanden, en de code is in Perl.
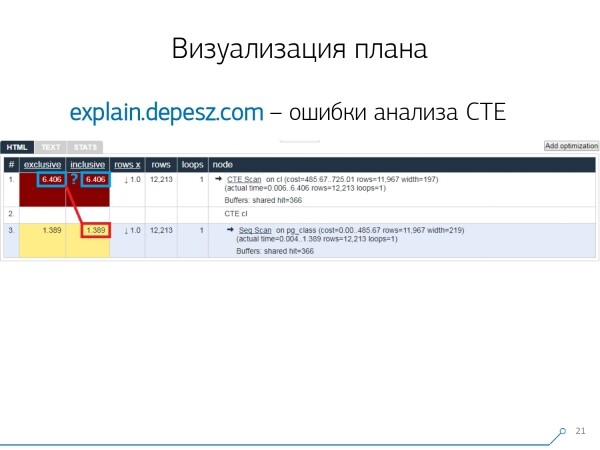
Maar dit is allemaal 'lyriek', hiermee konden we op de een of andere manier omgaan, maar er is één ding dat ons sterk van deze service heeft afgeschrikt. Dit zijn de fouten in de analyse van Common Table Expression (CTE) en verschillende dynamische knopen zoals InitPlan/SubPlan.
Als we deze afbeelding mogen geloven, dan is de totale uitvoeringstijd van elke afzonderlijke knoop groter dan de totale uitvoeringstijd van de gehele aanvraag. Het is simpel — de tijdsduur van de CTE Scan knoop is niet afgetrokken van de tijd voor het genereren van deze CTEDaarom weten we al niet meer wat het juiste antwoord is, hoe lang de CTE-scan heeft geduurd.
Hier begrepen we dat het tijd was om onze eigen oplossing te schrijven — hoera! Elke ontwikkelaar zegt: "Nu gaan we zelf iets schrijven, het wordt super eenvoudig!"
We hebben een typische stack voor webservices genomen: de core op Node.js + Express, een Bootstrap-sjabloon en voor mooie diagrammen — D3.js. En onze verwachtingen zijn volledig uitgekomen — we kregen de eerste prototype in 2 weken:
- een eigen parser voor plannen
Dus nu kunnen we in principe elk plan analyseren dat door PostgreSQL wordt gegenereerd. - correcte analyse van dynamische knooppunten — CTE Scan, InitPlan, SubPlan
- analyse van de bufferspreiding — waar databestanden uit het geheugen worden gelezen, waar uit de lokale cache, en waar van de schijf
- we kregen duidelijkheid
Zodat we niet die hele ‘boel’ in de log hoeven te ‘graven’, maar meteen het ‘zwakste punt’ op de afbeelding kunnen zien.
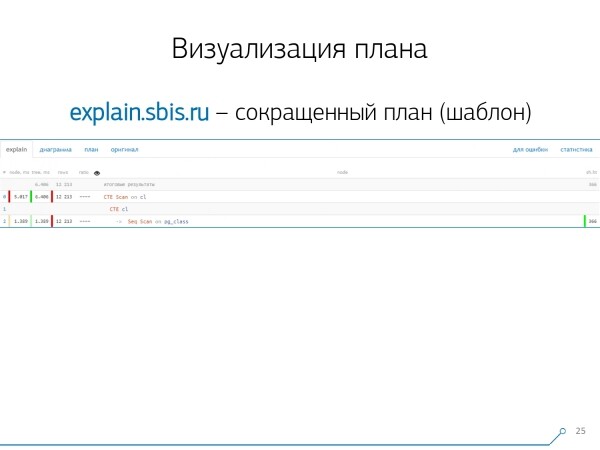
We kregen ongeveer zo’n afbeelding — meteen met syntaxismarkering. Maar meestal werken onze ontwikkelaars al niet meer met de volledige planweergave, maar met een kortere versie. We hebben al die cijfers ontleed en naar links en rechts afgevoerd, en in het midden hebben we alleen de eerste regel laten staan, wat voor knooppunt het is: CTE Scan, CTE-generatie of Seq Scan van een bepaalde tabel.
Deze verkorte weergave noemen we een sjabloon voor plannen.
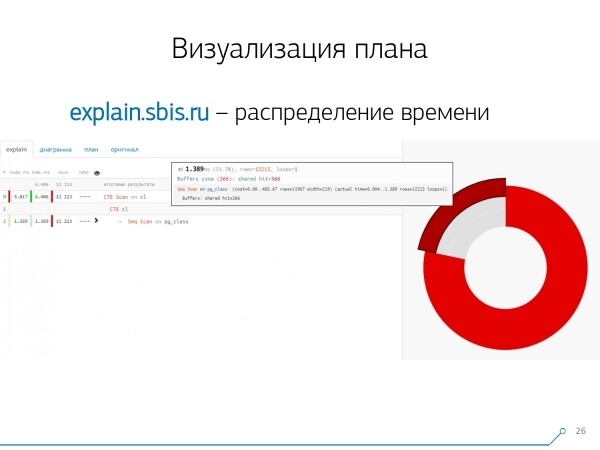
Wat zou nog handig zijn? Het zou handig zijn om te zien welk percentage van de totale tijd aan elk knooppunt is toegewezen — en we plakken het gewoon aan de zijkant taartdiagram.
We wijzen naar een knooppunt en zien — blijkbaar heeft de Seq Scan minder dan een kwart van de totale tijd in beslag genomen, terwijl de overige 3/4 door de CTE Scan werd gebruikt. Verschrikkelijk! Dit is een kleine opmerking over de ‘snelheid’ van CTE Scan, als je ze actief in je verzoeken gebruikt. Ze zijn niet heel snel — ze verliezen zelfs van reguliere tabelscans.
Maar meestal zijn dergelijke diagrammen interessanter en complexer, wanneer we meteen op een segment wijzen en zien dat een Seq Scan meer dan de helft van de totale tijd ‘opgegeten’ heeft. Er was ook nog een filter binnenin, waarmee een hoop records zijn afgewezen… Je kunt deze afbeelding meteen naar de ontwikkelaar sturen en zeggen: ‘Vasya, het gaat hier echt helemaal verkeerd! Kijk er eens naar, er klopt iets niet!’
Natuurlijk zijn we niet zonder ‘stronken’ gekomen.
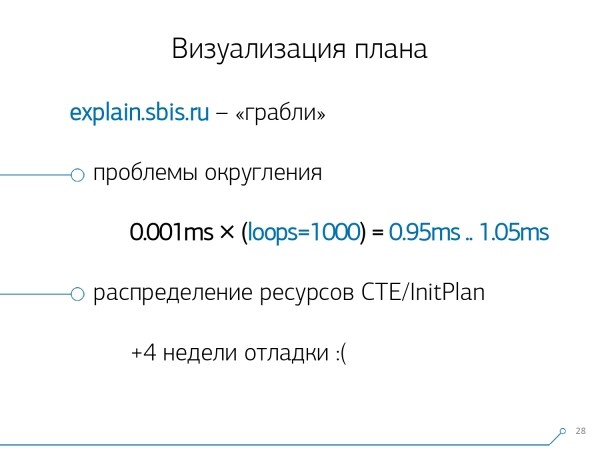
Het eerste probleem waar we tegenaan liepen, was de afronding. De tijd van elke aparte knoop in het plan wordt opgegeven met een nauwkeurigheid van 1µs. En wanneer het aantal knooppuntcycli, bijvoorbeeld, 1000 overschrijdt - na uitvoering heeft PostgreSQL de 'nauwkeurigheid tot' gedeeld, dan krijgen we bij de omgekeerde berekening een totale tijd 'ergens tussen 0,95 ms en 1,05 ms'. Wanneer het om microseconden gaat, valt het nog mee, maar wanneer het al in [milli]seconden is, moeten we deze informatie bij het 'ontknopen' van de middelen per plan knoop 'wie wat heeft verbruikt' meenemen.
Het tweede, meer complexe punt, is de verdeling van middelen (deze buffers) over dynamische knopen. Dit kostte ons in de eerste 2 weken met de prototype nog eens 4 weken extra.
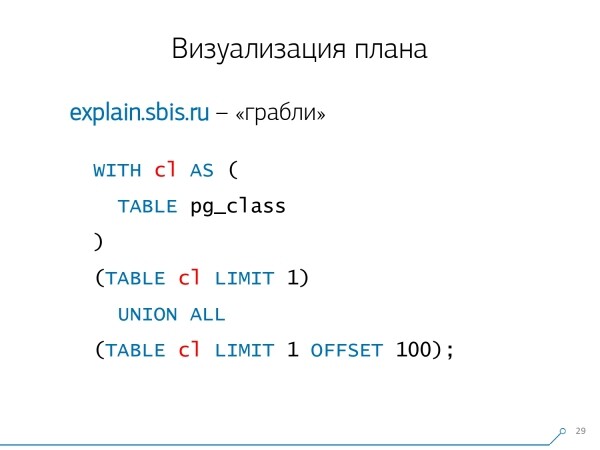
Het is vrij eenvoudig om dit probleem te krijgen - we maken een CTE en lezen daarin zogenaamd iets. In werkelijkheid is PostgreSQL 'intelligent' en zal daar niet rechtstreeks iets lezen. Vervolgens nemen we de eerste record uit de CTE, en koppelen daar de honderdste uit dezelfde CTE aan.
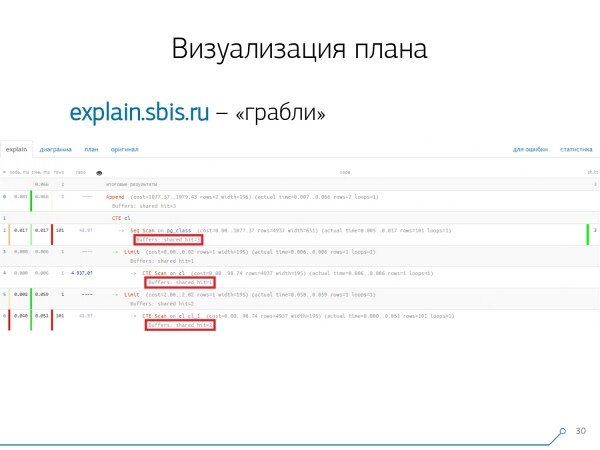
We bekijken het plan en begrijpen - vreemd, we hadden 3 buffers (gegevenspagina's) verbruikt in Seq Scan, nog 1 in CTE Scan, en nog 2 in de tweede CTE Scan. Dus als we alles gewoon optellen, krijgen we 6, maar we hebben slechts 3 uit de tabel gelezen! CTE Scan leest immers niets en werkt direct met het geheugen van het proces. Dus hier klopt duidelijk iets niet!
In feite blijkt dat de 3 gegevenspagina's, die zijn opgevraagd bij Seq Scan, eerst zijn aangevraagd door de eerste CTE Scan, en daarna door de tweede, die 2 extra heeft gelezen. Dus in totaal zijn er 3 gegevenspagina's gelezen, en niet 6.
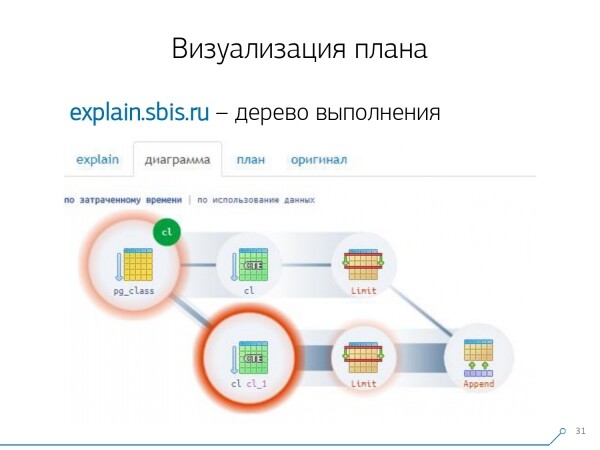
En dit beeld leidde ons tot het inzicht dat de uitvoering van het plan geen boom is, maar gewoon een acyclische grafiek. We hebben zo'n diagram gemaakt, zodat we begrijpen 'wat waarvandaan is gekomen'. Dus hier hebben we een CTE gecreëerd uit pg_class, en er twee keer om gevraagd, en de meeste tijd ging op aan de tak toen we er voor de tweede keer om vroegen. Het is duidelijk dat het lezen van de 101e record veel duurder is dan gewoon de 1e uit de tabel.

We haalden even diep adem. We zeiden: 'Nu weet je kung-fu, Neo! Nu is onze ervaring direct op jouw scherm. Nu kun je er gebruik van maken.'
Consolidatie van logs
Onze 1000 ontwikkelaars haalden opgelucht adem. Maar wij wisten dat we slechts honderden 'live' servers hadden, en al dat 'copy-paste' van de ontwikkelaars was helemaal niet handig. We realiseerden ons dat we dit zelf moesten samenstellen.
In feite is er een standaardmodule die statistieken kan verzamelen, maar die moet ook in de configuratie worden geactiveerd - dat is . Maar die beviel ons niet.
Ten eerste kent hij verschillende QueryId's toe aan dezelfde verzoeken in verschillende schema's binnen dezelfde database. verschillende QueryId. Dat betekent dat als we eerst SET search_path = '01'; SELECT * FROM user LIMIT 1;, en daarna SET search_path = '02'; en een soortgelijke aanvraag doen, er verschillende gegevens in de statistieken van deze module zullen staan, en ik kan geen algemene statistieken verzamelen specifiek vanuit dit verzoekprofiel, zonder rekening te houden met de schema's.
Het tweede probleem dat ons ervan weerhield het te gebruiken, is - het ontbreken van plannen. Dat wil zeggen, er is geen plan - er is alleen de aanvraag zelf. We zien wat vertraging veroorzaakte, maar begrijpen niet waarom. En dan komen we terug bij het probleem van de snel veranderende dataset.
En het laatste probleem - het gebrek aan 'feiten'. Dat wil zeggen, je kunt niet verwijzen naar een specifieke instantie van de uitvoering van de aanvraag - die is er niet, er is alleen geaggregeerde statistiek. Dit is moeilijk te behandelen, het is gewoon erg complex.
Daarom besloten we de 'copy-paste' tegen te gaan en begonnen we met het schrijven van een verzamelaar.
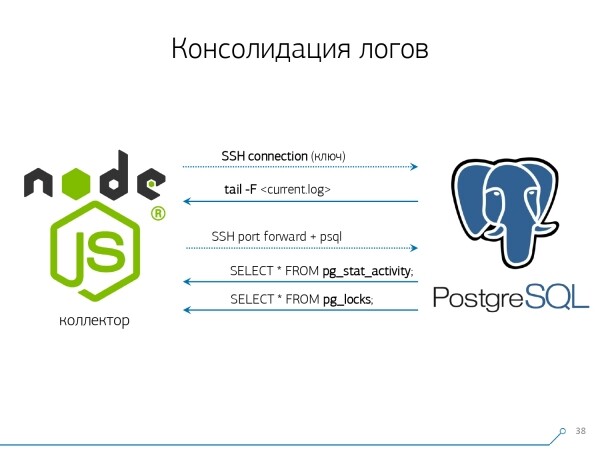
De verzamelaar maakt verbinding via SSH, 'trekt' via een certificaat een beveiligde verbinding naar de server met de database en tail -F hangt zich aan het logbestand. Op deze manier krijgen we in deze sessie een volledig 'spiegelbeeld' van het volledige logbestand, dat door de server wordt gegenereerd. De belasting op de server zelf is hierbij minimaal, omdat we daar niets parseren, we spiegelen gewoon het verkeer.
Aangezien we al begonnen waren met het schrijven van de interface in Node.js, hebben we de verzamelaar ook daarop verder ontwikkeld. En deze technologie heeft zich bewezen, omdat het heel handig is om met slecht geformatteerde tekstgegevens, zoals logs, te werken met JavaScript. En de Node.js infrastructuur als backend-platform maakt het gemakkelijk en praktisch om met netwerken en datastructuren te werken.
In dat geval 'trekken' we twee verbindingen: de eerste om de log zelf te 'luisteren' en deze te verzamelen, en de tweede om periodiek de database te vragen. 'Oh, in de log staat dat de tabel met oid 123 geblokkeerd is', maar dit zegt de ontwikkelaar niet veel en het zou handig zijn om de database te vragen: 'Wat is eigenlijk OID = 123?' En zo vragen we periodiek de database naar dingen die we nog niet weten.
'Je hebt slechts één ding niet overwogen, er zijn olifant-achtige bijen!' We begonnen deze systeem te ontwikkelen toen we 10 servers wilden monitoren. De meest kritische in onze ogen, waarop problemen opdoken die moeilijk te begrijpen waren. Maar in het eerste kwartaal kregen we al honderd servers om te monitoren — omdat het systeem 'binnenkwam', iedereen wilde het, het was handig voor iedereen.
Dit alles moet worden verzameld, de datastroom is groot en actief. Eigenlijk gebruiken we alleen datgene wat we monitoren en waar we mee om kunnen gaan. We gebruiken ook PostgreSQL als gegevensopslag. En er is niets snellers om gegevens in te 'storten' dan de operator. COPY nog niet.
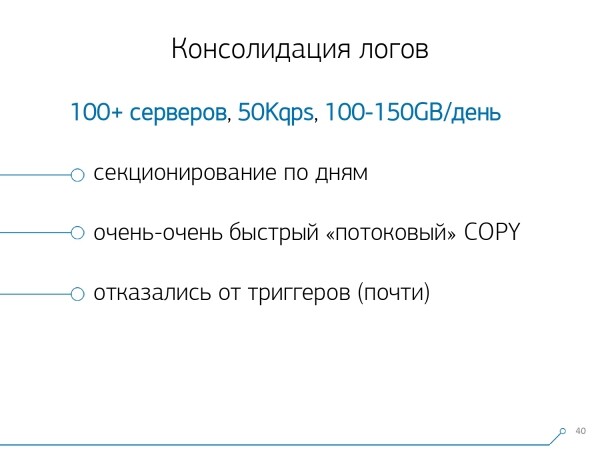
Maar alleen 'gegevensstorten' is niet helemaal onze technologie. Want als je op honderd servers ongeveer 50k verzoeken per seconde hebt, genereert dat 100-150GB logs per dag. Daarom moesten we de database zorgvuldig 'snijden'.
Ten eerste hebben we segmentatie per dag, omdat, in wezen, niemand zich bezighoudt met de correlatie tussen dagen. Wat maakt het uit wat je gisteren had, als je vanavond een nieuwe versie van de applicatie hebt uitgerold — en al nieuwe statistieken hebt.
Ten tweede hebben we geleerd (we waren gedwongen) om zeer, zeer snel te schrijven met COPY. Dat wil zeggen, niet alleen COPY, omdat hij sneller is dan INSERT, maar nog sneller.
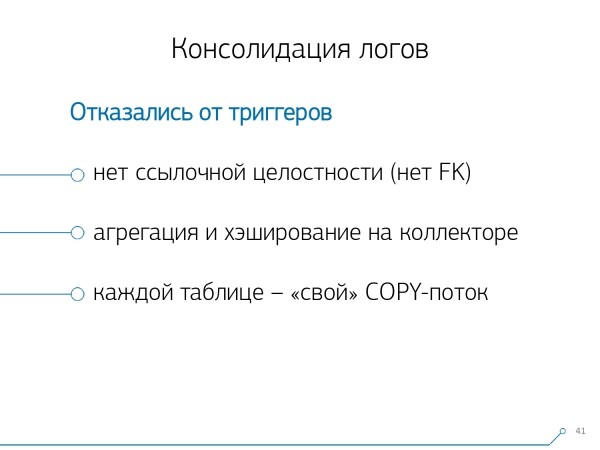
Het derde punt — we moesten afzien van triggers, en dus ook van Foreign Keys. Dat wil zeggen, we hebben helemaal geen referentiële integriteit. Want als je een tabel hebt met een paar FK's, en je zegt in de database-structuur dat 'deze logvermelding verwijst naar een groep records via FK', dan heeft PostgreSQL niets anders dan het eerlijk uitvoeren van SELECT 1 FROM master_fk1_table WHERE ... met de identificatie die je probeert in te voegen — gewoon om te verifiëren dat dit record daar aanwezig is, zodat je geen Foreign Key 'breekt' met je invoeging.
In plaats van één record in de doel tabel en zijn indexen, krijgen we bovendien ook alle leesoperaties van de tabellen waarnaar deze verwijst. En dat willen we helemaal niet — onze taak is om zo veel mogelijk en zo snel mogelijk te schrijven met de minste belasting. Dus FK — weg ermee!
Het volgende punt is aggregatie en hashing. Aanvankelijk hadden we dit in de database geïmplementeerd — het is tenslotte handig om direct een record te hebben zodra het binnenkomt, om deze in een bepaalde tabel te verwerken. ‘plus één’ direct in de trigger.. Goed, handig, maar slecht omdat — wanneer je één record invoert, je gedwongen bent om ook iets uit een andere tabel te lezen en te schrijven. En niet alleen lezen en schrijven — maar ook dat elke keer te doen.
Stel je nu voor dat je een tabel hebt waarin je gewoon het aantal verzoeken telt dat langs een specifieke host is gegaan: +1, +1, +1, ..., +1. En dat heb je in principe niet nodig — dat kan allemaal in het geheugen op de collector worden opgeteld en in één keer naar de database worden verzonden. +10.
Ja, je kunt in het geval van storingen de logische integriteit verliezen, maar dat is praktisch een onrealistisch scenario — omdat je een normale server hebt, met een batterij in de controller, je hebt een transactie-log, een log op het bestandssysteem… Kortom, het is het niet waard. De prestatieverlies die je oploopt door triggers/FK is het niet waard.
Hetzelfde geldt voor hashing. Er komt een verzoek binnen, je berekent een bepaalde identifier in de database, schrijft deze naar de database en zegt het daarna aan iedereen. Alles is goed, totdat er op het moment van schrijven een tweede iemand komt die dezelfde wil schrijven — en dan krijg je een blocking, en dat is al slecht. Dus als je het mogelijk kunt maken om de generatie van bepaalde ID's naar de client te verplaatsen (relatief van de database), doe dat dan liever.
Het was perfect voor ons om MD5 van de tekst — het verzoek, het plan, de sjabloon,… te gebruiken. We berekenen dit aan de kant van de collector, en 'storten' al de berekende ID in de database. De lengte van MD5 en dagelijkse partitionering stellen ons in staat om ons geen zorgen te maken over mogelijke botsingen.
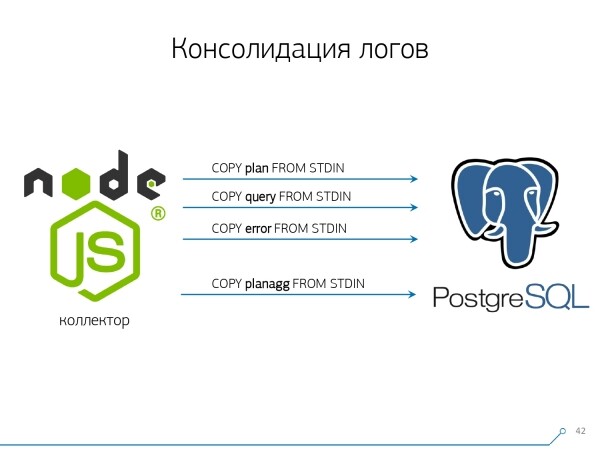
Maar om dit alles snel te schrijven, moesten we de schrijfprocedure zelf aanpassen.
Hoe worden gegevens normaal gesproken geschreven? We hebben een dataset, die we verdelen over verschillende tabellen, en daarna COPY — eerst naar de eerste, dan naar de tweede, de derde… Het is onhandig, omdat we eigenlijk één datastroom in drie opeenvolgende stappen schrijven. Dat is vervelend. Kan het sneller? Jazeker!
Het enige wat we hoeven te doen, is deze stromen parallel aan elkaar te verwerken. Hierdoor krijgen we fouten, verzoeken, sjablonen, blokkades… die in aparte stromen aankomen, en we schrijven alles parallel. Hiervoor is het voldoende om een COPY-kanaal permanent open te houden voor elke afzonderlijke doeltabel..
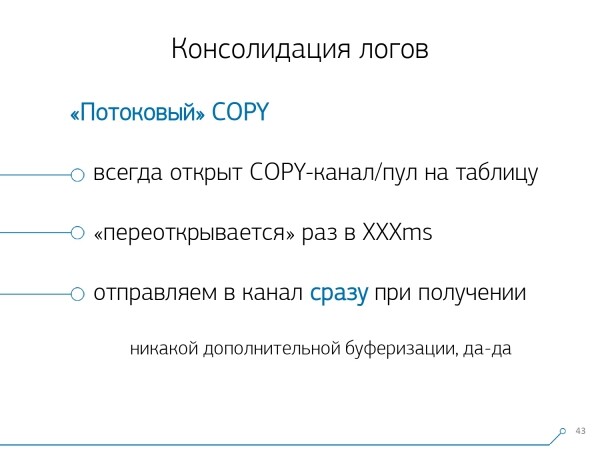
Dat betekent dat de collector altijd een stream heeft, waarin ik de benodigde gegevens kan schrijven. Maar om ervoor te zorgen dat de database deze gegevens ziet en niemand vastloopt in blokkades terwijl ze wachten tot de gegevens zijn geschreven, moet COPY met een bepaalde periodiciteit worden onderbroken. Voor ons bleek een periode van ongeveer 100 ms het meest effectief te zijn — we sluiten het af en openen onmiddellijk weer voor dezelfde tabel. En als we niet genoeg stromen hebben tijdens pieken, dan doen we polling tot een bepaald maximum.
Daarnaast hebben we vastgesteld dat voor dit soort belasting elke aggregatie, wanneer records in pakketten worden verzameld, schadelijk is. De klassieke boosdoener is INSERT ... VALUES en dan 1000 records. Want op dat moment ontstaat er een piek in het schrijven op de schijf, en alle anderen die iets op de schijf proberen te schrijven, moeten wachten.
Om dergelijke anomalieën te vermijden, aggregeer niets, bufereer helemaal niet. En als er toch buffering naar de schijf optreedt (gelukkig maakt de Stream API in Node.js dit mogelijk om te detecteren) — stel die verbinding uit. Wanneer je een melding ontvangt dat deze weer beschikbaar is, schrijf er dan in vanuit de verzamelde wachtrij. En zolang deze bezet is, neem de volgende vrije uit de pool en schrijf daarin.
Voordat we deze aanpak voor het schrijven van gegevens implementeerden, hadden we ongeveer 4K write ops, en op deze manier hebben we de belasting met 4 keer verminderd. Nu zijn we nog eens 6 keer toegenomen dankzij nieuwe waargenomen databases — tot 100 MB/s. En nu slaan we logs van de laatste 3 maanden op, met een volume van ongeveer 10-15 TB, in de hoop dat elke ontwikkelaar in die drie maanden elk probleem kan oplossen.
We begrijpen de problemen
Maar gewoon al deze gegevens verzamelen is goed, nuttig, relevant, maar niet voldoende - je moet ze begrijpen. Want dit zijn miljoenen verschillende plannen per dag.
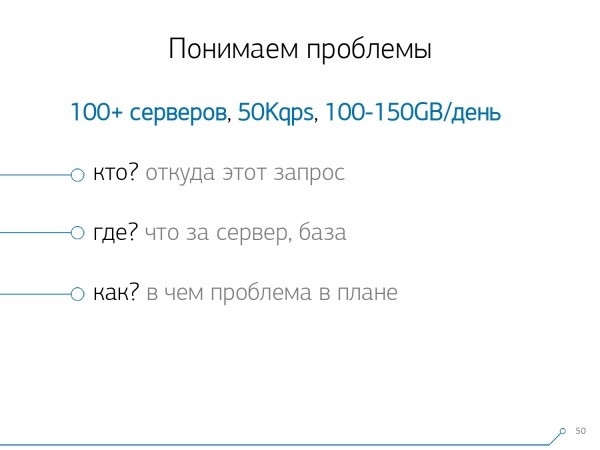
Maar miljoenen zijn onbeheerbaar, we moeten eerst 'minder' maken. En in de eerste plaats moeten we beslissen hoe we dat 'minder' gaan organiseren.
We hebben drie belangrijke punten voor onszelf onderscheiden:
- wie deze aanvraag is verzonden door
Dus van welke applicatie het 'is gekomen': webinterface, backend, betalingssysteem of iets anders. - waar dit gebeurde
Op welke specifieke server. Want als je onder één applicatie meerdere servers hebt en ineens een gaat 'hangen' (omdat de 'schijf is verrot', het 'geheugen lekt', of er is iets anders aan de hand), dan moet je specifiek naar de server verwijzen. - hoe de probleem zich manifesteerde in dit of dat plan
Om te begrijpen 'wie' ons verzoek heeft gestuurd, maken we gebruik van een standaard hulpmiddel - het instellen van een sessievariabele: SET application_name = '{bl-host}:{bl-method}'; we registreren de naam van de host van de business logic waar het verzoek vandaan komt en de naam van de methode of applicatie die het heeft geïnitieerd.
Nadat we de 'eigenaar' van het verzoek hebben doorgestuurd, moeten we dit in de log opnemen - om dit te doen configureren we de variabele log_line_prefix = ' %m [%p:%v] [%d] %r %a'. Voor wie geïnteresseerd is, kan , wat dit allemaal betekent. Het resultaat is dat we in de log zien:
- de tijd
- proces- en transactienummers
- databasenaam
- IP van degene die dit verzoek heeft verzonden
- en de naam van de methode
Daarna begrepen we dat het niet zo interessant is om de correlatie van één verzoek tussen verschillende servers te bekijken. Het komt niet vaak voor dat je één applicatie dezelfde fout laat maken hier en daar. Maar zelfs als het hetzelfde is - kijk naar een van die servers.
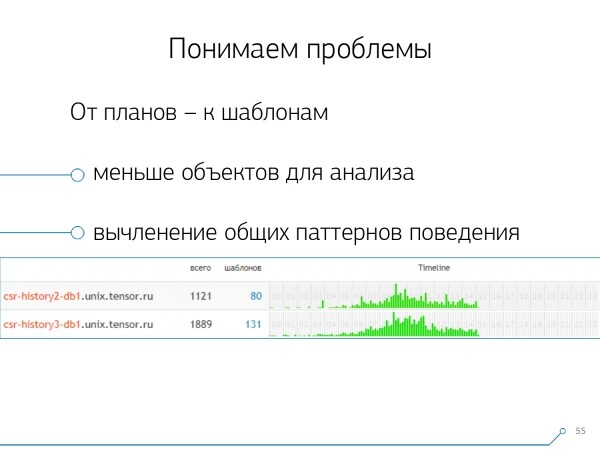
Dus, de snede 'één server - één dag' blijkt voldoende te zijn voor elke analyse.
De eerste analytische snede - is dat specifieke 'sjabloon' de verkorte weergave van het plan, ontdaan van alle numerieke indicatoren. De tweede snede - applicatie of methode, en de derde - dat specifieke knooppunt van het plan dat ons problemen heeft bezorgd.
Toen we van specifieke instanties naar sjablonen overstapten, kregen we onmiddellijk twee voordelen:
- een aanzienlijke vermindering van het aantal objecten voor analyse
Je hoeft de problemen niet meer te analyseren over duizenden verzoeken of plannen, maar slechts over tientallen sjablonen. - tijdlijn
Dus, door de "feiten" te generaliseren binnen een bepaalde afbakening, kun je hun verschijning gedurende de dag weergeven. En hier kun je begrijpen dat als je een bepaald patroon hebt dat bijvoorbeeld eens per uur voorkomt, terwijl het eens per dag zou moeten zijn, je je moet afvragen wat er mis is gegaan - wie heeft het opgeroepen en waarom, misschien hoort het hier niet te zijn. Dit is nog een niet-numerieke, puur visuele manier van analyseren.
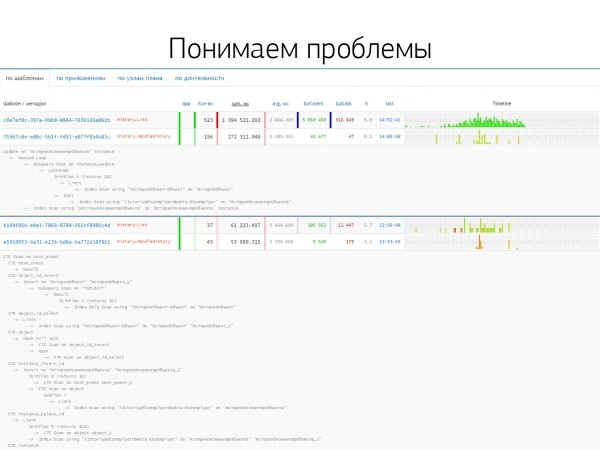
De andere methoden zijn gebaseerd op de indicatoren die we uit het plan halen: hoe vaak dit patroon heeft plaatsgevonden, de totale en gemiddelde tijd, hoeveel gegevens er van de schijf zijn gelezen en hoeveel uit het geheugen…
Omdat je bijvoorbeeld naar de analytics-pagina van de host komt, kijkt en ziet dat er te veel vanaf de schijf wordt gelezen. De schijf op de server kan het niet aan - maar wie leest ervan?
En je kunt sorteren op elke kolom en beslissen waar je nu mee aan de slag gaat - met de belasting op de CPU of de schijf, of met het totale aantal aanvragen… Je hebt gesorteerd, gekeken naar de "top", gerepareerd - en hebt een nieuwe versie van de applicatie uitgerold.
En meteen zie je verschillende applicaties die hetzelfde patroon volgen van een aanvraag van het type SELECT * FROM users WHERE login = 'Vasya'. Frontend, backend, processing… En je vraagt je af waarom de processing de gebruiker zou lezen, als hij er niet mee interacteert.
De omgekeerde manier is om meteen te zien wat de applicatie doet. Bijvoorbeeld, de frontend - dit, dit, dit, en ook dit eens per uur (precies de tijdlijn helpt). En dan rijst de vraag - het lijkt erop dat het niet de taak van de frontend is om iets eens per uur te doen…
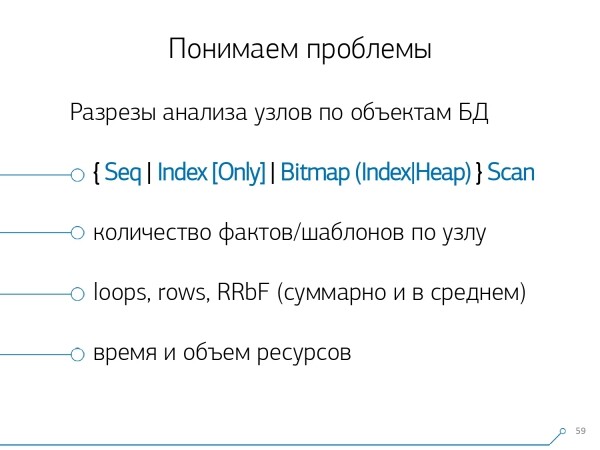
Na een tijdje realiseerden we ons dat we een geaggregeerde statistiek miste in het kader van de plannen. We hebben alleen die knooppunten uit de plannen gehaald die iets doen met de gegevens van de tabellen zelf (deze lezen/schrijven ze op index of niet). In wezen wordt er slechts één aspect toegevoegd aan de vorige afbeelding - hoeveel records deze knoop ons heeft gebracht, en hoeveel deze heeft weggegooid (Rows Removed by Filter).
Je hebt geen geschikte index op de tabel, je doet er een aanvraag op en deze vliegt langs de index, valt in Seq Scan… je hebt alle records gefilterd, behalve één. Waarom heb je in 24 uur 100M gefilterde records, zou het niet beter zijn een index te maken?
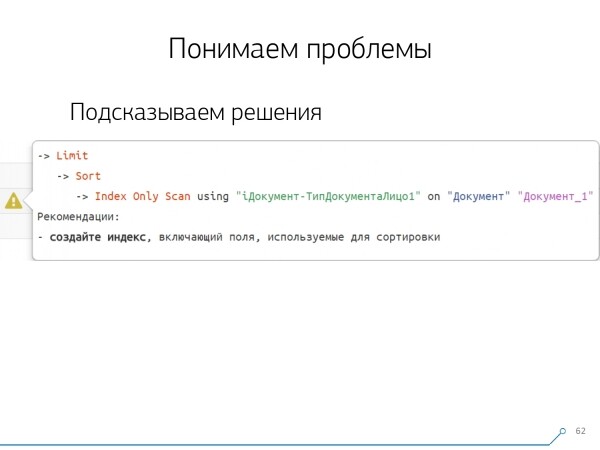
Na het analyseren van alle plannen per knooppunt, realiseerden we ons dat er enkele standaardstructuren in de plannen zijn die zeer waarschijnlijk verdacht lijken. Het zou handig zijn om de ontwikkelaar te adviseren: "Vriend, hier lees je eerst op de index, dan sorteert je en vervolgens snijd je af" — meestal is er maar één record daar.
Iedereen die verzoeken schreef met zo'n patroon is ongetwijfeld tegen het volgende aangelopen: "Geef me de laatste bestelling voor Vasya, zijn datum." En als je geen index op datum hebt, of als de gebruikte index geen datum bevat, dan is dit precies waar je op de "hobbels" stuit.
Maar we weten dat dit de "hobbels" zijn — waarom zouden we de ontwikkelaar niet meteen adviseren wat er moet gebeuren? Daarom ziet onze ontwikkelaar bij het openen van het plan meteen een mooi overzicht met aanwijzingen, waar meteen staat: "Je hebt problemen hier en daar, en deze kunnen zo en zo worden opgelost."
Als resultaat is de hoeveelheid ervaring die nodig was om problemen in het begin op te lossen en nu drastisch verminderd. Zo hebben we dit hulpmiddel ontwikkeld.
Bron: habr.com
