

Legitiem verkeer in het DDoS-Guard netwerk overschreed recentelijk de honderd gigabit per seconde. Momenteel genereert 50% van al ons verkeer webdiensten van klanten. Dit zijn vele tienduizenden domeinen, heel divers en in de meeste gevallen vereisen ze een individuele aanpak.
Hieronder zie je hoe we de front-end nodes beheren en deze uitleveren SSL-certificaten voor honderdduizenden sites.
Het instellen van de front-end voor één site, hoe groot ook, is eenvoudig. We nemen nginx of haproxy of lighttpd, configureren deze volgens de handleidingen en vergeten het. Als er iets moet worden gewijzigd, doen we een reload en vergeten het opnieuw.
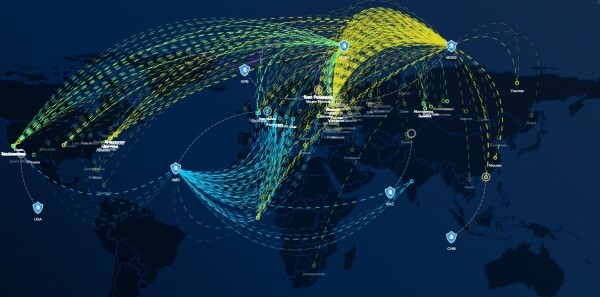
Alles verandert als je grote hoeveelheden verkeer in real-time verwerkt, de legitimiteit van aanvragen beoordeelt, gebruikersinhoud comprimeert en cachet, en tegelijkertijd parameters meerdere keren per seconde wijzigt. De gebruiker wil de resultaten op alle externe nodes zien zodra hij de instellingen in zijn persoonlijke omgeving heeft gewijzigd. Bovendien kan de gebruiker via de API duizenden (en soms tienduizenden) domeinen met specifieke verkeersbehandelingsparameters uploaden. Dit moet ook onmiddellijk functioneren in Amerika, Europa en Azië — een niet triviale taak, gezien het feit dat in Moskou alleen al verschillende fysiek gespreide filternodes bestaan.
Waarom veel grote betrouwbare nodes over de hele wereld?
- De kwaliteit van de dienstverlening van klantverkeer — aanvragen uit de VS moeten juist in de VS worden verwerkt (ook in verband met aanvallen, parsing en andere anomalieën), en niet naar Moskou of Europa worden getrokken, wat de verwerkingstijd onvoorspelbaar verhoogt.
- Aanvallend verkeer moet gelokaliseerd worden — transitoperators kunnen degraderen tijdens aanvallen, waarvan de volume vaak meer dan 1Tbps overschrijdt. Het transporteren van aanvallend verkeer via transatlantische of transaziatische verbindingen is geen goed idee. We hebben echte gevallen gehad waarin Tier-1 operators zeiden: 'De volumes van de aanvallen die u ontvangt, zijn gevaarlijk voor ons.' Daarom accepteren we inkomende stromen zo dicht mogelijk bij hun bronnen.
- Strenge continuïteitseisen - de datacenters mogen niet afhankelijk zijn van elkaar of van lokale gebeurtenissen in onze snel veranderende wereld. Is er een stroomstoring van een week op alle 11 verdiepingen van MMTS-9? Geen probleem. Geen enkele klant zal worden getroffen die geen fysieke aansluiting heeft op deze locatie, en webservices zullen onder geen enkele omstandigheid worden beïnvloed.
Hoe te beheren?
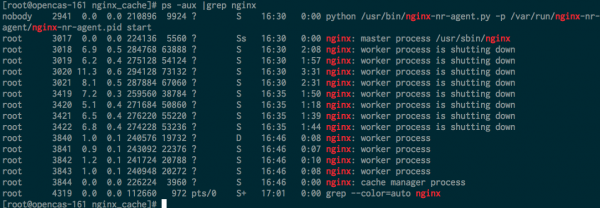
Serviceconfiguraties moeten zo snel mogelijk (bij voorkeur onmiddellijk) worden uitgerold naar alle frontnodes. Je kunt niet gewoon tekstconfiguraties aanpassen en demon opnieuw opstarten bij elke wijziging - zelfs nginx houdt aflopende processen (worker shutting down) nog een paar minuten vast (en soms zelfs uren als daar lange websocket-sessies zijn).
Bij het herstarten van de configuratie van nginx is de volgende situatie heel normaal:
Over geheugengebruik:
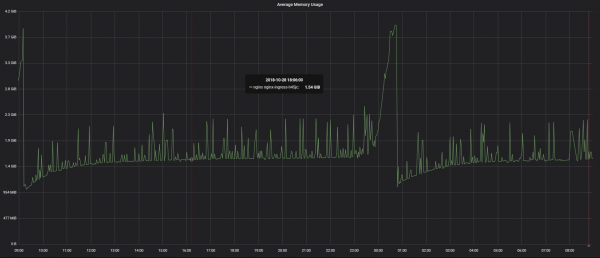
Oude workers gebruiken geheugen, ook dat wat niet lineair afhankelijk is van het aantal verbindingen - dit is normaal. Wanneer de klantverbindingen sluiten, komt dit geheugen weer vrij.
Waarom was dit geen probleem toen nginx net begon? Er was geen HTTP/2, geen WebSocket, en geen massale lange keep-alive verbindingen. 70% van ons webverkeer is HTTP/2, wat zeer langdurige verbindingen met zich meebrengt.
De oplossing is eenvoudig - gebruik geen nginx, beheer de fronten niet op basis van tekstbestanden, en stuur zeker geen gecomprimeerde tekstconfiguraties over transpacifische kanalen. De kanalen zijn natuurlijk gegarandeerd en gereserveerd, maar dat maakt ze niet minder transcontinentaal.
Wij hebben een eigen frontserver-balancer, waarvan ik in de volgende artikelen meer zal vertellen. Het belangrijkste is dat hij in staat is om duizenden configuratiewijzigingen per seconde on-the-fly toe te passen, zonder herstarts, herlaadacties, een plotselinge toename van het geheugengebruik en dat soort dingen. Dit lijkt veel op Hot Code Reload, bijvoorbeeld in Erlang. Gegevens worden opgeslagen in een geografisch gedistribueerde key-value database en worden onmiddellijk door de uitvoeringsmechanismen van de fronten gelezen. Dat wil zeggen, je hebt een SSL-certificaat via de webinterface of API in Moskou geüpload, en binnen enkele seconden is het al klaar voor gebruik in ons schoonmaakcentrum in Los Angeles. Mocht er ooit een wereldoorlog uitbreken en het internet wereldwijd verdwijnen, dan blijven onze nodes autonoom functioneren en lossen ze split-brain op zodra een van de speciale verbindingen Los Angeles-Amsterdam-Moskou, Moskou-Amsterdam-Hongkong-Los Angeles of minstens een van de reserve overlay GRE-kanalen beschikbaar is.
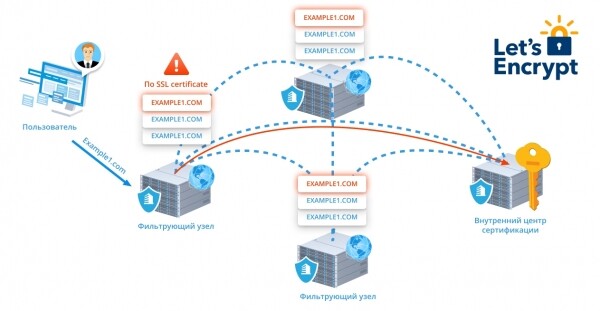
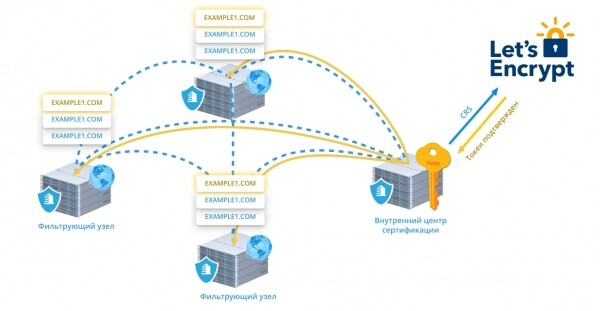
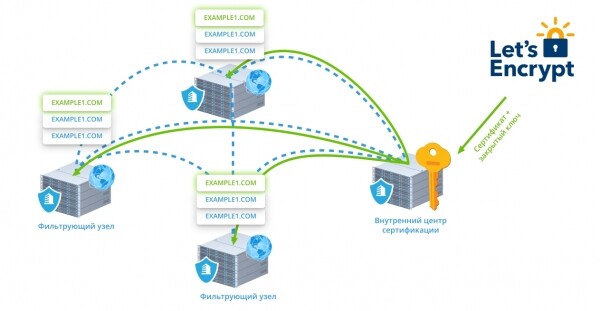
Ditzelfde mechanisme stelt ons in staat om certificaten van Let’s Encrypt onmiddellijk uit te geven en te verlengen. Op een vereenvoudigde manier werkt dit als volgt: Zodra we een enkele HTTPS-verzoek voor het domein van onze klant zonder certificaat (of met een verlopen certificaat) zien, meldt de externe node die het verzoek heeft ontvangen dit aan het interne certificeringscentrum.
- Als de gebruiker het uitgeven van Let’s Encrypt niet heeft verboden, genereert het certificeringscentrum een CSR, ontvangt een bevestigings-token van LE en verspreidt deze via een beveiligd kanaal naar alle fronten. Nu kan elke node de validatieverzoek van LE bevestigen.

- Binnen enkele momenten ontvangen we een geldig certificaat en een privésleutel, en wederom versturen we deze naar de fronten. Opnieuw zonder de demons opnieuw op te starten.
- Zeven dagen voor de vervaldatum wordt het proces voor het opnieuw verkrijgen van het certificaat geïnitieerd.
- Op dit moment roteren we in real-time 350.000 certificaten volledig transparant voor de gebruikers.
In de volgende artikelen van de cyclus zal ik vertellen over andere kenmerken van real-time verwerking van groot webverkeer, zoals het analyseren van RTT op onvolledige gegevens om de kwaliteit van de dienstverlening voor transitklanten te verbeteren, en over de bescherming van transitverkeer tegen terabits-aanvallen, het leveren en aggregeren van informatie over verkeer, over WAF, bijna onbeperkte CDN en een groot aantal optimalisatiemechanismen voor de contentlevering.
Waarover zou je in de eerste plaats meer willen weten?
Alleen geregistreerde gebruikers kunnen deelnemen aan de enquête. Log in, alstublieft.
Waar zou je eerst meer over willen weten?
- 14,3%Clusteranalyse-algoritmen en webverkeer kwaliteitsanalyse<3
- 33,3%De interne werking van DDoS-Guard7 balancers
- 9,5%Bescherming van transit L3/L4 verkeer2
- 0,0%Bescherming van websites tegen transitverkeer0
- 14,3%Web Application Firewall3
- 28,6%Bescherming tegen parsing en klikfraude6
21 gebruikers hebben gestemd. 6 gebruikers hebben zich onthouden.
Bron: habr.com
