

Onlangs vertelde ik hoe je de prestaties van 'read' SQL-query's kunt verhogen je het schrijven in de database efficiënter kunt maken zonder enige 'draaiknoppen' in de configuratie - gewoon door de datastromen goed te organiseren. Dit artikel gaat over hoe en waarom je het moet organiseren
#1. Секционирование
van toepasselijke partitionering 'in theorie'. monitoringdienst voor honderden PostgreSQL-servers. .
Aanvankelijk, zoals elk MVP-project, startte ons project onder een relatief lage belasting - de monitoring vond alleen plaats voor een tiental kritische servers, alle tabellen waren relatief klein... Maar de tijd ging voorbij, het aantal te monitoren hosts nam toe, en toen we opnieuw iets probeerden te doen met een van de
tabellen van 1,5TB, begrepen we dat het leven zo verdergaan mogelijk was, maar erg onhandig.De tijden waren bijna mythisch, verschillende varianten van PostgreSQL 9.x waren relevant, dus moest al het partitioneren 'handmatig' worden gedaan - via
tabelovererving en triggers. Routing met dynamische Het resultaat bleek voldoende universeel te zijn, zodat het op alle tabellen kon worden toegepast. EXECUTE.
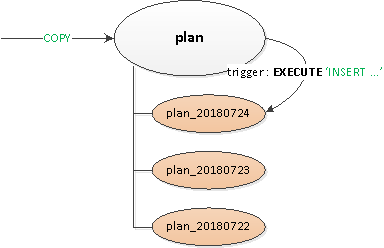
Er werd een lege 'hoofd'-parenttabel gedeclareerd, waarop alle
- vereiste indexen en triggers werden beschreven. Gegevens vanuit het perspectief van de klant werden ingevoerd in de 'wortel'-tabel, terwijl binnenin met behulp van.
- de routing-trigger BEFORE INSERT
de gegevens 'fysiek' in het juiste segment werden ingevoegd. Als zo'n segment nog niet bestond, vingen we de uitzondering op en ...... met behulp van - CREATE TABLE ... (LIKE ... INCLUDING ...) segment aangemaakt met een beperking op de vereiste datum, zodat tijdens het ophalen van gegevens het lezen alleen daarin plaatsvond.PG10: de eerste poging.
Maar partitioneren via overerving was historisch gezien niet goed aangepast voor actief schrijfverkeer of een groot aantal kindsegmenten. Bijvoorbeeld, je kunt je herinneren dat het algoritme voor het kiezen van het juiste segment had
kwadratische complexiteit, wat met 100+ segmenten, je begrijpt hoe dat werkt...In PG10 is deze situatie sterk geoptimaliseerd, met de implementatie van ondersteuning voor
native partitionering. Dus hebben we het meteen geprobeerd toe te passen na de migratie van de opslag, maar...
Zoals bleek na het doorlezen van de handleiding, ondersteunt de natively partitioned tabel in deze versie:
- geen indexbeschrijvingen
- ondersteunt geen triggers
- kan zelf niets zijn 'afkomstig van'
- ondersteunt niet
INSERT ... ON CONFLICT - kan sectie niet automatisch genereren
Na een flinke klap op ons hoofd met de hark, beseften we dat we niet zonder modificatie van de applicatie verder konden, en stelden we ons onderzoek zes maanden uit.
PG10: een tweede kans
Dus we begonnen de opkomende problemen een voor een op te lossen:
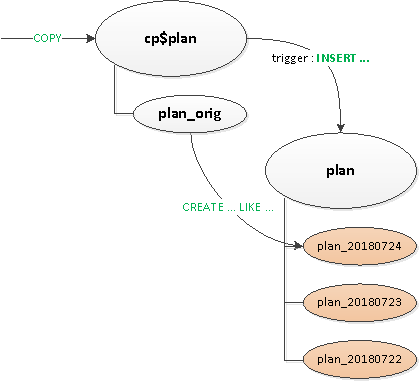
- Aangezien triggers en
ON CONFLICTtoch ergens nodig waren, maakten we een tussentijdse proxy-tabel. - We hebben de 'routering' in de triggers verwijderd - dat wil zeggen de We hebben apart
EXECUTE. - een sjabloontabel met alle indexen gemaakt , zodat ze zelfs niet op de proxy-tabel aanwezig waren.Uiteindelijk, na dit alles, hebben we de hoofdtafel natively gepartitioneerd. Het aanmaken van een nieuwe sectie bleef voorlopig de verantwoordelijkheid van de applicatie.
We 'snijden' woordenlijsten
Zoals in elk analytisch systeem, hadden wij ook
feiten en dimensies (woordenlijsten). In ons geval fungeerden bijvoorbeeld het lichaam van de 'sjabloon' We hadden de 'feiten' al lang op dagen gepartitioneerd, dus konden we verouderde secties rustig verwijderen, ze hebben ons niet gestoord (de logs!). Maar met de woordenlijsten liep het anders...
Het is niet zo dat er heel veel waren, maar ongeveer
op 100TB 'feiten' kreeg je een woordenlijst van 2.5TB. Van zo'n tabel is het moeilijk om iets te verwijderen, niets kan je in een redelijke tijd comprimeren, en het schrijven daarin werd geleidelijk steeds langzamer.Het lijkt een woordenlijst... elke opname moet precies één keer worden gepresenteerd... en dat is correct, maar!.. Niemand weerhoudt ons ervan
om een aparte woordenlijst voor elke dag te hebben! Ja, dat brengt bepaalde overbodigheid met zich mee, maar het maakt het mogelijk om:sneller te schrijven/lezen
- door de kleinere grootte van de sectie minder geheugen te verbruiken
- door te werken met compactere indexen minder gegevens op te slaan
- door de mogelijkheid om snel verouderde Als resultaat van alles wat we hebben gedaan,
is de CPU-belasting met ~30% verminderd, de schijfbelasting met ~50% Bij dit alles hebben we nog steeds precies hetzelfde in de database geschreven, alleen met een lagere belasting.:
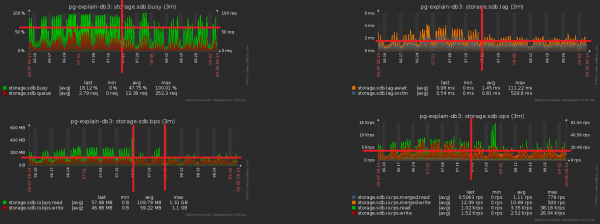
Tegelijkertijd hebben we exact hetzelfde in de database geschreven, maar met een lagere belasting.
#2. Эволюция и рефакторинг БД
Dus, we waren gebleven bij het feit dat we voor elke dag een sectie hebben met gegevens. Eigenlijk, CHECK (dt = '2018-10-12'::date) — en dat is de sleutel voor partitionering en de voorwaarde voor opname van een record in een specifieke sectie.
Aangezien alle rapporten in onze service worden gebouwd op basis van een specifieke datum, waren de indexen uit de "niet-gepartitioneerde tijden" ook allemaal van het type (Server, Datum, Sjabloon plan), (Server, Datum, Knoop plan), (Datum, Foutklasse, Server),…
Maar nu hebben elke secties hun eigen exemplaren van elke dergelijke index... En binnen elke sectie is de datum een constante... Het blijkt dat we nu in elke dergelijke index simpelweg de constante opnemen als een van de velden, wat zowel het volume als de zoektijd vergroot, maar geen resultaat oplevert. We hebben onszelf op de vingers getikt, oeps...
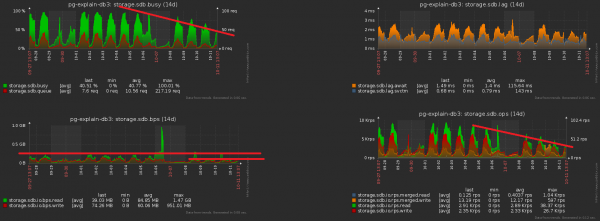
De richting van optimalisatie is duidelijk - gewoon verwijder het dataveld uit alle indexen in gepartitioneerde tabellen. Bij onze volumes is de winst ongeveer 1TB/week!
En laten we nu opmerken dat deze terabyte ook ergens moet worden opgeslagen. Dat wil zeggen, we moeten de schijf nu minder belasten! Op deze afbeelding is het effect van de uitgevoerde reiniging, waar we een week aan hebben besteed, goed te zien:
#3. «Размазываем» пиковую нагрузку
Een van de grote problemen van drukbelaste systemen is overmatige synchronisatie van bepaalde operaties die dat niet vereisen. Soms "omdat we het niet opgemerkt hebben", soms "omdat het makkelijker was", maar vroeg of laat moet je ervan af.
We benaderen de vorige afbeelding - en zien dat de schijf ons "beweegt" met een dubbele amplitudo belasting tussen naburige metingen, wat statistisch gezien niet zou moeten zijn bij zo'n aantal bewerkingen:
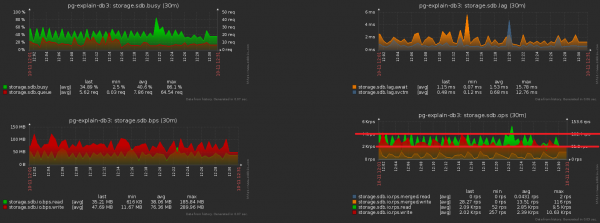
Dit is vrij eenvoudig te bereiken. We hadden al bijna 1000 servers gemonitord,elke wordt verwerkt door een aparte logische stroom, en elke stroom verplaatst de verzamelde informatie voor verzending naar de database met een bepaalde periodiciteit, ongeveer zo:
setInterval(sendToDB, interval)Het probleem ligt precies in het feit dat alle stromen ongeveer tegelijkertijd starten,waardoor hun verzendmomenten bijna altijd "samenvallen tot het punt". Oeps nummer 2...
Gelukkig kan dit vrij eenvoudig worden opgelost, door een "willekeurige" tijdsverschuiving toe te voegen: setInterval(sendToDB, interval * (1 + 0.1 * (Math.random() - 0.5)))
Het derde traditionele probleem van highload is#4. Кэшируем, что нужно можно
het ontbreken van cache waar dat moet zijn. zou kunnen zijn.
Bijvoorbeeld, we hebben de mogelijkheid gecreëerd om analyses per knoop van het plan uit te voeren (al deze Seq Scan op gebruikers), maar meteen denken dat ze, in de massa, gelijk zijn — dat zijn ze vergeten.
Nee, natuurlijk worden er geen gegevens opnieuw in de database geschreven, dat schakelt de trigger uit met INSERT ... ON CONFLICT DO NOTHING. Maar deze gegevens komen toch in de database terecht, en dat zorgt voor overbodige leesoperaties voor het controleren van conflicten die moeten plaatsvinden. Oeps nummer 3…
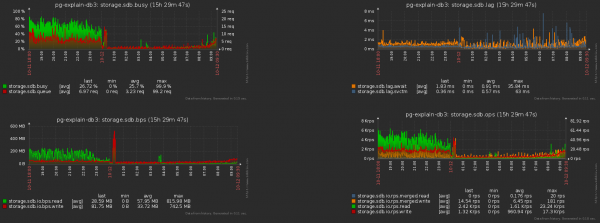
Het verschil in het aantal records dat naar de database wordt verzonden voor/na het inschakelen van caching is duidelijk:
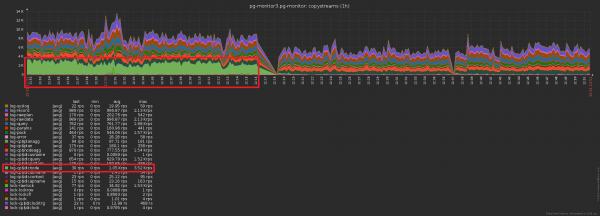
En dit is — de bijbehorende afname van de belasting op de opslag:
Total
‘Terabyte-per-dag’ klinkt alleen nogal angstaanjagend. Als je alles goed doet, is dat slechts 2^40 bytes / 86400 seconden = ~12.5MB/s, wat de desktop IDE-schijven zelfs konden bijhouden. 🙂
En als het serieus is, zelfs met een tienvoudige ‘overbelasting’ van de belasting gedurende de dag, kun je met gemak blijven binnen de mogelijkheden van moderne SSD's.
Bron: habr.com
