

Het onderwerp van het vastleggen van grote gegevensstromen, dat in komt hier aan bod met manieren om de 'fysieke' omvang van opgeslagen gegevens in PostgreSQL te verminderen en de impact daarvan op de serverprestaties.
We gaan het hebben over TOAST-instellingen en dataverlies.. 'Gemiddeld' zullen deze methodes niet veel middelen besparen, maar ze vereisen ook helemaal geen wijziging van de applicatiecode.
Onze ervaring in dit opzicht is echter zeer productief gebleken, aangezien de opslag voor vrijwel elke monitoring van nature grotendeels append-only is met betrekking tot de gegevens die worden geschreven. En als je je afvraagt hoe je de database kunt leren om op een snelheid van 200MB/s de helft minder te schrijven - lees dan verder.
Kleine geheimen van grote data
Vanwege het type werk Aangezien het gecombineerde systeem van SBIS,.
wiens databases we controleren, een veelzijdig product met complexe datastructuren is, zijn de verzoeken soms echt 'multi-volume' met complexe algoritmische logica. Het resultaat is dat de omvang van elk afzonderlijk exemplaar van een verzoek of uitvoeringsplan in de door ons ontvangen logs 'gemiddeld' behoorlijk groot is. CREATE TABLE rawdata_orig( pack -- PK uuid NOT NULL , recno -- PK smallint NOT NULL , dt -- sectiesleutel date , data -- het allerbelangrijkste text , PRIMARY KEY(pack, recno) );
Een typische tabel (al gepartitioneerd, uiteraard, dus dit is een sectiesjabloon), waarbij de tekst het belangrijkste is. Soms behoorlijk omvangrijk.
Vergeet niet dat de 'fysieke' omvang van een record in PG niet groter kan zijn dan één datablok, maar de 'logische' omvang - dat is een heel ander verhaal. Om een volumineuze waarde (varchar/text/bytea) in een veld op te slaan, wordtde TOAST-technologie gebruikt.
Laten we ons herinneren dat de "fysieke" grootte van een record in PG niet meer dan één gegevenspagina mag innemen, maar de "logische" grootte is iets heel anders. Om een grote waarde in een veld (varchar/text/bytea) op te slaan, wordt er gebruik gemaakt van :
PostgreSQL gebruikt een vaste paginagrootte (meestal 8 KB) en staat niet toe dat tuples meerdere pagina's innemen. Daarom is het niet mogelijk om zeer grote veldwaarden direct op te slaan. Om deze beperking te omzeilen, worden grote veldwaarden gecomprimeerd en/of verdeeld in meerdere fysieke rijen. Dit gebeurt onopgemerkt voor de gebruiker en heeft onbeduidende invloed op het grootste deel van de servercode. Deze methode staat bekend als TOAST …
In feite wordt er automatisch voor elke tabel met "potentieel grote" velden van elke "grote" opname in segmenten van 2KB:
TOAST(
  chunk_id
    integer
, chunk_seq
    integer
, chunk_data
    bytea
, PRIMARY KEY(chunk_id, chunk_seq)
);
Dat wil zeggen, als we een rij met een "groot" waarde moeten opslaan, datazal de werkelijke opname plaatsvinden niet alleen in de hoofdtafel en zijn PK, maar ook in TOAST en zijn PK..
De impact van TOAST verminderen
Maar de meeste opnames zijn nog steeds niet zo groot, moeten binnen 8KB passen — hoe kunnen we hierop besparen?..
Hier komt de attribuut van de kolom in de tabel ons te hulp:
- EXTENDED staat zowel compressie als aparte opslag toe. Dit is de standaardoptie voor de meeste datatypes die compatibel zijn met TOAST. Eerst wordt geprobeerd om compressie uit te voeren, vervolgens wordt de opslag buiten de tabel geprobeerd als de rij nog steeds te groot is.
- MAIN staat compressie toe, maar niet aparte opslag. (In feite zal aparte opslag echter worden uitgevoerd voor dergelijke kolommen, maar alleen als uiterste maatregel, wanneer er geen andere manier is om de rij te verkleinen zodat deze op de pagina past.)
In feite is dit precies wat we nodig hebben voor tekst — zo veel mogelijk comprimeren, en als het echt niet past — verplaatsen naar TOAST.Dit kan rechtstreeks "on-the-fly" met één commando:
ALTER TABLE rawdata_orig ALTER COLUMN data SET STORAGE MAIN;Hoe het effect te evalueren
Aangezien de datastroom elke dag verandert, kunnen we geen absolute cijfers vergelijken, maar in relatieve termen, hoe minder proportie we in TOAST hebben opgeslagen — hoe beter. Maar hier is een risico — hoe groter ons "fysieke" volume van elke afzonderlijke opname, hoe "breder" de index wordt, omdat we meer gegevenspagina's moeten dekken.
Sectie voor de wijzigingen:
heap  = 37GB (39%)
TOAST = 54GB (57%)
PK    =  4GB ( 4%)
Sectie na de wijzigingen:
heap  = 37GB (67%)
TOAST = 16GB (29%)
PK    =  2GB ( 4%)
In feite schrijven we nu 2 keer minder naar TOAST., wat niet alleen de schijf, maar ook de CPU ontlastte:
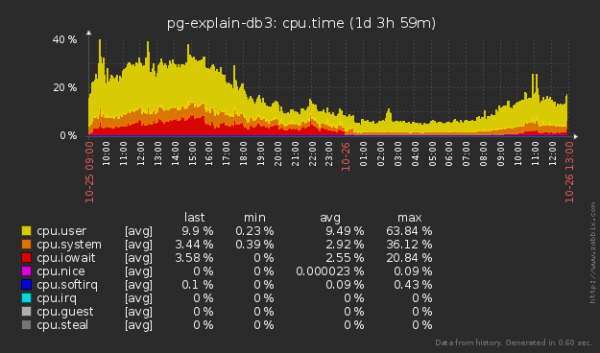
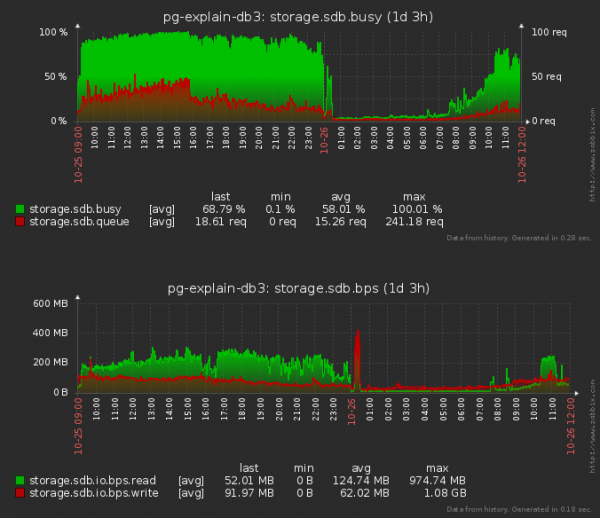
Ik merk op dat we de schijf niet alleen minder 'schrijven', maar ook minder 'lezen' — omdat we bij het invoegen van een record in een bepaalde tabel ook een deel van de boom van elke index moeten 'lezen' om de toekomstige positie daarin te bepalen.
Wie goed kan leven met PostgreSQL 11
Na de update naar PG11 besloten we verder te gaan met het 'tunen' van TOAST en merkten we op dat vanaf deze versie een instelparameter beschikbaar is geworden: :
De TOAST-verwerkingscode wordt alleen geactiveerd wanneer de waarde van de rij die in de tabel moet worden opgeslagen groter is dan TOAST_TUPLE_THRESHOLD bytes (meestal 2 KB). De TOAST-code zal waarden van velden comprimeren en/of buiten de tabel plaatsen totdat de rijwaarde kleiner wordt dan TOAST_TUPLE_TARGET bytes (een variabele die meestal ook 2 KB is) of het impossible is om het volume te verkleinen.
We besloten dat onze gegevens meestal ofwel 'heel kort' zijn ofwel 'heel lang', dus we besloten ons te beperken tot de minimaal mogelijke waarde:
ALTER TABLE rawplan_orig SET (toast_tuple_target = 128);Laten we eens kijken hoe de nieuwe instellingen de schijfbelasting na de herconfiguratie hebben beïnvloed:
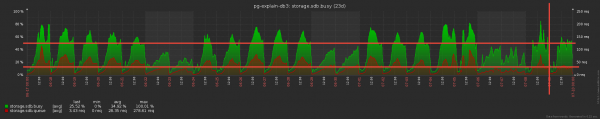
Niet slecht! De gemiddelde wachtrij naar de schijf is ongeveer 1,5 keer verkort, en de 'bezetting' van de schijf is met 20% afgenomen! Maar heeft dit misschien ook invloed gehad op de CPU?
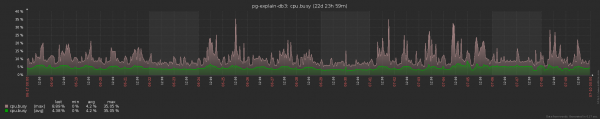
In ieder geval is het zeker niet slechter geworden. Hoewel het moeilijk te beoordelen is, als zelfs dergelijke volumes de gemiddelde CPU-belasting niet hoger kunnen krijgen dan 5%.
Bij het wisselen van de termen verandert de som…
Zoals bekend bespaart een cent een roebel, en met onze opslagvolume van ongeveer 10TB/maand kan zelfs een kleine optimalisatie een goed resultaat opleveren. Daarom hebben we aandacht besteed aan de fysieke structuur van onze gegevens — namelijk hoe precies 'de velden zijn binnen een record ingepakt' in elk van de tabellen.
Omdat door dit direct :
Veel architecturen vereisen uitlijning van gegevens naar de grenzen van woordlengtes. Bijvoorbeeld, op een 32-bits x86-systeem worden gehele getallen (type integer, 4 bytes) uitgelijnd op een 4-byte woordgrens, net als zwevende getallen met dubbele precisie (type double precision, 8 bytes). En op een 64-bits systeem worden double-waarden uitgelijnd op een 8-byte woordgrens. Dit is nog een reden voor incompatibiliteit.
Door de uitlijning hangt de grootte van de tabelrij af van de volgorde van de velden. Gewoonlijk is dit effect niet sterk merkbaar, maar in sommige gevallen kan het leiden tot een aanzienlijke toename van de grootte. Bijvoorbeeld, als je velden van de types char(1) en integer door elkaar plaatst, zullen er tussen hen meestal 3 bytes verloren gaan.
Laten we beginnen met synthetische modellen:
SELECT pg_column_size(ROW(
  '0000-0000-0000-0000-0000-0000-0000-0000'::uuid
, 0::smallint
, '2019-01-01'::date
));
-- 48 bytes

SELECT pg_column_size(ROW(
  '2019-01-01'::date
, '0000-0000-0000-0000-0000-0000-0000-0000'::uuid
, 0::smallint
));
-- 46 bytes
Waar zijn de extra bytes in het eerste geval vandaan gekomen? Heel eenvoudig — de 2-byte smallint is uitgelijnd op een 4-byte grens voor het volgende veld, en wanneer het laatste is, is er niets uit te lijnen en ook geen reden.
In theorie is alles goed en kunnen we de velden naar believen verplaatsen. Laten we dit testen met echte gegevens aan de hand van een van de tabellen, waarvan het dagelijkse sectie 10-15GB groot is.
Oorspronkelijke structuur:
CREATE TABLE public.plan_20190220
(
-- Geërfd van tabel plan:  pack uuid NOT NULL,
-- Geërfd van tabel plan:  recno smallint NOT NULL,
-- Geërfd van tabel plan:  host uuid,
-- Geërfd van tabel plan:  ts timestamp with time zone,
-- Geërfd van tabel plan:  exectime numeric(32,3),
-- Geërfd van tabel plan:  duration numeric(32,3),
-- Geërfd van tabel plan:  bufint bigint,
-- Geërfd van tabel plan:  bufmem bigint,
-- Geërfd van tabel plan:  bufdsk bigint,
-- Geërfd van tabel plan:  apn uuid,
-- Geërfd van tabel plan:  ptr uuid,
-- Geërfd van tabel plan:  dt date,
  CONSTRAINT plan_20190220_pkey PRIMARY KEY (pack, recno),
  CONSTRAINT chck_ptr CHECK (ptr IS NOT NULL),
  CONSTRAINT plan_20190220_dt_check CHECK (dt = '2019-02-20'::date)
)
INHERITS (public.plan)
Sectie na het veranderen van de volgorde van de kolommen — precies dezelfde velden, alleen in een andere volgorde:
CREATE TABLE public.plan_20190221
(
-- Geërfd van tabel plan:  dt date NOT NULL,
-- Geërfd van tabel plan:  ts timestamp with time zone,
-- Geërfd van tabel plan:  pack uuid NOT NULL,
-- Geërfd van tabel plan:  recno smallint NOT NULL,
-- Geërfd van tabel plan:  host uuid,
-- Geërfd van tabel plan:  apn uuid,
-- Geërfd van tabel plan:  ptr uuid,
-- Geërfd van tabel plan:  bufint bigint,
-- Geërfd van tabel plan:  bufmem bigint,
-- Geërfd van tabel plan:  bufdsk bigint,
-- Geërfd van tabel plan:  exectime numeric(32,3),
-- Geërfd van tabel plan:  duration numeric(32,3),
  CONSTRAINT plan_20190221_pkey PRIMARY KEY (pack, recno),
  CONSTRAINT chck_ptr CHECK (ptr IS NOT NULL),
  CONSTRAINT plan_20190221_dt_check CHECK (dt = '2019-02-21'::date)
)
INHERITS (public.plan)
De totale omvang van de sectie wordt bepaald door het aantal 'feiten' en is alleen afhankelijk van externe processen, daarom delen we de grootte van de heap (pg_relation_size) voor het aantal records erin — dus we krijgen de gemiddelde grootte van een echte opgeslagen record:
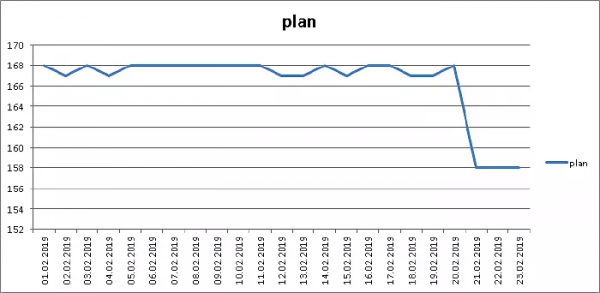
Min 6% volume, uitstekend!
Maar het is natuurlijk niet allemaal zo rooskleurig — want kunnen we de volgorde van de velden in de indexen niet veranderen, en daarom ‘in het algemeen’ (pg_total_relation_size)…
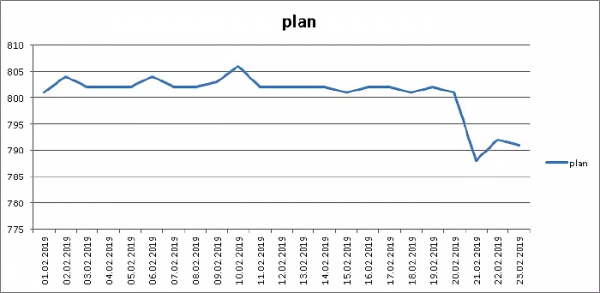
… toch ook hier hebben we 1,5% bespaard, zonder zelfs maar een regel code te veranderen. Inderdaad!
Ik merk op dat de bovenstaande variant van veldindeling — niet per se de meest optimale is. Omdat sommige blokken velden willen we uit esthetische overwegingen niet ‘scheuren’ — bijvoorbeeld een paar (pack, recno), dat de PK vormt voor deze tabel.
Over het geheel genomen is het bepalen van de ‘minimale’ veldindeling een relatief eenvoudige ‘bruteforce’ taak. Daarom kunt u met uw eigen gegevens zelfs betere resultaten behalen dan wij — probeer het eens!
Bron: habr.com
