

Het materiaal van dit artikel is afkomstig van mijn .
Mechanisme voor het verplaatsen van gegevens
- Gegevensblok dblk_t
- Bericht mblk_t
- Functies voor het werken met berichten mblk_t
- Wachtrij queue_t
- Functies voor het werken met wachtrijen queue_t
- Verbinding van filters
- Signaalpunt in de gegevensverwerkingsgrafiek
- Achtergrondactiviteiten van de ticker
- Buffer (MSBufferizer)
- Functies voor het werken met MSBufferizer
In het verleden Wij hebben onze eigen filter ontwikkeld. Dit artikel is gewijd aan de opzet van het interne mechanisme voor het verplaatsen van gegevens tussen de filters van de mediastreamer. Dit zal in de toekomst het mogelijk maken om geavanceerdere filters te schrijven met minder inspanning.
Mechanisme voor het verplaatsen van gegevens
Het verplaatsen van gegevens in de mediastreamer gebeurt met behulp van wachtrijen die worden beschreven door de structuur queue_t. Door de wachtrijen worden reeksen berichten van het type mblk_t, die zelf geen signaalgegevens bevatten, maar alleen verwijzingen naar het vorige, volgende bericht en naar het gegevensblok. Daarnaast wil ik speciaal benadrukken dat er ook een veld is voor een verwijzing naar een bericht van hetzelfde type, waarmee een enkelvoudige linklijst van berichten kan worden georganiseerd. De groep berichten die door deze lijst zijn verbonden, noemen we een tuple. Op deze manier kan elk element van de wachtrij een enkel bericht zijn mblk_t, maar kan ook de kop van de tuple van berichten zijn mblk_t. Elk bericht van de tuple kan zijn eigen ondergeschikt gegevensblok hebben. Waarom tuples nodig zijn, zullen we wat later bespreken.
Zoals eerder vermeld, bevat het bericht zelf geen gegevensblok, in plaats daarvan bevat het alleen een aanwijzer naar het geheugen waar het blok is opgeslagen. Op dit punt komt het algemene beeld van de werking van de mediastreamer overeen met een magazijn van deuren uit de tekenfilm 'Monsters, Inc.', waar de deuren (verwijzingen naar gegevens — kamers) met waanzinnige snelheid over hangende transportbanden bewegen, terwijl de kamers zelf stil blijven staan.
Laten we nu, terwijl we de hiërarchie van onder naar boven doorlopen, de vermelde entiteiten van het gegevensoverdrachtsmechanisme in de mediastreamer gedetailleerd bekijken.
Gegevensblok dblk_t
Het gegevensblok bestaat uit een header en een gegevensbuffer. De header wordt beschreven door de volgende structuur,
typedef struct datab
{
unsigned char *db_base; // Aanwijzer naar het begin van de gegevensbuffer.
unsigned char *db_lim;  // Aanwijzer naar het einde van de gegevensbuffer.
void (*db_freefn)(void*); // Vrijgavefunctie voor geheugen bij verwijdering van het blok.
int db_ref; // Referentieteller.
} dblk_t;
De structuurvelden bevatten aanwijzingen voor het begin van de buffer, het einde van de buffer en een functie om de gegevensbuffer te verwijderen. Het laatste element in de header db_ref is een referentieteller; wanneer deze nul bereikt, dient dit als een signaal om het betreffende blok uit het geheugen te verwijderen. Als het gegevensblok is aangemaakt met de functie datab_alloc() , dan wordt de gegevensbuffer direct achter de header in het geheugen geplaatst. In alle andere gevallen kan de buffer ergens apart liggen. In de gegevensbuffer bevinden zich signaalmetingen of andere gegevens die we willen verwerken met filters.
Een nieuw exemplaar van een gegevensblok wordt gemaakt met de functie:
dblk_t *datab_alloc(int size);De grootte van de gegevens die het blok zal opslaan, wordt als invoerparameter doorgegeven. Er wordt meer geheugen toegewezen zodat in het begin van het toegewezen geheugen de header — de structuur datab. Maar dit is niet altijd het geval wanneer andere functies worden gebruikt; in sommige gevallen kan de gegevensbuffer apart van de header van het gegevensblok liggen. De velden van de structuur worden zodanig ingesteld dat het veld db_base verwijst naar het begin van het gegevensgebied, en db_lim verwijst naar het einde ervan. De referentieteller db_ref wordt ingesteld op één. De aanwijzer voor de functie om gegevens te wissen wordt op nul ingesteld.
Bericht mblk_t
Zoals eerder vermeld, hebben de elementen van de wachtrij het type mblk_t, dat als volgt is gedefinieerd:
typedef struct msgb
{
  struct msgb *b_prev;   // Aanwijzer naar het vorige element in de lijst.
  struct msgb *b_next;   // Aanwijzer naar het volgende element in de lijst.
  struct msgb *b_cont;   // Aanwijzer voor het onderbrengen van andere berichten aan een bericht, om een tuple van berichten te creëren.
  struct datab *b_datap; // Aanwijzer naar de structuur van het gegevensblok.
  unsigned char *b_rptr; // Aanwijzer naar het begin van het gegevensgebied voor het lezen van de gegevens van de buffer b_datap.
  unsigned char *b_wptr; // Aanwijzer naar het begin van het gegevensgebied voor het schrijven van de gegevens van de buffer b_datap.
  uint32_t reserved1;    // Gereserveerd veld1, de mediaspeler plaatst daar service-informatie.
  uint32_t reserved2;    // Gereserveerd veld2, de mediaspeler plaatst daar service-informatie.
  #if defined(ORTP_TIMESTAMP)
  struct timeval timestamp;
  #endif
  ortp_recv_addr_t recv_addr;
} mblk_t;
Structuur mblk_t aan het begin bevinden zich aanwijzers b_prev, b_next, die nodig zijn voor de organisatie van een dubbel gekoppelde lijst (waaruit de wachtrij bestaat). queue_t).
Daarna volgt de aanwijzer b_cont, die alleen wordt gebruikt wanneer het bericht in de tuple komt. Voor het laatste bericht in de tuple blijft deze pointer nul.
Verder zien we een pointer naar het datablok b_datap, waarvoor het bericht bestaat. Daarna volgen pointers naar de gebieden binnen de gegevensbuffer van het blok. Het veld b_rptr geeft de plek aan waaruit gegevens uit de buffer worden gelezen. Het veld b_wptr geeft de plek aan waar de gegevens in de buffer worden geschreven.
De overige velden zijn administratief van aard en hebben geen betrekking op de werking van het datatransfermechanisme.
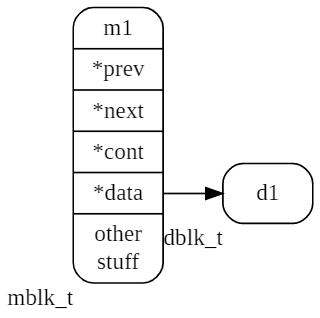
Hieronder ziet u een enkel bericht met de naam m1 en het datablok d1.
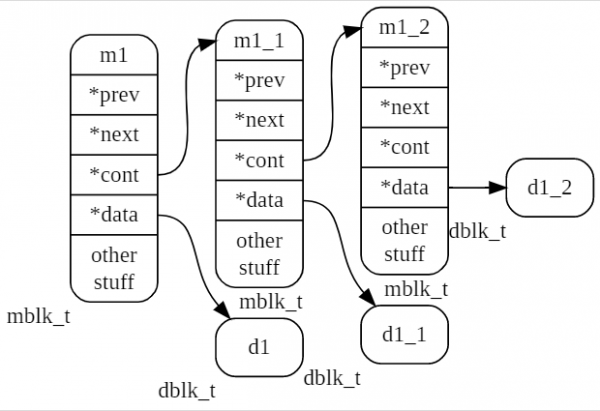
In de volgende afbeelding is een tuple van drie berichten afgebeeld m1, m1_1, m1_2.
Functies voor het werken met berichten mblk_t
Een nieuw bericht mblk_t wordt aangemaakt door de functie:
mblk_t *allocb(int size, int pri); deze plaatst een nieuw bericht in het geheugen mblk_t met een datablok van de gespecificeerde grootte size, de tweede parameter — pri wordt niet gebruikt in de besproken versie van de bibliotheek. Deze moet nul blijven. Tijdens de werking van de functie wordt geheugen toegewezen voor de structuur van het nieuwe bericht en wordt de functie mblk_init(), aangeroepen, die alle velden van de gemaakte structuur instelt op nul en vervolgens, met behulp van het eerder genoemde, datab_alloc()zal een gegevensbuffer creëren. Daarna worden de velden in de structuur ingesteld:
mp->b_datap=datab;
mp->b_rptr=mp->b_wptr=datab->db_base;
mp->b_next=mp->b_prev=mp->b_cont=NULL;
We krijgen een nieuw bericht met geïnitialiseerde velden en een lege gegevensbuffer. Om gegevens aan het bericht toe te voegen, moet je deze naar de buffer van het datablok kopiëren:
memcpy(msg->b_rptr, data, size);waar data — een pointer naar de gegevensbron, en size — hun grootte.
Vervolgens moet je de pointer naar het schrijfpunt bijwerken, zodat deze weer naar het begin van het vrije gebied in de buffer wijst:
msg->b_wptr = msg->b_wptr + sizeAls je een bericht wilt maken uit een al bestaand buffer, zonder te kopiëren, dan gebruik je de functie:
mblk_t *esballoc(uint8_t *buf, int size, int pri, void (*freefn)(void*)); De functie zal na het aanmaken van het bericht en de datablokstructuur de pointers naar de gegevens instellen op het adres buf. Dat wil zeggen, in dit geval bevindt de gegevensbuffer zich niet achter de velden van de datablokheader, zoals bij de creatie van het datablok met de functie. datab_alloc()De aan de functie doorgegeven gegevensbuffer blijft op zijn plaats, maar met behulp van pointers wordt deze verbonden met de net aangemaakte gegevensblokkentitel, die op zijn beurt naar het bericht verwijst.
Aan één bericht mblk_t kunnen meerdere gegevensblokken achtereenvolgens worden bevestigd. Dit gebeurt met de functie:
mblk_t * appendb(mblk_t *mp, const char *data, int size, bool_t pad); mp — het bericht waaraan weer een gegevensblok zal worden toegevoegd;
data — een pointer naar het blok, waarvan een kopie aan het bericht zal worden toegevoegd;
size — de grootte van de gegevens;
pad — een vlag die aangeeft dat de grootte van de toegewezen geheugenruimte moet worden afgestemd op een grens van 4 bytes (aanvulling zal met nullen worden uitgevoerd).
Als er in de bestaande gegevensbuffer van het bericht voldoende ruimte is, worden de nieuwe gegevens achter de al aanwezige gegevens toegevoegd. Als er minder vrije ruimte in de gegevensbuffer van het bericht is dan size, wordt er een nieuw bericht aangemaakt met een voldoende grote buffer en worden de gegevens in zijn buffer gekopieerd. Dit nieuwe bericht wordt met behulp van de pointer b_contaan het origineel gekoppeld. In dit geval verandert het bericht in een tuple.
Als er een extra gegevensblok aan de tuple moet worden toegevoegd, moet de functie worden gebruikt:
void msgappend(mblk_t *mp, const char *data, int size, bool_t pad);deze zal het laatste bericht in de tuple zoeken (het zal b_cont nul zijn) en voor dit bericht de functie appendb() aanroepen..
De grootte van de gegevens in het bericht of de tuple kan worden bepaald met de functie:
int msgdsize(const mblk_t *mp);deze zal door alle berichten van de tuple lopen en de totale hoeveelheid gegevens in de gegevensbuffers van deze berichten retourneren. Voor elk bericht wordt de hoeveelheid gegevens als volgt berekend:
mp->b_wptr - mp->b_rptrOm twee tuples te combineren, wordt de functie toegepast:
mblk_t *concatb(mblk_t *mp, mblk_t *newm);deze voegt de tuple newm aan de achterkant van de tuple mp toe en retourneert een pointer naar het laatste bericht van de resulterende tuple.
Indien nodig kan de tuple worden omgezet in één bericht met één gegevensblok; dit gebeurt met de functie:
void msgpullup(mblk_t *mp,int len);als het argument len gelijk is aan -1, dan wordt de grootte van de toegewezen buffer automatisch bepaald. Als len Als het een positief getal is, wordt er een buffer van deze grootte aangemaakt en worden de gegevens van de berichten uit de tuple hierin gekopieerd. Als de buffer vol is, wordt het kopiëren stopgezet. Het eerste bericht van de tuple ontvangt een buffer van de nieuwe grootte met de gekopieerde gegevens. De overige berichten worden verwijderd en het geheugen wordt teruggegeven aan de heap.
Bij het verwijderen van de structuur mblk_t wordt de referentieteller van het gegevensblok in overweging genomen, als deze bij de aanroep freeb() nul blijkt te zijn, wordt de gegevensbuffer samen met het exemplaar verwijderd mblk_t, waarnaar het verwijst.
Initiëren van de velden van het nieuwe bericht:
void mblk_init(mblk_t *mp);Een extra hoeveelheid gegevens aan het bericht toevoegen:
mblk_t * appendb(mblk_t *mp, const char *data, size_t size, bool_t pad);Als de nieuwe gegevens niet passen in de vrije ruimte van de gegevensbuffer van het bericht, wordt er een apart gemaakt bericht met de benodigde bufferomvang aan het bericht toegevoegd (in het eerste bericht wordt een verwijzing naar het toegevoegde bericht ingesteld); het bericht verandert in een tuple.
Een hoeveelheid gegevens aan de tuple toevoegen:
void msgappend(mblk_t *mp, const char *data, size_t size, bool_t pad); De functie roept appendb() in een lus aan.
Twee tuples samenvoegen tot één:
mblk_t *concatb(mblk_t *mp, mblk_t *newm);Bericht newm wordt toegevoegd aan mp.
Een kopie van een enkel bericht maken:
mblk_t *copyb(const mblk_t *mp);Een volledige kopie van de tuple met al zijn gegevensblokken:
mblk_t *copymsg(const mblk_t *mp);De elementen van de tuple worden bij deze gekopieerd door de functie copyb().
Een lichte kopie van het bericht maken mblk_t. Hierbij wordt het gegevensblok niet gekopieerd, maar wordt de referentieteller verhoogd db_ref:
mblk_t *dupb(mblk_t *mp);Een lichte kopie van de tuple maken. Gegevensblokken worden niet gekopieerd, alleen hun referentietellers worden verhoogd db_ref:
mblk_t *dupmsg(mblk_t* m);Alle berichten van de tuple samenvoegen tot één bericht:
void msgpullup(mblk_t *mp,size_t len);Als het argument len gelijk is aan -1, wordt de grootte van de te reserveren buffer automatisch bepaald.
Een bericht, tuple verwijderen:
void freemsg(mblk_t *mp);De referentieteller van het gegevensblok wordt met één verlaagd. Als deze nul bereikt, wordt het gegevensblok ook verwijderd.
Het totale volume van gegevens in een bericht of tuple tellen.
size_t msgdsize(const mblk_t *mp);Een bericht uit de staart van de wachtrij halen:
mblk_t *ms_queue_peek_last (q);De inhoud van de gereserveerde velden van het ene bericht naar het andere berichten kopiëren (in feite bevinden zich in deze velden vlaggen die door de mediastreamer worden gebruikt):
mblk_meta_copy(const mblk_t *source, mblk *dest);Wachtrij queue_t
De berichtenwachtrij in de mediastreamer is geïmplementeerd als een ringdoubly linked list. Elk element van de lijst bevat een pointer naar een gegevensblok met signalen. Dit betekent dat alleen de pointers naar de gegevensblokken verplaatst worden, terwijl de gegevens zelf onbeweeglijk blijven. Met andere woorden, alleen de verwijzingen naar deze gegevens worden verplaatst.
Structuur die de wachtrij beschrijft queue_t, hieronder weergegeven:
typedef struct _queue
{
   mblk_t _q_stopper; /* "Lege" element in de wachtrij, wijst niet naar gegevens, alleen gebruikt voor het beheren van de wachtrij. Bij het initialiseren van de wachtrij (qinit()) worden de pointers zo ingesteld dat ze naar zichzelf wijzen. */
   int q_mcount;        // Aantal elementen in de wachtrij.
} queue_t;
De structuur bevat een veld - pointer _q_stopper van het type *mblk_t, dat wijst naar het eerste element (bericht) in de wachtrij. Het tweede veld van de structuur is een teller van de berichten in de wachtrij.
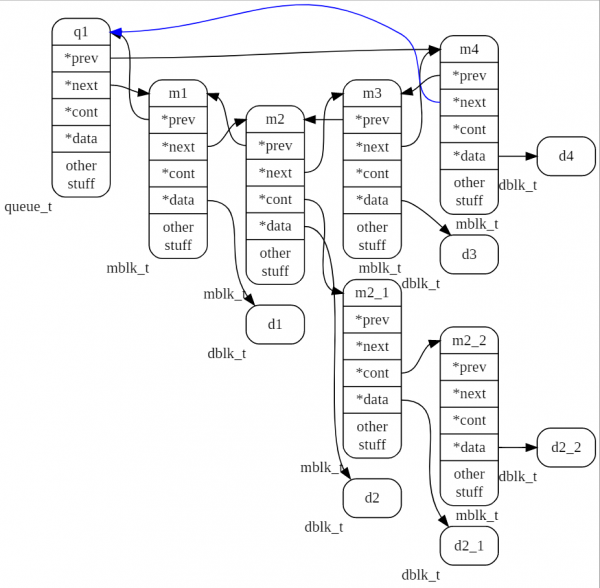
In de onderstaande afbeelding is de wachtrij met de naam q1 te zien, die 4 berichten m1, m2, m3, m4 bevat.
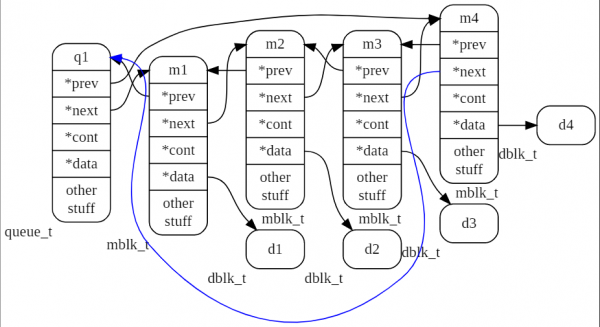
In de volgende afbeelding is de wachtrij met de naam q1 te zien, die 4 berichten m1, m2, m3, m4 bevat. Bericht m2 is de kop van het tuple, waarvan twee andere berichten m2_1 en m2_2 worden geleid.
Functies voor het werken met wachtrijen queue_t
Initialisatie van de wachtrij:
void qinit(queue_t *q);Veld _q_stopper (verder zullen we het "stopper" noemen) en wordt geïnitialiseerd door de functie mblk_init(), zijn pointer naar het voorgaande element en het volgende element worden zo ingesteld dat ze naar zichzelf verwijzen. De teller van de elementen in de wachtrij wordt op nul gezet.
Toevoegen van een nieuw element (bericht):
void putq(queue_t *q, mblk_t *m);Een nieuw element m wordt aan het einde van de lijst toegevoegd, de pointers van het element worden zo ingesteld dat de stopper het volgende element voor hem wordt, en hij voor de stopper het vorige. De teller van de elementen in de wachtrij wordt verhoogd.
Verwijderen van een element uit de wachtrij:
mblk_t * getq(queue_t *q); het bericht dat achter de stopper staat wordt verwijderd, de teller van de elementen wordt verlaagd. Als er geen elementen in de wachtrij zijn, behalve de stopper, wordt 0 geretourneerd.
Invoegen van een bericht in de wachtrij:
void insq(queue_t *q, mblk_t *emp, mblk_t *mp); Element mp wordt voor het element emp. Als emp=0, dan wordt het bericht aan het einde van de wachtrij toegevoegd.
Verwijderen van een bericht uit de kop van de wachtrij:
void remq(queue_t *q, mblk_t *mp); De teller van de elementen wordt verlaagd.
Lezen van de pointer naar het eerste element in de wachtrij:
mblk_t * peekq(queue_t *q); Verwijderen van alle elementen uit de wachtrij met verwijdering van de elementen zelf:
void flushq(queue_t *q, int how);Het argument hoe wordt niet gebruikt. De teller van de wachtrij-elementen wordt op nul gezet.
Macro voor het lezen van de aanwijzer naar het laatste element in de wachtrij:
mblk_t * qlast(queue_t *q);Bij het werken met berichtenwachtrijen moet in gedachten worden gehouden dat bij het aanroepen van ms_queue_put(q, m) met een nulpointer naar een bericht, de functie in een loop vastloopt. Uw programma zal bevroren zijn. Op dezelfde manier gedraagt zich ms_queue_next(q, m).
Verbinding van filters
De hierboven beschreven wachtrij wordt gebruikt voor het verzenden van berichten van de ene filter naar de andere of van de ene naar meerdere filters. Filters en hun verbindingen vormen een gerichte graaf. De ingang of uitgang van een filter zal worden aangeduid met het algemene woord "pin". Voor het beschrijven van de volgorde waarin filters zijn verbonden, wordt in de mediastreamer het begrip "signaalpunt" gebruikt. Een signaalpunt is een structuur _MSCPoint, die een aanwijzer naar de filter bevat en het nummer van een van zijn pinnen, waardoor het de verbinding tussen een van de ingangen of uitgangen van de filter beschrijft.
Signaalpunt in de gegevensverwerkingsgrafiek
typedef struct _MSCPoint{
struct _MSFilter *filter; // Aanwijzer naar de mediastreamer-filter.
int pin;                        // Het nummer van een van de ingangen of uitgangen van de filter, dus de pin.
} MSCPoint;
De pinnen van de filters worden genummerd vanaf nul.
De verbinding van twee pinnen met een berichtenwachtrij wordt beschreven door de structuur _MSQueue, die de berichtenwachtrij en aanwijzers naar twee signaalpunten bevat, die het verbindt:
typedef struct _MSQueue
{
queue_t q;
MSCPoint prev;
MSCPoint next;
}MSQueue;
Laten we deze structuur een signaalverbinding noemen. Elke mediastreamer-filter bevat een tabel van inkomende koppelingen en een tabel van uitgaande koppelingen (MSQueue). De grootte van de tabellen wordt vastgesteld bij het creëren van de filter, wat we al deden met behulp van de geëxporteerde variabele van het type MSFilterDesc, toen we onze eigen filter ontwikkelden. Hieronder staat de structuur die elke filter in de mediastreamer beschrijft, MSFilter:
struct _MSFilter{
    MSFilterDesc *desc;
    /* Pointer to the filter descriptor. */
    /* Protected attributes, they cannot be moved or removed, otherwise plugin operation will be disrupted. */
    ms_mutex_t lock;      /* Semaphore. */
    MSQueue **inputs;     /* Table of input links. */
    MSQueue **outputs;    /* Table of output links. */
    struct _MSFactory *factory; /* Pointer to the factory that created this filter instance. */
    void *padding;              /* Not used, will be utilized if protected fields are added. */
    void *data;                 /* Pointer to an arbitrary structure for storing the internal state data of the filter and intermediate computations. */
    struct _MSTicker *ticker;   /* Pointer to the ticker object, which must not be null when the process() function is called. */
    /* private attributes, they can be moved and changed at any time */
    MSList *notify_callbacks; /* List of callbacks used for processing filter events. */
    uint32_t last_tick;       /* The number of the last tick when the process() was called. */
    MSFilterStats *stats;     /* Filter operation statistics. */
    int postponed_task; /* Number of postponed tasks. Some filters may postpone data processing (calling process()) for several ticks. */
    bool_t seen;  /* Flag used by the ticker to mark that it has already serviced this filter instance during this tick. */
};
typedef struct _MSFilter MSFilter;
Nadat we de filters in ons C-programma hebben verbonden volgens ons ontwerp (maar de ticker niet hebben aangesloten), hebben we daarmee een gerichte grafiek gecreëerd, waarvan de knooppunten instanties van de structuur zijn MSFilter, en de randen zijn instanties van links MSQueue.
Achtergrondactiviteiten van de ticker
Toen ik je zei dat de ticker een bronfilter voor tikken is, was dat niet de hele waarheid over hem. De ticker is een object dat vanuit de klok functies uitvoert process() van alle filters in het schema (de grafiek) waaraan hij is aangesloten. Wanneer we in het C-programma de ticker aansluiten op de filter van de grafiek, geven we de ticker de grafiek aan, die hij vanaf dat moment zal beheren, totdat we hem loskoppelen. Na de aansluiting begint de ticker het aan hem toegewezen grafiek te inspecteren, en stelt hij een lijst van de filters samen die daarin zijn opgenomen. Om te voorkomen dat hij dezelfde filter twee keer "telt", markeert hij de ontdekte filters door een teken seen. De zoektocht wordt uitgevoerd via de tabellen van de links die elke filter heeft.
Tijdens zijn introductietour controleert de ticker of er onder de filters ten minste één is die fungeert als bron van gegevensblokken. Als er geen is, wordt de grafiek als ongeldig beschouwd en stopt de ticker met de uitvoering.
Als de grafiek "geldig" blijkt te zijn, wordt voor elke gevonden filter de initialisatiefunctie aangeroepen preprocess(). Zodra het tijd is voor de volgende verwerkingscyclus (standaard om de 10 milliseconden), roept de ticker de functie aan process() voor alle eerder gevonden bronfilters en daarna voor de overige filters in de lijst. Als de filter inkomende links heeft, wordt de functie process() herhaald totdat de wachtrijen van inkomende links leeg zijn. Daarna gaat hij naar de volgende filter in de lijst en "draait" deze door de inkomende links van berichten te ontdoen. De ticker gaat van filter naar filter totdat de lijst is afgelopen. Op dit moment eindigt de verwerkingscyclus.
Laten we nu terugkeren naar de tuples en bespreken waarom zo'n entiteit aan de media-streamer is toegevoegd. In het algemeen komt de hoeveelheid gegevens die nodig is voor de algoritme dat in de filter draait, niet overeen met en is niet een veelvoud van de grootte van de gegevensbuffers die binnenkomen. Stel dat we een filter schrijven dat snelle Fourier-transformaties uitvoert, welke per definitie alleen blokken gegevens kan verwerken waarvan de grootte een macht van twee is. Laten we zeggen dat dit 512 steekproeven is. Als de gegevens via een telefoonkanaal worden gegenereerd, komt de gegevensbuffer van elk bericht bij de ingang met 160 steekproeven van het signaal. Er is de verleiding om geen gegevens van de invoer te halen totdat er een benodigde hoeveelheid gegevens is. Maar in dit geval ontstaat er een conflict met de ticker, die vergeefs zal proberen de filter te draaien totdat de inkomende link is geleegd. Eerder hebben we deze regel aangeduid als de derde principe van de filterwerking. Volgens dit principe moet de functie process() van de filter alle gegevens uit de invoerwachtrijen ophalen.
Daarnaast kunnen er vanaf de invoer niet meer dan 512 metingen worden opgehaald, omdat deze alleen in hele blokken kunnen worden verzameld, dat wil zeggen dat de filter 640 metingen moet ophalen en 512 daarvan gebruiken, met de rest tot de accumulatie van een nieuwe gegevensbatch. Zo moet onze filter, naast zijn hoofdfunctie, ook ondersteunende acties voor de tussentijdse opslag van de invoergegevens bieden. De ontwikkelaars van de mediastreamer hebben hiervoor een speciaal object ontwikkeld - MSBufferizer (buffer), dat deze taak oplost met behulp van tuples.
Buffer (MSBufferizer)
Dit is een object dat de invoergegevens binnen de filter accumuleert en begint deze te verwerken zodra de hoeveelheid informatie voldoende is om het filteralgoritme uit te voeren. Terwijl de buffer gegevens verzamelt, werkt de filter in een idle-modus en verbruikt geen rekenkracht van de processor. Maar zodra de leesfunctie van de buffer een waarde teruggeeft die verschillend is van nul, begint de functie process() van de filter de gegevens in de juiste hoeveelheden uit de buffer te halen en te verwerken tot deze uitgeput zijn.
De nog niet gebruikte gegevens blijven in de buffer als het eerste element van de tuple, waaraan de volgende blokken invoergegevens worden toegevoegd.
De structuur die de buffer beschrijft:
struct _MSBufferizer{
queue_t q; /* Berichtqueue. */
int size; /* Totale grootte van de gegevens in de buffer op dit moment. */
};
typedef struct _MSBufferizer MSBufferizer;
Functies voor het werken met MSBufferizer
Een nieuw exemplaar van de buffer aanmaken:
MSBufferizer * ms_bufferizer_new(void);Geheugen wordt toegewezen en geïnitieerd in ms_bufferizer_init() en retourneert een pointer.
De initialisatiefunctie:
void ms_bufferizer_init(MSBufferizer *obj); De queue q, veld size wordt ingesteld op nul.
Bericht toevoegen:
void ms_bufferizer_put(MSBufferizer *obj, mblk_t *m); Bericht m wordt toegevoegd aan de queue. De berekende grootte van de gegevensblokken wordt opgeteld bij size.
Overbrengen naar de buffer van alle berichten in de gegevensqueue van de link q:
void ms_bufferizer_put_from_queue(MSBufferizer *obj, MSQueue *q); Berichten overbrengen van de link q naar de buffer gebeurt met behulp van de functie ms_bufferizer_put().
Lezen uit de buffer:
int ms_bufferizer_read(MSBufferizer *obj, uint8_t *data, int datalen); Als de grootte van de gegevens die in de buffer zijn verzameld kleiner is dan het aangevraagde (datalen), de functie retourneert nul, gegevenskopie naar data wordt niet uitgevoerd. Anders wordt er een sequentiële kopie van gegevens uit de tuples in de buffer uitgevoerd. Na het kopiëren wordt de tuple verwijderd en wordt het geheugen vrijgegeven. Het kopiëren stopt wanneer datalen bytes zijn gekopieerd. Als de ruimte halverwege een gegevensblok opraakt, wordt in dit bericht het gegevensblok ingekort tot het resterende niet-gekopieerde deel. Bij de volgende aanroep gaat het kopiëren verder vanaf deze locatie.
Lezen van de hoeveelheid gegevens die op dit moment beschikbaar zijn in de buffer:
int ms_bufferizer_get_avail(MSBufferizer *obj); Geeft het veld terug size van de buffer.
Overslaan van een deel van de gegevens in de buffer:
void ms_bufferizer_skip_bytes(MSBufferizer *obj, int bytes);Het opgegeven aantal bytes gegevens wordt geëxtraheerd en overgeslagen. De oudste gegevens worden overgeslagen.
Verwijderen van alle berichten die in de buffer zitten:
void ms_bufferizer_flush(MSBufferizer *obj); De gegevens teller wordt op nul gereset.
Verwijderen van alle berichten die in de buffer zitten:
void ms_bufferizer_uninit(MSBufferizer *obj); Het resetten van de teller wordt niet uitgevoerd.
Verwijderen van de buffer en vrijgeven van het geheugen:
void ms_bufferizer_destroy(MSBufferizer *obj); Voorbeelden van het gebruik van de buffer zijn te vinden in de broncode van verschillende mediastreamerfilters. Bijvoorbeeld in de filter MS_L16_ENC, die de bytevolgorde in netwerkomgevingen omzet naar de hostvolgorde:
In het volgende artikel zullen we de vraag bespreken over de belastingsevaluatie voor de ticker en manieren om overmatige rekenbelasting in de mediastreamer te bestrijden.
Bron: habr.com
