

Ik nodig u uit om het verslag van de presentatie van begin 2016 van Vladimir Sitnikov "PostgreSQL en JDBC - we persen alles eruit" te bekijken
Goedemiddag! Mijn naam is Vladimir Sitnikov. Ik werk al 10 jaar bij NetCracker. En ik ben voornamelijk bezig met prestaties. Alles wat met Java en SQL te maken heeft – dat is waar ik van hou.
En vandaag zal ik vertellen over de uitdagingen die we in het bedrijf tegenkwamen toen we PostgreSQL begonnen te gebruiken als databas server. En we werken voornamelijk met Java. Maar wat ik vandaag zal vertellen, is niet alleen gerelateerd aan Java. Zoals de praktijk heeft aangetoond, komt dit ook voor in andere talen.
We zullen bespreken:
- het ophalen van gegevens.
- het opslaan van gegevens.
- en ook de prestaties.
- En over de valkuilen die daar verborgen zijn.
Laten we beginnen met een simpele vraag. We selecteren één rij uit de tabel op basis van de primaire sleutel.
De database bevindt zich op dezelfde host. En dit hele proces kost 20 milliseconden.
Die 20 milliseconden zijn echt veel. Als je 100 van zulke verzoeken hebt, verlies je tijd in seconden om deze verzoeken te verwerken, d.w.z. je verspilt tijd.
We houden er niet van om dat te doen en kijken wat de database ons hiervoor biedt. De database biedt ons twee opties voor query-uitvoering.
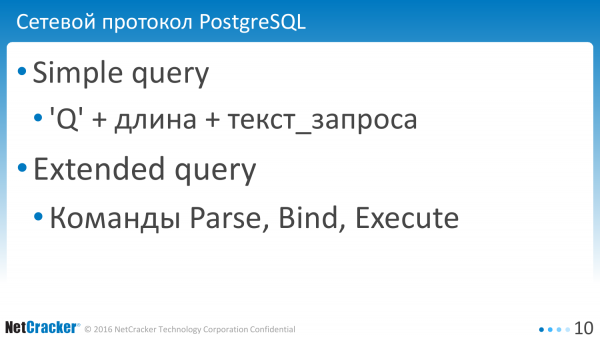
De eerste optie is een eenvoudige query. Wat is het voordeel ervan? Je neemt het en stuurt het gewoon op, en verder niets.
De database heeft ook een uitgebreide query, die geavanceerder maar functioneler is. Je kunt afzonderlijk aanvragen voor parsing, uitvoering, associatie van variabelen, enz.
Super uitgebreide query – dat is iets wat we in deze presentatie niet zullen behandelen. Misschien willen we iets van de database, en er is een lijst met wensen, die op een bepaalde manier is opgesteld, dat wil zeggen, dat is wat we willen, maar het is nu en in het komende jaar niet mogelijk. Daarom hebben we het gewoon opgeschreven en zullen we de belangrijkste mensen hierover onder druk zetten.
Wat we kunnen doen, is de simple query en de extended query.
Wat is het kenmerk van elke benadering?
Een eenvoudige query is goed te gebruiken voor eenmalige uitvoering. Een keer uitgevoerd en vergeten. En het probleem is dat het geen binaire gegevensformaten ondersteunt, d.w.z. voor sommige hoog-performante systemen is het niet geschikt.
Uitgebreide query – helpt om tijd te besparen bij het parseren. Dit is wat we hebben gedaan en begonnen te gebruiken. Het heeft ons enorm geholpen. Er is niet alleen besparing op het parseren. Er is ook besparing op gegevensoverdracht. Gegevens in binaire vorm verzenden is veel efficiënter.
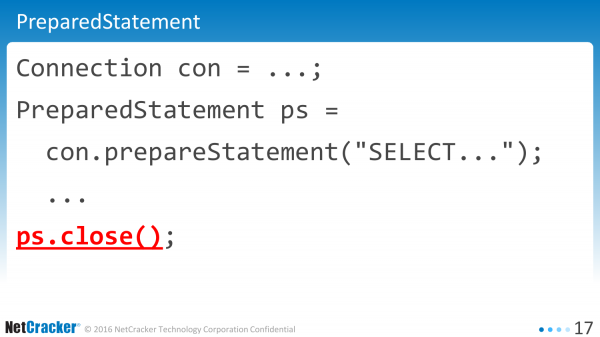
Laten we naar de praktijk gaan. Zo ziet een typisch applicatie eruit. Dit kan Java zijn, enz.
We hebben een statement aangemaakt. Een commando uitgevoerd. Een close gemaakt. Waar is de fout? Wat is het probleem? Er zijn geen problemen. Zo staat het in alle boeken. Zo moet je schrijven. Als je maximale prestaties wilt, schrijf dan zo.
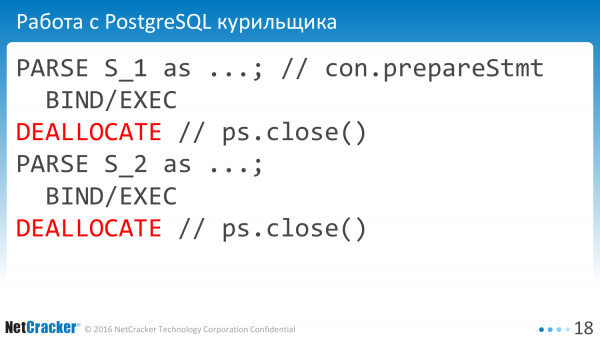
Maar de praktijk heeft aangetoond dat dit niet werkt. Waarom? Omdat we de methode 'close' hebben. En als we het zo doen, is dat vanuit het perspectief van de database als het werk van een roker met de database. We zeiden 'PARSE EXECUTE DEALLOCATE'.
Waarom deze overbodige creaties en uitvoeringen van statements? Ze zijn voor niemand nodig. Maar meestal is het zo met PreparedStatement, dat wanneer we ze sluiten, ze alles in de database sluiten. Dat is niet wat we willen.
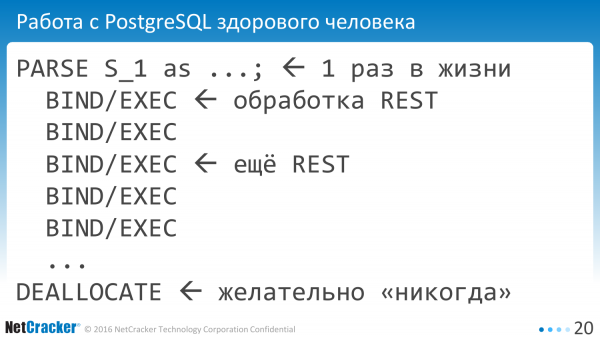
We willen, net als gezonde mensen, met de database werken. Een keer nemen we en bereiden we ons statement voor, en daarna voeren we het veelvuldig uit. Veelvuldig betekent eigenlijk één keer in het hele leven van de applicatie parseren. En bij verschillende REST gebruiken we dezelfde statement id. Dat is ons doel.
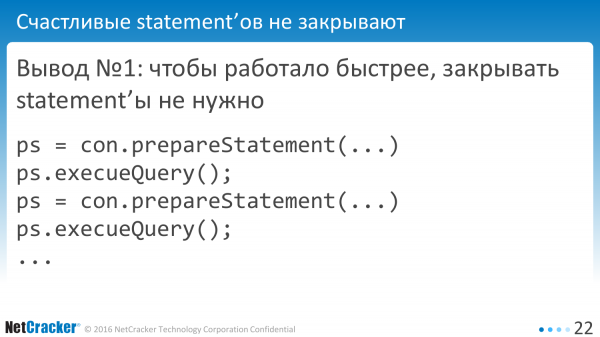
Hoe bereiken we dit?
Heel eenvoudig – we hoeven statements niet te sluiten. We schrijven zo: 'prepare' 'execute'.
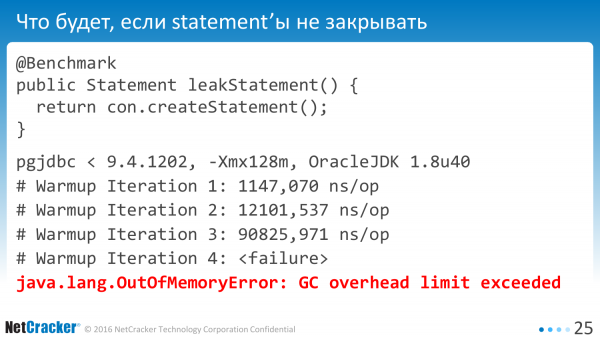
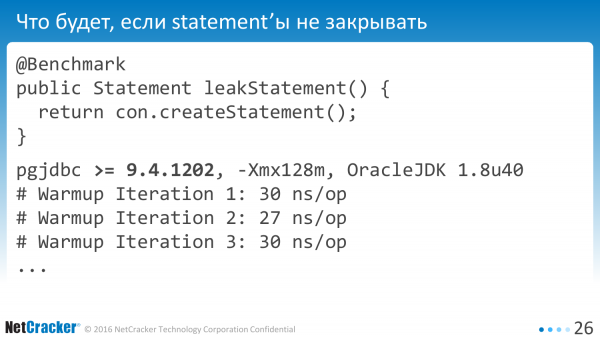
Als we dit draaien, is het duidelijk dat ergens iets volloopt. Als het niet duidelijk is, kunnen we het meten. Laten we een benchmark maken, waarin we zo'n simpele methode hebben. We creëren een statement. We draaien het op een bepaalde versie van de driver en krijgen dat het vrij snel instort met verlies van al het geheugen dat we hebben aangeschaft.
Het is duidelijk dat zulke fouten gemakkelijk te verhelpen zijn. Ik ga er niet verder op in. Maar ik zal zeggen dat het in de nieuwe versie veel sneller werkt. Een onsamenhangende methode, maar desondanks.
Hoe werken we correct? Wat moeten we hiervoor doen?
In de realiteit sluiten applicaties altijd statements. In alle boeken staat dat je ze moet sluiten, anders lekt geheugen.
En PostgreSQL kan geen queries cachen. Elke sessie moet deze cache zelf aanmaken.
En we willen ook geen tijd verspillen aan parseren.
En zoals gewoonlijk hebben we twee opties.
De eerste optie is dat we zeggen laten we alles in PgSQL wikkelen. Daar is een cache. Het cached alles. Het zou geweldig zijn. We hebben dit bekeken. We hebben 100500 aanvragen. Het werkt niet. We zijn het er niet mee eens om handmatig de aanvragen om te zetten in procedures. Nee, nee.
We hebben een tweede optie – zelf aan de slag gaan. We openen de broncode en beginnen te programmeren. We programmeren maar door. Het bleek niet zo moeilijk te zijn om dit te doen.
Dit verscheen in augustus 2015. Nu is er al een modernere versie. En alles is geweldig. Het werkt zo goed dat we niets aan de applicatie veranderen. En we zijn zelfs gestopt met denken aan PgSQL, dat wil zeggen, dit volstond om alle overheadkosten tot vrijwel nul te verlagen.
Bijgevolg wordt Server-prepared statements geactiveerd bij de vijfde uitvoering om geheugen in de database niet te verspillen aan elk eenmalig verzoek.
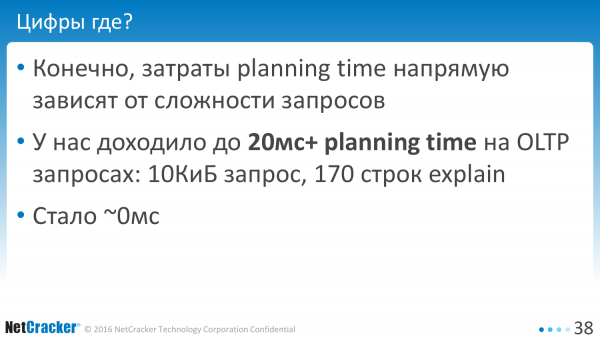
Je kunt vragen – waar zijn de cijfers? Wat krijg je? En hier kan ik geen cijfers geven, omdat elke aanvraag zijn eigen cijfers heeft.
Onze aanvragen waren zodanig dat we op OLTP-aanvragen ongeveer 20 milliseconden besteedden aan parsing. Er was 0,5 milliseconde voor uitvoering, 20 milliseconden voor parsing. Aanvraag – 10 KiB tekst, 170 regels plan. Dit is een OLTP-aanvraag. Het vraagt 1, 5, 10 regels op, soms meer.
Maar we wilden helemaal geen 20 milliseconden besteden. We hebben het teruggebracht naar 0. Alles is geweldig.
Wat kun je hieruit halen? Als je Java hebt, neem dan de moderne versie van de driver en wees blij.
Als je een andere taal hebt, denk dan na – misschien heb je dit ook nodig? Want vanuit het perspectief van de doeltaal, bijvoorbeeld als je PL 8 of LibPQ hebt, is het niet vanzelfsprekend dat je tijd verliest, niet aan de uitvoering, maar aan de parsing en dit moet je verifiëren. Hoe? Alles is gratis.
Behalve dat er fouten zijn, bepaalde eigenaardigheden. En daar gaan we het nu over hebben. Het grootste deel zal gaan over industriële archeologie, over wat we vonden, tegen wat we aanliepen.
Als de aanvraag dynamisch wordt gegenereerd. Dat komt voor. Iemand plakt de strings aan elkaar, en dat resulteert in een SQL-aanvraag.
Waarom is dit slecht? Het is slecht omdat we elke keer uiteindelijk een andere string krijgen.
Ook deze verschillende string moet opnieuw de hashCode berekenen. Dit is echt een CPU-taak - het vinden van een lange aanvraagtekst in zelfs een bestaande hash is niet zo eenvoudig. Dus de boodschap is simpel: genereer geen aanvragen. Bewaar ze in één enkele variabele. En wees tevreden.
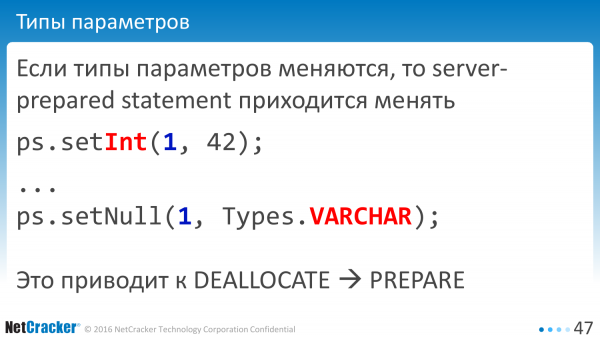
Het volgende probleem. Datatypes zijn belangrijk. Er zijn ORM's die zeggen dat het niet uitmaakt welke NULL, laat het maar een of andere zijn. Als het Int is, dan zeggen we setInt. En als het NULL is, laat het dan altijd VARCHAR zijn. En wat maakt het uiteindelijk uit welke NULL daar is? De database begrijpt het uiteindelijk zelf. En zo'n situatie werkt niet.
In de praktijk maakt de database het helemaal niet uit. Als je de eerste keer zegt dat het een getal is, en de tweede keer zegt dat het VARCHAR is, dan is het onmogelijk om Server-prepared statements opnieuw te gebruiken. En in dat geval moet je onze statement opnieuw aanmaken.
Als je dezelfde aanvraag meerdere keren uitvoert, zorg er dan voor dat de datatypes in de kolom niet door elkaar raken. Let op NULL. Dit is een veelvoorkomende fout die we hebben gehad after we begonnen met PreparedStatements.
Oké, we hebben het ingeschakeld. Misschien hebben we een driver genomen. En de prestaties zijn gedaald. Alles is slecht geworden.
Hoe kan dit gebeuren? Is het een bug of een feature? Helaas, we konden niet begrijpen of het een bug of een feature is. Maar er is een vrij eenvoudig scenario om dit probleem te reproduceren. Het heeft ons volledig verrast. Het betreft een query uit letterlijk één tabel. We hadden natuurlijk meer van zulke queries. Over het algemeen omvatten ze twee of drie tabellen, maar er is zo'n scenario om te reproduceren. Neem op jouw database enige versie en reproduceer het.
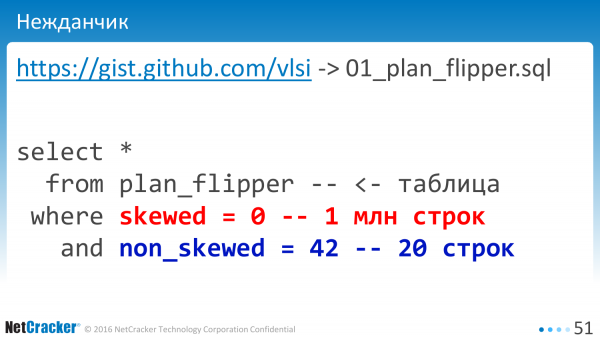
De essentie is dat we twee kolommen hebben, die elk geïndexeerd zijn. In de ene kolom ligt een miljoen regels met de waarde NULL. En in de andere kolom liggen slechts 20 regels. Wanneer we uitvoeren zonder gekoppelde variabelen, werkt alles goed.
Als we beginnen met uitvoeren met gekoppelde variabelen, d.w.z. we voeren het teken «?» of «$1» voor onze aanvraag uit, wat krijgen we dan uiteindelijk?
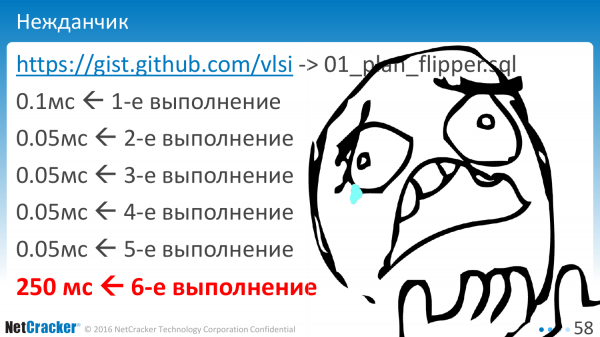
De eerste uitvoering - zoals het hoort. De tweede - iets sneller. Iets is gecached. De derde, vierde, vijfde. Dan klap - en zo gaat het. En het slechtste is dat dit gebeurt bij de zesde uitvoering. Wie wist dat je precies zes uitvoeringen moest doen om te begrijpen wat het echte uitvoeringsplan is?
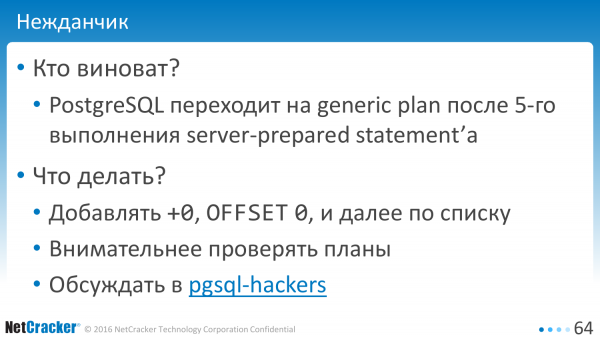
Wie zit er achter? Wat is er gebeurd? De database bevat optimalisatie. En deze is als het ware geoptimaliseerd voor de algemene situatie. En, dienovereenkomstig, vanaf een bepaald moment gaat het over naar een algemeen plan, dat helaas anders kan zijn. Het kan hetzelfde zijn, maar het kan ook anders zijn. En er is een drempelwaarde die dit gedrag veroorzaakt.
Wat kunnen we hieraan doen? Hier is het natuurlijk moeilijk om iets te veronderstellen. Er is een eenvoudige oplossing die we gebruiken. Dit is +0, OFFSET 0. Zeker weten dat je zulke oplossingen kent. We nemen het gewoon en voegen ‘+0’ toe aan de query en het is allemaal goed. Ik zal het later laten zien.
En er is nog een optie – de plannen aandachtiger bekijken. De ontwikkelaar moet niet alleen de query schrijven, maar ook zes keer zeggen ‘explain analyze’. Als het er vijf zijn, is het niet goed.
En er is nog een derde optie – een brief schrijven naar pgsql-hackers. Ik heb het geschreven, maar het is nog niet duidelijk – is dit een bug of een functie.
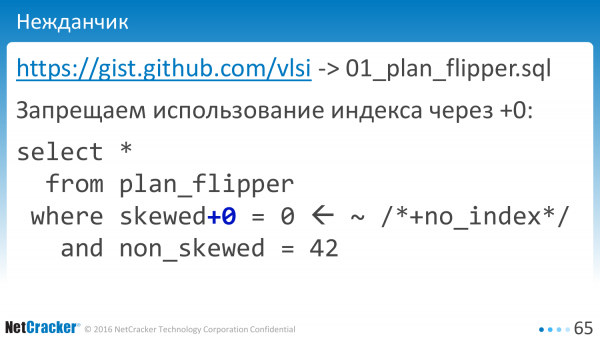
Terwijl we denken – is het een bug of een functie, laten we het oplossen. We nemen onze query en voegen ‘+0’ toe. Het is allemaal goed. Twee karakters en je hoeft zelfs niet na te denken over hoe en wat. Heel eenvoudig. We hebben de database gewoon verboden om de index op deze kolom te gebruiken. We hebben geen index op de kolom ‘+0’ en dat is het, de database gebruikt de index niet, alles is goed.
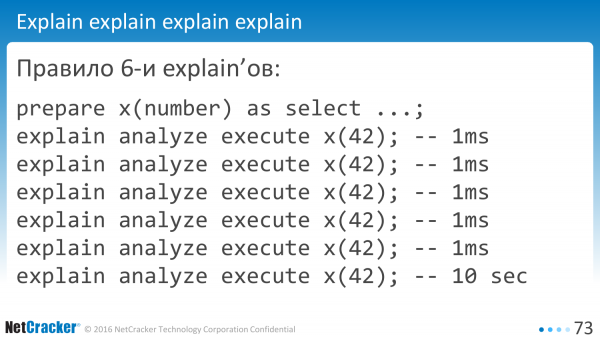
Dit is de regel van zes explains. In de huidige versies moet je het zes keer doen, als je gekoppelde variabelen hebt. Als je geen gekoppelde variabelen hebt, dan doen we het zo. En uiteindelijk faalt precies deze query. Het is niet ingewikkeld.
Het zou zo zijn, hoe lang kan dat duren? Hier is een bug, daar is een bug. Echt, er is overal een bug.
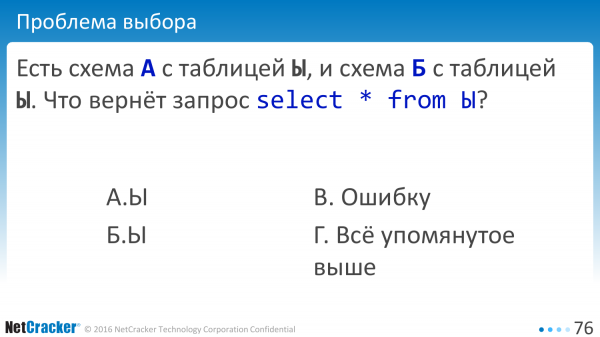
Laten we nog eens kijken. Bijvoorbeeld, we hebben twee schema's. Schema A met tabel Y en schema B met tabel Y. De query – selecteer gegevens uit de tabel. Wat hebben we in dit geval? We krijgen een fout. We krijgen alles wat hierboven is genoemd. De regel is zo – bug overal, we zullen alles hierboven hebben.
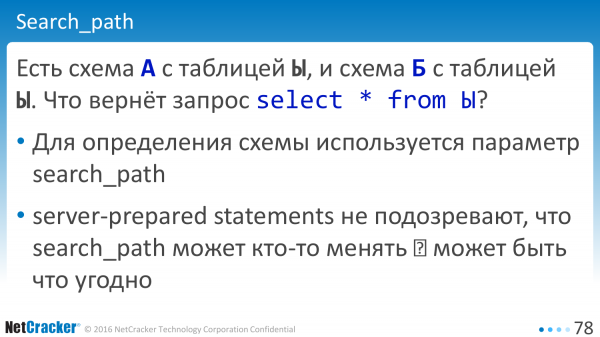
Nu de vraag: ‘Waarom?’. Het lijkt erop dat er documentatie is, dat als we een schema hebben, er een variabele ‘search_path’ is die aangeeft waar de tabel moet worden gezocht. Het lijkt erop dat de variabele er is.
Wat is het probleem? Het probleem is dat server-prepared statements niet vermoeden dat iemand het search_path kan wijzigen. Deze waarde blijft als het ware constant voor de database. En sommige delen kunnen de nieuwe waarden mogelijk niet oppikken.
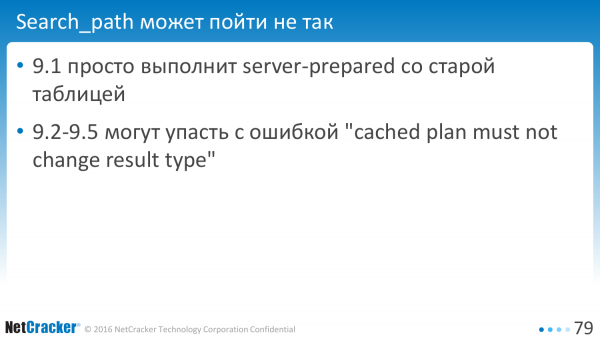
Natuurlijk hangt het af van de versie waarop je test. Het hangt af van hoe verschillend je tabellen zijn. En versie 9.1 zal simpelweg oudere verzoeken uitvoeren. Nieuwe versies kunnen een trucje ontdekken en zeggen dat je een fout hebt.
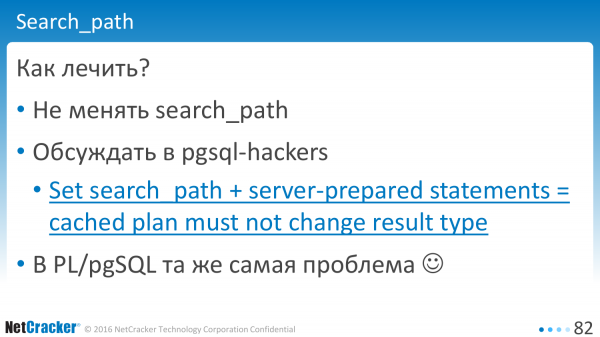
Hoe dit op te lossen? Er is een eenvoudig recept – doe het niet zo. Verander search_path niet terwijl de applicatie draait. Als je het verandert, creëer dan beter een nieuwe verbinding.
We kunnen erover discussiëren, dat wil zeggen, open het, bespreek het, schrijf verder. Misschien overtuigen we de database-ontwikkelaars dat, wanneer iemand een waarde verandert, de database de cliënt moet zeggen: 'Kijk, je waarde is hier geüpdatet. Misschien moet je de statements resetten, opnieuw creëren?'. Momenteel gedraagt de database zich verborgen en geeft helemaal geen melding dat er ergens intern iets in de statements is veranderd.
En ik benadruk opnieuw – dit is iets wat niet typisch is voor Java. We zullen hetzelfde één op één zien in PL/pgSQL. Maar daar zal het worden gereproduceerd.
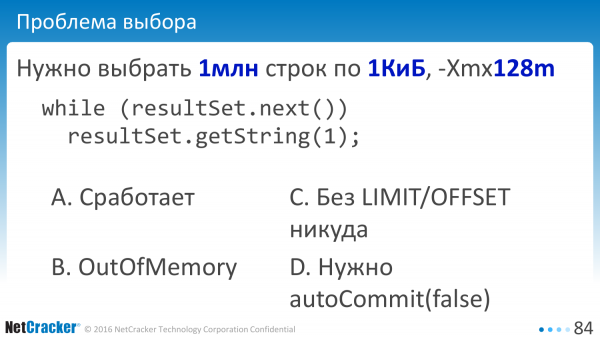
Laten we proberen weer gegevens te selecteren. We selecteren-en-selecteren. We hebben een tabel met een miljoen rijen. Elke rij is ongeveer een kilobyte. Ongeveer een gigabyte aan gegevens. En we hebben werkgeheugen in de Java-machine van 128 megabyte.
We gebruiken, zoals aanbevolen in alle boeken, stromen voor verwerking. Dat wil zeggen, we openen resultSet en lezen daar de gegevens beetje bij beetje. Werkt dit? Zal het niet uitvallen door geheugen? Zal het beetje bij beetje lezen? Laten we geloven in de database, laten we geloven in Postgres. We geloven niet. Vallen we door OutOfMemory? Wie heeft er last van OutOfMemory gehad? En wie heeft het na dat probleem kunnen repareren? Iemand heeft het weten te repareren.
Als je een miljoen rijen hebt, kun je niet zomaar kiezen. Je moet verplicht OFFSET/LIMIT gebruiken. Wie is voor deze optie? En wie is voor de optie dat je met autoCommit moet experimenteren?
Hier blijkt, zoals gewoonlijk, de meest onverwachte optie de juiste te zijn. En als je plotseling autoCommit uitschakelt, helpt dat. Waarom zo? De wetenschap weet het niet.
Maar standaard selecteren alle clients die verbinding maken met de Postgres-database de gegevens in hun geheel. PgJDBC is hierin geen uitzondering, het selecteert alle rijen.
Er is een variatie op het onderwerp FetchSize, dat wil zeggen, je kunt op het niveau van een individuele statement zeggen, dat je hier, alsjeblieft, gegevens wilt selecteren per 10, 50. Maar dit werkt niet totdat je autoCommit uitschakelt. AutoCommit uitgeschakeld – het begint te werken.
Maar door de code te doorlopen en overal setFetchSize in te stellen, is ongemakkelijk. Daarom hebben we een instelling gemaakt die de standaardwaarde voor de hele verbinding aangeeft.
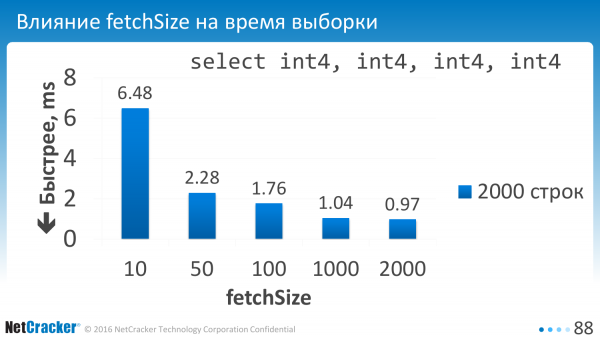
Dat hebben we gezegd. We hebben de parameter ingesteld. En wat hebben we bereikt? Als we selecteren met een klein aantal, bijvoorbeeld met 10 rijen, zijn de overheadkosten behoorlijk hoog. Daarom moeten we deze waarde op ongeveer honderd instellen.
Idealiter leren we ook om het in bytes te beperken, maar het recept is als volgt: stel defaultRowFetchSize hoger dan honderd in en geniet.
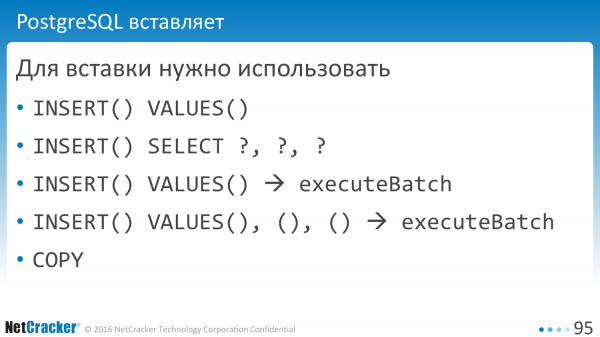
Laten we verder gaan met het invoegen van gegevens. Invoegen is eenvoudiger, er zijn verschillende opties. Bijvoorbeeld, INSERT, VALUES. Dat is een goede optie. Je kunt ook 'INSERT SELECT' zeggen. In de praktijk is dat hetzelfde. Er is geen verschil in prestaties.
Boeken zeggen dat je Batch statements moet uitvoeren, boeken zeggen dat je complexere opdrachten met meerdere haakjes kunt uitvoeren. En in Postgres is er een geweldige functie – je kunt COPY doen, dat wil zeggen, het sneller doen.

Als we meten, kunnen we weer een paar interessante ontdekkingen doen. Hoe willen we dat dit werkt? We willen niet parseren en geen overbodige opdrachten uitvoeren.
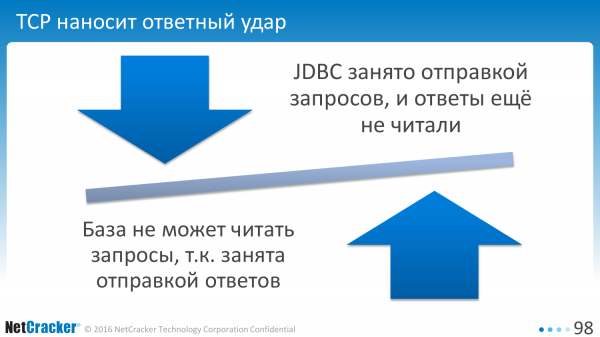
In de praktijk laat TCP ons dit niet doen. Als de client bezig is met het verzenden van een verzoek, leest de database de verzoeken niet in de poging om ons antwoorden te geven. Uiteindelijk wacht de client op de database tot deze het verzoek leest, terwijl de database op de client wacht tot deze het antwoord leest.
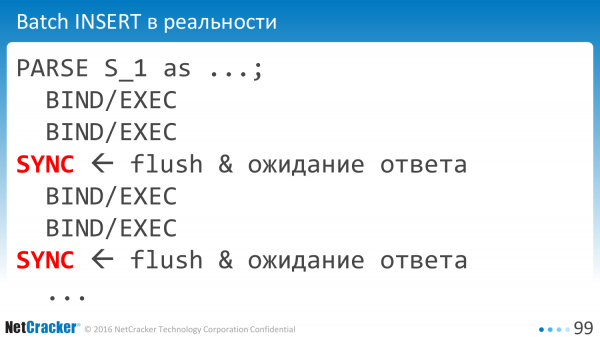
Daarom moet de client periodiek een synchronisatiepakket verzenden. Overbodige netwerkinteracties, onnodig verlies van tijd.
 En hoe meer we ze toevoegen, hoe slechter het wordt. De driver is vrij pessimistisch en voegt ze redelijk vaak toe, ongeveer om de 200 rijen, afhankelijk van de rijgrootte, enzovoort.
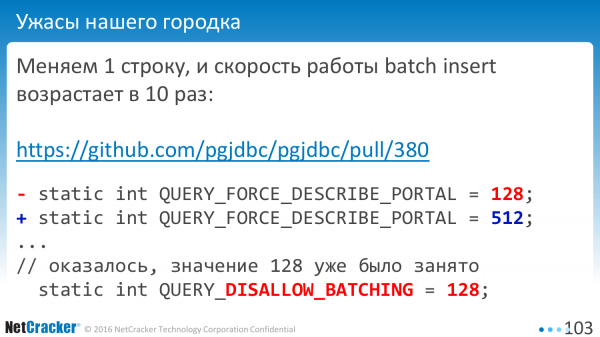
Soms kan je slechts één rij aanpassen en alles met tien keer versnellen. Dat gebeurt. Waarom? Zoals gewoonlijk, werd ergens zo'n constante al gebruikt. En de waarde '128' betekende - batching niet gebruiken.
Het is goed dat dit niet in de officiële versie is beland. We hebben het ontdekt voordat we de release begonnen te maken. Alle waarden die ik noem, zijn gebaseerd op moderne versies.
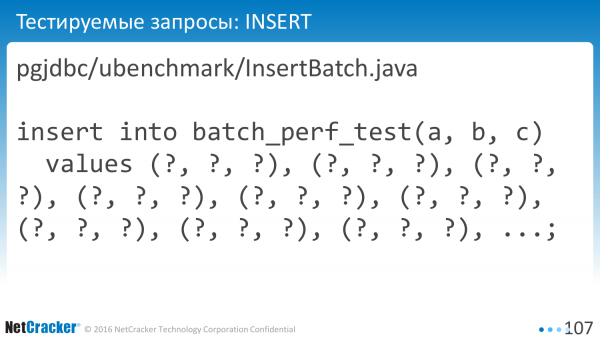
Laten we meten. We meten eenvoudige InsertBatch. We meten herhaalde InsertBatch, dat wil zeggen hetzelfde, maar met veel values. Een slimme zet. Niet iedereen kan dat, maar het is een eenvoudige stap, veel eenvoudiger dan COPY.
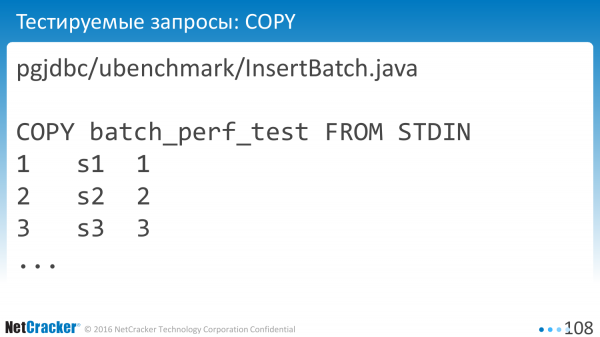
Je kunt COPY doen.
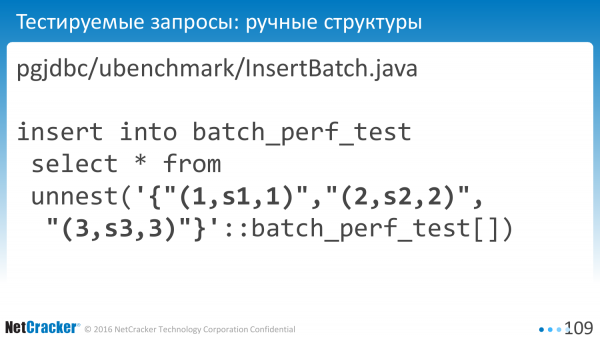
En dit kan gedaan worden met structuren. Declareer het standaardtype User, geef een array door en INSERT rechtstreeks in de tabel.
Als je de link opent: pgjdbc/ubenchmsrk/InsertBatch.java, dan vind je deze code op GitHub. Je kunt specifiek bekijken welke queries daar worden gegenereerd. Het is niet echt belangrijk.
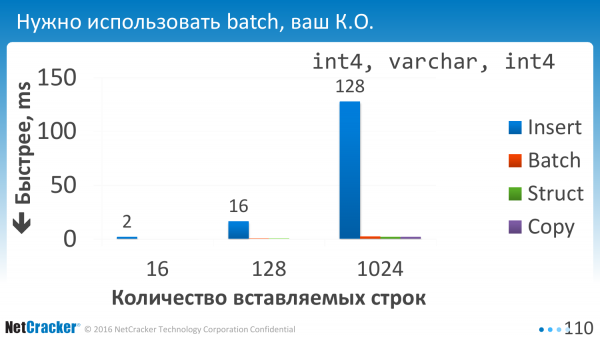
We hebben het uitgevoerd. En het eerste wat we begrepen, is dat je batch-niet kunt negeren – dat is gewoon niet mogelijk. Alle batch-opties zijn gelijk aan nul, d. w. z. de uitvoeringstijd is praktisch nul vergeleken met een enkele uitvoering.
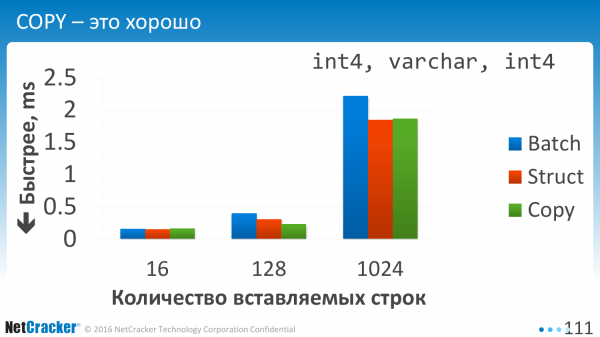
We voegen gegevens toe. Het is een vrij eenvoudige tabel. Drie kolommen. En wat zien we hier? We zien dat al deze drie opties ongeveer vergelijkbaar zijn. En COPY is natuurlijk beter.
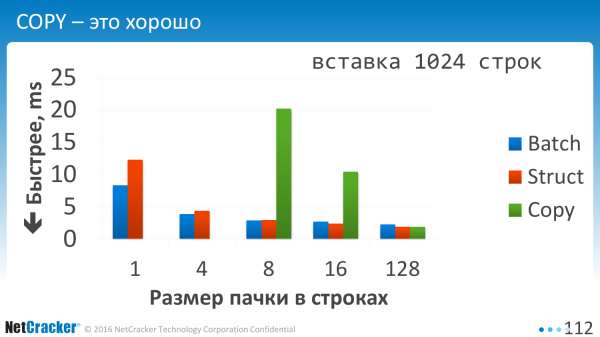
Dit is wanneer we in stukjes invoegen. Wanneer we zeiden dat één waarde VALUES, twee waarden VALUES, drie waarden VALUES zijn of dat we er 10 door elkaar hebben opgegeven. Dit is nu horizontaal. 1, 2, 4, 128. Je ziet dat Batch Insert, dat in het blauw is weergegeven, dit veel gemakkelijker maakt. D. w. z. wanneer je één voor één invoegt of zelfs wanneer je vier tegelijk invoegt, wordt het twee keer beter, gewoon omdat we iets meer in VALUES hebben gestopt. Minder EXECUTE-operaties.
COPY gebruiken voor kleine volumes is uiterst onvoordelig. Ik heb zelfs op de eerste twee niet getekend. Zij stijgen de lucht in, d. w. z. deze groene cijfers zijn voor COPY.
COPY moet worden gebruikt wanneer je gegevensvolume tenminste meer dan honderd regels is. De overhead voor het openen van deze verbinding is groot. En, eerlijk gezegd, heb ik hier niet verder in gegraven. Batch heb ik geoptimaliseerd, COPY niet.
Wat doen we nu verder? We hebben gemeten. We begrijpen dat we ofwel structuren moeten gebruiken, of een ingenieuze batch die meerdere waarden combineert.
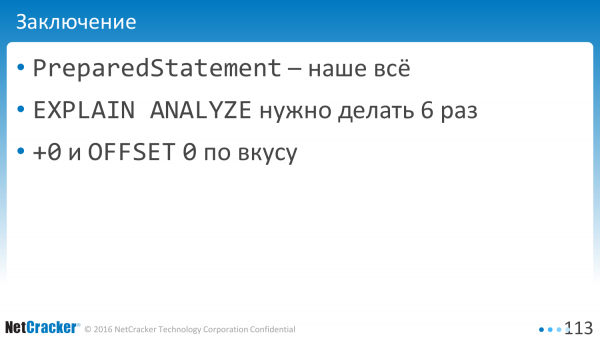
Wat moeten we meenemen uit de presentatie van vandaag?
- PreparedStatement is alles voor ons. Het geeft veel voor de prestaties. Het levert een grote emmer teers.
- En we moeten EXPLAIN ANALYZE 6 keer uitvoeren.
- En we moeten OFFSET 0 verdunnen, en trucs zoals +0 toepassen om het resterende percentage van onze problematische queries te corrigeren.
Bron: habr.com
