

Hallo, Habr!
In het licht van de huidige gebeurtenissen als gevolg van het coronavirus, hebben verschillende internetdiensten een increased belasting ontvangen. Bijvoorbeeld, , omdat de capaciteit niet voldoende was. En het is niet altijd mogelijk om een server te versnellen door simpelweg krachtigere hardware toe te voegen, maar je moet wel de klantverzoeken verwerken (anders gaan ze naar de concurrentie).
In dit artikel geef ik een korte uiteenzetting van populaire praktijken die het mogelijk maken om een snelle en fouttolerante service te creëren. Ik heb echter uit de mogelijke ontwikkelingsschema's alleen de geselecteerd die momenteel gemakkelijk te gebruiken zijn. Voor elk punt heeft u ofwel al bestaande bibliotheken, ofwel de mogelijkheid om dit probleem op te lossen via een cloudplatform.
Horizontale schaalvergroting
Het meest eenvoudige en algemeen bekende punt. In wezen zijn er twee vaak voorkomende manieren van load balancing — horizontale en verticale schaalvergroting. staat u de services toe om parallel te werken, waardoor de belasting tussen hen wordt verdeeld. bestelt u krachtigere servers of optimaliseert u de code.
Als voorbeeld neem ik een abstracte cloudopslag voor bestanden, dus een soortgelijke dienst als OwnCloud, OneDrive, enzovoort.
De standaardillustratie van een dergelijk schema staat hieronder, maar het laat alleen de complexiteit van het systeem zien. We moeten immers op de een of andere manier de services synchroniseren. Wat gebeurt er als een gebruiker een bestand vanaf een tablet heeft opgeslagen en het vervolgens vanaf een telefoon wil bekijken?
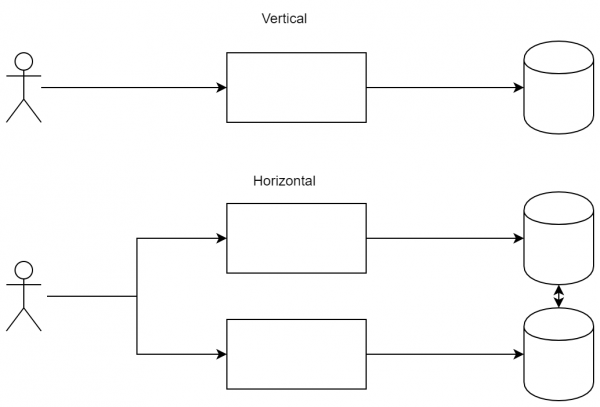
Het verschil tussen de benaderingen: bij verticale schaalvergroting zijn we bereid om de prestaties van de knooppunten te verhogen, terwijl we bij horizontale schaalvergroting nieuwe knooppunten toevoegen om de belasting te verdelen.
CQRS
is een vrij belangrijk patroon, omdat het verschillende klanten in staat stelt niet alleen verbinding te maken met verschillende services, maar ook dezelfde event streams te ontvangen. De voordelen zijn niet zo voor de hand liggend voor een eenvoudige applicatie, maar het is van cruciaal belang (en eenvoudig) voor een zwaar belaste service. De essentie is: inkomende en uitgaande datastromen mogen elkaar niet overlappen. Dat betekent dat u geen verzoek kunt sturen en een antwoord kunt verwachten; in plaats daarvan stuurt u een verzoek naar service A, maar ontvangt u het antwoord in service B.
De eerste bonus van deze aanpak is de mogelijkheid om de verbinding (in de brede zin van het woord) te verbreken tijdens een langlopende aanvraag. Laten we als voorbeeld een meer of minder standaard volgorde nemen:
- De klant heeft een verzoek naar de server verzonden.
- De server is begonnen met een langdurige verwerking.
- De server heeft de klant een resultaat gegeven.
Stel je voor dat er in punt 2 een verbindingsonderbreking heeft plaatsgevonden (of het netwerk is opnieuw verbonden, of de gebruiker is naar een andere pagina gegaan en heeft de verbinding verbroken). In dit geval zal het voor de server moeilijk zijn om de gebruiker een antwoord te sturen met de informatie over wat precies is verwerkt. Bij het toepassen van CQRS zal de volgorde iets anders zijn:
- De klant heeft zich ingeschreven voor updates.
- De klant heeft een verzoek naar de server verzonden.
- De server antwoordde met 'verzoek ontvangen'.
- De server heeft het resultaat via het kanaal van punt ‘1’ verzonden.
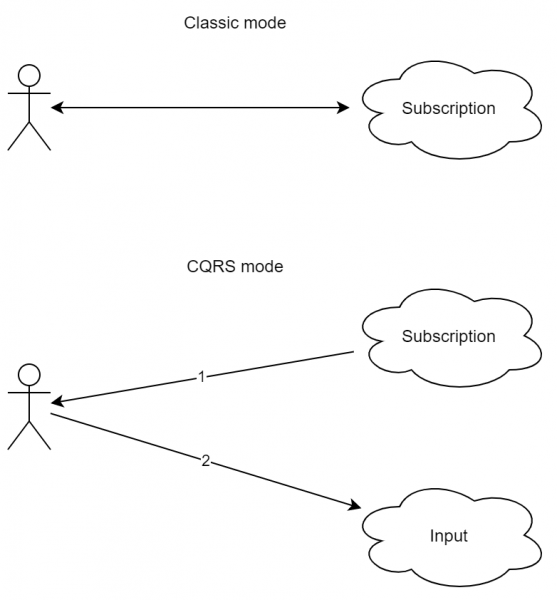
Zoals je kunt zien, is het schema iets complexer. Bovendien ontbreekt de intuïtieve aanvraag-reactie aanpak hier. Maar zoals te zien is, zal een verbindingsonderbreking tijdens de verwerking van een aanvraag niet leiden tot een fout. Bovendien, als de gebruiker daadwerkelijk vanaf meerdere apparaten is verbonden met de service (bijvoorbeeld vanaf een mobiele telefoon en een tablet), is het mogelijk om ervoor te zorgen dat het antwoord op beide apparaten aankomt.
Het interessante is dat de code voor het verwerken van inkomende berichten hetzelfde wordt (niet voor 100%) zowel voor gebeurtenissen die door de klant zelf zijn beïnvloed als voor andere gebeurtenissen, inclusief die van andere klanten.
In de praktijk krijgen we echter extra bonussen doordat de eenrichtingsstroom in functionele stijl kan worden verwerkt (met RX en soortgelijke methoden). Dit is al een serieuze pluspunt, aangezien de applicatie in wezen volledig reactief kan worden gemaakt, met inachtneming van een functionele aanpak. Voor zware programma's kan dit aanzienlijk middelen besparen voor ontwikkeling en ondersteuning.
Als we deze aanpak combineren met horizontale schaalbaarheid, krijgen we als bonus de mogelijkheid om verzoeken naar één server te sturen en antwoorden van een andere te ontvangen. Op deze manier kan de klant zelf de service kiezen die het beste bij hem past, terwijl het systeem intern de gebeurtenissen correct kan verwerken.
Event Sourcing
Zoals u weet, is een van de belangrijkste kenmerken van een verdeeld systeem het ontbreken van een gemeenschappelijke tijd en een gemeenschappelijke kritieke sectie. Voor één proces kunt u synchronisatie toepassen (op dezelfde mutexen), waarbij u zeker weet dat niemand anders deze code uitvoert. Voor een verdeeld systeem is dit echter gevaarlijk, omdat het overhead met zich meebrengt en bovendien de schoonheid van schaalvergroting verloren gaat — toch zullen alle componenten op elkaar moeten wachten.
Hieruit kunnen we een belangrijke conclusie trekken — een snelle verdeelde systeem kan niet worden gesynchroniseerd, omdat dit de prestaties zou verminderen. Aan de andere kant is er vaak behoefte aan bepaalde consistentie tussen componenten. En daarvoor kan de volgende benadering worden gebruikt. , waar wordt gegarandeerd dat, in de afwezigheid van gegevenswijzigingen gedurende een bepaalde periode na de laatste update (‘uiteindelijk’), alle verzoeken de laatst bijgewerkte waarde zullen teruggeven.
Het is belangrijk te begrijpen dat voor klassieke databases vaak wordt toegepast. , waarbij elke knoop dezelfde informatie bezit (dit wordt vaak bereikt wanneer een transactie als bevestigd wordt beschouwd pas na een antwoord van de tweede server). Hier zijn er enkele verslappingen vanwege isolatieniveaus, maar de essentie blijft dezelfde — u kunt leven in een volledig consistente wereld.
Laten we echter terugkeren naar de oorspronkelijke taak. Als een deel van het systeem kan worden opgebouwd met , kan de volgende schema worden gebouwd.
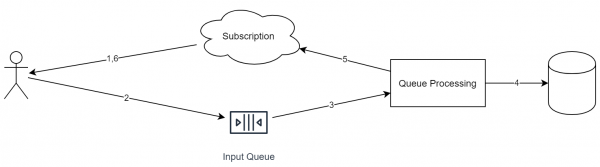
Belangrijke kenmerken van deze benadering:
- Elk binnenkomend verzoek wordt in een enkele wachtrij geplaatst.
- Bij de verwerking van een verzoek kan de service ook taken in andere wachtrijen plaatsen.
- Elk binnenkomend evenement heeft een identificator (die nodig is voor deduplicatie).
- De wachtrij werkt ideologisch volgens het principe 'alleen toevoegen'. Elementen kunnen niet uit de wachtrij worden verwijderd of opnieuw worden geplaatst.
- De wachtrij werkt volgens het FIFO-principe (excuses voor de tautologie). Als parallelle verwerking noodzakelijk is, moeten objecten in een van de fasen naar verschillende wachtrijen worden overgebracht.
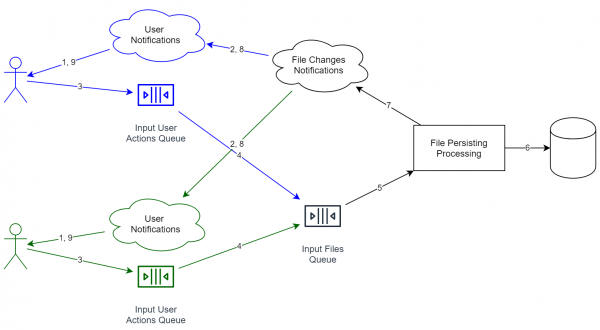
Ter herinnering, we beschouwen de situatie van een online bestandsopslag. In dit geval zal het systeem er ongeveer als volgt uitzien:
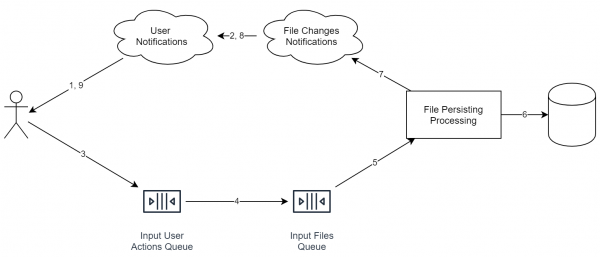
Het is belangrijk dat de diensten op het diagram niet noodzakelijk afzonderlijke servers betekenen. Zelfs het proces kan hetzelfde zijn. Belangrijker is: ideologisch zijn deze zaken zo gescheiden dat horizontale schaalvergroting gemakkelijk kan worden toegepast.
Voor twee gebruikers zou het schema er als volgt uitzien (diensten die voor verschillende gebruikers bestemd zijn, zijn in verschillende kleuren gemarkeerd):
Voordelen van een dergelijke combinatie:
- De informatieverwerkingsdiensten zijn gescheiden. De wachtrijen zijn ook gescheiden. Als we de doorvoercapaciteit van het systeem willen verhogen, hoeven we alleen maar meer diensten op meer servers te starten.
- Wanneer we informatie van de gebruiker ontvangen, hoeven we niet te wachten op de volledige opslag van gegevens. Integendeel, we kunnen eenvoudig 'ok' antwoorden en vervolgens geleidelijk aan met het werk beginnen. Tegelijkertijd verzacht de wachtrij pieken, aangezien het toevoegen van een nieuw object snel gebeurt en de gebruiker niet hoeft te wachten op een volledige doorloop van de cyclus.
- Als voorbeeld heb ik een deduplicatieservice toegevoegd, die probeert identieke bestanden samen te voegen. Als deze lang werkt voor 1% van de gevallen, zal de klant dit praktisch niet opmerken (zie hierboven), wat een groot voordeel is, aangezien van ons niet een honderd procent snelheid en betrouwbaarheid wordt vereist.
Echter, de nadelen zijn ook onmiddellijk zichtbaar:
- Onze systeem heeft strikte consistentie verloren. Dit betekent dat als je je bijvoorbeeld aanmeldt voor verschillende diensten, je theoretisch verschillende toestanden kunt ontvangen (aangezien een van de diensten mogelijk het bericht van de interne wachtrij niet op tijd ontvangt). Als een ander gevolg heeft het systeem nu geen gezamenlijke tijd. Dit betekent dat je bijvoorbeeld alle gebeurtenissen niet eenvoudig kunt sorteren op basis van tijd van binnenkomst, omdat de klokken tussen servers mogelijk niet gesynchroniseerd zijn (bovendien is dezelfde tijd op twee servers een utopie).
- Geen enkele gebeurtenis kan nu eenvoudig worden teruggedraaid (zoals met een database mogelijk zou zijn). In plaats daarvan moet er een nieuwe gebeurtenis worden toegevoegd — , die de laatste toestand naar de vereiste zal wijzigen. Als voorbeeld uit een vergelijkbaar gebied: zonder het herschrijven van de geschiedenis (wat in sommige gevallen slecht is) kan men in git geen commit terugdraaien, maar kan men wel een speciale , wat in wezen gewoon de oude staat zal teruggeven. Echter, zowel de foutieve commit als de rollback zullen in de geschiedenis blijven.
- Het datamodel kan van release tot release veranderen, maar oude gebeurtenissen kunnen nu niet meer worden bijgewerkt naar de nieuwe standaard (aangezien gebeurtenissen in principe niet kunnen worden gewijzigd).
Zoals te zien is, past Event Sourcing uitstekend samen met CQRS. Sterker nog, het implementeren van een systeem met efficiënte en handige wachtrijen, maar zonder datastroomsegmentatie, is al een uitdaging op zich, want het vereist het toevoegen van synchronisatiepunten die het positieve effect van de wachtrijen tenietdoen. Door beide benaderingen tegelijkertijd toe te passen, moet de programmatuur enigszins worden aangepast. In ons geval, bij het uploaden van een bestand naar de server, komt er alleen een 'ok' als reactie, wat betekent dat de 'bestandsadditie-operatie is opgeslagen'. Formeel betekent dit niet dat de gegevens al op andere apparaten beschikbaar zijn (bijvoorbeeld, de deduplicatieservice kan de index opnieuw opbouwen). Echter, na enige tijd ontvangt de klant een notificatie als 'bestand X is opgeslagen'.
Als resultaat:
- Het aantal bestandsstatussen neemt toe: in plaats van de klassieke 'bestand verzonden' krijgen we er twee: 'bestand in wachtrij op de server toegevoegd' en 'bestand opgeslagen in de opslag'. Laatstgenoemde betekent dat andere apparaten het bestand al kunnen beginnen te ontvangen (met de kanttekening dat wachtrijen met verschillende snelheden werken).
- Vanwege het feit dat informatie over verzending nu via verschillende kanalen binnenkomt, moeten we oplossingen bedenken om de status van de bestandverwerking te ontvangen. Hierdoor kan de client, in tegenstelling tot de klassieke request-response, tijdens de bestandsverwerking opnieuw worden opgestart, maar de status van de verwerking is correct. Dit punt werkt in wezen out-of-the-box. Hierdoor zijn we nu toleranter voor storingen.
Sharding
Zoals hierboven beschreven, ontbreekt in systemen met event sourcing strikte consistentie. Dit betekent dat we meerdere opslagplaatsen kunnen gebruiken zonder enige synchronisatie ertussen. Dichtbij onze taak kunnen we:
- Bestanden indelen op type. Bijvoorbeeld, afbeeldingen/video's kunnen worden gedecodeerd en er kan een efficiënter formaat worden gekozen.
- Accounts splits per country. Due to many laws, this may be required, however, this architecture scheme allows for such an option automatically.
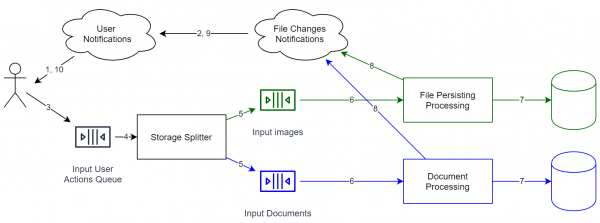
If you want to transfer data from one storage to another, standard means will not suffice here. Unfortunately, in this case, it is necessary to stop the queue, perform the migration, and then restart it. Generally, data cannot be transferred 'on the fly'; however, if the event queue is fully stored, and you have snapshots of previous states of the storage, we can replay events as follows:
- In Event Source, each event has its own identifier (ideally, a non-decreasing one). Thus, we can add a field in the storage — the id of the last processed item.
- We duplicate the queue so that all events can be processed for several independent storages (the first is the one that is already storing data, and the second is new, while still empty). The second queue is naturally not being processed yet.
- We start the second queue (that is, we begin replaying events).
- When the new queue is relatively empty (i.e., the average time difference between adding an item and retrieving it is acceptable), we can start switching readers to the new storage.
As you can see, our system has never had strict consistency. There is only eventual consistency, meaning that events are guaranteed to be processed in the same order (however, possibly with different delays). And, using this, we can comparatively easily transfer data without stopping the system to the other side of the globe.
Thus, continuing our example of an online storage for files, such an architecture already gives us a number of bonuses:
- We can move objects closer to users, and dynamically. This can improve service quality.
- We can store part of the data within companies. For example, enterprise users often require their data to be stored in controlled data centers (to prevent data leaks). With sharding, we can easily support this. The task is further simplified if the customer has a compatible cloud (for instance, ).
- Het belangrijkste is dat we het niet hoeven te doen. Voorlopig zou één opslag voor alle accounts ons prima passen (om sneller aan de slag te gaan). En het sleutelkenmerk van dit systeem is dat, hoewel het uitbreidbaar is, het in het begin vrij eenvoudig is. Je hoeft niet meteen code te schrijven die werkt met een miljoen afzonderlijke onafhankelijke wachtrijen, enzovoorts. Als dat nodig is, kan dat in de toekomst.
Static Content Hosting
Dit punt lijkt misschien heel vanzelfsprekend, maar het is nog steeds noodzakelijk voor een min of meer standaard zwaar beladen applicatie. Het idee is simpel: alle statische content wordt niet vanaf dezelfde server gedistribueerd als de applicatie, maar vanaf speciale servers die hiervoor zijn ingericht. Dit betekent dat deze operaties sneller verlopen (bijvoorbeeld, nginx levert bestanden sneller en kosteneffectiever dan een Java-server). Bovendien maakt de architectuur van een CDN () het mogelijk om onze bestanden dichter bij eindgebruikers te plaatsen, wat de gebruikservaring met de service verbetert.
Het eenvoudigste en meest standaard voorbeeld van statische content is een set scripts en afbeeldingen voor een website. Dit is vrij straightforward — ze zijn van tevoren bekend, vervolgens wordt het archief naar de CDN-servers geüpload, vanwaar het aan eindgebruikers wordt geleverd.
Echter, in de praktijk kan voor statische content een aanpak worden gebruikt die lijkt op een lambda-architectuur. Laten we terugkeren naar onze taak (een online bestandopslag), waarin we bestanden aan gebruikers moeten leveren. De eenvoudigste directe oplossing is om een service te maken die voor elk gebruikersverzoek alle noodzakelijke controles uitvoert (autorisatie, enzovoort), en vervolgens het bestand direct van onze opslag downloadt. Het belangrijkste nadeel van deze aanpak is dat de statische content (en een bestand met een bepaalde revisie is in wezen statische content) wordt geleverd door dezelfde server die de bedrijfslogica bevat. In plaats daarvan kan het volgende schema worden gemaakt:
- De server geeft een URL voor het downloaden. Deze kan de vorm hebben van file_id + key, waarbij key een kleine digitale handtekening is die toegang geeft tot de resource voor de komende 24 uur.
- Een simpele nginx verzorgt het bestand met de volgende opties:
- Content caching. Since this service may be on a separate server, we have left room for future potential to store all recently downloaded files on disk.
- Key check at the moment of connection creation.
- Optionally: streaming content processing. For example, if we compress all files in the service, we can perform decompression directly within this module. Consequently, IO operations are done where they belong. A Java archiver may consume a lot of excess memory, but rewriting the service with business logic in conditional Rust/C++ could also prove inefficient. In our case, different processes (or even services) are utilized, making it quite effective to separate business logic from IO operations.
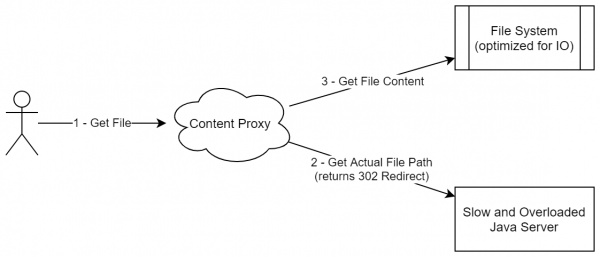
Such a scheme doesn’t closely resemble serving static content (since we are not offloading the entire static package somewhere), yet in reality, this approach indeed specializes in delivering immutable data. Moreover, this scheme can be generalized to other cases where content is not merely static but can be represented as a set of immutable and non-deletable blocks (though they can be added).
As another example (for reinforcement): if you have worked with Jenkins/TeamCity, you know that both solutions are written in Java. They both represent a Java process that handles both build orchestration and content management. Specifically, they each have tasks such as 'transfer file/folder from the server.' For example: delivering artifacts, transferring source code (when the agent does not directly download code from the repository but the server does it instead), accessing logs. All these tasks differ in IO load. Thus, the server responsible for complex business logic also needs to efficiently push large data streams through itself. Interestingly, this operation can be delegated to the same nginx in exactly the same manner (except the request should include a data key).
However, if we return to our system, the result is a similar scheme:
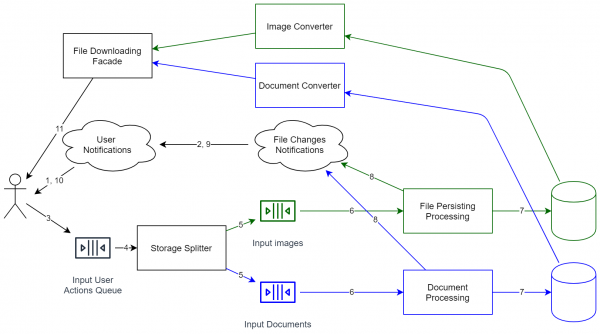
Zoals te zien is, is het systeem radicaal ingewikkelder geworden. Het is nu niet langer gewoon een miniproces dat bestanden lokaal opslaat. Nu zijn er al meer geavanceerde ondersteuning en versiebeheer van API’s nodig, enzovoort. Daarom is het, nadat alle diagrammen zijn getekend, het beste om gedetailleerd te beoordelen of de uitbreidbaarheid van dit soort kosten gerechtvaardigd is. Maar als je de mogelijkheid wilt hebben om het systeem uit te breiden (ook om met een nog groter aantal gebruikers te werken), dan zul je voor dergelijke oplossingen moeten kiezen. Het resultaat is dat het architecturaal systeem klaar is om de belasting te verhogen (bijna elke component kan worden gekloond voor horizontale schaalvergroting). Het systeem kan worden bijgewerkt zonder dat het stilgelegd hoeft te worden (alleen sommige bewerkingen zullen een beetje vertragen).
Zoals ik aan het begin al zei, krijgt een aantal internetdiensten nu een verhoogde belasting. En sommige van hen zijn gewoon gestopt met goed functioneren. In feite heeft het systeem gefaald op het moment dat het bedrijf net geld had moeten verdienen. In wezen zei het systeem: "ga maar naar de concurrenten" in plaats van uitgestelde levering of het aanbieden aan klanten om "de levering voor de komende maanden te plannen". Dit is wat de prijs van lage prestaties is: verliezen zullen zich precies op het moment voordoen dat de winst het hoogst zou zijn.
Conclusie
Al deze benaderingen waren eerder al bekend. VK maakt al lange tijd gebruik van het idee van Static Content Hosting voor het leveren van afbeeldingen. Veel online games gebruiken de Sharding-schema om spelers over regio's te verdelen of om spelsituaties te scheiden (als de wereld één geheel is). De Event Sourcing-aanpak wordt actief gebruikt in e-mail. De meeste handelsapplicaties, waar continu gegevens binnenkomen, zijn eigenlijk gebouwd op de CQRS-aanpak om de binnenkomende gegevens te kunnen filteren. Horizontale schaalvergroting wordt ook al geruime tijd in veel diensten toegepast.
Maar het belangrijkste is dat al deze patronen nu heel gemakkelijk toepasbaar zijn in moderne applicaties (tenzij ze uiteraard ongepast zijn). Cloud-omgevingen bieden sharding en horizontale schaalbaarheid direct aan, wat veel eenvoudiger is dan het zelf bestellen van verschillende dedicated servers in verschillende datacenters. CQRS is veel gemakkelijker geworden, onder andere door de ontwikkeling van bibliotheken zoals RX. Tien jaar geleden zou een zeldzame website dat aankunnen. Event sourcing is ook ongelooflijk eenvoudig in te richten dankzij de beschikbare containers met Apache Kafka. Tien jaar geleden zou dit als vernieuwend worden beschouwd, terwijl het nu heel gewoon is. Evenzo geldt dit voor static content hosting: door gebruiksvriendelijkere technologieën (waaronder uitgebreide documentatie en een groot aantal antwoorden) is deze aanpak nog eenvoudiger geworden.
Als conclusie is de implementatie van een aantal behoorlijk complexe architecturale patronen nu veel eenvoudiger geworden, en dat betekent dat het goed is om er van tevoren naar te kijken. Als in een applicatie van tien jaar geleden een van de bovenstaande oplossingen werd afgewezen vanwege de hoge kosten van implementatie en exploitatie, kan nu in een nieuwe applicatie, of na een refactoring, een service worden gebouwd die architectonisch zowel uitbreidbaar (in termen van prestaties) als klaar voor nieuwe klantbehoeften (bijvoorbeeld voor de lokalisatie van persoonlijke gegevens) zal zijn.
En het belangrijkste: gebruik deze benaderingen alsjeblieft niet als je een eenvoudige applicatie hebt. Ja, ze zijn mooi en interessant, maar voor een website met een piekbezoek van 100 mensen kan je vaak volstaan met een klassieke monolith (al kan je intern alles opdelen in modules, etc.).
Bron: habr.com
