

Opmerking vertaler.: dit materiaal is afkomstig van een educatief project — een antwoord op een veelgestelde vraag bij het ontwerpen van infrastructuur op basis van Kubernetes. We hopen dat de voldoende uitgebreide beschrijvingen van de voor- en nadelen van elk van de opties helpen om de optimale keuze voor uw project te maken.
TL;DR: dezelfde set workloads kan worden uitgevoerd op verschillende grote clusters (waarbij elke cluster een groot aantal workloads heeft) of op meerdere kleinere (met een klein aantal workloads in elk cluster).
Hieronder is een tabel waarin de voor- en nadelen van elke benadering worden beoordeeld:
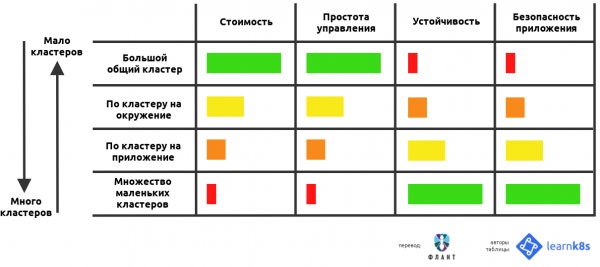
Bij het gebruik van Kubernetes als platform voor het in productie nemen van applicaties rijzen vaak enkele fundamentele vragen over de nuances van clusterconfiguraties:
- Hoeveel clusters moeten worden gebruikt?
- Hoe groot moeten ze zijn?
- Wat moet elke cluster omvatten?
In dit artikel zal ik proberen al deze vragen te beantwoorden door de voor- en nadelen van elke benadering te analyseren.
Het formuleren van de vraag
Als softwareontwikkelaar ontwikkelt u waarschijnlijk meerdere applicaties tegelijkertijd.
Bovendien worden er ongetwijfeld meerdere exemplaren van deze applicaties uitgevoerd in verschillende omgevingen — bijvoorbeeld: , maar volgt geen wijzigingen), gebruikmakend van een andere configuratie., test en prod.
Hierdoor ontstaat er een volledige matrix van applicaties en omgevingen:
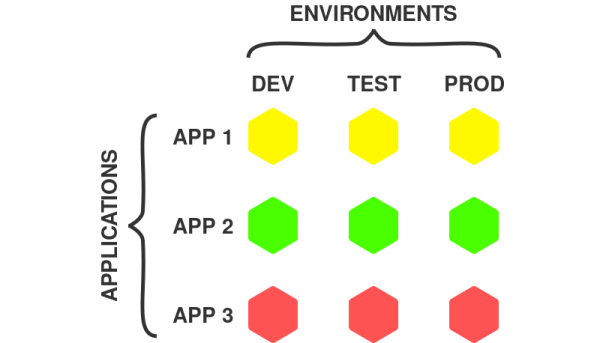
Applicaties en omgevingen
In het bovenstaande voorbeeld zijn er 3 applicaties en 3 omgevingen, wat uiteindelijk 9 mogelijke combinaties oplevert.
Elk exemplaar van een applicatie vormt een zelfstandige deployment-eenheid, waarmee onafhankelijk van andere kan worden gewerkt.
Let op dat exemplaar van de applicatie kan uit meerdere componenten, zoals frontend, backend, database, enzovoort. In het geval van een microservices-applicatie omvat het exemplaar alle microservices.
Daarom hebben gebruikers van Kubernetes enkele vragen:
- Moet ik alle exemplaren van de applicatie in één cluster plaatsen?
- Moet ik een apart cluster aanmaken voor elk exemplaar van de applicatie?
- Of moet ik misschien een combinatie van de bovenstaande benaderingen gebruiken?
Al deze opties zijn volkomen haalbaar, aangezien Kubernetes een flexibel systeem is dat de gebruiker niet beperkt in mogelijkheden.
Hier zijn enkele van de mogelijke paden:
- één grote gemeenschappelijke cluster;
- een groot aantal kleine gespecialiseerde clusters;
- één cluster per applicatie;
- één cluster per omgeving.
Zoals hieronder weergegeven, bevinden de eerste twee benaderingen zich aan de tegenovergestelde uiteinden van de schaal van opties:
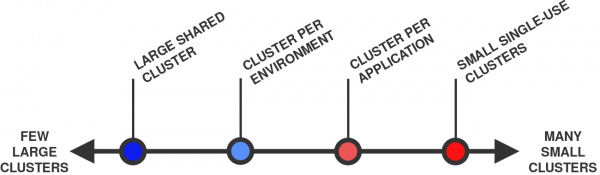
Van enkele grote clusters (links) tot een groot aantal kleine (rechts)
Over het algemeen wordt aangenomen dat één cluster 'groter' is dan een ander als het meer knooppunten en pods heeft. Bijvoorbeeld, een cluster met 10 knooppunten en 100 pods is groter dan een cluster met 1 knooppunt en 10 pods.
Laten we beginnen!
1. Eén grote gedeelde cluster
De eerste optie is om alle werkbelastingen in één cluster te plaatsen:
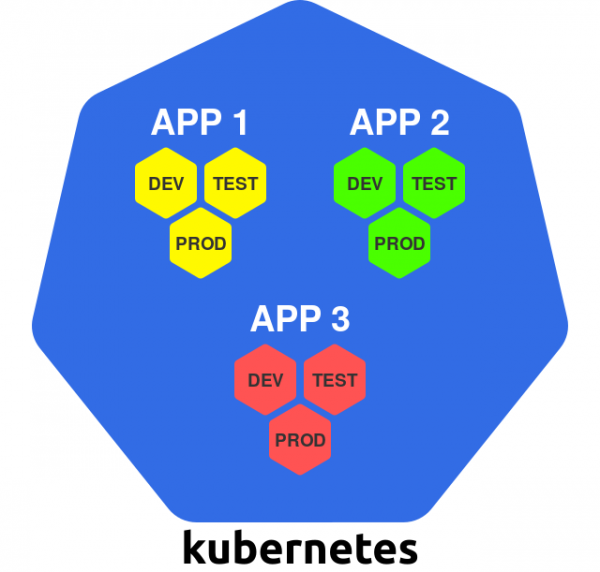
Eén grote cluster
Binnen deze aanpak wordt de cluster gebruikt als een universeel infrastructuurplatform — alles wat je nodig hebt, kun je gewoon implementeren in de bestaande Kubernetes-cluster.
Kubernetes maakt het mogelijk om delen van de cluster logisch van elkaar te scheiden, zodat voor elke instance van de applicatie een eigen naamruimte kan worden gebruikt.
Laten we de voor- en nadelen van deze aanpak bekijken.
+ Effectief gebruik van middelen
In het geval van een enkele cluster is er slechts één kopie nodig van alle middelen die vereist zijn voor het draaien van de Kubernetes-cluster en het beheer ervan.
Bijvoorbeeld, dit geldt voor master knooppunten. Gewoonlijk zijn er 3 master knooppunten per Kubernetes-cluster, dus voor één enkele cluster blijft dat aantal hetzelfde (ter vergelijking, 10 clusters hebben 30 master knooppunten nodig).
De hierboven genoemde nuance geldt ook voor andere services die op het niveau van de hele cluster functioneren, zoals load balancers, Ingress controllers, authenticatiesystemen, logging en monitoring.
In een enkele cluster kunnen al deze services direct voor alle werkbelastingen worden gebruikt (er hoeven geen kopieën te worden gemaakt, zoals in het geval van meerdere clusters).
+ Goedkoopheid
Als gevolg van het bovenstaande zijn minder clusters meestal goedkoper, omdat er geen kosten zijn voor overbodige middelen.
Dit geldt vooral voor master knooppunten, die aanzienlijke kosten met zich mee kunnen brengen, ongeacht de plaatsingsmethode (on-premises of in de cloud).
Sommige beheerde (managed) Kubernetes-services, zoals of , bieden een gratis managementlaag. In dit geval is de vraag naar kosten minder dringend.
Er zijn ook managed-diensten die een vast bedrag vragen voor het gebruik van elke Kubernetes-cluster (bijvoorbeeld, ).
+ Efficiënt beheer
Het beheren van één cluster is eenvoudiger dan meerdere.
Beheer kan de volgende taken omvatten:
- het updaten van de Kubernetes-versie;
- het instellen van een CI/CD-pijplijn;
- het installeren van de CNI-plugin;
- het configureren van het gebruikersauthenticatiesysteem;
- het installeren van een toegangscontroller;
en nog veel meer…
In het geval van één cluster hoeft u al deze taken maar één keer uit te voeren.
Voor meerdere clusters moeten de operaties herhaaldelijk worden uitgevoerd, wat waarschijnlijk enige automatisering van processen en tools vereist om de systematiek en uniformiteit van het proces te waarborgen.
Laten we nu eens kijken naar de nadelen.
− Enkele punten van falen
Bij een storing van de enige cluster zullen meteen all de workloads uitvallen!
Er zijn talloze scenario's waarin iets mis kan gaan:
- een update van Kubernetes leidt tot onverwachte bijwerkingen;
- een clustercomponent (bijvoorbeeld de CNI-plugin) functioneert niet zoals verwacht;
- een van de clustercomponenten is verkeerd geconfigureerd;
- er is een storing in de onderliggende infrastructuur.
Zo'n incident kan ernstige schade toebrengen aan alle workloads die zijn geplaatst in het gedeelde cluster.
− Gebrek aan strikte isolatie
Werken in een gedeeld cluster betekent dat applicaties hardware, netwerkcapaciteiten en het besturingssysteem op de clusterknopen gezamenlijk gebruiken.
In zekere zin zijn twee containers met twee verschillende applicaties die op dezelfde knoop draaien vergelijkbaar met twee processen die op dezelfde machine worden uitgevoerd onder hetzelfde besturingssysteemkernel.
Linux-containers bieden een zekere mate van isolatie, maar deze is lang niet zo sterk als die welke bijvoorbeeld door virtuele machines wordt geboden. In wezen is een proces in een container hetzelfde proces dat wordt uitgevoerd in het hostbesturingssysteem.
Dit kan een probleem vormen op het gebied van beveiliging: een dergelijke opzet staat theoretisch niet-verwante applicaties toe om met elkaar te communiceren (opzettelijk of per ongeluk).
Daarnaast delen alle werklasten in het Kubernetes-cluster bepaalde clusterbrede diensten, zoals — dit stelt applicaties in staat om de services van andere applicaties in het cluster te vinden.
De hierboven genoemde punten kunnen verschillende betekenissen hebben, afhankelijk van de eisen die aan de beveiliging van applicaties worden gesteld.
Kubernetes biedt verschillende tools om problemen in het beveiligingssysteem te voorkomen, zoals en . Voor een correcte configuratie is echter bepaalde ervaring vereist en bovendien kunnen ze niet alle beveiligingslekken volledig dichten.
Het is belangrijk om altijd in gedachten te houden dat Kubernetes oorspronkelijk is ontworpen voor gedeeld gebruik, en niet voor isolatie en veiligheid.
− Gebrek aan strikte multi-tenancy
Gezien de overvloed aan gedeelde middelen in het Kubernetes-cluster zijn er talloze manieren waarop verschillende applicaties "elkaar in de weg kunnen zitten".
Bijvoorbeeld, een applicatie kan monopolies vormen op een bepaalde gedeelde hulpbron (zoals CPU of geheugen) en andere applicaties die op dezelfde node draaien van toegang tot die hulpbron beroven.
Kubernetes biedt verschillende mechanismen om dit soort gedrag te controleren, zoals (zie ook het artikel ") — bron: vert., en . Zoals met beveiliging, is de configuratie ervan ook behoorlijk complex, en ze zijn niet in staat om alle onvoorziene bijwerkingen volledig te voorkomen.
− Veel gebruikers
In het geval van een enkele cluster moet deze voor veel mensen toegankelijk worden gemaakt. En naarmate het aantal toeneemt, neemt ook het risico toe dat iemand iets "verbreekt".
Binnen het cluster kan worden gecontroleerd wie wat kan doen via (zie het artikel ") — bron: vert.. Het voorkomt echter niet dat gebruikers "iets breken" binnen hun verantwoordelijkheidsgebied.
− Clusters kunnen niet onbeperkt groeien
Een cluster dat wordt gebruikt voor alle werklasten, zal waarschijnlijk behoorlijk groot zijn (qua aantal nodes en pods).
Maar hier doet zich een ander probleem voor: clusters in Kubernetes kunnen niet onbeperkt groeien.
Er is een theoretische limiet aan de grootte van een cluster. In Kubernetes bedraagt deze ongeveer .
Echter, in de echte wereld kunnen problemen veel eerder ontstaan - bijvoorbeeld al bij .
Het probleem is dat grote clusters een hoge belasting op de Kubernetes-besturinglaag veroorzaken. Met andere woorden, om een cluster operationeel te houden en de middelen efficiënt te gebruiken, is zorgvuldige configuratie vereist.
Dit probleem wordt besproken in het betreffende artikel op de oorspronkelijke blog met de titel "».
Maar laten we de tegenovergestelde benadering bekijken: veel kleine clusters.
2. Veel kleine, gespecialiseerde clusters
Bij deze benadering gebruikt u een afzonderlijk cluster voor elk te implementeren element:
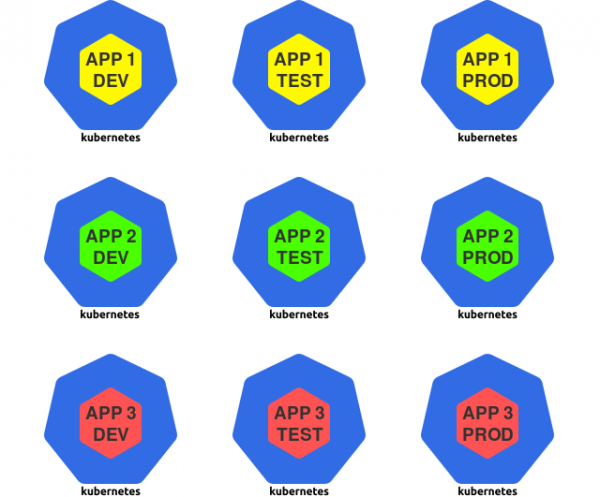
Veel kleine clusters
Voor de doeleinden van dit artikel wordt onder een te implementeren element een instantie van een applicatie verstaan — bijvoorbeeld de dev-versie van een afzonderlijke applicatie.
In deze strategie wordt Kubernetes gebruikt als een gespecialiseerde runtime-omgeving voor afzonderlijke instanties van applicaties.
Laten we de voor- en nadelen van deze aanpak bekijken.
+ Beperkte "explosieradius"
Bij een "mislukking" van een cluster worden de negatieve gevolgen beperkt tot de workloads die in dat cluster zijn geïmplementeerd. Alle andere workloads blijven onaangeroerd.
+ Isolatie
Workloads geplaatst in individuele clusters delen geen gemeenschappelijke middelen, zoals CPU, geheugen, besturingssysteem, netwerk of andere diensten.
Hierdoor krijgen we strikte isolatie tussen niet-verwante applicaties, wat gunstig kan zijn voor hun veiligheid.
+ Weinig gebruikers
Aangezien elk cluster slechts een beperkte set workloads bevat, neemt het aantal gebruikers met toegang tot het cluster af.
Hoe minder mensen toegang hebben tot een cluster, hoe kleiner het risico dat er iets "misgaat".
Laten we nu eens kijken naar de nadelen.
− Inefficiënt gebruik van middelen
Zoals eerder vermeld, heeft elk Kubernetes-cluster een bepaalde set bestuurlijke middelen nodig: master-knooppunten, controlelaagcomponenten, oplossingen voor monitoring en logging.
Bij een groot aantal kleine clusters moet een groter deel van de middelen worden toegewezen aan beheer.
− Kostbaar
Onefficiënt gebruik van middelen leidt automatisch tot hoge kosten.
Bijvoorbeeld, het beheren van 30 masterknooppunten in plaats van drie bij dezelfde rekenkracht zal onvermijdelijk invloed hebben op de kosten.
− Beheercomplexiteit
Het beheren van meerdere Kubernetes-clusters is veel moeilijker dan werken met één cluster.
U moet bijvoorbeeld de authenticatie en autorisatie voor elk cluster configureren. Het updaten van de Kubernetes-versie moet ook meerdere keren gebeuren.
Waarschijnlijk moet automatisering worden toegepast om de efficiëntie van al deze taken te verhogen.
Laten we nu minder extreme scenario's bekijken.
3. Eén cluster per applicatie
Bij deze aanpak creëert u een apart cluster voor alle instanties van een specifieke applicatie:
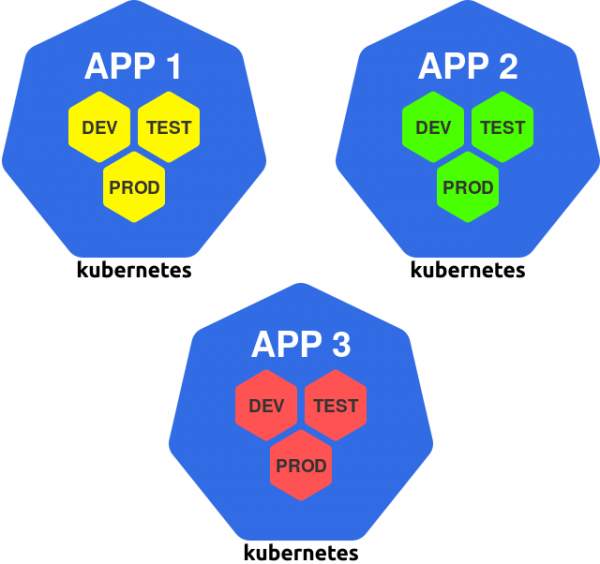
Cluster per applicatie
Deze route kan worden gezien als een uitbreiding van het principe ‘één cluster per team’, aangezien meestal een team ingenieurs verantwoordelijk is voor de ontwikkeling van één of meerdere applicaties.
Laten we de voor- en nadelen van deze aanpak bekijken.
+ Cluster kan worden aangepast aan de applicatie
Als de applicatie speciale behoeften heeft, kunnen deze in het cluster worden geïmplementeerd zonder andere clusters te beïnvloeden.
Dergelijke behoeften kunnen GPU-werknemers, specifieke CNI-plugins, service mesh of een andere service omvatten.
Elk cluster kan worden aangepast aan de applicatie die erin draait, zodat het alleen bevat wat noodzakelijk is.
− Verschillende omgevingen in één cluster
Nadeel van deze aanpak is dat instanties van applicaties uit verschillende omgevingen samenleven in één cluster.
Bijvoorbeeld, de productieversie van de applicatie draait in hetzelfde cluster als de ontwikkelversie. Dit betekent ook dat ontwikkelaars hun werkzaamheden uitvoeren in hetzelfde cluster als waarin de productieversie van de applicatie draait.
Als er door de acties van ontwikkelaars of bugs in de ontwikkelversie een storing in het cluster optreedt, kan dit mogelijk ook de productieversie schaden - een enorm nadeel van deze aanpak.
En tot slot, het laatste scenario op onze lijst.
4. Eén cluster per omgeving
Dit scenario omvat het toewijzen van een apart cluster voor elke omgeving:
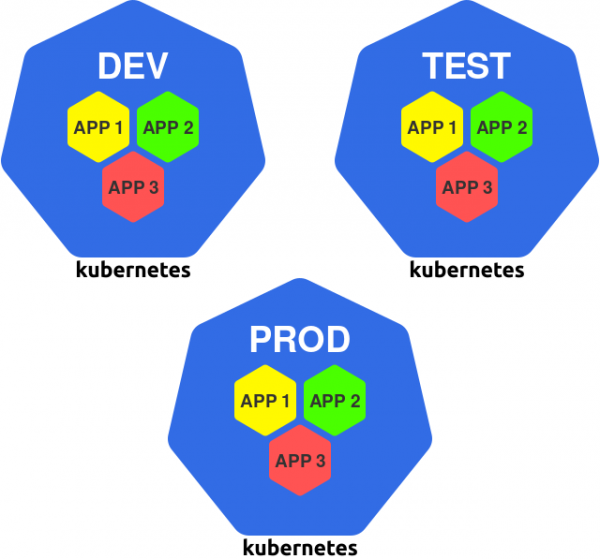
Eén cluster per omgeving
Bijvoorbeeld, u kunt clusters hebben , maar volgt geen wijzigingen), gebruikmakend van een andere configuratie., test en prod, waarin u alle exemplaren van de applicatie zult draaien die zijn bedoeld voor een specifieke omgeving.
Hier zijn de voor- en nadelen van deze benadering.
+ Isolatie van de prod-omgeving
Bij deze aanpak zijn alle omgevingen van elkaar geïsoleerd. Dit is echter vooral belangrijk voor de prod-omgeving.
Productieversies van de applicatie zijn nu niet afhankelijk van wat er in andere clusters en omgevingen gebeurt.
Als er plotseling een probleem in het dev-cluster ontstaat, blijven de prod-versies van de applicaties werken alsof er niets aan de hand is.
+ Cluster kan worden afgestemd op de omgeving
Elk cluster kan worden aangepast aan zijn omgeving. Bijvoorbeeld, men kan:
- ontwikkelings- en debugtools in het dev-cluster installeren;
- testframeworks en tools in het cluster installeren; test;
- krachtiger apparatuur en netwerken in het cluster gebruiken; prod.
Dit verhoogt zowel de effectiviteit van de ontwikkeling als van de operatie van de applicaties.
+ Beperking van de toegang tot de production-cluster
De noodzaak om direct met de prod-cluster te werken komt niet vaak voor, zodat het mogelijk is om het aantal mensen dat toegang heeft aanzienlijk te beperken.
Men kan nog verder gaan en mensen helemaal de toegang tot dit cluster ontzeggen, en alle implementaties uitvoeren met behulp van een geautomatiseerd CI/CD-instrument. Deze aanpak minimaliseert het risico op menselijke fouten juist daar waar dat het meest kritisch is.
Laten we nu eens kijken naar de nadelen.
− Afwezigheid van isolatie tussen applicaties
Het belangrijkste nadeel van deze aanpak is de afwezigheid van hardware- en resource-isolatie tussen applicaties.
Onverwante applicaties delen samen de resources van het cluster: het systeemkern, de processor, het geheugen en enkele andere diensten.
Zoals al eerder vermeld, kan dit potentieel gevaarlijk zijn.
− Niet in staat om afhankelijkheden van applicaties te isoleren
Als een applicatie speciale vereisten heeft, moeten deze in alle clusters worden vervuld.
Bijvoorbeeld, als een applicatie een GPU nodig heeft, moet elk cluster minstens één worker met een GPU bevatten (ook al wordt deze alleen door die applicatie gebruikt).
Het resultaat hiervan is dat we het risico lopen op hogere kosten en een inefficiënt gebruik van resources.
Conclusie
Met een bepaalde set applicaties kunnen ze worden geplaatst in enkele grote clusters of in veel kleine.
In dit artikel worden de voor- en nadelen van verschillende benaderingen besproken, van één grote globale cluster tot meerdere kleine en gespecialiseerde clusters:
- één grote algemene cluster;
- een groot aantal kleine gespecialiseerde clusters;
- één cluster per applicatie;
- één cluster per omgeving.
Dus, welke benadering moet je kiezen?
Zoals gebruikelijk hangt het antwoord af van het gebruiksscenario: je moet de voor- en nadelen van verschillende benaderingen afwegen en de meest optimale optie kiezen.
De keuze is echter niet beperkt tot de bovenstaande voorbeelden — je kunt elke combinatie ervan gebruiken!
Bijvoorbeeld, je kunt voor elk team een paar clusters opzetten: een cluster voor ontwikkeling (met omgevingen , maar volgt geen wijzigingen), gebruikmakend van een andere configuratie. en test) en een cluster voor production (waar de productieomgeving zich zal bevinden).
Op basis van de informatie in dit artikel kun je de voor- en nadelen dienovereenkomstig optimaliseren voor het specifieke scenario. Veel succes!
P.S.
Lees ook op onze blog:
- «»;
- «»;
- «»;
- «».
Bron: habr.com
