

Hallo allemaal. We ontwikkelen een product voor de analyse van offline verkeer. In het project is er een taak gerelateerd aan de statistische analyse van de navigatiepaden van bezoekers door gebieden.
In het kader van deze taak kunnen gebruikers de volgende soorten aanvragen aan het systeem doen:
- hoeveel bezoekers zijn er van gebied "A" naar gebied "B" gegaan;
- hoeveel bezoekers zijn er van gebied "A" naar gebied "B" gegaan via gebied "C", en vervolgens via gebied "D";
- hoeveel tijd het kostte om een bepaald type bezoeker van gebied "A" naar gebied "B" te laten gaan.
en nog een reeks soortgelijke analytische aanvragen.
De beweging van de bezoeker door gebieden stelt een gerichte graaf voor. Na wat onderzoek ontdekte ik dat grafdatabases ook worden gebruikt voor analytische rapporten. Ik had de wens om te zien hoe dergelijke aanvragen zouden worden afgehandeld door grafdatabases (TL;DR; niet goed).
Ik heb gekozen voor de database , als een prominente vertegenwoordiger van grafische open-source databases, die steunt op een stack van volwassen technologieën waarvan ik denk dat ze goede operationele kenmerken zouden moeten bieden:
- de backend opslag BerkeleyDB, Apache Cassandra, Scylla;
- complexe indexen kunnen worden opgeslagen in Lucene, Elasticsearch, Solr.
De auteurs van JanusGraph schrijven dat het geschikt is voor zowel OLTP als OLAP.
Ik heb gewerkt met BerkeleyDB, Apache Cassandra, Scylla en ES, bovendien worden deze producten vaak gebruikt in onze systemen, dus ik keek optimistisch naar het testen van deze grafdatabase. Het leek me een vreemde keuze voor BerkeleyDB in plaats van RocksDB, maar waarschijnlijk heeft dat te maken met de vereisten voor transacties. Hoe dan ook, voor schaalbaar en productief gebruik wordt het aanbevolen om de backend op Cassandra of Scylla te gebruiken.
Neo4j heb ik niet overwogen omdat voor clustering een commerciële versie vereist is, dat wil zeggen dat het product niet open source is.
Grafdatabases zeggen: "Als iets eruitziet als een graaf — behandel het als een graaf!" — prachtig!
Eerst heb ik een graaf getekend die precies volgens de normen van grafdatabases is gemaakt:
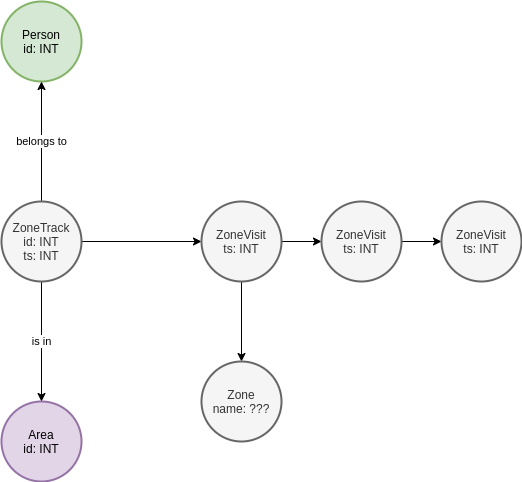
Er is een entiteit Zone, verantwoordelijk voor het gebied. Als ZoneStep tot deze hoort, heeft hij er een verwijzing naar. Let niet op de entiteiten ZoneArea ZoneTrack, , ze behoren tot het domein en worden niet in deze test overwogen. Kortom, zo'n grafische structuur zou er als volgt uitzien voor een aanvraag naar het vinden van ketens:, Person Let op, negeer ze, ze behoren tot het domein en worden in het kader van de test niet overwogen. Kortom, een zoekopdracht naar ketens in een dergelijke grafstructuur zou eruitzien als:
g.V().hasLabel('Zone').has('id',0).in_()
       .repeat(__.out()).until(__.out().hasLabel('Zone').has('id',19)).count().next()
Dit is ongeveer zo in het Nederlands: vind Zone met ID=0, neem alle knooppunten waarvan een rand (ZoneStep) naar haar toe leidt, ga door zonder terug te keren totdat je dergelijke ZoneStep vindt waarvan een rand naar Zone met ID=19 leidt, tel het aantal van dergelijke ketens.
Ik pretendeer geen kennis te hebben van alle nuances van zoeken in grafen, maar deze query is gegenereerd op basis van dit boek ().
Ik heb 50.000 tracks van 3 tot 20 punten in de grafische database JanusGraph geladen, die de BerkeleyDB backend gebruikt, en indices aangemaakt volgens .
Script voor uploaden in Python:
from random import random
from time import time

from init import g, graph

if __name__ == '__main__':

    points = []
    max_zones = 19
    zcache = dict()
    for i in range(0, max_zones + 1):
        zcache[i] = g.addV('Zone').property('id', i).next()

    startZ = zcache[0]
    endZ = zcache[max_zones]

    for i in range(0, 10000):

        if not i % 100:
            print(i)

        start = g.addV('ZoneStep').property('time', int(time())).next()
        g.V(start).addE('belongs').to(startZ).iterate()

        while True:
            pt = g.addV('ZoneStep').property('time', int(time())).next()
            end_chain = random()
            if end_chain < 0.3:
                g.V(pt).addE('belongs').to(endZ).iterate()
                g.V(start).addE('goes').to(pt).iterate()
                break
            else:
                zone_id = int(random() * max_zones)
                g.V(pt).addE('belongs').to(zcache[zone_id]).iterate()
                g.V(start).addE('goes').to(pt).iterate()

            start = pt

    count = g.V().count().next()
    print(count)
Een VM met 4 kernen en 16 GB RAM op SSD werd gebruikt. JanusGraph werd opgestart met het volgende commando:
docker run --name janusgraph -p8182:8182 janusgraph/janusgraph:latestIn dit geval worden de gegevens en indices voor exact-matching opgeslagen in BerkeleyDB. Nadat ik de eerder genoemde query had uitgevoerd, kreeg ik een tijd van enkele tientallen seconden.
Door de 4 bovenstaande scripts parallel uit te voeren, lukte het me om de database in een pompoen te veranderen met een vrolijke stroom van Java-stacks (en we houden allemaal van het lezen van Java-stacks) in de Docker-logboeken.
Na erover nagedacht te hebben, besloot ik het graf schema te vereenvoudigen tot het volgende:
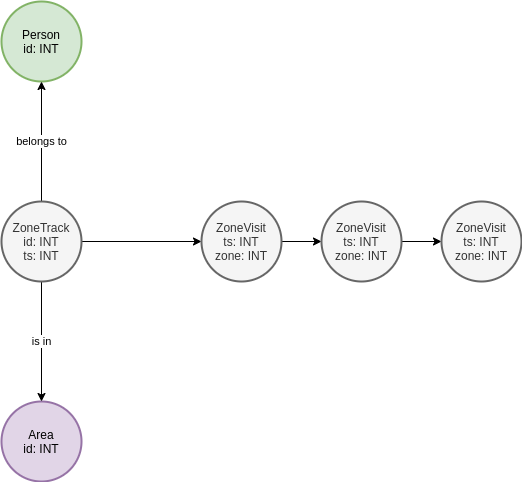
Ik besloot dat zoeken op entiteit attributen sneller zou zijn dan zoeken op randen. Uiteindelijk werd mijn query dus als volgt:
g.V().hasLabel('ZoneStep').has('id',0).repeat(__.out().simplePath()).until(__.hasLabel('ZoneStep').has('id',19)).count().next()Dit is ongeveer zo in het Nederlands: vind ZoneStep met ID=0, ga door zonder terug te keren totdat je ZoneStep met ID=19 vindt, tel het aantal van dergelijke ketens.
Het hierboven genoemde uploadscript heb ik ook vereenvoudigd om geen onnodige verbindingen te creëren, en me beperkt tot de attributen.
De aanvraag werd nog steeds enkele seconden uitgevoerd, wat volkomen onaanvaardbaar was voor onze taak, omdat dit totaal niet geschikt was voor AdHoc-aanvragen van willekeurige aard.
Ik heb geprobeerd JanusGraph uit te rollen met behulp van Scylla, als de snelste implementatie van Cassandra, maar dit leidde ook niet tot significante verbeteringen in de prestaties.
Dus, ondanks dat "het eruitziet als een grafiek", is het me niet gelukt om de grafische database snel te laten werken. Ik vermoed dat ik iets niet weet en dat JanusGraph deze zoekopdracht in fracties van seconden kan uitvoeren, maar dat is me niet gelukt.
Aangezien de taak toch opgelost moest worden, begon ik na te denken over JOINs en draaitabellen, wat niet echt hoopvol klonk qua elegantie, maar op de praktijk geheel bruikbaar kon zijn.
In ons project wordt reeds Apache ClickHouse gebruikt, dus besloot ik mijn bevindingen op deze analytische database uit te proberen.
Ik heb ClickHouse uitgerold volgens een eenvoudig recept:
sudo docker run -d --name clickhouse_1
     --ulimit nofile=262144:262144
     -v /opt/clickhouse/log:/var/log/clickhouse-server
     -v /opt/clickhouse/data:/var/lib/clickhouse
     yandex/clickhouse-server
Ik heb er een database en een tabel van het volgende type aangemaakt:
CREATE TABLE
db.steps (`area` Int64, `when` DateTime64(1, 'Europe/Moscow') DEFAULT now64(), `zone` Int64, `person` Int64)
ENGINE = MergeTree() ORDER BY (area, zone, person) SETTINGS index_granularity = 8192
Ik heb deze gevuld met gegevens met behulp van het volgende script:
from time import time

from clickhouse_driver import Client
from random import random

client = Client('vm-12c2c34c-df68-4a98-b1e5-a4d1cef1acff.domain',
                database='db',
                password='secret')

max = 20

for r in range(0, 100000):

    if r % 1000 == 0:
        print("CNT: {}, TS: {}".format(r, time()))

    data = [{
            'area': 0,
            'zone': 0,
            'person': r
        }]

    while True:
        if random() < 0.3:
            break

        data.append({
                'area': 0,
                'zone': int(random() * (max - 2)) + 1,
                'person': r
            })

    data.append({
            'area': 0,
            'zone': max - 1,
            'person': r
        })

    client.execute(
        'INSERT INTO steps (area, zone, person) VALUES',
        data
    )
Aangezien de inserts in batches plaatsvinden, was het vullen veel sneller dan bij JanusGraph.
Ik heb twee queries geconstrueerd met behulp van JOIN. Voor de doorgang van punt A naar punt B:
SELECT s1.person AS person,
       s1.zone,
       s1.when,
       s2.zone,
       s2.when
FROM
  (SELECT *
   FROM steps
   WHERE (area = 0)
     AND (zone = 0)) AS s1 ANY INNER JOIN
  (SELECT *
   FROM steps AS s2
   WHERE (area = 0)
     AND (zone = 19)) AS s2 USING person
WHERE s1.when <= s2.when
Voor de overgang via 3 punten:
SELECT s3.person,
       s1z,
       s1w,
       s2z,
       s2w,
       s3.zone,
       s3.when
FROM
  (SELECT s1.person AS person,
          s1.zone AS s1z,
          s1.when AS s1w,
          s2.zone AS s2z,
          s2.when AS s2w
   FROM
     (SELECT *
      FROM steps
      WHERE (area = 0)
        AND (zone = 0)) AS s1 ANY INNER JOIN
     (SELECT *
      FROM steps AS s2
      WHERE (area = 0)
        AND (zone = 3)) AS s2 USING person
   WHERE s1.when <= s2.when) p ANY INNER JOIN
  (SELECT *
   FROM steps
   WHERE (area = 0)
     AND (zone = 19)) AS s3 USING person
WHERE p.s2w <= s3.when
De queries zien er natuurlijk best ingewikkeld uit, voor praktisch gebruik moet er een programmatische wrapper-generator worden gemaakt. Ze werken echter en ze werken snel. Zowel de eerste als de tweede query worden in minder dan 0,1 seconden uitgevoerd. Hier is een voorbeeld van de uitvoeringstijd van de query voor count(*) door 3 punten:
SELECT count(*)
FROM
(
    SELECT
        s1.person AS person,
        s1.zone AS s1z,
        s1.when AS s1w,
        s2.zone AS s2z,
        s2.when AS s2w
    FROM
    (
        SELECT *
        FROM steps
        WHERE (area = 0) AND (zone = 0)
    ) AS s1
    ANY INNER JOIN
    (
        SELECT *
        FROM steps AS s2
        WHERE (area = 0) AND (zone = 3)
    ) AS s2 USING (person)
    WHERE s1.when <= s2.when
) AS p
ANY INNER JOIN
(
    SELECT *
    FROM steps
    WHERE (area = 0) AND (zone = 19)
) AS s3 USING (person)
WHERE p.s2w <= s3.when

┌─count()─┐
│   11592 │
└─────────┘
1 rijen in set. Verstreken: 0,068 sec. Verwerkte 250,03 duizend rijen, 8,00 MB (3,69 miljoen rijen/s, 117,98 MB/s.)Opmerking over IOPS. Tijdens het invullen van gegevens genereerde JanusGraph een vrij hoog aantal IOPS (1000-1300 voor vier threads bij het invullen van gegevens), en de IOWAIT was behoorlijk hoog. Tegelijkertijd genereerde ClickHouse een minimale belasting op het opslagsysteem.
Conclusie
We hebben besloten ClickHouse te gebruiken voor het verwerken van dit soort queries. We kunnen de queries altijd verder optimaliseren door gebruik te maken van materialized views en parallelisatie, en door de datastream vooraf te verwerken met Apache Flink voordat we deze in ClickHouse laden.
De prestaties zijn zo goed dat we waarschijnlijk zelfs niet meer na hoeven te denken over pivots van tabellen met programmatische middelen. Eerder moesten we pivots maken van gegevens die uit Vertica werden geëxtraheerd door export naar Apache Parquet.
Helaas was een nieuwe poging om de grafdatabase te gebruiken niet succesvol. Ik ontdekte dat JanusGraph geen vriendelijke ecosysteem heeft dat het eenvoudig maakt om met het product aan de slag te gaan. Voor het configureren van de server wordt de traditionele Java-methode gebruikt, wat mensen zonder ervaring met Java in tranen zal doen uitbarsten:
host: 0.0.0.0
port: 8182
threadPoolWorker: 1
gremlinPool: 8
scriptEvaluationTimeout: 30000
channelizer: org.janusgraph.channelizers.JanusGraphWsAndHttpChannelizer

graphManager: org.janusgraph.graphdb.management.JanusGraphManager
graphs: {
  ConfigurationManagementGraph: conf/janusgraph-cql-configurationgraph.properties,
  airlines: conf/airlines.properties
}

scriptEngines: {
  gremlin-groovy: {
    plugins: { org.janusgraph.graphdb.tinkerpop.plugin.JanusGraphGremlinPlugin: {},
               org.apache.tinkerpop.gremlin.server.jsr223.GremlinServerGremlinPlugin: {},
               org.apache.tinkerpop.gremlin.tinkergraph.jsr223.TinkerGraphGremlinPlugin: {},
               org.apache.tinkerpop.gremlin.jsr223.ImportGremlinPlugin: {classImports: [java.lang.Math], methodImports: [java.lang.Math#*]},
               org.apache.tinkerpop.gremlin.jsr223.ScriptFileGremlinPlugin: {files: [scripts/airline-sample.groovy]}}}}

serializers:
# GraphBinary is here to replace Gryo and Graphson
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GraphBinaryMessageSerializerV1, config: { ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistry] }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GraphBinaryMessageSerializerV1, config: { serializeResultToString: true }}
  # Gryo and Graphson, latest versions
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GryoMessageSerializerV3d0, config: { ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistry] }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GryoMessageSerializerV3d0, config: { serializeResultToString: true }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GraphSONMessageSerializerV3d0, config: { ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistry] }}
  # Older serialization versions for backwards compatibility:
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GryoMessageSerializerV1d0, config: { ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistry] }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GryoMessageSerializerV1d0, config: { serializeResultToString: true }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GryoLiteMessageSerializerV1d0, config: {ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistry] }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GraphSONMessageSerializerGremlinV2d0, config: { ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistry] }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GraphSONMessageSerializerGremlinV1d0, config: { ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistryV1d0] }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GraphSONMessageSerializerV1d0, config: { ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistryV1d0] }}

processors:
  - { className: org.apache.tinkerpop.gremlin.server.op.session.SessionOpProcessor, config: { sessionTimeout: 28800000 }}
  - { className: org.apache.tinkerpop.gremlin.server.op.traversal.TraversalOpProcessor, config: { cacheExpirationTime: 600000, cacheMaxSize: 1000 }}

metrics: {
  consoleReporter: {enabled: false, interval: 180000},
  csvReporter: {enabled: false, interval: 180000, fileName: /tmp/gremlin-server-metrics.csv},
  jmxReporter: {enabled: false},
  slf4jReporter: {enabled: true, interval: 180000},
  gangliaReporter: {enabled: false, interval: 180000, addressingMode: MULTICAST},
  graphiteReporter: {enabled: false, interval: 180000}}
threadPoolBoss: 1
maxInitialLineLength: 4096
maxHeaderSize: 8192
maxChunkSize: 8192
maxContentLength: 65536
maxAccumulationBufferComponents: 1024
resultIterationBatchSize: 64
writeBufferHighWaterMark: 32768
writeBufferHighWaterMark: 65536
ssl: {
  enabled: false}
Ik heb per ongeluk BerkeleyDB versie JanusGraph "neergelegd."
De documentatie is nogal krom als het gaat om indexen, aangezien er bij het beheren van indexen nogal vreemde toeren met Groovy moeten worden uitgehaald. Zo moet het aanmaken van een index gebeuren door code te schrijven in de Gremlin-console (die, trouwens, niet out-of-the-box werkt). Uit de officiële documentatie van JanusGraph:
graph.tx().rollback() \/\/Maak nooit nieuwe indexen aan terwijl een transactie actief is
mgmt = graph.openManagement()
name = mgmt.getPropertyKey('name')
age = mgmt.getPropertyKey('age')
mgmt.buildIndex('byNameComposite', Vertex.class).addKey(name).buildCompositeIndex()
mgmt.buildIndex('byNameAndAgeComposite', Vertex.class).addKey(name).addKey(age).buildCompositeIndex()
mgmt.commit()
\/
\/
Wacht totdat de index beschikbaar is
ManagementSystem.awaitGraphIndexStatus(graph, 'byNameComposite').call()
ManagementSystem.awaitGraphIndexStatus(graph, 'byNameAndAgeComposite').call()
\/
\/
Herindexeer de bestaande gegevens
mgmt = graph.openManagement()
mgmt.updateIndex(mgmt.getGraphIndex("byNameComposite"), SchemaAction.REINDEX).get()
mgmt.updateIndex(mgmt.getGraphIndex("byNameAndAgeComposite"), SchemaAction.REINDEX).get()
mgmt.commit()
Naschrift
Op zekere hoogte is het bovenstaande experiment een vergelijking van warm en zacht. Als je erover nadenkt, voert een grafdatabase andere bewerkingen uit om dezelfde resultaten te verkrijgen. Echter, binnen het kader van de tests heb ik ook een experiment gedaan met een query van de volgende aard:
g.V().hasLabel('ZoneStep').has('id',0)
    .repeat(__.out().simplePath()).until(__.hasLabel('ZoneStep').has('id',1)).count().next()
die de stap-toegankelijkheid weerspiegelt. Echter, zelfs op dergelijke gegevens toonde de grafdatabase een resultaat dat enkele seconden overschreed... Dit heeft natuurlijk te maken met het feit dat er paden waren zoals 0 -> X -> Y ... -> 1, die de grafmotor ook controleerde.
Zelfs voor een query van de volgende aard:
g.V().hasLabel('ZoneStep').has('id',0).out().has('id',1)).count().next()is het me niet gelukt om een snel antwoord te krijgen met een verwerkingstijd van minder dan een seconde.
De moraal van het verhaal is dat een mooi idee en paradigmatisch modelleren niet leiden tot het gewenste resultaat, dat met aanzienlijk meer efficiëntie wordt aangetoond aan de hand van ClickHouse. De use case die in dit artikel wordt gepresenteerd, is een duidelijke antipatroon voor grafdatabases, hoewel deze eruit ziet als een geschikte aanpak voor modelleren binnen hun paradigma.
Bron: habr.com
