

In het eerste deel hebben we uitgelegd waarom we besloten hebben om ons oude BMS-systeem in onze datacentra te vervangen door een nieuw systeem. En niet alleen vervangen, maar vanaf nul ontwikkelen volgens onze eisen. In het tweede deel vertellen we hoe we dit hebben gedaan.
Marktanalyse
Gelet op de hierboven beschreven wensen en de beslissing om af te zien van de update van het bestaande systeem, hebben we een specificatie geschreven voor het zoeken naar een oplossing op de markt en hebben we aanvragen gedaan bij meerdere grote bedrijven die zich alleen bezighouden met het ontwikkelen van industriële SCADA-systemen. De eerste antwoorden die we ontvingen, lieten zien dat de leiders op de markt voor monitoringssystemen voornamelijk blijven werken op fysieke servers, alhoewel het migratieproces naar de cloud in dit segment al is begonnen. Voor wat betreft de backup van virtuele machines - deze optie werd door niemand ondersteund. Sterker nog, het leek erop dat geen van de belangrijke ontwikkelaars op de markt zelfs maar begrijpt dat backup nodig is: 'de cloud valt toch niet uit' was het meest voorkomende antwoord. In feite werd ons voorgesteld om de monitoring van het datacenter in de cloud te plaatsen, welke fysiek zich in hetzelfde datacenter bevond.
Hier moeten we een kleine zijsprong maken over het proces van het kiezen van een aannemer. De prijs is natuurlijk belangrijk, maar tijdens elke aanbesteding voor de uitvoering van een complex project, in de fase van de dialoog met leveranciers, begin je te voelen wie van de kandidaten meer geïnteresseerd is en in staat is om het project te realiseren.
Dit is vooral merkbaar bij complexe projecten.
Op basis van de aard van de verduidelijkende vragen aan de specificatie kunnen we aannemers onderverdelen in degenen die gewoon geïnteresseerd zijn in verkoop (de standaard druk van een verkoper is voelbaar) en degenen die geïnteresseerd zijn in het ontwikkelen van een product, de klant willen horen en begrijpen, constructieve wijzigingen in de specificatie willen aanbrengen zelfs vóór de uiteindelijke keuze (ondanks het reële risico om de specificatie van iemand anders te verbeteren en de aanbesteding te verliezen), en uiteindelijk gewoon bereid zijn om de professionele uitdaging aan te gaan en een goed product te maken.
Dit alles heeft ons doen besluiten om onze aandacht te vestigen op een relatief kleine lokale ontwikkelaar – de groep bedrijven ‘Sanline’, die direct op de meeste van onze eisen heeft gereageerd en klaar was om al onze behoeften met betrekking tot het nieuwe BMS te realiseren.
Dit alles heeft ons doen besluiten om aandacht te besteden aan de relatief kleine lokale ontwikkelaar – de groep van bedrijven "Sunline", die vrijwel direct op de meeste van onze eisen reageerde en bereid was al onze wensen met betrekking tot het nieuwe BMS te realiseren.
Risico's
Terwijl de grote spelers probeerden te begrijpen wat wij willen en een trage correspondentie met ons voerden met de hulp van presale-specialisten, heeft de lokale ontwikkelaar een afspraak in ons kantoor ingepland met zijn technische team. Tijdens deze bijeenkomst toonde de aannemer nogmaals de wil om deel te nemen aan het project en legde vooral uit hoe het vereiste systeem gerealiseerd zal worden.
Voor de bijeenkomst zagen we twee risico's bij het werken met een team dat niet ondersteund wordt door de middelen van een groot nationaal of internationaal bedrijf:
- Specialisten kunnen hun mogelijkheden overschatten en daardoor simpelweg niet in staat zijn om het werk te voltooien; ze zouden bijvoorbeeld complexe software kunnen gebruiken of onhaalbare reserveringsalgoritmes kunnen ontwerpen.
- Na de uitvoering van het project kan het projectteam uiteenvallen, waardoor de ondersteuning van het product in gevaar komt.
Om deze risico's te minimaliseren, hebben we onze eigen ontwikkelingsspecialisten uitgenodigd voor de bijeenkomst. De medewerkers van de potentiële aannemer werden zorgvuldig ondervraagd over de basis van het systeem, hoe de reservering gepland is en over andere vragen waarbij wij, als operationele dienst, niet voldoende bekwaam zijn.
Het oordeel was positief: de architectuur van het bestaande BMS-platform is modern, eenvoudig en betrouwbaar, kan worden verbeterd, en het voorgestelde schema voor reservering en synchronisatie is logisch en uitvoerbaar.
Het eerste risico is aangepakt. Het tweede is uitgesloten, waarbij we van de aannemer bevestiging kregen dat ze bereid zijn om ons de broncode van het systeem en de documentatie over te dragen, en dat we bovendien de programmeertaal Python hebben gekozen, waarmee onze specialisten goed vertrouwd zijn. Dit garandeerde ons de mogelijkheid om het systeem zelf te onderhouden zonder enige moeilijkheden en zonder een langdurige opleidingsperiode voor medewerkers in het geval de ontwikkelende onderneming de markt zou verlaten.
Een bijkomend voordeel van het platform was dat het was geïmplementeerd in Docker-containers: in deze omgeving functioneren de kernel, webinterface en database van het product. Deze aanpak biedt tal van voordelen, waaronder de voorgeconfigureerde instellingen voor de hoogste implementatiesnelheid in vergelijking met de 'klassiekers' en de eenvoudige toevoeging van nieuwe apparaten aan het systeem. Het principe van 'alles samen' vereenvoudigt de implementatie van het systeem maximaal: het is voldoende om het systeem uit te pakken en het kan meteen in gebruik worden genomen.
Met deze oplossing is het eenvoudiger om systeemkopieën te maken, en verbeteringen kunnen in een aparte omgeving worden doorgevoerd, zonder dat de werking van de oplossing als geheel wordt onderbroken.
Nadat beide risico's waren geminimaliseerd, heeft de opdrachtnemer een offerte verstrekt. Hierin zijn alle belangrijke parameters van het BMS-systeem voor ons uitgewerkt.
Redundantie
Het nieuwe BMS-systeem moest in de cloud worden gehost, op een virtuele machine.
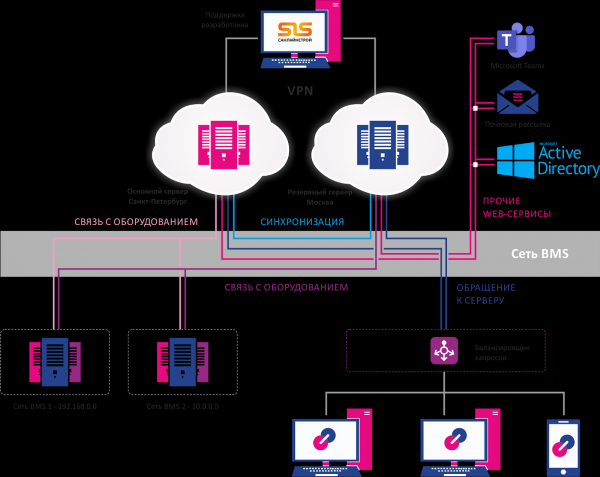
Geen hardware, geen servers en alle ongemakken en risico's die met dit type implementatie gepaard gaan - de cloudoplossing stelde ons in staat om voor altijd van deze problemen af te komen. Er werd besloten dat het systeem zou draaien in onze cloud op twee locaties van datacenters in Sint-Petersburg en Moskou. Dit zijn twee volledig functionele systemen die werken in een active standby-modus met toegang voor alle geautoriseerde specialisten.
De twee systemen verzekeren elkaar, waardoor volledige redundantie op zowel rekencapaciteit als dataverbindingen wordt gegarandeerd. Er zijn ook aanvullende beveiligingsmaatregelen ingesteld, waaronder gegevens- en kanaalback-ups, back-ups van systemen en virtuele machines als geheel, en een aparte database-back-up eenmaal per maand (de meest waardevolle hulpbron op het gebied van beheer en analyse).
Het is belangrijk op te merken dat de back-upoptie als onderdeel van de BMS-oplossing speciaal was ontwikkeld op onze aanvraag. Het back-upschema zag er als volgt uit:
Ondersteuning
Een cruciaal punt voor een effectieve werking van de BMS-oplossing is de klantenservice.
Hier is het simpel: het nieuwe systeem zou ons volgens deze indicator 35.000 roebel per maand kosten voor SLA 'reactie binnen 8 uur', dat wil zeggen 35.000 x 12 / 80 = $5.250 per jaar. Het eerste jaar is gratis.
Ter vergelijking: de ondersteuning van de oude BMS van de leverancier kostte $18.000 per jaar, met een verhoging van het bedrag voor elk nieuw toegevoegd apparaat! Bovendien verstrekte het bedrijf geen toegewezen manager, alle interactie verliep via de verkoopmanager, die in ons geïnteresseerd was als potentiële koper, met een overeenkomstige focus op de afhandeling van verzoeken.
Voor minder geld kregen we volledige productondersteuning, met een accountmanager die betrokken was bij de productontwikkeling, met een enkele toegangspunt, enzovoort. De ondersteuning werd aanzienlijk flexibeler – dankzij directe toegang tot de ontwikkelaars voor snelle aanpassingen aan alle aspecten van het systeem, integratie via API, enzovoort.
Updates
In het aangeboden voorstel voor de nieuwe BMS zijn alle updates inbegrepen in de ondersteuningskosten, dat wil zeggen, ze vereisen geen extra betaling. Een uitzondering vormt de ontwikkeling van extra functionaliteit bovenop wat is aangegeven in de specificaties.
Het oude systeem vereiste betalingen voor zowel updates van de ingebouwde gratis software (zoals Java) als voor bugfixes. We konden hier niet vanaf, zonder updates 'vertraagde' het systeem als geheel vanwege oude versies van interne componenten.
En natuurlijk kon de software niet worden bijgewerkt zonder het kopen van een ondersteuningspakket.
Flexibele aanpak
Een andere belangrijke eis betreft de interface. We wilden toegang bieden via een webbrowser vanaf elke locatie, zonder dat een ingenieur ter plaatse in de datacenter aanwezig moest zijn. Daarnaast streefden we naar de ontwikkeling van een geanimeerde interface, zodat de dynamiek van de werking van de infrastructuur duidelijker zichtbaar zou zijn voor de onderhoudsingenieurs.
Ook moest het nieuwe systeem ondersteuning bieden voor formules voor het berekenen van de werking van virtuele sensors in technische systemen – bijvoorbeeld voor de optimale verdeling van elektrische vermogens over racks met apparatuur. Hiervoor moeten alle gebruikelijke wiskundige bewerkingen, toepasbaar op sensorwaarden, tot onze beschikking staan.
Vervolgens was toegang nodig tot de SQL-database om de benodigde gegevens over de werking van de apparatuur te verkrijgen – met name alle records van de monitoring van twee duizend apparaten en twee duizend virtuele sensoren, die ongeveer 20 duizend variabelen genereren.
Er was ook een module voor het bijhouden van apparatuur in de rack nodig, die een grafische weergave geeft van de locatie van de apparaten in elke eenheid, met een berekening van het totale gewicht van de ‘hardware’, het bijhouden van een bibliotheek van apparaten en gedetailleerde informatie over elk element.
Afstemming van de specificaties en ondertekening van het contract
Op het moment dat we moesten beginnen met het werken aan het nieuwe systeem, was de correspondentie met de 'grote' bedrijven nog ver verwijderd van het bespreken van de kosten van hun voorstellen, daarom hebben we de ontvangen offerte vergeleken met de kosten voor het upgraden van het oude BMS (zie ), en uiteindelijk bleek deze aantrekkelijker geprijsd en voldeed aan onze eisen.
De keuze is gemaakt.
Na de keuze van de aannemer begonnen de juristen met het opstellen van het contract, terwijl de technische teams aan beide zijden de specificaties verfijnden. Zoals bekend is een gedetailleerde en nauwkeurige specificatie de basis voor het succes van elk project. Hoe meer details in de specificatie, hoe minder teleurstellingen over dingen zoals 'maar we bedoelden het anders'.
Ik geef twee voorbeelden van het detailniveau van de eisen in de specificatie:
- De nachtelijke datacenters hebben de bevoegdheid om nieuwe apparaten aan de BMS toe te voegen, meestal zijn dit PDU’s. In het oude BMS was dit op ‘administrator-niveau’, wat ook de mogelijkheid gaf om de instellingen van alle apparaten te wijzigen, en het was niet mogelijk om deze functies te scheiden. Dit beviel ons niet. In de bestaande basisversie van het nieuwe platform was het schema vergelijkbaar. We hebben meteen in de specificatie aangegeven dat we deze rollen willen scheiden: alleen bevoegde medewerkers mogen de instellingen wijzigen, maar de diensten moeten nog steeds in staat zijn om apparaten toe te voegen. Dit schema werd aangenomen voor implementatie.
- In elk standaard BMS zijn er drie typische categorieën van meldingen: RODE – onmiddellijke actie vereist, GELE – kan worden waargenomen, BLAUWE – ‘Informatie’. Wij hebben traditioneel ‘blauwe’ meldingen gebruikt om de overschrijding van commerciële parameters te monitoren, bijvoorbeeld de overschrijding van de capaciteit limiet van de klant rack. Dit type melding was in ons geval bedoeld voor managers en was niet interessant voor de exploitatiemiddelen, maar in de oude BMS vulden ze regelmatig de lijst met actieve incidenten en hinderden ze de operationele werkzaamheden. We beschouwden zelf de logica en kleurenscheiding van de meldingen als geslaagd en behielden deze, echter in de technische specificatie werd expliciet aangegeven dat ‘blauwe’ meldingen, zonder de bewakers af te leiden, stilletjes in een aparte sectie moesten worden geplaatst, waar commerciële specialisten zich ermee zouden bezighouden.
Met een vergelijkbaar detailniveau werden de formaten voor het opstellen van grafieken en rapportages, de contouren van de interfaces, de lijst van apparaten die gemonitord moesten worden en nog vele andere zaken beschreven.
Dit was echt een creatieve taak van drie werkgroepen – de klantendienst, die zijn eisen en voorwaarden dicteerde; technische specialisten van beide zijden, waarvan de taak was om deze voorwaarden om te zetten in technische documentatie; en het team van programmeurs van de aannemer, die de eisen van de klant volgens de opgestelde technische documentatie implementeerden… In het resultaat hebben we sommige van onze niet-principiële eisen aangepast aan de functionaliteit van het reeds bestaande platform, terwijl de aannemer zich verplichtte om andere voor ons toe te voegen.
Gelijktijdige werking van twee systemen
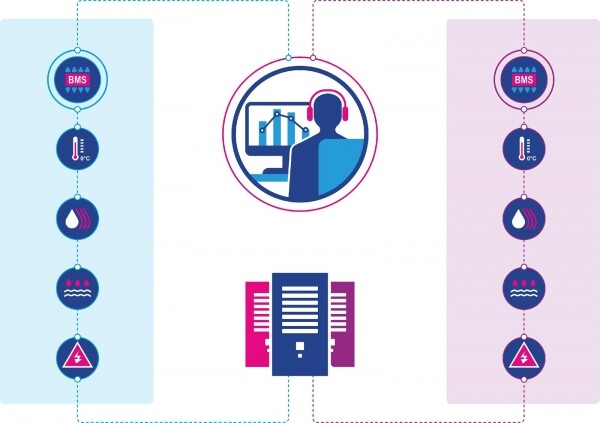
De tijd voor implementatie was gekomen. In de praktijk betekende dit dat we de aannemer de mogelijkheid gaven om een prototype BMS in onze virtuele cloud te implementeren en netwerktoegang te bieden tot alle apparaten die monitoring vereisten.
Tegelijkertijd was het nieuwe systeem nog niet klaar voor gebruik. In dit stadium was het voor ons belangrijk om de monitoring in het oude systeem te behouden en tegelijkertijd toegang tot de apparaten voor het nieuwe systeem te geven. Het is onmogelijk om een systeem goed te bouwen als je geen zicht hebt op de apparaten, die op hun beurt niet kunnen worden losgekoppeld van de monitoring van het oude systeem.
Of het apparaat gelijktijdige polling door twee systemen aankan, was niet duidelijk zonder echte tests. Er was een kans dat dubbele gelijktijdige polling zou leiden tot frequente antwoorduitval van de apparaten en we zouden tal van fouten ontvangen wegens onbereikbare apparaten, wat op zijn beurt de werking van het oude bewakingssysteem zou blokkeren.
De netwerkafdeling heeft virtuele routes van het prototype van het nieuwe BMS, uitgerold in de cloud, naar de apparaten gelegd, en we hebben de resultaten ontvangen:
- apparaten die via het SNMP-protocol zijn aangesloten, vielen praktisch niet weg door gelijktijdige verzoeken,
- apparaten die via gateways zijn aangesloten via modbus-TCP-protocollen, hadden problemen die werden opgelost door de pollingfrequentie redelijk te verlagen.
En vervolgens begonnen we te observeren hoe er voor onze ogen een nieuw systeem werd opgebouwd, waarin al bekende apparaten verschijnen, maar in een andere interface - gebruiksvriendelijk, snel, toegankelijk zelfs vanaf een telefoon.
Over wat er uiteindelijk is ontstaan, zullen we in het derde deel van ons artikel vertellen.
Bron: habr.com
