

Dit artikel helpt je te begrijpen hoe load balancing werkt in Kubernetes, wat er gebeurt bij het schalen van langdurige verbindingen en waarom je load balancing aan de clientzijde zou moeten overwegen als je HTTP/2, gRPC, RSockets, AMQP of andere langdurige protocollen gebruikt.
Een beetje over hoe het verkeer in Kubernetes wordt herschikt
Kubernetes biedt twee handige abstracties voor het uitrollen van applicaties: services en deployments.
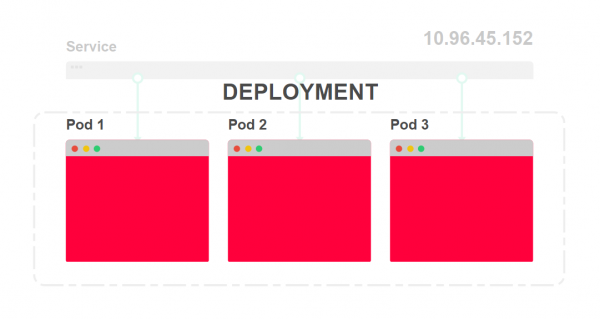
Deployments beschrijven hoe en hoeveel exemplaren van jouw applicatie op elk moment moeten draaien. Elke applicatie wordt uitgerold als een pod en krijgt een IP-adres toegewezen.
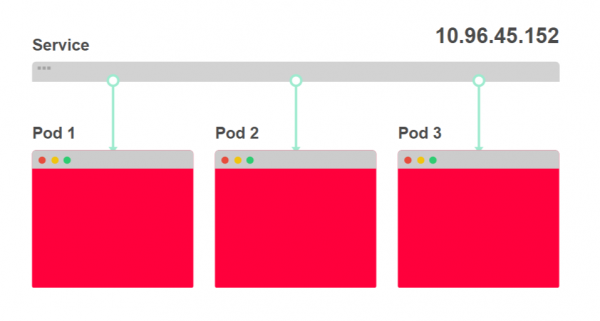
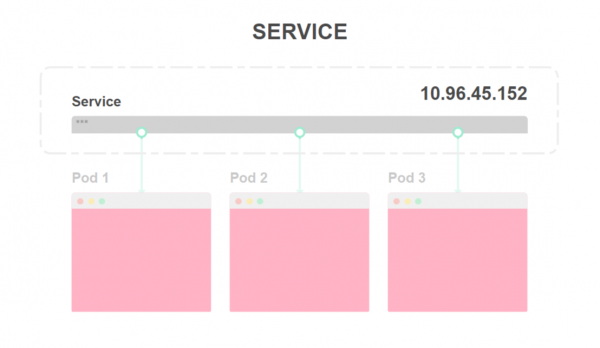
Services fungeren functioneel als een load balancer. Ze zijn bedoeld om het verkeer over meerdere pods te verdelen.
Laten we eens kijken hoe dit eruitziet.
- In het diagram hieronder zie je drie instanties van één applicatie en een load balancer:

- De load balancer wordt een service genoemd, en deze krijgt een IP-adres toegewezen. Elke binnenkomende aanvraag wordt doorgestuurd naar een van de pods:

- Het deployment scenario bepaalt het aantal instanties van de applicatie. Je hoeft vrijwel nooit een pod direct uit te rollen:

- Elke pod krijgt zijn eigen IP-adres toegewezen:

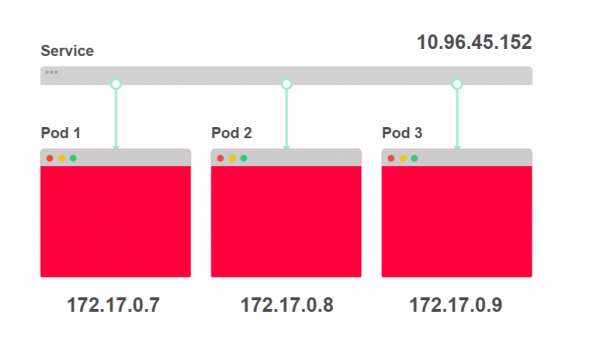
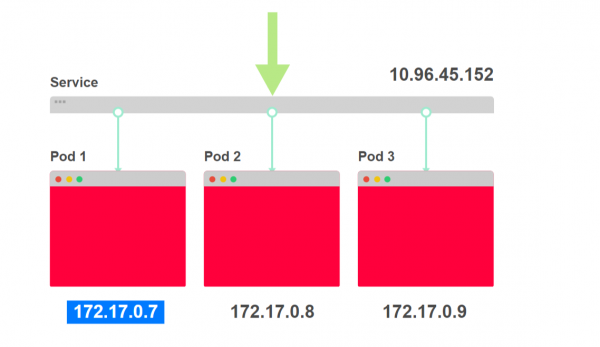
Het is nuttig om services te beschouwen als een set IP-adressen. Elke keer dat je een service aanroept, wordt een van de IP-adressen uit de lijst geselecteerd en gebruikt als bestemmingsadres.
Zo ziet het eruit.
- Een curl-verzoek naar 10.96.45.152 naar de service komt binnen:

- De service kiest een van de drie pod-adressen als bestemmingspunt:

- Het verkeer wordt doorgestuurd naar een specifieke pod:


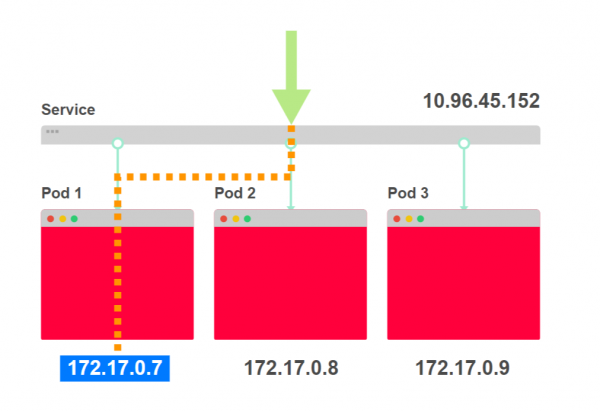
Als jouw applicatie uit een frontend en een backend bestaat, heb je zowel een service als een deployment voor elk.
Wanneer de frontend een verzoek doet aan de backend, hoeft hij niet te weten hoeveel pods de backend bedient: het kunnen er één, tien of honderd zijn.
Bovendien weet de frontend niets van de pod-adressen die de backend bedienen.
Wanneer de frontend een verzoek doet aan de backend, gebruikt hij het IP-adres van de backend-service, dat niet verandert.
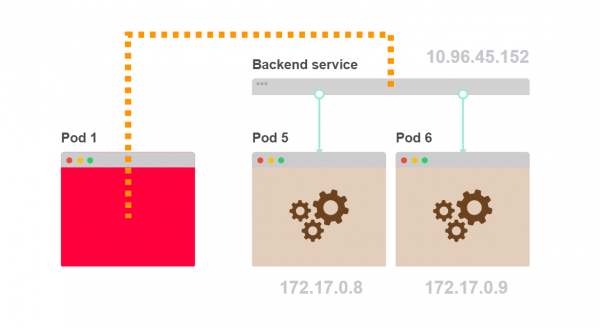
Zo ziet dat eruit.
- Pod 1 vraagt een interne component van de backend aan. In plaats van een specifieke pod van de backend te selecteren, doet hij een verzoek aan de service:

- De service kiest een van de backend-pods als bestemming:

- Verkeer gaat van pod 1 naar pod 5, geselecteerd door de service:

- Pod 1 weet niet hoeveel pods, zoals pod 5, er achter de service verborgen zijn:

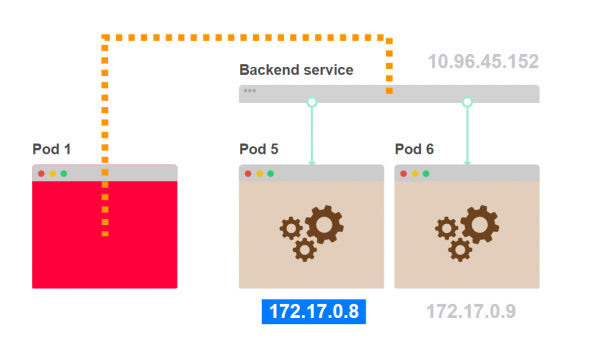
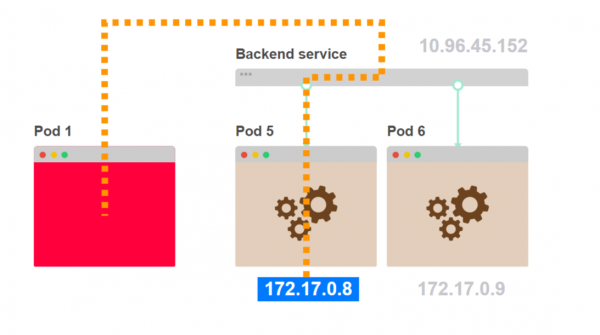
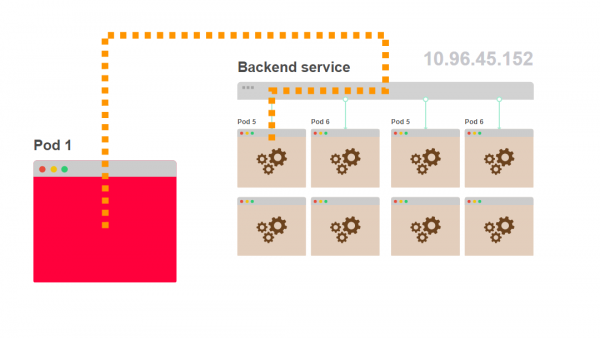
Maar hoe verdeelt de service precies de verzoeken? Wordt er blijkbaar gebruikgemaakt van round-robin load balancing? Laten we het uitzoeken.
Load balancing in Kubernetes-services
Kubernetes-services bestaan niet. Voor de service is er geen proces dat een IP-adres en poort toegewezen krijgt.
U kunt dit verifiëren door op een knoop in het cluster te gaan en het commando netstat -ntlp uit te voeren.
U zult zelfs het IP-adres dat aan de service is toegewezen, niet kunnen vinden.
Het IP-adres van de service bevindt zich in de behe laag, in de controller, en is opgeslagen in de database - etcd. Dit adres wordt ook gebruikt door een andere component - kube-proxy.
Kube-proxy ontvangt de lijst van IP-adressen voor alle services en vormt een set iptables-regels op elke knoop in het cluster.
Deze regels zeggen: 'Als we het IP-adres van de service zien, moeten we het bestemmingsadres van het verzoek aanpassen en dit naar een van de pods sturen.'
Het IP-adres van de service wordt alleen gebruikt als inlogpunt en wordt niet beheerd door een proces dat naar dit IP-adres en poort luistert.
Laten we hiernaar kijken.
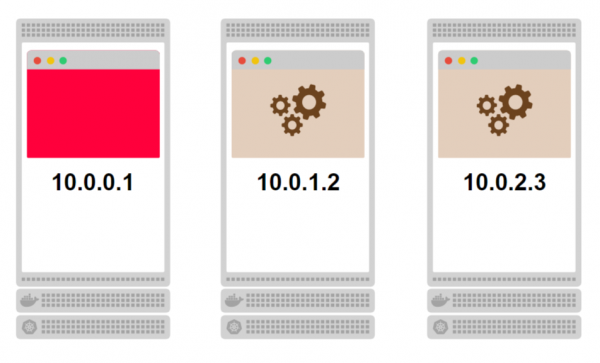
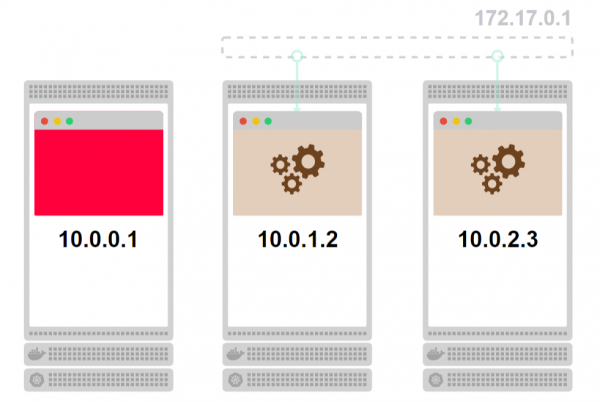
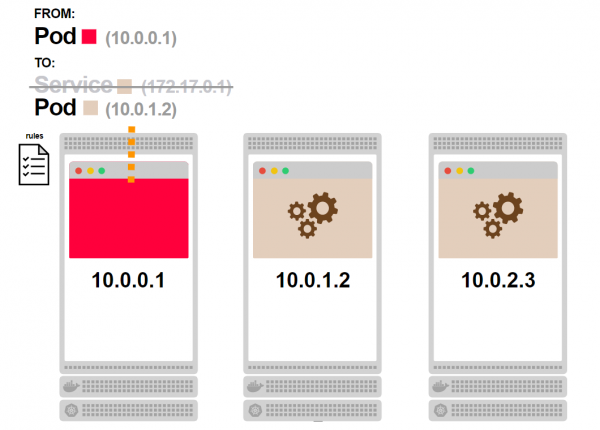
- Laten we een cluster bekijken met drie knopen. Op elke knoop zijn er pods aanwezig:

- Gerelateerde pods, gemarkeerd in beige, maken deel uit van de service. Aangezien de service niet bestaat als proces, wordt deze in grijs weergegeven:

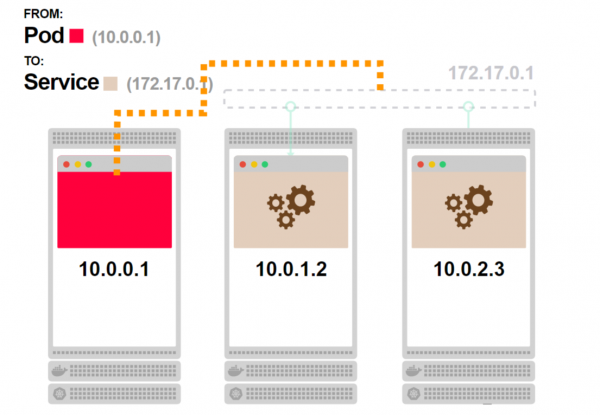
- De eerste pod vraagt de service aan en moet een van de gerelateerde pods bereiken:

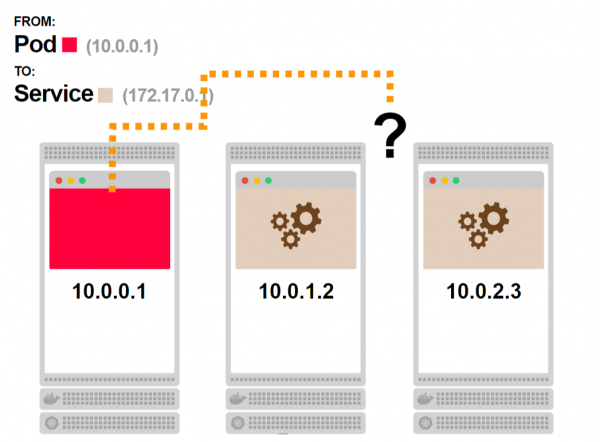
- Maar de service bestaat niet, er is geen proces. Hoe werkt dit?

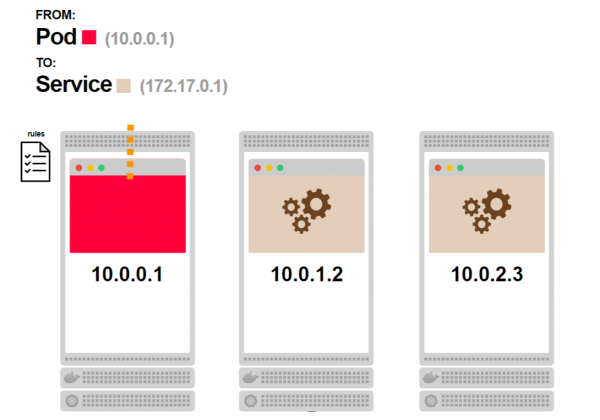
- Voordat het verzoek de knoop verlaat, gaat het door de iptables-regels:

- De iptables-regels weten dat de service er niet is en vervangen het IP-adres door een van de IP-adressen van de pods die aan deze service zijn gekoppeld:

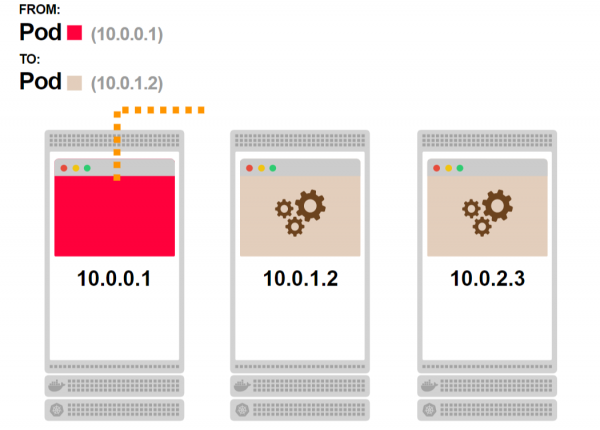
- Het verzoek krijgt een geldig IP-adres als bestemmingsadres en wordt normaal verwerkt:
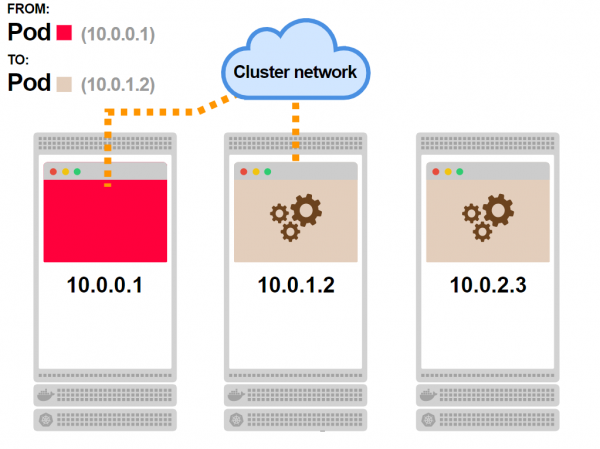
- Afhankelijk van de netwerktopologie bereikt het verzoek uiteindelijk de pod:

Kunnen iptables de belasting balanceren?
Nee, iptables worden gebruikt voor filtering en zijn niet ontworpen voor load balancing.
Er is echter de mogelijkheid om een set regels te schrijven die werkt als een .
En dit is precies wat in Kubernetes is geïmplementeerd.
Als u drie pods heeft, schrijft kube-proxy de volgende regels:
- Kies de eerste pod met een kans van 33%, anders ga verder naar de volgende regel.
- Select the second pod with a 50% probability, otherwise proceed to the next rule.
- Select the third pod.
This system results in each pod being selected with a 33% probability.
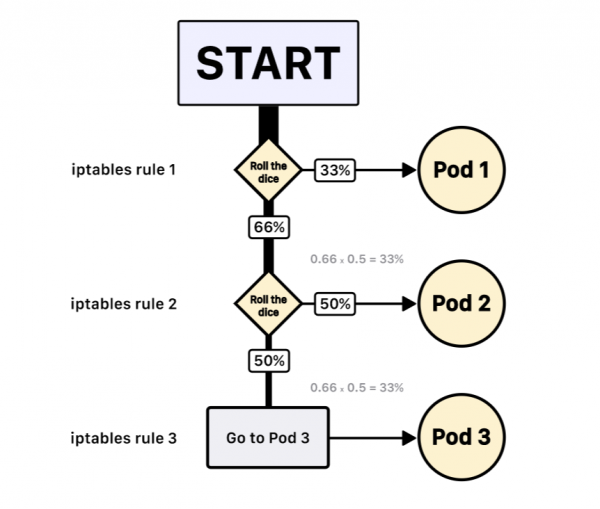
And there is no guarantee that pod 2 will be selected next after pod 1.
Opmerking: iptables uses a statistical module with random distribution. Thus, the load balancing algorithm is based on random selection.
Now that you understand how services work, let's look at some more interesting usage scenarios.
Long-lived connections in Kubernetes do not scale by default.
Each HTTP request from the frontend to the backend is serviced by a separate TCP connection, which is opened and closed.
If the frontend sends 100 requests per second to the backend, 100 different TCP connections will be opened and closed.
You can reduce the request processing time and decrease the load by opening one TCP connection and using it for all subsequent HTTP requests.
The HTTP protocol has a feature called HTTP keep-alive, or connection reuse. In this case, one TCP connection is used to send and receive multiple HTTP requests and responses:
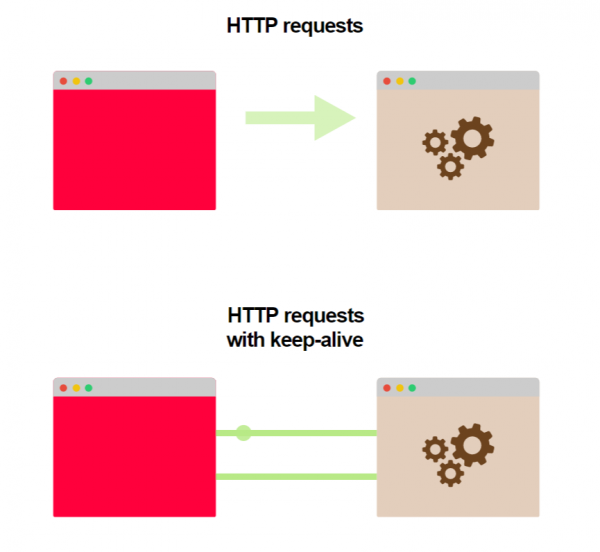
This feature is not enabled by default: both the server and client must be configured accordingly.
The configuration itself is simple and accessible for most programming languages and environments.
Here are some links to examples in different languages:
What happens if we use keep-alive in a Kubernetes service?
Let's assume that both the frontend and backend support keep-alive.
We have one copy of the frontend and three instances of the backend. The frontend makes the first request and opens a TCP connection to the backend. The request reaches the service, and one of the backend pods is selected as the destination address. The backend pod sends a response, and the frontend receives it.
Unlike the usual situation where the TCP connection is closed after receiving the response, it is now kept open for subsequent HTTP requests.
What happens if the frontend sends more requests to the backend?
An open TCP connection will be used to forward these requests, and all requests will go to the same backend pod where the first request was sent.
Moet iptables het verkeer niet herverdelen?
Niet in dit geval.
Wanneer een TCP-verbinding wordt opgezet, gaat deze door de iptables-regels, die bepalen naar welke specifieke pod van de backend het verkeer zal gaan.
Aangezien alle volgende verzoeken via de reeds geopende TCP-verbinding gaan, worden de iptables-regels niet meer aangeroepen.
Laten we eens kijken hoe dit eruitziet.
- De eerste pod stuurt een verzoek naar de service:

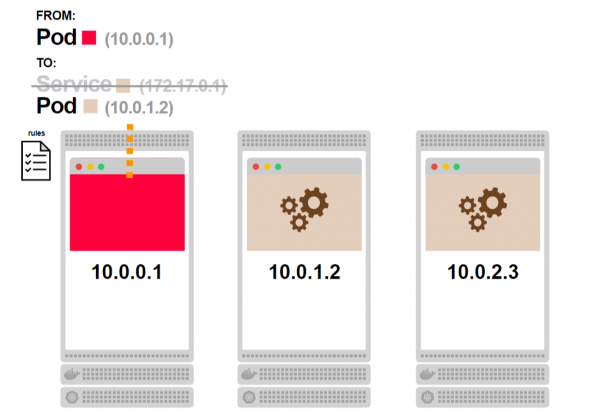
- Je weet al wat er verder gaat gebeuren. De service bestaat niet, maar er zijn iptables-regels die het verzoek zullen verwerken:
- Een van de backend-pods zal worden geselecteerd als bestemmingsadres:

- Het verzoek bereikt de pod. Op dit moment zal een permanente TCP-verbinding tussen de twee pods worden ingesteld:

- Een volgend verzoek van de eerste pod zal via de reeds gevestigde verbinding gaan:

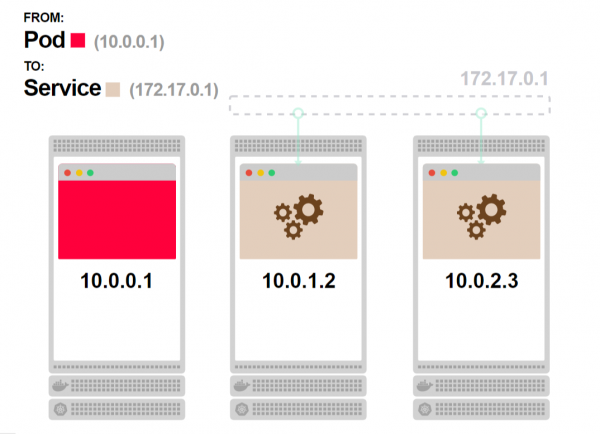
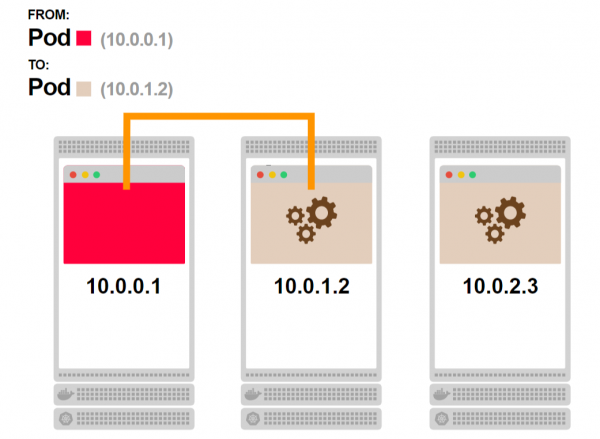
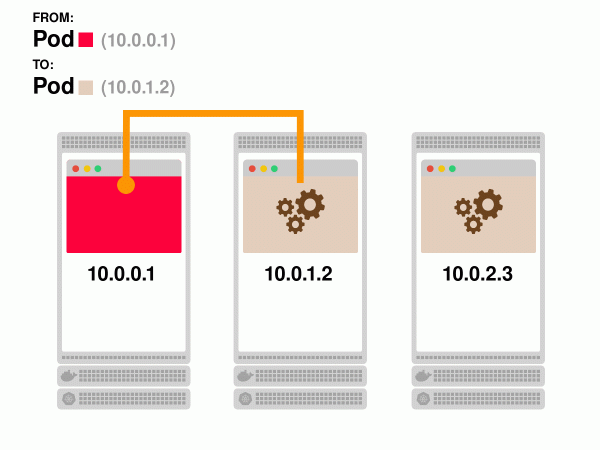
Dit resulteert in een snellere respons en een hogere doorvoersnelheid, maar je hebt de mogelijkheid tot schaling van de backend verloren.
Zelfs als je twee pods in de backend hebt, zal het verkeer steeds naar een van hen gaan bij een permanente verbinding.
Kan dit worden opgelost?
Aangezien Kubernetes niet weet hoe hij permanente verbindingen moet balanceren, ligt deze taak bij jou.
Services zijn een verzameling IP-adressen en poorten, die eindpunten worden genoemd.
Je applicatie kan een lijst van eindpunten van de service krijgen en beslissen hoe verzoeken ertussen te verdelen. Je kunt een permanente verbinding met elke pod openen en de verzoeken tussen deze verbindingen balanceren via round-robin.
Of meer .
De client-side code die verantwoordelijk is voor de balans moet deze logica volgen:
- Haal de lijst van eindpunten van de service op.
- Open een permanente verbinding voor elk eindpunt.
- Wanneer je een verzoek moet doen, gebruik een van de geopende verbindingen.
- Werk regelmatig de lijst van eindpunten bij, maak nieuwe permanente verbindingen of sluit oude af wanneer de lijst verandert.
Zo zal het eruitzien..
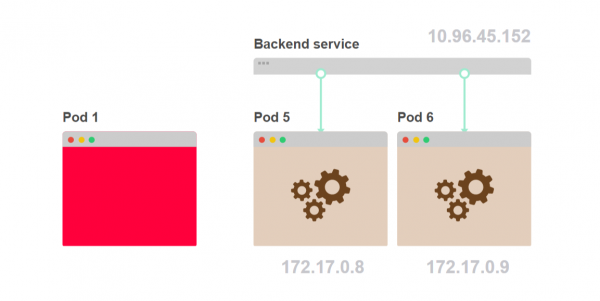
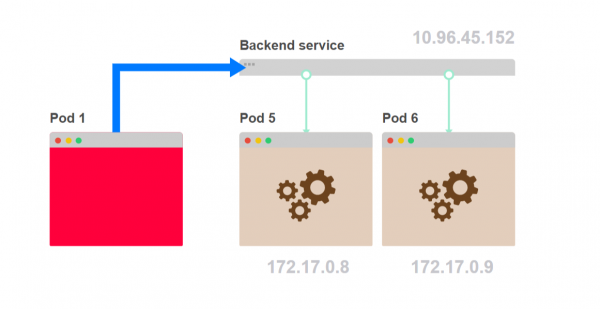
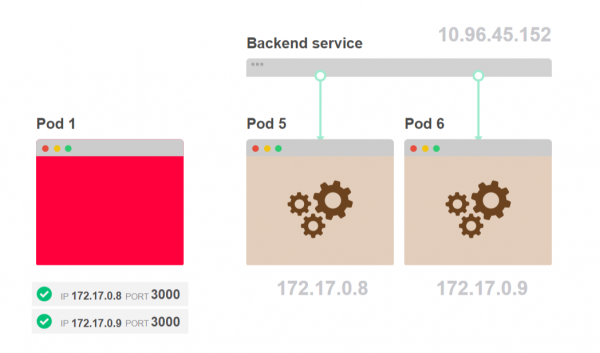
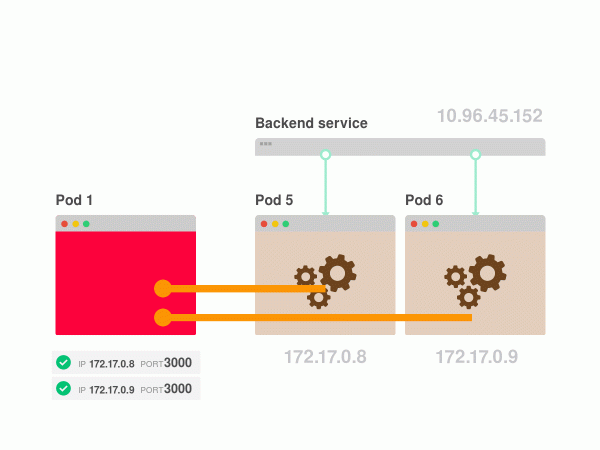
- In plaats van dat de eerste pod een verzoek naar de service stuurt, kun je de verzoeken aan de client-side balanceren:

- Je moet code schrijven die vraagt welke pods onderdeel zijn van de service:

- Zodra je de lijst hebt, sla je deze op aan de client-side en gebruik je deze voor verbindingen met de pods:

- U bent zelf verantwoordelijk voor het load balancing-algoritme:
Nu is de vraag: geldt dit probleem alleen voor HTTP keep-alive?
Load balancing aan de clientzijde
HTTP is niet het enige protocol dat constante TCP-verbindingen kan gebruiken.
Als uw applicatie een database gebruikt, wordt de TCP-verbinding niet elke keer opnieuw geopend wanneer u een query moet uitvoeren of een document uit de database wilt ophalen.
In plaats daarvan wordt er een constante TCP-verbinding met de database geopend en gebruikt.
Als uw database in Kubernetes is uitgerold en de toegang wordt verleend via een service, dan zult u tegen dezelfde problemen aanlopen zoals beschreven in het vorige gedeelte.
Één database-replica zal zwaarder belast worden dan de anderen. Kube-proxy en Kubernetes helpen niet bij het balanceren van verbindingen. U moet zorgen voor de balans van verzoeken naar uw database.
Afhankelijk van welke bibliotheek u gebruikt voor de verbinding met de database, kunt u verschillende oplossingen voor dit probleem hebben.
Hieronder staat een voorbeeld van toegang tot een MySQL-databasecluster vanuit Node.js:
var mysql = require('mysql');
var poolCluster = mysql.createPoolCluster();

var endpoints = /* haal eindpunten op van de service */

for (var [index, endpoint] of endpoints) {
  poolCluster.add(`mysql-replica-${index}`, endpoint);
}

// Maak queries naar de geclusterde MySQL-database
Er zijn tal van andere protocollen die constante TCP-verbindingen gebruiken:
- WebSockets en beveiligde WebSockets
- HTTP/2
- gRPC
- RSockets
- AMQP
U moet al bekend zijn met de meeste van deze protocollen.
Maar als deze protocollen zo populair zijn, waarom is er dan geen gestandaardiseerde oplossing voor load balancing? Waarom is er een wijziging van de clientlogica nodig? Is er een native oplossing in Kubernetes?
Kube-proxy en iptables zijn ontworpen om de meeste standaard gebruiksscenario's te dekken bij het uitrollen in Kubernetes. Dit is gedaan voor het gemak.
Als u een webservice gebruikt die een REST API biedt, heeft u geluk — in dat geval worden geen constante TCP-verbindingen gebruikt, en kunt u elke Kubernetes-service gebruiken.
Maar zodra u constante TCP-verbindingen begint te gebruiken, moet u uitzoeken hoe u de belasting gelijkmatig over de backends kunt verdelen. Kubernetes biedt hiervoor geen kant-en-klare oplossingen.
Er zijn echter natuurlijk opties die kunnen helpen.
Load balancing van langdurige verbindingen in Kubernetes
In Kubernetes zijn er vier soorten services:
- ClusterIP
- NodePort
- LoadBalancer
- Headless
De eerste drie services werken op basis van een virtueel IP-adres, dat door kube-proxy wordt gebruikt voor het opstellen van iptables-regels. De fundamentele basis van alle services is echter een headless service.
Een headless service is niet gekoppeld aan een IP-adres en biedt alleen een mechanisme om een lijst van IP-adressen en poorten van de daaraan gekoppelde pods (eindpunten) te verkrijgen.
Alle services zijn gebaseerd op de headless service.
De ClusterIP-service is een headless service met enkele aanvullingen:
- De behe laag wijst een IP-adres toe.
- Kube-proxy vormt de benodigde iptables-regels.
Zo kunt u kube-proxy negeren en rechtstreeks de lijst van eindpunten gebruiken, verkregen uit de headless service, voor load balancing in uw applicatie.
Maar hoe voeg je een dergelijke logica toe aan alle applicaties die in de cluster zijn geïmplementeerd?
Als uw applicatie al is geïmplementeerd, kan deze taak onuitvoerbaar lijken. Er is echter een alternatieve optie.
Service Mesh kan u helpen
U heeft waarschijnlijk al opgemerkt dat de load balancing-strategie aan de clientzijde vrij standaard is.
Wanneer de applicatie opstart, doet deze het volgende:
- Verkrijgt een lijst van IP-adressen van de service.
- Opent en onderhoudt een pool van verbindingen.
- Werkt periodiek de pool bij door eindpunten toe te voegen of te verwijderen.
Zodra de applicatie een verzoek wil indienen, doet deze het volgende:
- Kiest een beschikbare verbinding met behulp van enige logica (bijvoorbeeld round-robin).
- Voert het verzoek uit.
Deze stappen werken voor zowel WebSockets- als gRPC- en AMQP-verbindingen.
U kunt deze logica in een aparte bibliotheek isoleren en gebruiken in uw applicaties.
Maar in plaats daarvan kunt u servicenetwerken gebruiken, zoals Istio of Linkerd.
Service Mesh voegt een proces aan uw applicatie toe dat:
- Automatisch IP-adressen van services zoekt.
- Verbindingen controleert, zoals WebSockets en gRPC.
- Verzoeken balanceert met behulp van het juiste protocol.
Service Mesh helpt het verkeer binnen de cluster te beheren, maar is vrij resource-intensief. Andere opties zijn het gebruik van externe bibliotheken, zoals Netflix Ribbon, of programmeerbare proxies, zoals Envoy.
Wat gebeurt er als u het probleem van load balancing negeert?
U kunt load balancing niet gebruiken en toch geen veranderingen opmerken. Laten we een paar scenario's bekijken.
Als u meer klanten heeft dan servers, is dat niet zo'n groot probleem.
Stel dat er vijf klanten zijn die verbinding maken met twee servers. Zelfs als er geen load balancing is, zullen beide servers worden gebruikt:
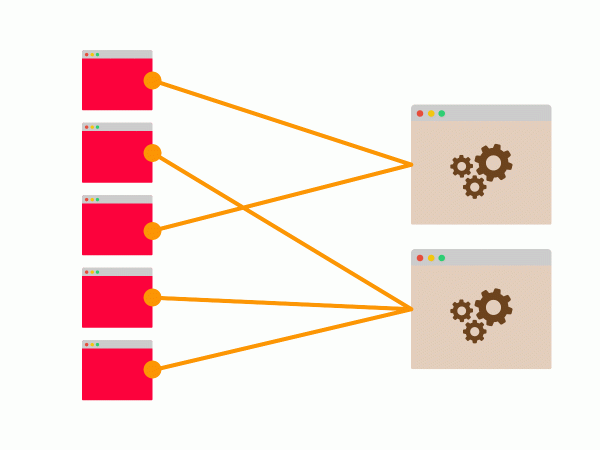
De verbindingen kunnen ongelijkmatig verdeeld zijn: het is mogelijk dat vier klanten verbinding hebben gemaakt met dezelfde server, maar er is een goede kans dat beide servers worden gebruikt.
Wat problematischer is, is het tegenovergestelde scenario.
Als u minder klanten en meer servers heeft, kunnen uw middelen onvoldoende worden gebruikt, wat een potentieel knelpunt oplevert.
Stel dat er twee klanten zijn en vijf servers. In het beste geval zijn er twee permanente verbindingen met twee van de vijf servers.
De andere servers zullen ongebruikt blijven:
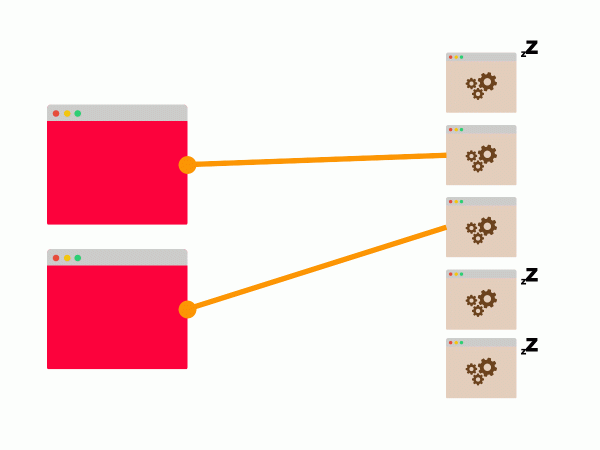
Als deze twee servers niet in staat zijn om de klantverzoeken te verwerken, zal horizontale schaalvergroting niet helpen.
Conclusie
Kubernetes-services zijn ontworpen om te werken in de meeste standaardscenario's van webapplicaties.
Echter, zodra u begint te werken met applicatieprotocollen die gebruik maken van permanente TCP-verbindingen, zoals databases, gRPC of WebSockets, zijn de services niet meer geschikt. Kubernetes biedt geen interne mechanismen voor load balancing van permanente TCP-verbindingen.
Dit betekent dat u applicaties moet schrijven met het oog op client-side load balancing.
De vertaling is voorbereid door het team .
Wat verder te lezen over dit onderwerp:
- .
- .
- .
Bron: habr.com
