

Ik stel voor om kennis te nemen van de samenvatting van de presentatie van begin 2016 door Andrei Salnikov "Typische fouten in applicaties die leiden tot bloat in PostgreSQL"
In deze presentatie bespreek ik de belangrijkste fouten in applicaties die ontstaan tijdens het ontwerp- en coderingsproces. Ik zal alleen die fouten behandelen die leiden tot bloat in PostgreSQL. Gewoonlijk markeert dit het begin van het einde van de prestaties van uw systeem in zijn geheel, hoewel er aanvankelijk geen tekenen van problemen zichtbaar waren.
Ik heet iedereen van harte welkom! Deze presentatie is niet zo technisch als die van mijn collega. Deze presentatie is voornamelijk gericht op ontwikkelaars van backend-systemen, omdat we een behoorlijk aantal klanten hebben. En allemaal maken ze dezelfde fouten. Daarover zal ik het met u hebben. Ik zal uitleggen welke fatale en slechte gevolgen deze fouten met zich meebrengen.
Waarom worden er fouten gemaakt? Fouten worden om twee redenen gemaakt: op goed geluk, misschien komt het goed uit en uit onwetendheid over bepaalde mechanismen die plaatsvinden tussen de database en de applicatie, en ook binnen de database zelf.
Ik zal drie voorbeelden geven met vreselijke afbeeldingen van hoe alles slecht is geworden. Ik zal kort het mechanisme toelichten dat daar plaatsvindt. En hoe ermee om te gaan wanneer ze zich voordoen, en welke preventieve maatregelen te nemen om fouten te voorkomen. Ik zal vertellen over nuttige hulpmiddelen en waardevolle links geven.
Ik gebruikte een testdatabase, waar ik twee tabellen had. Een tabel met klantfacturen en een andere met transacties op deze facturen. En met een bepaalde periodiciteit werken we de saldi op deze rekeningen bij.
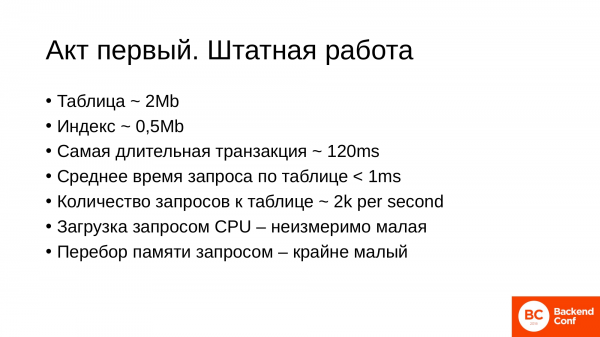
De oorspronkelijke gegevens van de tabel: deze is relatief klein, 2 MB. De responstijd van de database en specifiek van de tabel is ook zeer goed. En een redelijke belasting - 2000 transacties per seconde op de tabel.
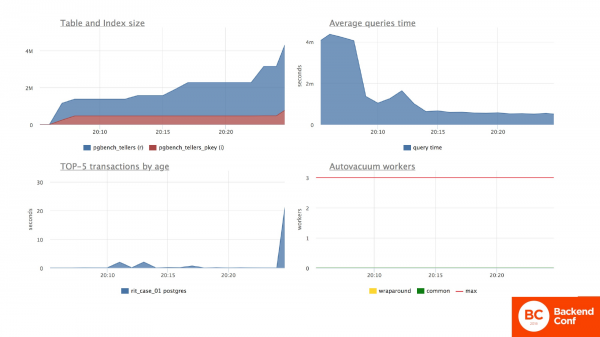
En door deze presentatie zal ik grafieken laten zien om visueel duidelijk te maken wat er gebeurt. Er zullen altijd 2 dia's met grafieken zijn. De eerste dia toont wat er in het algemeen op de server gebeurt.
En in deze situatie zien we dat onze tabel inderdaad klein van omvang is. Index is klein met 2 MB. Dit is de eerste grafiek aan de linkerkant.
De gemiddelde responstijd van de server is ook stabiel en klein. Dit is de rechter bovenste grafiek.
De linkerbeneden grafiek toont de langste transacties. We zien dat de transacties snel worden uitgevoerd. En de autovacuümfunctie werkt hier nog niet, omdat het een starttest was. Verder zal deze werken en nuttig voor ons zijn.
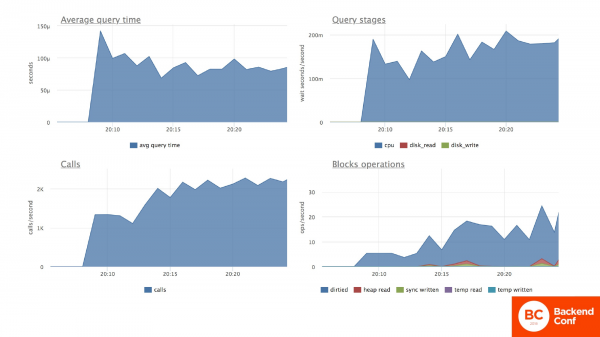
De tweede dia is altijd gewijd aan de geteste tabel. In deze situatie werken we voortdurend de saldi op de rekeningen van de klant bij. En we zien dat de gemiddelde responstijd voor de update-operatie behoorlijk goed is, minder dan een milliseconde. We zien ook dat de CPU-resources (de rechterboven grafiek) gelijkmatig en vrij laag worden gebruikt.
De rechterbeneden grafiek toont hoeveel geheugen, zowel operationeel als op schijf, we doorlopen in de zoektocht naar onze benodigde regel, voordat we deze bijwerken. En het aantal operaties op de tabel is 2.000 per seconde, zoals ik in het begin al zei.
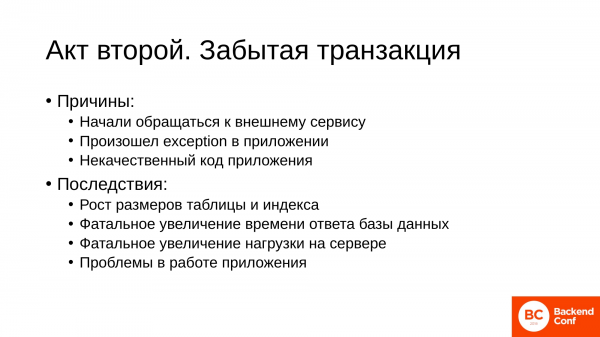
En nu gebeurt er een tragedie. Om de een of andere reden ontstaat er een lange vergeten transactie. De redenen zijn meestal allemaal banaal:
- Een van de meest voorkomende redenen is dat we in de applicatiecode beginnen te communiceren met een externe service. En deze service antwoordt ons niet. Dat wil zeggen, we hebben een transactie geopend, een wijziging in de database aangebracht en zijn uit de applicatie gaan mailen of naar een andere service in onze infrastructuur gegaan, en deze antwoordt om de een of andere reden niet. En onze sessie blijft hangen in een toestand – het is onduidelijk wanneer het zal worden opgelost.
- De tweede situatie is wanneer er om de een of andere reden een uitzondering in onze code is opgetreden. En we hebben in de uitzondering de sluiting van de transactie niet afgehandeld. En we hebben een hangende sessie met een open transactie.
- En de laatste – dat is ook een vrij vaak voorkomend geval. Dit is kwaliteitsarme code. Sommige frameworks openen een transactie. Deze blijft hangen en je kunt in de applicatie niet weten dat deze hangt.
Wat leiden dergelijke dingen?
Tot het punt dat onze tabellen en indexen snel beginnen uit te dijen. Dit is precies het bloat-effect. Voor de database zal dit zich uiten in een plotselinge stijging van de responstijd van de database, er zal een grotere belasting op de database-server komen. En als gevolg daarvan zal de applicatie lijden. Want als je in de code 10 milliseconden op een databasequery besteedde, 10 milliseconden op je logica, dan had je functie een tijd van 20 milliseconden. Maar nu zal je situatie heel treurig zijn.
Laten we eens kijken naar wat er aan de hand is. De linkerbeneden grafiek toont dat we te maken hebben met een lange transactie. En als we naar de linkerboven grafiek kijken, zien we dat de grootte van de tabel van twee megabytes plotseling is gestegen naar 300 megabyte. Daarbij is het aantal gegevens in de tabel niet veranderd, dat wil zeggen, er is een aanzienlijke hoeveelheid rommel aanwezig.
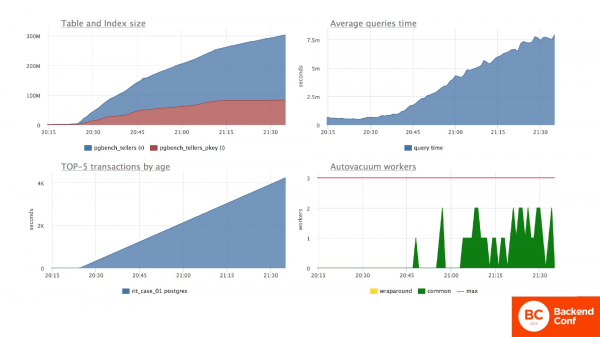
De algehele situatie met de gemiddelde serverreactietijd is ook met meerdere maatstaven veranderd. Dat betekent dat alle verzoeken aan de server aanzienlijk zijn vertraagd. En tegelijkertijd zijn de interne processen van Postgres gestart in de vorm van autovacuum, die proberen iets te doen en middelen verbruiken.
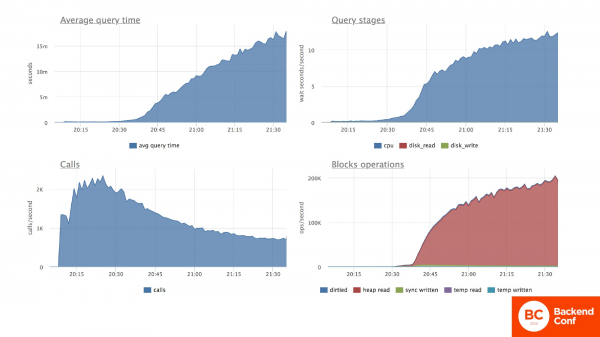
Wat gebeurt er met onze tabel? Hetzelfde. De gemiddelde reactietijd van de tabel is met meerdere maten omhoog geschoten. Wat betreft de verbruikte middelen, zien we dat de belasting op de CPU sterk is toegenomen. Dit is de rechterboven grafiek. Het is toegenomen omdat de CPU een heleboel nutteloze rijen moet doorlopen op zoek naar één die wel nodig is. Dit is de rechterbeneden grafiek. En als resultaat – het aantal aanroepen per seconde is aanzienlijk gedaald, omdat de database niet in staat is hetzelfde aantal verzoeken te verwerken.
We moeten weer tot leven komen. We duiken het internet in en ontdekken dat lange transacties een probleem veroorzaken. We vinden deze transactie en beëindigen deze. En alles werkt weer normaal. Alles functioneert zoals het hoort.
We zijn gerustgesteld, maar na enige tijd beginnen we op te merken dat de applicatie niet zo functioneert als voor de storing. Verzoeken worden nog steeds trager verwerkt, en wel aanzienlijk trager. In mijn geval zelfs anderhalf tot twee keer trager. De belasting op de server is ook hoger dan vóór de storing.
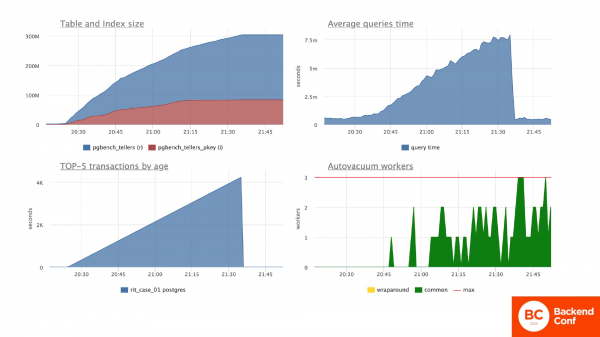
En de vraag is: "Wat gebeurt er met de database op dat moment?" Met de database gebeurt het volgende. In de transactiegrafiek zie je dat deze stilstaat en er inderdaad geen langdurige transacties zijn. Maar de grootte van de tabel is tijdens de storing dramatisch toegenomen. En sindsdien is deze niet afgenomen. De gemiddelde tijd van de database is gestabiliseerd. En de reacties lijken redelijk adequaat te zijn met een snelheid die voor ons acceptabel is. Autovacuum is actiever geworden en is begonnen met het verwerken van meer gegevens in de tabel.
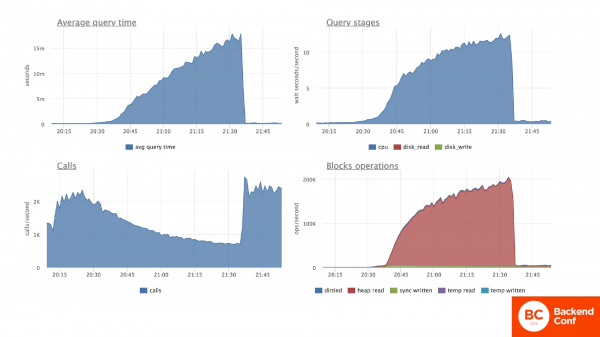
Specifiek voor de geteste tabel met rekeningen, waar we de saldi wijzigen: de responstijd op de aanvraag lijkt weer normaal te zijn. Maar in werkelijkheid is het anderhalve keer hoger.
Wat betreft de belasting op de CPU, zien we dat de belasting op de CPU nog niet terug is op het gewenste niveau sinds de storing. De redenen hiervoor zijn te vinden in de grafiek rechtsonder. Het is duidelijk dat er sprake is van een overschrijding van een bepaald geheugenvolume. Dit betekent dat we serverbronnen van de database verbruiken om de juiste rij te zoeken, terwijl we ongebruikte gegevens doorbladeren. Het aantal transacties per seconde heeft zich gestabiliseerd.
Over het geheel genomen is het goed, maar de situatie is slechter dan voorheen. Er is duidelijke degradatie van de database als gevolg van onze applicatie die met deze database werkt.
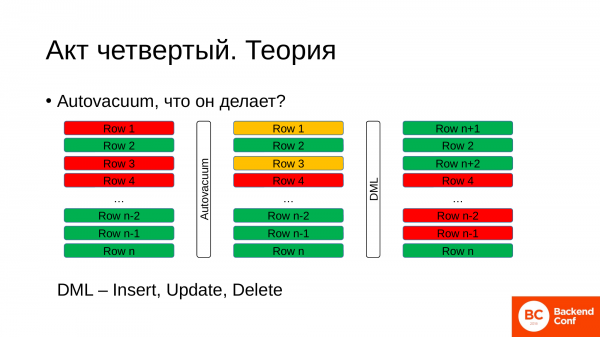
En om te begrijpen wat daar aan de hand is, als je niet bij de vorige presentatie was, zal ik nu iets theorie geven. Theorie over het interne proces. Wat is autovacuum en wat doet het?
Kort gezegd, op een bepaald moment hebben we een tabel. In de tabel bevinden zich rijen. Deze rijen kunnen actief, levend en nu nodig zijn. In de afbeelding zijn ze groen gemarkeerd. En er zijn dode rijen, die al zijn verwerkt, zijn bijgewerkt, en waar nieuwe vermeldingen voor zijn verschenen. Ze zijn gemarkeerd, omdat ze al niet meer interessant zijn voor de database, maar blijven in de tabel liggen vanwege de kenmerken van Postgres.
Waarom is autovacuum nodig? Autovacuum komt op een gegeven moment en vraagt de database: 'Geef me alstublieft de id van de oudste transactie die momenteel openstaat in de database.' De database geeft deze id terug. En op basis hiervan doorloopt autovacuum de rijen in de tabel. En als het ziet dat bepaalde rijen zijn gewijzigd door veel oudere transacties, heeft het het recht om ze te markeren als rijen die we in de toekomst kunnen hergebruiken door er nieuwe gegevens in te schrijven. Dit is een achtergrondproces.
Ondertussen blijven we werken met de database, blijven we wijzigingen aanbrengen in de tabel. En voor deze rijen, die we kunnen hergebruiken, schrijven we nieuwe gegevens. Zo ontstaat er een cyclus, wat betekent dat er constant dode oude rijen zijn, en we schrijven nieuwe rijen die we nodig hebben in plaats van hen. En dit is een normale toestand voor het werken met PostgreSQL.
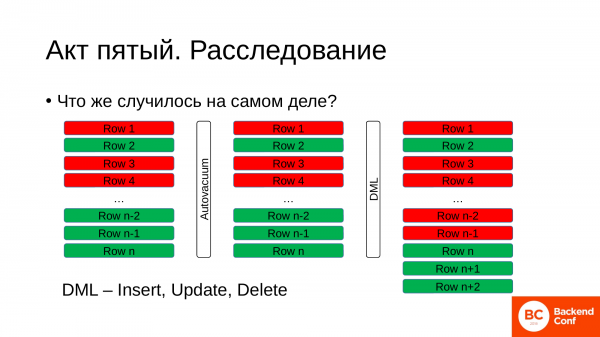
Wat gebeurde er tijdens het ongeval? Hoe verliep dit proces?
We hadden een tabel in een bepaalde staat, met een combinatie van actieve en inactieve rijen. Toen kwam de autovacuum. Hij vroeg de database naar de oudste transactie die we hadden en wat de bijbehorende ID was. Hij ontving deze ID, die uren of minuten oud kon zijn, afhankelijk van de belasting op de database. Vervolgens ging hij op zoek naar rijen die hij als herbruikbaar kon markeren. En hij vond geen zulk soort rijen in onze tabel.
Maar ondertussen blijven we met de tabel werken. We doen dingen, we updaten en veranderen gegevens. En wat moet de database in dit geval doen? Er blijft haar niets anders over dan nieuwe rijen aan het einde van de bestaande tabel toe te voegen. Hierdoor begint de grootte van de tabel te groeien.
Echt, we hebben groene rijen nodig om te kunnen werken. Maar tijdens zo'n probleem blijkt het percentage groene rijen extreem laag te zijn in de gehele tabel.
En wanneer we een verzoek indienen, moet de database door alle rijen heen lopen: zowel de rode als de groene, om de juiste rij te vinden. En het probleem van de opgeblazen tabel door nutteloze gegevens wordt 'bloat' genoemd, wat ook onze schijfruimte opeet. Herinner je je nog dat het 2 MB was, en nu is het 300 MB? En nu moet je megabytes vervangen door gigabytes, en je zult snel al je schijfruimte verliezen.
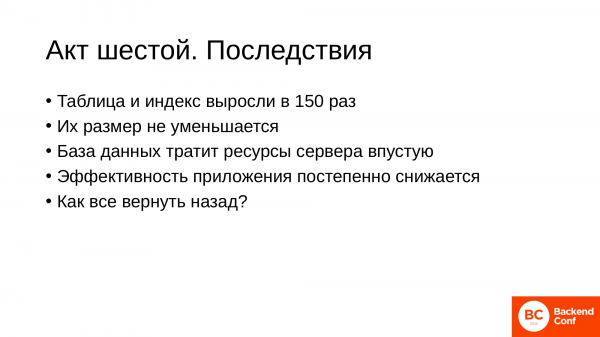
Wat kunnen de gevolgen voor ons zijn?
- In mijn voorbeeld is de tabel en de index 150 keer gegroeid. Bij sommige van onze klanten zijn er ernstigere gevallen geweest waarbij de schijfruimte gewoon opraakte.
- De grootte van tabellen zal nooit zomaar afnemen. Autovacuum kan in sommige gevallen het staartje van een tabel afsnijden, als er alleen maar inactieve rijen zijn. Maar aangezien er constante rotatie plaatsvindt, kan een groene rij aan het einde blijven hangen en niet worden bijgewerkt, terwijl alle andere ergens aan het begin van de tabel worden geschreven. Maar dit is een zeldzame gebeurtenis, dus je kunt er niet op hopen dat je tabel van zelf kleiner wordt.
- De database moet door een hoop nutteloze rijen heen, en we verspillen schijfruimte, CPU-processorkracht en energie.
- En dit heeft directe invloed op onze applicatie, want als we in het begin 10 milliseconden aan een verzoek besteedden, 10 milliseconden aan onze code, dan kostte het tijdens de storing een seconde voor het verzoek en 10 milliseconden voor de code, d.w.z. de prestaties van de applicatie zijn met een factor 10 verminderd. En toen de storing was opgelost, kostte het ons 20 milliseconden voor het verzoek en 10 milliseconden voor de code. Dit betekent dat we nog steeds met anderhalf keer slechtere prestaties zitten. En dit komt allemaal door één transactie die vastliep, mogelijk door onze schuld.
- En de vraag is: 'Hoe krijgen we alles weer terug zoals het was?', zodat alles goed gaat en de verzoeken weer zo snel zijn als vóór de storing.
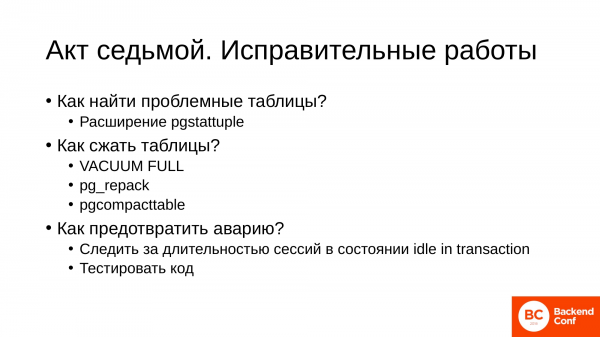
Daarvoor zijn er specifieke werkzaamheden die moeten worden uitgevoerd.
Eerst moeten we de probleemtabellen vinden die zijn uitgedijd. We begrijpen dat voor sommige tabellen de schrijfsnelheid hoger is dan voor andere. En hiervoor gebruiken we de extensie . Als je deze extensie installeert, kun je verzoeken schrijven die je helpen om de tabellen te vinden die behoorlijk zijn uitgedijd.
Zodra je deze tabellen hebt gevonden, moeten ze worden gecomprimeerd. Hiervoor zijn er al tools beschikbaar. In ons bedrijf gebruiken we drie tools. De eerste is de ingebouwde VACUUM FULL. Dit is een rigoureuze, harde en meedogenloze methode, maar soms erg nuttig. en zijn externe tools voor het comprimeren van tabellen. En ze zijn zorgvuldiger met de database.
Ze worden gebruikt afhankelijk van wat je het meest comfortabel vindt. Maar daarover zal ik aan het einde praten. Het belangrijkste is dat er drie tools zijn. Er is genoeg om uit te kiezen.
Nadat we alles hebben hersteld en ervoor hebben gezorgd dat alles weer goed functioneert, moeten we weten hoe we deze situatie in de toekomst kunnen voorkomen:
- Het is vrij eenvoudig te voorkomen. Je moet letten op de duur van sessies op de Master-server. Vooral gevaarlijke sessies in de staat idle in transaction.Dit zijn diegenen die een transactie hebben geopend, iets hebben gedaan en vervolgens zijn verdwenen of gewoon vastzaten in de code.
- En voor jullie, als ontwikkelaars, is het belangrijk om de code te testen op het moment dat deze situaties zich voordoen. Dit is niet moeilijk te doen. Het zal een nuttige controle zijn. Je voorkomt een groot aantal 'kinderlijke' problemen die samenhangen met lange transacties.
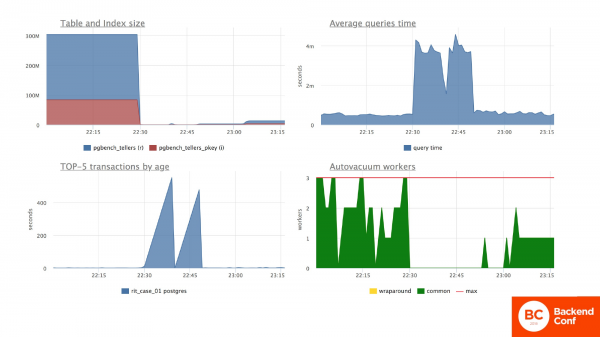
Op deze grafieken wilde ik je laten zien hoe de tabel en het gedrag van de database zijn veranderd nadat ik in dit geval een VACUUM FULL op de tabel heb uitgevoerd. Dit is geen productieomgeving.
De grootte van de tabel is onmiddellijk weer terug in een normale werktoestand van enkele megabytes. Dit had niet veel invloed op de gemiddelde responstijd van de server.
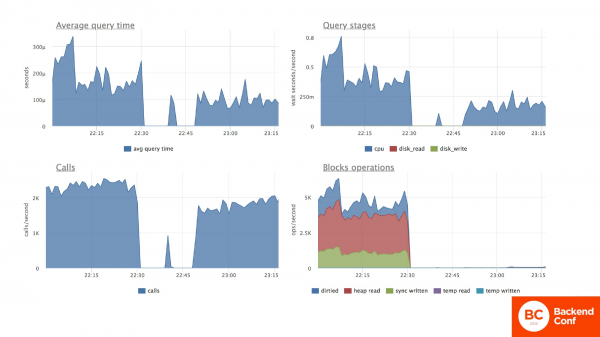
Maar specifiek voor onze testtabel, waar we de saldo's op de rekeningen hebben geüpdatet, zien we dat de gemiddelde responstijd voor de gegevensupdate in de tabel is teruggebracht naar pré-crisisniveau. Ook zijn de bronnen die door de processor worden verbruikt voor het uitvoeren van deze aanvraag teruggebracht naar pré-crisisniveau. En de grafiek rechtsonder toont aan dat we nu precies die regel vinden die we nodig hebben zonder door een berg dode regels te hoeven bladeren die er vóór de compressie van de tabel waren. De gemiddelde tijd voor aanvragen is ongeveer op hetzelfde niveau gebleven, maar hier heb ik waarschijnlijk te maken met fouten in mijn hardware.
Hier eindigt het eerste verhaal. Dit is de meest voorkomende situatie. Het overkomt iedereen, ongeacht de ervaring van de klant of hoe gekwalificeerd de programmeurs zijn. Vroeg of laat gebeurt dit.
Het tweede verhaal, waarin we de belasting verdelen en serverresources optimaliseren.
- We zijn al gegroeid en zijn serieuze jongens geworden. We begrijpen dat we een replica hebben en het zou goed zijn om de belasting in balans te brengen: schrijven naar de Master en lezen van de replica. Deze situatie ontstaat meestal wanneer we rapporten of ETL willen genereren. En het bedrijf is daar heel blij mee. Ze willen heel graag verschillende rapporten met veel complexe analytics.
- De rapporten duren uren omdat je complexe analytics niet in enkele milliseconden kunt berekenen. Wij, als dappere jongens, schrijven code. We maken in de applicatie invoegen, waarbij we schrijven naar de Master en rapporten uitvoeren op de replica.
- We verdelen de belasting.
- Alles werkt uitstekend. We zijn goed bezig.
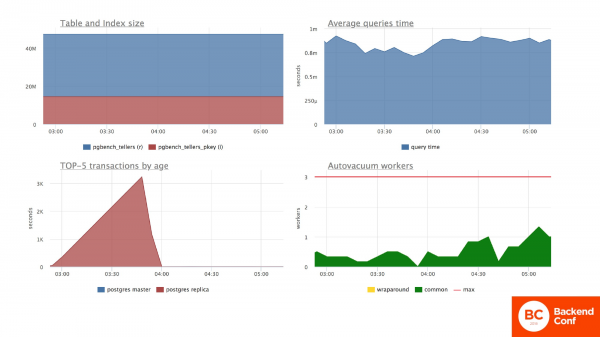
En hoe ziet deze situatie eruit? Specifiek voor deze grafieken heb ik ook de duur van transacties vanuit de replica toegevoegd. Alle andere grafieken zijn alleen voor de Master-server.
Mijn rapportagetabel is op dit moment gegroeid. Er zijn er meer geworden. We zien dat de gemiddelde serverreactietijd stabiel is. We zien dat er een langdurige transactie op de replica is, die al twee uur loopt. We zien dat de autovacuum goed functioneert en dode rijen verwerkt. En alles gaat goed.
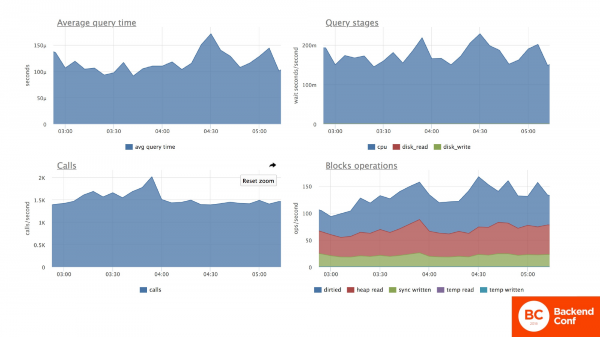
Specifiek voor de testtabel blijven we de saldi op de rekeningen bijwerken. Ook hier hebben we een stabiele reactietijd voor het verzoek en een stabiel resourceverbruik. Alles gaat goed.
Alles is goed totdat deze rapporten beginnen af te schieten door conflicten met de replicatie. En ze worden met constante periodiciteit afgevuurd.
We duiken het internet op en beginnen te lezen waarom dit gebeurt. En we vinden een oplossing.
De eerste oplossing is om de replicatietijd te verhogen. We weten dat ons rapport drie uur draait. We stellen de replicatietijd in op drie uur. We starten alles opnieuw, maar we hebben nog steeds problemen met het feit dat rapporten soms afgeschoten worden.
We willen dat alles perfect is. We gaan verder. En we vinden een geweldige instelling op internet – hot_standby_feedback. We schakelen het in. Hot_standby_feedback stelt ons in staat om het werk van de autovacuum op de Master vast te houden. Hierdoor elimineren we de conflicten in de replicatie volledig. En alles werkt goed met de rapporten.
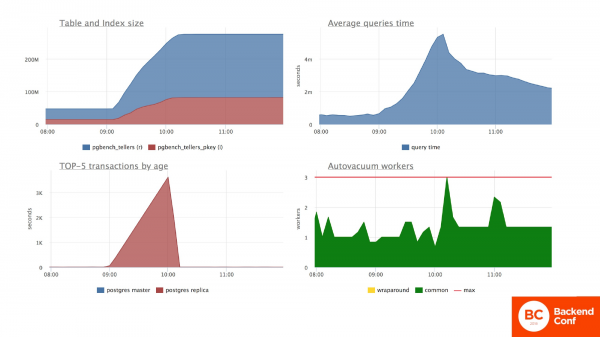
En hoe gaat het ondertussen met de Master-server? Met de Master-server is er een totale ramp aan de hand. Nu bekijken we de grafieken, sinds ik beide instellingen heb ingeschakeld. En we zien dat de sessie op de replica op de een of andere manier de situatie op de Master-server beïnvloedt. Het beïnvloedt het daadwerkelijk, omdat het de autovacuum heeft gepauzeerd die dode rijen opruimt. De grootte van de tabel is weer omhooggeschoten. De gemiddelde uitvoeringstijd van verzoeken in de hele database is ook omhooggeschoten. De autovacuum heeft het een beetje moeilijker gekregen.
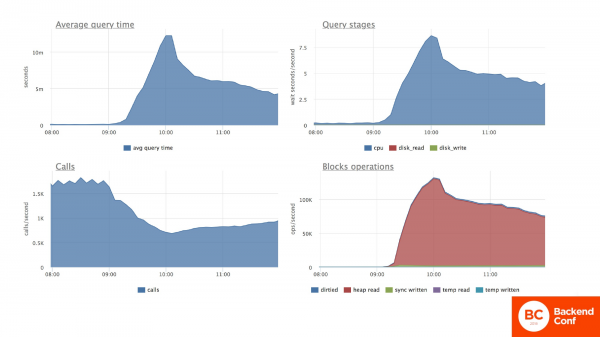
Specifiek voor onze tabel zien we dat de gegevensupdate ook flink omhoog is geschoten. Het CPU-verbruik is ook aanzienlijk toegenomen. We doorlopen weer een groot aantal dode, nutteloze rijen. En de reactietijd van deze tabel, het aantal transacties is gedaald.
Hoe zou dit eruitzien als we niet weten waar ik het hiervoor over had?
- We beginnen met het onderzoeken van problemen. Als we eerder problemen hebben ondervonden, weten we dat lange transacties de oorzaak kunnen zijn en we kijken naar de Master. Het probleem ligt bij de Master. Het is instabiel. Het wordt heet, en de Load Average is bijna honderd.
- De verzoeken daar vertragen, maar we zien daar geen langdurige transacties. En we begrijpen niet wat er aan de hand is. We weten niet waar we moeten zoeken.
- We controleren de serverhardware. Misschien is onze raid kapot gegaan. Misschien is er een geheugenstaaf defect. Van alles kan er aan de hand zijn. Maar nee, de servers zijn nieuw en alles werkt prima.
- Alleen maar rennende mensen: systeembeheerders, ontwikkelaars en de directeur. Niets helpt.
- En op een gegeven moment begint alles onverwachts vanzelf weer in orde te komen.
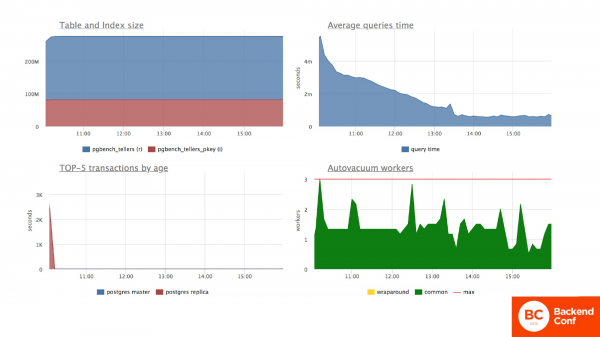
Op de replica heeft een verzoek ondertussen gewerkt en is het uitgevoerd. We hebben het rapport ontvangen. Het bedrijf is nog steeds tevreden. Zoals we zien, is onze tabel weer gegroeid en is het niet van plan te krimpen. Op de grafiek met sessies heb ik een stuk van die lange transactie van de replica gelaten, zodat je kunt inschatten hoe lang het duurt voordat de situatie stabiliseert.
De sessie is verdwenen. En pas na enige tijd komt de server weer een beetje in orde. En de gemiddelde responstijd van verzoeken op de Master-server komt weer op een normaal niveau. Omdat, eindelijk, de autovacuum de kans kreeg om deze dode rijen op te schonen en te markeren. En hij is zijn werk gaan doen. En hoe snel hij dit doet, hoe sneller we weer in orde komen.
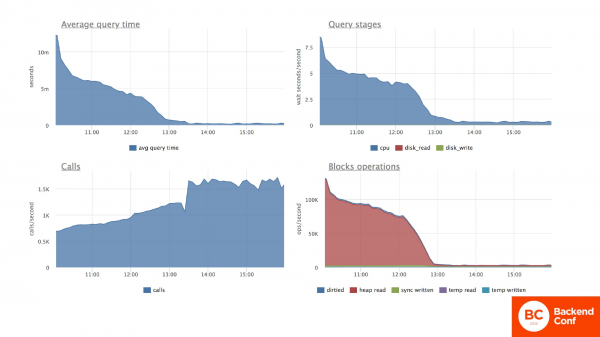
Op de testtabel, waar we de saldo's van rekeningen bijwerken, zien we precies hetzelfde patroon. De gemiddelde tijd voor het bijwerken van een rekening normaliseert ook geleidelijk. De bronnen die door de processor worden verbruikt, nemen ook af. En het aantal transacties per seconde komt weer in de normaalwaarden. Maar opnieuw, niet op het niveau zoals we dat voor de storing hadden.
We ervaren in ieder geval een daling van de prestaties, net als in het eerste geval, met anderhalf tot twee keer, en soms zelfs meer.
We dachten dat we alles goed hadden gedaan. We hebben de belasting verdeeld. De hardware staat niet stil. We hebben de verzoeken goed ingedeeld, maar het is nog steeds niet goed gegaan.
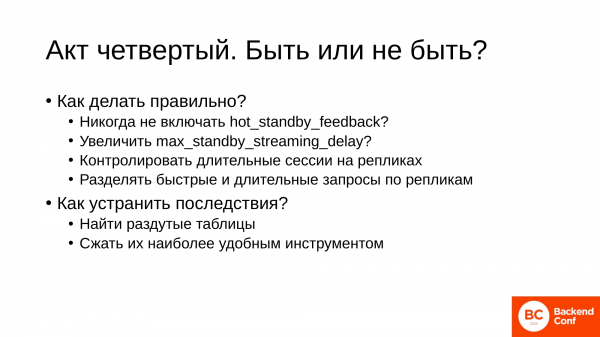
- Moet hot_standby_feedback niet worden ingeschakeld? Ja, het wordt niet aanbevolen om dit zonder goede reden in te schakelen. Dit omdat deze instelling rechtstreeks invloed heeft op de Master-server en het functioneren van de autovacuum daar onderbreekt. Als u het op een bepaalde replica inschakelt en het daarna vergeet, kunt u de Master beschadigen en grote problemen met de applicatie krijgen.
- Moet max_standby_streaming_delay worden verhoogd? Ja, voor rapporten is dat zeker het geval. Als u een rapport van drie uur heeft en u wilt niet dat het faalt door replica-conflicten, verhoog dan gewoon de vertraging. Een langdurig rapport heeft nooit gegevens nodig die zojuist in de database zijn gekomen. Als het een rapport van drie uur is, betekent dat dat u het uitvoert over een oudere periode van gegevens. Of het nu drie of zes uur vertraging is, dat maakt niet uit, maar u zult regelmatig rapporten ontvangen zonder problemen.
- Het is natuurlijk nodig om langdurige sessies op de replicas te controleren, vooral als u heeft besloten hot_standby_feedback op de replica in te schakelen. Want er kan van alles gebeuren. U heeft deze replica aan een ontwikkelaar gegeven om queries te testen. Hij schreef een ingewikkelde query, voerde deze uit en ging thee drinken, terwijl wij een vastgelopen Master kregen. Of we hebben er een ongeschikte applicatie op toegelaten. De situaties zijn divers. Sessies op replicas moeten net zo zorgvuldig worden gecontroleerd als die op de Master.
- Als u snelle en langdurige queries op de replicas heeft, is het in dit geval beter om deze te splitsen voor een betere belastingverdeling. Dit betreft streaming_delay. Voor snelle queries, gebruik een replica met een geringe replicatievertraging. Voor langdurige rapportqueries, gebruik een replica die tot 6 uur of zelfs een dag achter kan lopen. Dit is een vrij normale situatie.
We verhelpen de gevolgen op dezelfde manier:
- We zoeken naar opgeblazen tabellen.
- En we comprimeren ze met het meest geschikte hulpmiddel dat we hebben.
Dit tweede verhaal is daarmee afgesloten. Laten we verdergaan naar het derde verhaal.
Ook een vrij gebruikelijke voor ons, waarin we migratie uitvoeren.
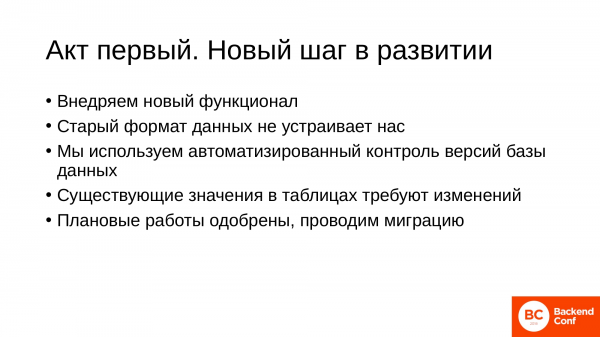
- Elke softwareoplossing groeit. De vereisten veranderen. We willen hoe dan ook vooruitgang boeken. En soms is het nodig om de gegevens in de tabel bij te werken, namelijk een update uit te voeren als onderdeel van onze migratie naar de nieuwe functionaliteit die we in ons ontwikkelingsproces implementeren.
- Het oude gegevensformaat voldoet niet. Stel dat we nu naar de tweede tabel kijken, waar ik de transacties voor deze rekeningen heb. En laten we zeggen dat ze in roebels waren, en we besloten de nauwkeurigheid te verhogen en alles in kopeken te doen. Hiervoor moeten we een update uitvoeren: het veld met het transactiebedrag vermenigvuldigen met honderd.
- In de moderne wereld gebruiken we geautomatiseerde middelen voor versiebeheer van databases. Stel dat, . We beschrijven daar onze migratie. We testen het op onze testdatabase. Alles werkt perfect. De update verloopt. Dit blokkeert even de werkzaamheden, maar we krijgen bijgewerkte gegevens. En we kunnen nieuwe functionaliteiten daarop draaien. We hebben alles getest, gecheckt. Alles is goedgekeurd.
- We hebben gepland onderhoud uitgevoerd en de migratie voltooid.
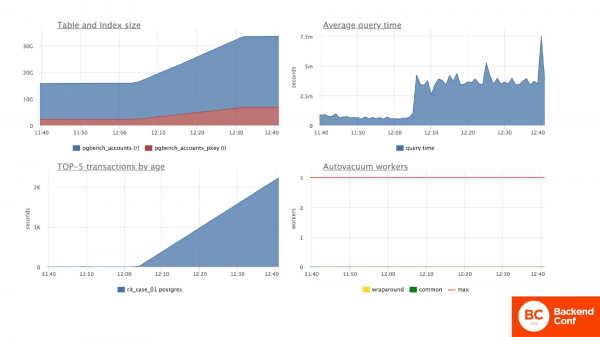
Hier ziet u de migratie met de update. Aangezien dit mijn transacties zijn, was de tabel 15 GB groot. En omdat we elke regel bijwerken, hebben we de tabel met de update verdubbeld, omdat we elke regel hebben herschreven.
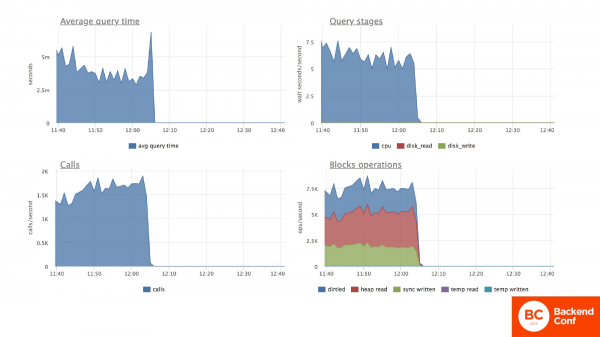
Tijdens de migratie konden we niets met deze tabel doen, omdat alle verzoeken hiervoor in de wachtrij stonden en wachtten tot deze update was voltooid. Maar hier wil ik uw aandacht vestigen op de cijfers aan de verticale as. Dat wil zeggen, we hadden een gemiddelde tijd van een verzoek voor de migratie van ongeveer 5 milliseconden en de belasting op de processor, het aantal blokbewerkingen voor het lezen van het geheugen van de schijf was minder dan 7,5.
We hebben de migratie uitgevoerd en opnieuw problemen gekregen.
De migratie is succesvol verlopen, maar:
- De oude functionaliteit is langzamer gaan werken.
- De tabel is weer in omvang toegenomen.
- De belasting op de server is opnieuw groter geworden dan voorheen.
- En natuurlijk zijn we nog steeds bezig met de functionaliteiten die goed werkten, we hebben ze een beetje verbeterd.
En dit is weer bloat, dat ons opnieuw het leven zuur maakt.
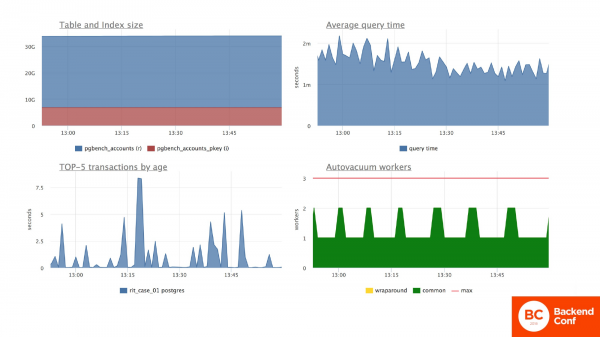
Hier laat ik zien dat de tabel, net als in de voorgaande twee gevallen, niet van plan is terug te keren naar de eerdere afmetingen. De gemiddelde belasting op de server lijkt redelijk.
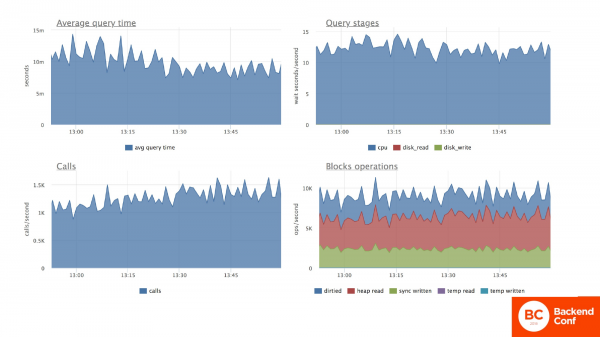
Als we naar de tabel met rekeningen kijken, zien we dat de gemiddelde responstijd voor deze tabel is verdubbeld. De belasting op de CPU en het aantal doorzochte rijen in het geheugen is gestegen tot boven de 7,5, terwijl het daaronder lag. Voor processors is dit verdubbeld en voor blokoperaties 1,5 keer, wat betekent dat we een degradatie van de serverprestaties hebben ervaren. Als gevolg daarvan zijn de prestaties van onze applicatie ook verslechterd. Het aantal oproepen is echter ongeveer op hetzelfde niveau gebleven.
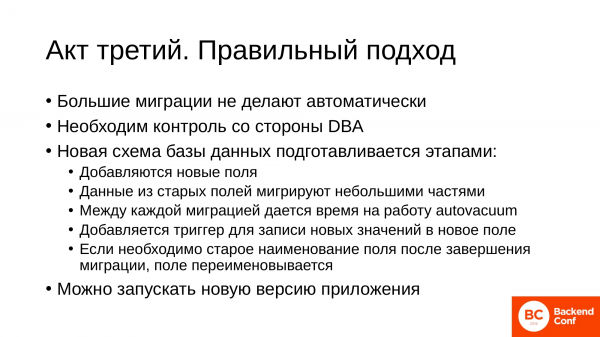
Het is belangrijk om te begrijpen hoe je dergelijke migraties goed uitvoert. En ze moeten worden uitgevoerd. We doen deze migraties redelijk vaak.
- Dergelijke grote migraties worden niet automatisch uitgevoerd. Ze moeten altijd onder controle worden gehouden.
- Er is controle nodig van een ervaren persoon. Als je een DBA in het team hebt, laat hem het dan doen. Dat is zijn taak. Als dat niet zo is, laat dan de meest ervaren persoon het doen die weet hoe je met databases moet werken.
- Een nieuw databaseschema, zelfs als we maar één kolom bijwerken, bereiden we altijd gefaseerd voor, dat wil zeggen, voorafgaand aan de uitrol van de nieuwe versie van de applicatie:
- Nieuwe velden worden toegevoegd waarin we de bijgewerkte gegevens zullen opslaan.
- We verplaatsen gegevens van het oude veld naar het nieuwe veld in kleine delen. Waarom doen we dit? Ten eerste houden we altijd controle over dit proces. We weten dat we al een bepaald aantal batches hebben verplaatst en dat er nog zoveel overblijven.
- Een tweede positief effect is dat we tussen elke batch de transactie afsluiten, een nieuwe openen, wat de mogelijkheid biedt voor de autovacuum om op de tabel te werken en dode rijen voor hergebruik te markeren.
- Voor rijen die tijdens het werken met de applicatie verschijnen (waaronder het oude programma nog operationeel is), voegen we een trigger toe die nieuwe waarden in de nieuwe velden opslaat. In ons geval is dit de oude waarde vermenigvuldigd met honderd.
- Als we echt vasthoudend zijn en hetzelfde veld willen gebruiken, hernoemen we gewoon de velden na het voltooien van alle migraties en vóór de uitrol van de nieuwe versie van de applicatie. De oude naar een verzonnen naam en de nieuwe velden hernoemen we naar de oude naam.
- En pas daarna starten we de nieuwe versie van de applicatie.
En op deze manier krijgen we geen bloat en zullen we niet in prestaties inboeten.
Hier eindigde het derde verhaal.
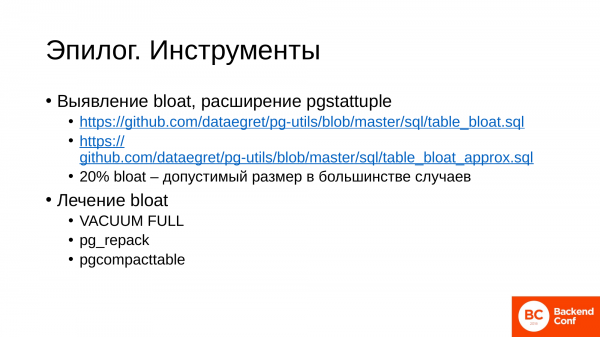
En nu iets gedetailleerder over de tools die ik in het allereerste verhaal heb genoemd.
Voordat je bloat gaat zoeken, is het absoluut noodzakelijk om de extensie te installeren. .
Om je geen zoekopdrachten te laten bedenken, hebben we in ons werk deze zoekopdrachten al geschreven. Je kunt ze gebruiken. Hier worden twee zoekopdrachten gepresenteerd.
- De eerste werkt vrij langzaam, maar laat je wel de exacte bloatwaarden in de tabel zien.
- De tweede werkt sneller en is erg effectief als je snel wilt beoordelen of er bloat is of niet in de tabel. En je moet begrijpen dat er altijd bloat in een Postgres-tabel is. Dit is een kenmerk van het MVCC-model.
- En 20% bloat is in de meeste gevallen normaal voor tabellen. Dat wil zeggen, je hoeft je geen zorgen te maken en deze tabel niet te verkleinen.
Hoe we tabellen die zijn opgeblazen hebben ontdekt, hebben we begrepen, en bovendien wanneer ze zijn opgeblazen met nutteloze gegevens.
Nu over hoe bloat te verhelpen:
- Als we een kleine tabel hebben en goede schijven, dat wil zeggen, als de tabel tot één gigabyte is, kun je VACUUM FULL prima gebruiken. Dit zal een exclusieve vergrendeling van de tabel voor enkele seconden nemen en dat is alles, maar het doet het snel en grondig. Wat doet VACUUM FULL? Het neemt een exclusieve vergrendeling van de tabel en herschrijft de levende rijen uit de oude tabellen naar de nieuwe tabel. En aan het einde wisselt het deze om. Het verwijdert de oude bestanden en vervangt ze door nieuwe. Maar tijdens zijn werking neemt het een exclusieve vergrendeling van de tabel. Dit betekent dat je niets met deze tabel kunt doen: je kunt er niet in schrijven, niet in lezen en niet wijzigen. En VACUUM FULL vereist extra schijfruimte om gegevens op te slaan.
- De volgende tool . Volgens zijn principe lijkt hij sterk op VACUUM FULL, omdat hij ook gegevens uit oude bestanden naar nieuwe herschrijft en deze in de tabel vervangt. Maar hij neemt aan het begin van zijn werking geen exclusieve vergrendeling van de tabel, maar alleen op het moment dat hij al gereed gegevens heeft om de bestanden te vervangen. De eisen aan schijfbronnen zijn vergelijkbaar met die van VACUUM FULL. Je hebt extra schijfruimte nodig, wat soms kritiek kan zijn als je terabyte-tabels hebt. En hij is behoorlijk veeleisend voor de CPU, omdat hij actief werkt met invoer/uitvoer.
- De derde tool is . Het gaat veel zorgvuldiger om met middelen, omdat het een beetje op andere principes werkt. De essentie van pgcompacttable is dat het bij updates alle actieve rijen naar de bovenkant van de tabel verplaatst. Vervolgens voert het een vacuum uit op deze tabel, omdat we weten dat de actieve rijen aan het begin staan en de dode rijen aan het einde. En de vacuum zelf snijdt deze staart af, d.w.z. het vereist niet veel extra schijfruimte. En bovendien kan het nog worden geoptimaliseerd voor hulpbronnen.
Alles met hulpmiddelen.
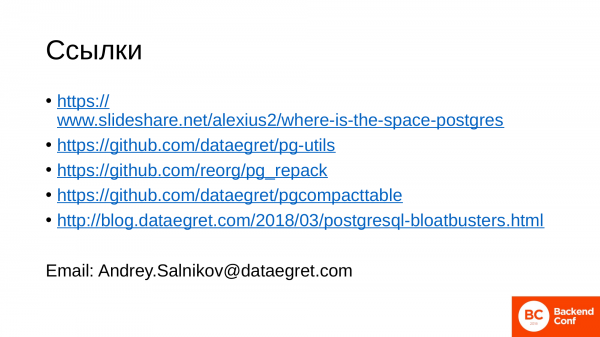
Als je het onderwerp bloat interessant vindt om verder in te duiken, dan zijn hier enkele nuttige links:
- – dit is een presentatie van mijn collega. Het is een algemeen verhaal over waar ruimte in Postgres naartoe gaat tijdens zijn werking en leven. En er is een heel groot en gedetailleerd technisch stuk voor databasebeheerders over bloat.
- – dit is een link naar onze repository waar we een hoop nuttige scripts opslaan voor het controleren van de status van de database. Daar kun je scripts vinden voor het opsporen van bloat.
- en links naar hulpmiddelen die je zullen helpen om tabellen te optimaliseren.
- – dit is een blogpost van mijn collega. Daar legt hij behoorlijk serieus en gedetailleerd technisch bloat uit, juist op een niveau dat dicht bij de beheerders ligt.
Ik heb hier geprobeerd een schrikbeeld voor ontwikkelaars te schetsen, omdat zij onze directe klanten van databases zijn en moeten begrijpen wat de consequenties van bepaalde acties zijn. Ik hoop dat dit gelukt is. Bedankt voor je aandacht!
Vragen
Bedankt voor de presentatie! U sprak over hoe problemen kunnen worden geïdentificeerd. Maar hoe kunnen ze worden voorkomen? Dat wil zeggen, ik had een situatie waarin queries vastlieten, niet alleen vanwege het feit dat ze contact maakten met externe diensten. Het waren gewoon een paar bizarre joins. Er waren enkele onschuldige kleine queries die een dag vastzaten en toen onzin begonnen te produceren. Het lijkt erg op wat u beschrijft. Hoe kan dit worden gemonitord? Moet ik constant kijken welke query vastzit? Hoe kan dit worden voorkomen?
In dit geval is het een taak voor de beheerders van uw bedrijf, niet per se voor de DBA.
Ik ben de beheerder.
In PostgreSQL is er een weergave genaamd pg_stat_activity, waarin de vastgelopen queries worden getoond. En je kunt zien hoe lang ze daar al vastzitten.
Moet ik elke 5 minuten inloggen en kijken?
Stel cron in en controleer. Als u een langdurige aanvraag heeft, stuur dan een e-mail en dat is het. Dat wil zeggen, u hoeft het niet zelf te bekijken; dit kan automatisch worden gedaan. U ontvangt een e-mail en daarop reageert u. U kunt het ook automatisch afhandelen.
Zijn er duidelijke redenen waarom dit gebeurt?
Ik heb er een aantal opgesomd. Andere zijn meer complexe voorbeelden. En daar kan het gesprek lang duren.
Bedankt voor de presentatie! Ik wilde iets vragen over de pg_repack tool. Als het geen exclusieve blokkering uitvoert, dan…
Het voert een exclusieve blokkering uit.
… dan kan ik mogelijk gegevens verliezen. Mijn applicatie mag in dat geval niets schrijven, toch?
Nee, het werkt gewoon met de tabel, dat wil zeggen, pg_repack verplaatst eerst alle actieve regels die er zijn. Natuurlijk vindt er enige schrijfactie naar de tabel plaats. Het voegt gewoon die laatste regel toe.
Dat wil zeggen, doet het uiteindelijk iets?
Aan het einde neemt het een exclusieve blokkering om deze bestanden te vervangen.
Is dit sneller dan VACUUM FULL?
VACUUM FULL neemt bij de start meteen een exclusieve blokkering en houdt deze vast totdat alles is afgerond. pg_repack neemt alleen een exclusieve blokkering op het moment van bestandsvervanging. Op dat moment kunt u daar niet naar schrijven, maar de gegevens gaan niet verloren; alles is in orde.
Hallo! U vertelde over het werk van de autovacuum. Er was een diagram met rode, gele en groene celindelingen. Dat wil zeggen, de gele - zijn gemarkeerd als verwijderd. En vervolgens kan daar iets nieuws in worden geschreven?
Ja. Postgres verwijdert geen regels. Dat is de specificiteit ervan. Als we een regel hebben bijgewerkt, markeren we de oude als verwijderd. Daar komt het id van de transactie die deze regel heeft gewijzigd te staan, en we schrijven een nieuwe regel. We hebben sessies die deze mogelijk kunnen lezen. Op een bepaald moment worden ze helemaal verouderd. De essentie van het werk van de autovacuum is dat het door deze regels loopt en ze als overbodig markeert. En daar kunt u gegevens overschrijven.
Ik begrijp het. Maar de vraag gaat een beetje niet hierover. Ik had het nog niet afgemaakt. Stel dat we een tabel hebben. Daarin zijn er velden van variabele grootte. En als ik iets nieuws probeer in te voegen, kan het gewoon niet in de oude cel passen.
Nee, de hele regel wordt sowieso bijgewerkt. In Postgres zijn er twee datamodels. Het selecteert op basis van het datatype. Sommige gegevens worden direct in de tabel opgeslagen, terwijl er ook tos-gegevens zijn. Dit zijn grote hoeveelheden gegevens: tekst, json. Ze worden in aparte tabellen opgeslagen. En voor deze tabellen geldt hetzelfde verhaal met bloat, dat wil zeggen, alles is hetzelfde. Het is gewoon dat ze apart zijn ondergebracht.
Bedankt voor de presentatie! Hoe acceptabel is het om statement timeout te gebruiken om de duur van verzoeken te beperken?
Heel acceptabel. We gebruiken het overal. En omdat we geen eigen diensten hebben, bieden we externe ondersteuning, hebben we vrij diverse klanten. Iedereen is daar tevreden mee. Dat wil zeggen, we hebben cron-taak die controleert. Met de klant wordt de duur van sessies afgesproken, die we niet eerder beëindigen. Dit kan een minuut zijn, dit kan 10 minuten zijn. Het hangt af van de belasting van de database en het doel ervan. Maar bij iedereen gebruiken we pg_stat_activity.
Bedankt voor de presentatie! Ik probeer jouw presentatie te verbinden met mijn applicaties. En het lijkt erop dat we overal een transactie starten en deze duidelijk beëindigen. Als er een uitzondering optreedt, vindt er toch een rollback plaats. En toen begon ik na te denken. Want een transactie kan misschien impliciet starten. Dit is waarschijnlijk een hint voor de dame. Als ik gewoon een record bijwerk, start de transactie in PostgreSQL en eindigt deze pas wanneer de verbinding wordt verbroken?
Als je het nu over het applicatenniveau hebt, hangt het af van de driver die je gebruikt, van de ORM die wordt gebruikt. Er zijn veel instellingen. Als auto commit ingeschakeld is, start de transactie en wordt deze meteen gesloten.
Dat wil zeggen, wordt het onmiddellijk gesloten na de update?
Dat hangt af van de instellingen. Ik noemde al een instelling. Dat is auto commit. Het is vrij gebruikelijk. Als het is ingeschakeld, werd de transactie geopend en weer gesloten. Als je niet expliciet zei "start transactie" en "eindig transactie", maar gewoon een verzoek in de sessie uitvoerde.
Hallo! Bedankt voor de presentatie! Stel je voor dat we een database hebben die steeds maar groter wordt en dat er op de server geen ruimte meer is. Zijn er tools om deze situatie te verhelpen?
De ruimte op de server moet idealiter worden gemonitord.
Bijvoorbeeld, de DBA ging thee drinken, was op vakantie, enzovoort.
Wanneer een bestandssysteem wordt aangemaakt, wordt er minstens een deel van de gereserveerde ruimte gecreëerd waar geen gegevens worden geschreven.
En wat als het helemaal op nul is?
Daar heet het gereserveerde ruimte, dat wil zeggen, het kan worden vrijgemaakt en afhankelijk van hoe groot het is gemaakt, heeft u vrije ruimte gekregen. Standaard weet ik niet hoeveel daar is. In een andere situatie moeten er schijven worden geleverd zodat u ruimte heeft om een hersteloperatie uit te voeren. U kunt een tabel verwijderen die u gegarandeerd niet nodig heeft.
Zijn er geen andere hulpmiddelen?
Dit is altijd handwerk. En ter plekke wordt vastgesteld wat het beste kan worden gedaan, omdat er kritische en niet-kritische gegevens zijn. En voor elke database en applicatie die ermee werkt, hangt dit van het bedrijf af. Het wordt altijd ter plekke beslist.
Bedankt voor de presentatie! Ik heb twee vragen. Ten eerste, u toonde dia's waarop werd aangetoond dat in het geval van vastlopende transacties zowel het volume van de tabelruimte als de grootte van de indexen toenemen. En verder in de presentatie waren er veel hulpprogramma's die de tabel inpakken. Wat gebeurt er met de index?
Ze worden ook ingepakt.
Maar de vacuumaanpak raakt de index niet?
Sommigen werken met de index. Bijvoorbeeld, pg_rapack, pgcompacttable. Vacuum maakt de indexen opnieuw aan, raakt ze aan. Het idee van VACUUM FULL is om alles opnieuw te schrijven, dat wil zeggen, het werkt met alles.
En de tweede vraag. Ik begreep niet waarom rapporten op replicas zo sterk afhankelijk zijn van de replicatie zelf. Ik dacht dat rapporten lezen zijn, terwijl replicatie schrijven is.
Waar ontstaat het conflict in de replicatie? We hebben een Master waar de processen plaatsvinden. We hebben auto-vacuum. Wat doet auto-vacuum? Het verwijdert sommige oude rijen. Als er ondertussen op de replica een verzoek loopt dat deze oude rijen leest, en op de Master was er een situatie waarin auto-vacuum deze rijen markeerde als mogelijk voor herschrijving, dan schrijven we ze opnieuw. En we hebben een datapakket gekregen, wanneer we die rijen moeten herschrijven die nodig zijn voor het verzoek op de replica, dan zal het replicatieproces wachten op de time-out die u heeft ingesteld. En dan zal PostgreSQL beslissen wat voor hem belangrijker is. En replicatie is voor hem belangrijker dan het verzoek, en hij zal het verzoek afschieten om deze wijzigingen op de replica uit te voeren.
Andrei, ik heb een vraag. Zijn deze geweldige grafieken die je tijdens de presentatie toonde, het resultaat van een van jouw tools? Hoe zijn de grafieken gemaakt?
Dit is een service .
Is dit een commercieel product?
Ja. Dit is een commercieel product.
Bron: habr.com
