

Hallo, Habr! Ik presenteer u de vertaling van het artikel van de auteurs Burak Yavuz, Brenner Heintz en Denny Lee, die is voorbereid ter gelegenheid van de start van de cursus van OTUS.
Gegevens, net als onze ervaring, accumuleren en evolueren voortdurend. Om niet achter te blijven, moeten onze mentale modellen van de wereld zich aanpassen aan nieuwe gegevens, waarvan sommige nieuwe dimensies bevatten - nieuwe manieren om naar dingen te kijken waarvan we eerder geen idee hadden. Deze mentale modellen verschillen weinig van de schema's van tabellen, die definiëren hoe we nieuwe informatie classificeren en verwerken.
Dit leidt ons tot de vraag van schema-beheer. Naarmate zakelijke taken en vereisten in de loop van de tijd veranderen, verandert ook de structuur van uw gegevens. Delta Lake maakt het eenvoudig om nieuwe dimensies in te voeren naarmate de gegevens veranderen. Gebruikers hebben toegang tot een eenvoudige semantiek voor het beheren van de schema's van hun tabellen. Deze tools omvatten schema-afdwinging (Schema Enforcement), die gebruikers beschermt tegen het onbedoeld vervuilen van hun tabellen met fouten of onnodige gegevens, evenals schema-evolutie (Schema Evolution), waarmee nieuwe kolommen met waardevolle gegevens automatisch op de juiste plaatsen kunnen worden toegevoegd. In dit artikel verdiepen we ons in het gebruik van deze tools.
Begrijpen van tabellschema's
Elke DataFrame in Apache Spark bevat een schema dat de structuur van de gegevens bepaalt, zoals datatypes, kolommen en metadata. Met Delta Lake wordt het schema van de tabel opgeslagen in JSON-formaat binnen het transactiedagboek.
Wat is schema-afdwinging?
Schema-afdwinging (Schema Enforcement), ook wel schema-validatie (Schema Validation) genoemd, is een beschermingsmechanisme in Delta Lake dat de kwaliteit van gegevens garandeert door records die niet aan het schema van de tabel voldoen af te wijzen. Net als een hostess bij de receptie van een populair restaurant die alleen op reservering accepteert, controleert dit of elke kolom met gegevens die in de tabel wordt ingevoerd, op de bijbehorende lijst van verwachte kolommen staat (met andere woorden, of er voor elk daarvan een 'reservering' is), en wijst het alle records af met kolommen die niet op de lijst staan.
Hoe werkt schema-afdwinging?
Delta Lake gebruikt schema-controle bij het schrijven, wat betekent dat alle nieuwe records in de tabel worden gecontroleerd op compatibiliteit met het schema van de doeltabel tijdens het schrijven. Als het schema niet compatibel is, annuleert Delta Lake de transactie volledig (gegevens worden niet opgeslagen) en genereert het een uitzondering om de gebruiker te waarschuwen voor de inconsistentie.
Om de compatibiliteit van een record met de tabel te bepalen, gebruikt Delta Lake de volgende regels. Geschreven DataFrame:
- mag geen extra kolommen bevatten die niet in het schema van de doeltabel aanwezig zijn. Omgekeerd is het prima als de binnenkomende gegevens niet alle kolommen uit de tabel bevatten — deze kolommen krijgen gewoon null-waarden toegewezen.
- mag geen datatypes van kolommen hebben die verschillen van de datatypes van de kolommen in de doeltabel. Als een kolom in de doeltabel gegevens van het type StringType bevat, maar de overeenkomstige kolom in het DataFrame gegevens van het type IntegerType bevat, zal het afdwingen van het schema een uitzondering veroorzaken en de uitvoer van de schrijfoperatie blokkeren.
- mag geen kolomnamen bevatten die alleen in hoofdlettergebruik verschillen. Dit betekent dat je geen kolommen met de namen 'Foo' en 'foo' kunt hebben die in één tabel zijn gedefinieerd. Hoewel Spark kan worden gebruikt in hoofdlettergevoelige of -ongevoelige (standaard) modus, behoudt Delta Lake de hoofdlettergevoeligheid maar is het niet hoofdlettergevoelig wat betreft het opslaan van het schema. Parquet is hoofdlettergevoelig bij het opslaan en retourneren van kolominformatie. Om mogelijke fouten, datacorruptie of gegevensverlies te voorkomen (waar we persoonlijk mee te maken hebben gehad bij Databricks), hebben we besloten deze beperking toe te voegen.
Om dit te illustreren, laten we eens kijken naar wat er gebeurt in de onderstaande code wanneer we proberen enkele recent gegenereerde kolommen toe te voegen aan een Delta Lake-tabel die nog niet is ingesteld om deze te accepteren.
# Сгенерируем DataFrame ссуд, который мы добавим в нашу таблицу Delta Lake
loans = sql("""
            SELECT addr_state, CAST(rand(10)*count as bigint) AS count,
            CAST(rand(10) * 10000 * count AS double) AS amount
            FROM loan_by_state_delta
            """)

# Вывести исходную схему DataFrame
original_loans.printSchema()

root
  |-- addr_state: string (nullable = true)
  |-- count: integer (nullable = true)

# Вывести новую схему DataFrame
loans.printSchema()

root
  |-- addr_state: string (nullable = true)
  |-- count: integer (nullable = true)
  |-- amount: double (nullable = true) # new column

# Попытка добавить новый DataFrame (с новым столбцом) в существующую таблицу
loans.write.format("delta")
           .mode("append")
           .save(DELTALAKE_PATH)

Returns:

A schema mismatch detected when writing to the Delta table.

To enable schema migration, please set:
'.option("mergeSchema", "true")'

Table schema:
root
-- addr_state: string (nullable = true)
-- count: long (nullable = true)

Data schema:
root
-- addr_state: string (nullable = true)
-- count: long (nullable = true)
-- amount: double (nullable = true)

If Table ACLs are enabled, these options will be ignored. Please use the ALTER TABLE command for changing the schema.
In plaats van automatisch nieuwe kolommen toe te voegen, handhaaft Delta Lake het schema en stopt het de schrijfoperatie. Om te helpen identificeren welke kolom (of meerdere) de oorzaak van de inconsistentie is, zal Spark beide schema's uit de stacktrace afdrukken voor vergelijking.
Wat is het voordeel van het afdwingen van het schema?
Aangezien het afdwingen van een schema een strenge controle met zich meebrengt, is het een uitstekend instrument om te gebruiken als poortwachter voor een schone, volledig omgevormde dataset die klaar is voor productie of consumptie. Het wordt doorgaans toegepast op tabellen die gegevens direct aanbieden:
- Machine learning-algoritmen
- BI-dashboarden
- Gegevensanalyse en visualisatietools
- Elke productiesysteem dat strikte gestructureerde, strikt getypeerde semantische schema's vereist.
Om uw gegevens voor deze laatste barrière voor te bereiden, gebruiken veel gebruikers een eenvoudige ‘multi-hop’ architectuur die geleidelijk structuur in hun tabellen aanbrengt. Om hier meer over te leren, kunt u het artikel bekijken
Natuurlijk kan het afdwingen van een schema overal in uw pijplijn worden gebruikt, maar houd er rekening mee dat streamen naar een tabel in dat geval frustrerend kan zijn, vooral als u bent vergeten dat u een extra kolom aan de inkomende gegevens hebt toegevoegd.
Voorkomen van gegevensverdunning
Tot dit moment vraagt u zich misschien af, waar is al deze ophef om te doen? Uiteindelijk kan een onverwachte ‘schema mismatch’-fout uw workflow verstoren, vooral als u nieuw bent bij Delta Lake. Waarom gewoon niet de schema laten veranderen zoals nodig is, zodat ik mijn DataFrame kan opslaan, ongeacht wat er gebeurt?
Zoals het oude gezegde luidt: ‘Een ons preventie is een pond genezing waard’. Op een gegeven moment, als u niet voor uw schema zorgt, zullen typecompatibiliteitsproblemen hun lelijke kop opsteken - ogenschijnlijk homogene bronnen van ruwe gegevens kunnen randgevallen, beschadigde kolommen, verkeerd geconfigureerde mappings of andere vreselijke dingen bevatten die in nachtmerries opduiken. De beste benadering is om deze vijanden bij de poort te stoppen - door middel van schema-afdwingen - en ermee om te gaan in het licht, in plaats van later, wanneer ze beginnen rond te neuzen in de donkere diepten van uw werkcode.
Het afdwingen van een schema geeft de zekerheid dat het schema van uw tabel niet verandert, tenzij u zelf een wijzigingsoptie bevestigt. Dit voorkomt het 'verdunnen' van gegevens, wat kan gebeuren wanneer nieuwe kolommen zo vaak worden toegevoegd dat ooit waardevolle, gecomprimeerde tabellen hun betekenis en nut verliezen door een overvloed aan gegevens. Door u aan te moedigen om doelbewust te zijn, hoge standaarden te stellen en hoge kwaliteit te verwachten, doet het afdwingen van het schema precies waarvoor het bedoeld is: u helpen integer te blijven en uw tabellen schoon.
Als u bij verdere overweging beslist dat u eigenlijk moet een nieuwe kolom wilt toevoegen, geen probleem, hieronder staat een eenregelige oplossing. De oplossing is schema-evolutie!
Wat is schema-evolutie?
Schema-evolutie is een functie die gebruikers in staat stelt om de huidige tabelstructuur eenvoudig te wijzigen op basis van gegevens die in de loop der tijd veranderen. Het wordt het vaakst gebruikt tijdens een toevoeging of herschrijfoperatie om automatisch het schema aan te passen voor één of meerdere nieuwe kolommen.
Hoe werkt schema-evolutie?
Door het voorbeeld uit de vorige sectie te volgen, kunnen ontwikkelaars schema-evolutie eenvoudig gebruiken om nieuwe kolommen toe te voegen die eerder waren afgewezen vanwege schema-inconsistenties. Schema-evolutie wordt geactiveerd door .option('mergeSchema', 'true') toe te voegen aan uw Spark-opdracht .write of .writeStream.
# Добавьте параметр mergeSchema
loans.write.format("delta")
           .option("mergeSchema", "true")
           .mode("append")
           .save(DELTALAKE_SILVER_PATH)
Voer de volgende Spark SQL-query uit om de grafiek te bekijken
# Создайте график с новым столбцом, чтобы подтвердить, что запись прошла успешно
%sql
SELECT addr_state, sum(`amount`) AS amount
FROM loan_by_state_delta
GROUP BY addr_state
ORDER BY sum(`amount`)
DESC LIMIT 10 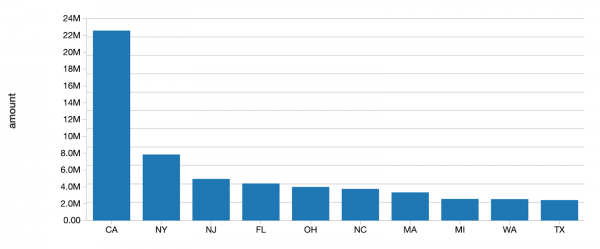
Als alternatief kunt u deze optie instellen voor de gehele Spark-sessie door spark.databricks.delta.schema.autoMerge = True toe te voegen aan de Spark-configuratie. Maar wees voorzichtig, want als u schema afdwingt, ontvangt u geen waarschuwingen meer over onopzettelijke schema-inconsistenties.
Door in de query de parameter mergeSchematoe te voegen, worden alle kolommen die in de DataFrame aanwezig zijn maar ontbreken in de doeltabel automatisch aan het einde van het schema toegevoegd binnen de schrijfactie. Ook geneste velden kunnen worden toegevoegd, en zij worden ook aan het einde van de bijbehorende kolommen in de structuur toegevoegd.
Data-engineers en wetenschappers kunnen deze functie gebruiken om nieuwe kolommen toe te voegen (mogelijk een recent bijgehouden metriek of een kolom met verkoopcijfers van deze maand) aan hun bestaande machine learning-productietabellen, zonder de bestaande modellen die op oude kolommen zijn gebaseerd te verstoren.
De volgende soorten schema wijzigingen zijn toegestaan in het kader van schema evolutie tijdens het toevoegen of overschrijven van een tabel:
- Nieuwe kolommen toevoegen (dit is het meest voorkomende scenario)
- Wijzigen van datatypes van NullType -> elk ander type of verhogen van ByteType -> ShortType -> IntegerType
Andere wijzigingen die niet zijn toegestaan in het kader van schema evolutie vereisen dat het schema en de gegevens worden overschreven door het toevoegen .option("overwriteSchema", "true"). Bijvoorbeeld, in het geval dat de kolom "Foo" oorspronkelijk een integer was en het nieuwe schema van string datatype zou zijn, dan moesten alle Parquet-bestanden (data) worden overschreven. Dergelijke wijzigingen zijn:
- verwijderen van een kolom
- wijzigen van het datatype van een bestaande kolom (op locatie)
- hernoemen van kolommen die alleen qua hoofdletters verschillen (bijvoorbeeld "Foo" en "foo")
Ten slotte zal met de volgende release van Spark 3.0 expliciete DDL (met gebruik van ALTER TABLE) volledig worden ondersteund, waardoor gebruikers de volgende acties op tabelschema's kunnen uitvoeren:
- kolommen toevoegen
- commentaren van kolommen wijzigen
- instellen van de tabel eigenschappen die het gedrag van de tabel bepalen, zoals het instellen van de bewaartermijn voor het transactie log.
Wat zijn de voordelen van schema evolutie?
Schema evolutie kan altijd worden gebruikt wanneer u van plan bent het schema van uw tabel te wijzigen (in tegenstelling tot wanneer u per ongeluk kolommen aan uw DataFrame toevoegt die daar niet in thuishoren). Het is de eenvoudigste manier om uw schema te migreren, omdat het automatisch de juiste kolomnamen en datatypes toevoegt zonder dat expliciete declaratie nodig is.
Conclusie
Dwingende toepassing van het schema wijst nieuwe kolommen of andere schemawijzigingen af die niet compatibel zijn met uw tabel. Door deze hoge normen vast te stellen en te handhaven, kunnen analisten en ingenieurs erop vertrouwen dat hun gegevens de hoogste integriteit hebben, wat hen in staat stelt om effectievere zakelijke beslissingen te nemen.
Aan de andere kant completeert de evolutie van het schema de dwingende toepassing en vereenvoudigt het vermoedelijke automatische schemawijzigingen. Tenslotte zou het geen complicatie moeten zijn — een kolom toevoegen.
Dwingende toepassing van het schema is yang, terwijl de evolutie van het schema yin is. Samen zorgen deze functies ervoor dat het onderdrukken van ruis en het afstemmen van het signaal eenvoudiger is dan ooit.
We willen ook Mukul Murty en Pranav Anand bedanken voor hun bijdrage aan dit artikel.
Andere artikelen in deze serie:
Artikelen over dit onderwerp
Bron: habr.com
