

Een belangrijk aspect van de werking van gedistribueerde systemen is het omgaan met uitval. Kubernetes helpt hierbij door controllers te gebruiken die de status van uw systeem in de gaten houden en niet-functionerende services opnieuw opstarten. Echter, Kubernetes kan gedwongen zijn om uw applicaties te stoppen om de algehele levensvatbaarheid van het systeem te waarborgen. In deze serie zullen we kijken naar hoe we Kubernetes kunnen helpen om zijn werk efficiënter uit te voeren en de stilstandtijd van toepassingen te verkorten.
Voor de invoering van containers draaiden de meeste applicaties op virtuele of fysieke machines. Wanneer een applicatie uitviel of vastliep, kostte het veel tijd om de lopende taak te stoppen en het programma opnieuw te starten. In het ergste geval moest iemand dit probleem handmatig 's nachts, op ongelegen tijden, oplossen. Als een belangrijke taak werd uitgevoerd door slechts 1-2 werkmachines, was zo'n uitval volstrekt onaanvaardbaar.
Daarom begon men in plaats van handmatige herstart monitoring op procesniveau te gebruiken voor het automatisch opnieuw opstarten van een applicatie in het geval van een crash. Als het programma uitviel, vangt de bewakingsproces de exit-code op en herstart de server. Met de opkomst van systemen zoals Kubernetes werd deze manier van reageren op systeemuitval eenvoudig geïntegreerd in de infrastructuur.
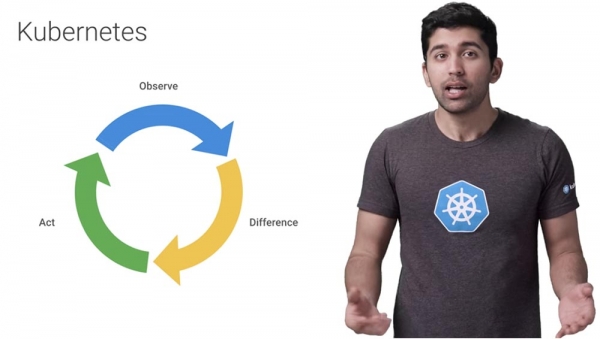
Kubernetes gebruikt een gebeurtenislus van 'bewaking - vastleggen van verschillen - actie ondernemen' om ervoor te zorgen dat bronnen operationeel blijven op het pad van containers naar de nodes zelf.
Dit betekent dat u niet langer handmatig processen hoeft te monitoren. Als een bron de Health Check niet doorstaat, zal Kubernetes automatisch een vervanging bieden. Daarnaast doet Kubernetes veel meer dan alleen het monitoren van uitval van uw applicaties. Het kan meer kopieën van de applicatie maken om op meerdere machines te draaien, de applicatie updaten of gelijktijdig meerdere versies van uw applicatie uitvoeren.
Er zijn daarom veel redenen waarom Kubernetes een volledig gezonde container kan beëindigen. Bijvoorbeeld, als je je deployment bijwerkt, zal Kubernetes langzaam oude pods stopzetten terwijl het tegelijkertijd nieuwe opstart. Als je een node uitschakelt, stopt Kubernetes alle pods op die node. Ten slotte, als een node zonder middelen komt te zitten, zal Kubernetes alle pods uitschakelen om die middelen vrij te maken.
Het is dus cruciaal dat je applicatie stopt met een minimale impact op de eindgebruiker en een minimale hersteltijd. Dit betekent dat het, voordat het wordt uitgeschakeld, alle noodzakelijke gegevens moet opslaan, alle netwerkverbindingen moet sluiten, resterend werk moet afronden en andere dringende taken moet afhandelen.
In de praktijk betekent dit dat je applicatie signalen zoals SIGTERM moet kunnen verwerken – het signaal voor procesbeëindiging dat de standaard is voor de kill-tool in Unix-achtige besturingssystemen. Wanneer dit signaal wordt ontvangen, moet de applicatie zich afsluiten.
Nadat Kubernetes heeft besloten een pod te beëindigen, vindt er een reeks gebeurtenissen plaats. Laten we elke stap bekijken die Kubernetes doorloopt bij het afsluiten van een container of pod.
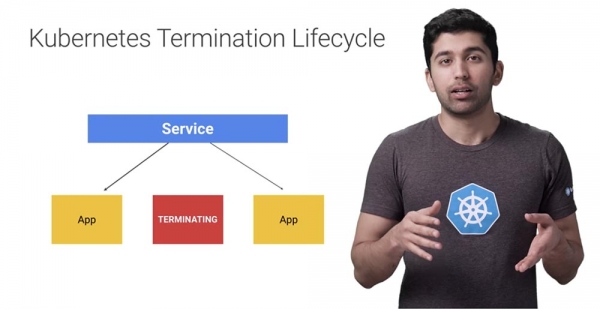
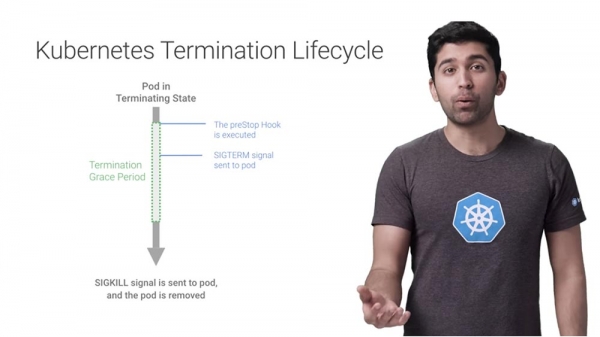
Stel dat we een van de pods willen beëindigen. Op dat moment zal het stoppen met het ontvangen van nieuw verkeer – de actieve containers in de pod worden niet beïnvloed, maar al het nieuwe verkeer wordt geblokkeerd.
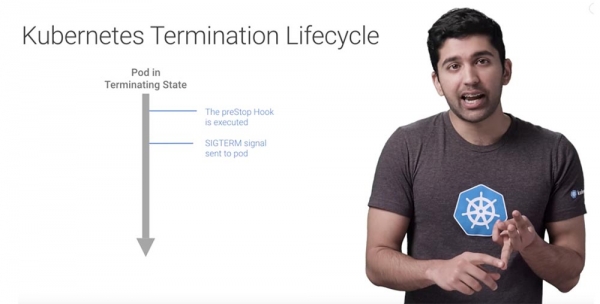
Laten we de preStop hook bekijken – dit is een speciale opdracht of HTTP-verzoek dat naar de containers in de pod wordt verzonden. Als je applicatie niet correct afsluit bij het ontvangen van SIGTERM, kun je preStop gebruiken voor een correcte beëindiging.
De meeste programma's beëindigen hun werk op een correcte manier bij ontvangst van het SIGTERM-signaal, maar als je gebruik maakt van externe code of een systeem dat je niet volledig kunt beheersen, biedt de preStop hook een uitstekende manier om een elegante afsluiting te forceren zonder de applicatie aan te passen.
Na het uitvoeren van deze hook zal Kubernetes een SIGTERM-signaal naar de containers in de pod sturen, waarmee ze op de hoogte worden gesteld dat ze binnenkort worden uitgeschakeld. Bij ontvangst van dit signaal zal uw code overgaan tot het afsluitproces. Dit proces kan onder meer het stoppen van eventuele langdurige verbindingen, zoals een verbinding met de database of een WebSocket-stroom, het opslaan van de huidige status en dergelijke omvatten.
Zelfs als u de preStop-hook gebruikt, is het zeer belangrijk om te controleren wat er met uw applicatie gebeurt wanneer u het SIGTERM-signaal naar hem stuurt, hoe het zich gedraagt, zodat gebeurtenissen of veranderingen in de werking van het systeem, veroorzaakt door de beëindiging van de pod, geen verrassing voor u worden.
Op dit moment, voordat verdere stappen worden ondernomen, zal Kubernetes wachten gedurende een bepaalde tijd, bekend als terminationGracePeriodSecond, of de periode voor een correcte beëindiging bij ontvangst van het SIGTERM-signaal.
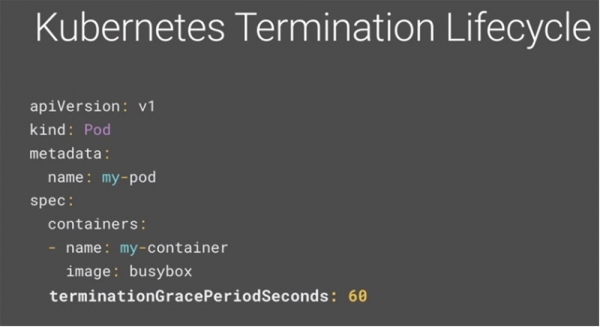
Standaard is deze periode 30 seconden. Het is belangrijk op te merken dat deze gelijktijdig verloopt met de preStop-hook en het SIGTERM-signaal. Kubernetes zal niet wachten tot de preStop-hook en SIGTERM zijn voltooid - als uw applicatie wordt afgesloten vóór het einde van de terminationGracePeriod, zal Kubernetes onmiddellijk doorgaan naar de volgende stap. Controleer daarom of de waarde van deze periode in seconden niet minder is dan de tijd die nodig is voor een correcte beëindiging van de pod, en als deze meer dan 30 seconden bedraagt, verhoog dan de periode tot de vereiste waarde in YAML. In het gegeven voorbeeld bedraagt deze 60 seconden.
En tenslotte, de laatste stap - als de containers nog steeds actief zijn na het verstrijken van de terminationGracePeriod, sturen ze een SIGKILL-signaal en worden ze gedwongen om te stoppen. Op dat moment zal Kubernetes ook alle andere objecten van de pod opruimen.
Kubernetes beëindigt pods om verschillende redenen, dus zorg ervoor dat uw applicatie in elk geval correct wordt afgesloten om een stabiele werking van de service te waarborgen.
Een beetje reclame 🙂
Bedankt dat je bij ons blijft. Houd je van onze artikelen? Wil je meer interessante inhoud zien? Ondersteun ons door een bestelling te plaatsen of ons aan vrienden aan te bevelen, , een unieke variant van entry-level servers, die we voor jou hebben bedacht: (opties beschikbaar met RAID1 en RAID10, tot 24 cores en tot 40GB DDR4).
Dell R730xd is 2 keer goedkoper in datacenter Equinix Tier IV in Amsterdam? Alleen bij ons in Nederland! Dell R420 — 2x E5-2430 2.2Ghz 6C 128GB DDR3 2x960GB SSD 1Gbps 100TB — vanaf $99! Lees over hoe
Bron: habr.com
