

Deze lente hebben we al enkele inleidende onderwerpen besproken, zoals en . In de tweede hebben we zelfs beloofd om de prestaties van verschillende multi-schijf topologieën in ZFS verder te onderzoeken. Dit is een next-gen bestandssysteem dat momenteel overal wordt geïmplementeerd: van tot .
Nou, vandaag is de meest geschikte dag om kennis te maken met ZFS, nieuwsgierige lezers. Weet gewoon dat, volgens de bescheiden schatting van de OpenZFS-ontwikkelaar Matt Arons, 'het echt moeilijk is'.
Maar voordat we bij de cijfers komen - en die komen, beloof ik - voor alle varianten van de acht-schijfconfiguraties van ZFS, moeten we het hebben over hoe hoe ZFS data op de schijf opslaat.
Zpool, vdev en device
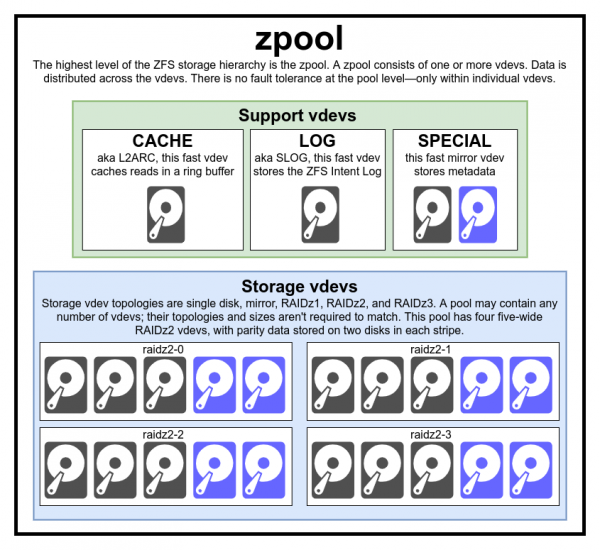
Dit diagram van een volledige pool bevat drie ondersteunende vdev's, elk van een andere klasse, en vier voor RAIDz2
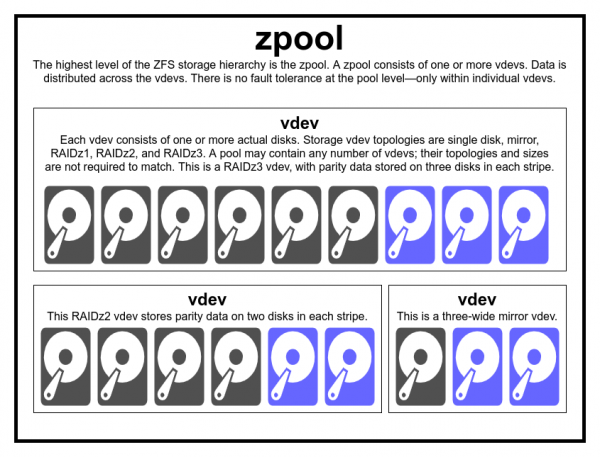
Normaal gesproken zijn er geen redenen om een pool te creëren van incompatibele types en maten vdev - maar als je dat wilt, staat er niets in de weg.
Om het ZFS-bestandssysteem echt te begrijpen, moet je goed kijken naar de werkelijke structuur. Ten eerste combineert ZFS de traditionele niveaus van volume- en bestandssysteembeheer. Ten tweede maakt het gebruik van een transactionele copy-on-write-mechanisme. Deze kenmerken maken het systeem structureel zeer verschillend van reguliere bestandssystemen en RAID-arrays. De eerste set bouwstenen om te begrijpen: dat is de opslagpool (zpool), het virtuele apparaat (vdev) en het fysieke apparaat (device).
zpool
De opslagpool zpool is de bovenste structuur van ZFS. Elke pool bevat een of meerdere virtuele apparaten. Op hun beurt bevat elk van deze een of meerdere fysieke apparaten (device). Virtuele pools zijn autonome blokken. Eén fysiek apparaat kan twee of meer gescheiden pools bevatten, maar elke pool is volledig onafhankelijk van de andere. Pools kunnen geen gebruik maken van virtuele apparaten.
De redundantie van ZFS bevindt zich op het niveau van de virtuele apparaten en niet op het niveau van de pools. Op het niveau van de pools is er absoluut geen redundantie - als een vdev-opslag of een speciaal vdev verloren gaat, gaat de hele pool samen met hem verloren.
Moderne opslagpools kunnen het verlies van cache of log van een virtueel apparaat overleven - hoewel ze een kleine hoeveelheid vuile gegevens kunnen verliezen als ze het vdev-log verliezen tijdens een stroomuitval of systeemfout.
Er heerst een wijdverspreide misvatting dat 'data stripes' (stripes) in ZFS over de hele pool worden geschreven. Dit is onjuist. Een Zpool is niet zomaar een leuk RAID0, het is eerder een leuk met een complex en variabel mechanisme voor gegevensverdeling.
Over het algemeen worden gegevens verdeeld over de beschikbare virtuele apparaten op basis van de beschikbare vrije ruimte, zodat ze theoretisch allemaal gelijktijdig gevuld zullen worden. In latere versies van ZFS wordt het huidige gebruik (utilisatie) van vdev overwogen - als een virtueel apparaat veel zwaarder belast is dan een ander (bijvoorbeeld door een hoge leesbelasting), wordt het tijdelijk overgeslagen voor schrijven, ondanks de hoogste graad van vrije ruimte.
Het mechanisme voor het bepalen van de utilisatie, ingebouwd in moderne gegevensverdelingsmethoden van ZFS, kan de latentie verminderen en de doorvoer verhogen tijdens perioden van ongewoon hoge belasting - maar dat is geen blanke cheque voor onvrijwillige menging van langzame HDD's en snelle SSD's in één pool. Zo'n ongelijkwaardige pool werkt nog steeds met de snelheid van het langzame apparaat, dat wil zeggen alsof het volledig uit zulke apparaten bestaat.
vdev
Elke opslagpool bestaat uit een of meerdere virtuele apparaten (virtual device, vdev). Elk vdev omvat op zijn beurt een of meerdere fysieke apparaten. De meeste virtuele apparaten worden gebruikt voor eenvoudige gegevensopslag, maar er zijn verschillende ondersteunende klassen vdev, waaronder CACHE, LOG en SPECIAL. Elk van deze vdev-typen kan een van de vijf topologieën hebben: enkel apparaat (single-device), RAIDz1, RAIDz2, RAIDz3 of mirror.
RAIDz1, RAIDz2 en RAIDz3 zijn speciale varianten van wat oudere systemen een RAID met dubbele (diagonaal) pariteit zouden noemen. 1, 2 en 3 verwijzen naar het aantal pariteitsblokken dat aan elke datalagi is toegewezen. In plaats van aparte schijven voor pariteit, verdelen virtuele RAIDz-apparaten deze pariteit gelijkmatig over de schijven. Een RAIDz-array kan zoveel schijven verliezen als het aantal pariteitsblokken; als het er nog één verliest, komt het in storing en neemt het de opslagpool mee.
In gemirrorde virtuele apparaten (mirror vdev) wordt elk blok op elk apparaat in de vdev opgeslagen. Hoewel de meest voorkomende dubbele mirror (two-wide) is, kan er in een mirror een willekeurig aantal apparaten aanwezig zijn – in grote installaties worden vaak driedubbele mirrors gebruikt voor hogere leesprestaties en fouttolerantie. Een mirror vdev kan elke storing overleven zolang er minstens één apparaat in de vdev blijft functioneren.
Enkele vdev's zijn van nature riskant. Zo'n virtueel apparaat overleeft geen enkele storing – en als het wordt gebruikt als opslag of speciaal vdev, dan zal de storing leiden tot de vernietiging van de hele pool. Wees hier zeer, zeer voorzichtig.
Virtuele apparaten CACHE, LOG en SPECIAL kunnen worden gemaakt volgens een van de bovenstaande topologieën – maar onthoud dat het verlies van een virtueel SPECIAL-apparaat betekent dat de pool verloren gaat, daarom wordt een redundante topologie sterk aanbevolen.
apparaat
Waarschijnlijk de eenvoudigste term in ZFS om te begrijpen – het is letterlijk een blokapparaat voor willekeurige toegang. Onthoud dat virtuele apparaten zijn opgebouwd uit afzonderlijke apparaten en dat de pool uit virtuele apparaten bestaat.
Schijven – magnetisch of solid-state – zijn de meest voorkomende blokapparaten die worden gebruikt als bouwstenen van vdev. Echter, elk apparaat met een descriptor in /dev is geschikt – dus zelfs hele hardware RAID-arrays kunnen als afzonderlijke apparaten worden gebruikt.
Een eenvoudige raw-bestand is een van de belangrijkste alternatieve blokapparaten waaruit een vdev kan worden opgebouwd. Testpools uit zijn een zeer handige manier om poolcommando's te testen en te zien hoeveel ruimte beschikbaar is in de pool of het virtuele apparaat van deze topologie.
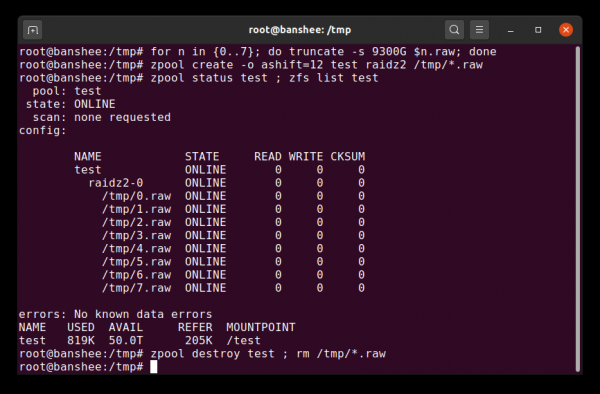
Je kunt binnen enkele seconden een testpool van dunne schijven aanmaken - maar vergeet niet om daarna de hele pool en zijn componenten te verwijderen.
Stel dat je een server wilt opzetten met acht schijven en van plan bent schijven van 10 TB (~9300 GiB) te gebruiken - maar je weet niet zeker welke topologie het beste aansluit bij jouw behoeften. In het bovenstaande voorbeeld bouwen we binnen enkele seconden een testpool van dunne schijven - en weten nu dat een RAIDz2 vdev van acht schijven van 10 TB 50 TiB nuttige capaciteit biedt.
Een andere bijzondere klasse apparaten zijn SPARE (reserve). Apparaten met hot-swappable mogelijkheden behoren, in tegenstelling tot gewone apparaten, tot de hele pool en niet tot één virtueel apparaat. Als een vdev in de pool uitvalt en een reserveapparaat is verbonden met de pool en beschikbaar, wordt het automatisch toegevoegd aan de getroffen vdev.
Nadat het reserveapparaat aan de getroffen vdev is gekoppeld, begint het met het ontvangen van kopieën of reconstructies van gegevens die op het ontbrekende apparaat zouden moeten staan. In traditionele RAID wordt dit herstel genoemd (rebuilding), terwijl dit in ZFS 'herstel van redundantie' (resilvering) wordt genoemd.
Het is belangrijk op te merken dat reserveapparaten niet permanent de defecte apparaten vervangen. Ze zijn slechts tijdelijke vervangers om de tijd te verkorten waarin er een degradatie van de vdev is. Nadat de beheerder het defecte vdev-apparaat heeft vervangen, vindt er herstel van redundantie plaats op dit permanente apparaat, en wordt de SPARE losgekoppeld van de vdev en opnieuw gebruikt als reserve voor de hele pool.
Datasets, blokken en sectoren
De volgende set bouwstenen die we moeten begrijpen in onze reis door ZFS heeft minder met hardware te maken, en meer met hoe de gegevens zelf zijn georganiseerd en opgeslagen. We slaan hier een paar niveaus over, zoals metaslab, om de details niet te overweldigen en het begrip van de algemene structuur te behouden.
Dataset
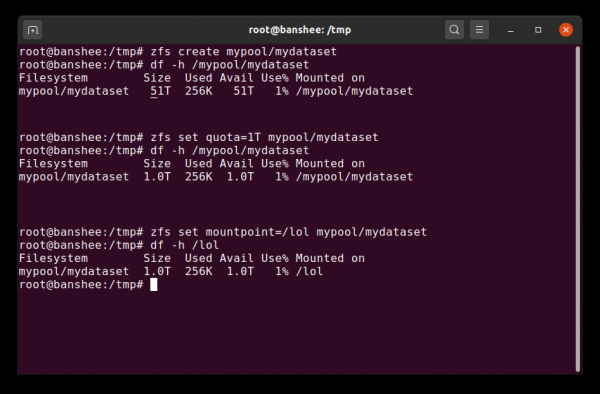
Wanneer we voor het eerst een dataset aanmaken, toont deze alle beschikbare ruimte van de pool. Daarna stellen we een quotum in - en veranderen we het inbouwpunt. Magie!
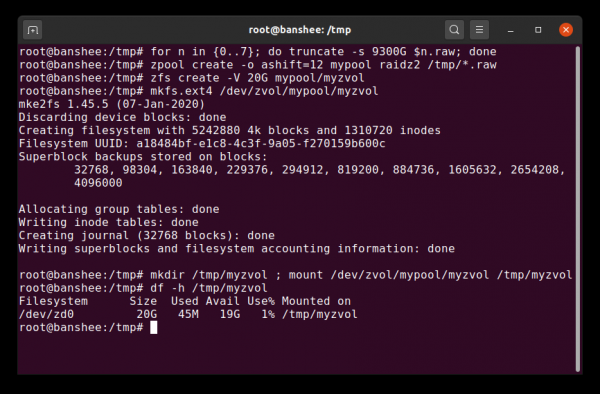
Zvol is in wezen gewoon een dataset, zonder zijn laag van het bestandssysteem, dat we hier vervangen door een volkomen normaal bestandssysteem ext4.
Een ZFS-dataset is ongeveer vergelijkbaar met een standaard gemounte bestandssysteem. Net als een gewoon bestandssysteem lijkt het op het eerste gezicht "gewoon weer een map". Maar net als bij gewone gemounte bestandssystemen heeft elke ZFS-dataset zijn eigen set basis eigenschappen.
In de eerste plaats kan er een toegewezen quotum voor de dataset zijn. Als je instelt zfs set quota=100G poolname/datasetname, dan kun je niet meer schrijven naar de gemounte map /poolname/datasetname dan 100 GiB.
Heb je de aanwezigheid – en afwezigheid – van schuine strepen aan het begin van elke regel opgemerkt? Elke dataset heeft zijn eigen plaats in zowel de ZFS-hiërarchie als de hiërarchie van het systeemmontage. In de ZFS-hiërarchie is er geen leidende schuine streep – je begint met de naam van de pool en vervolgens de pad van de ene dataset naar de volgende. Bijvoorbeeld, pool/parent/child voor een dataset met de naam kind onder de bovenliggende dataset parent in de pool met de creatieve naam pool.
Standaard zal het montagempunt van de dataset gelijk zijn aan zijn naam in de ZFS-hiërarchie, met een schuine streep aan het begin – de pool met de naam pool zal worden gemonteerd als /pool, de dataset parent wordt gemonteerd in /pool/parent, en de onderliggende dataset kind wordt gemonteerd in /pool/parent/child. Echter, het systeemmontagempunt van de dataset kan worden gewijzigd.
Als we opgeven zfs set mountpoint=/lol pool/parent/child, zal de dataset pool/parent/child in het systeem worden gemonteerd als /lol.
Naast datasets moeten we het hebben over volumes (zvols). Een volume is ongeveer vergelijkbaar met een dataset, behalve dat het feitelijk geen bestandssysteem heeft – het is gewoon een block device. Je kunt bijvoorbeeld een zvol met de naam mypool/myzvol, vervolgens formatteren met het bestandssysteem ext4, en daarna dat bestandssysteem mounten – nu heb je een ext4-bestandssysteem, maar met ondersteuning voor alle ZFS-beveiligingsfuncties! Dit lijkt misschien onzinnig op één computer, maar heeft veel meer zin als backend bij het exporteren van een iSCSI-apparaat.
Modules
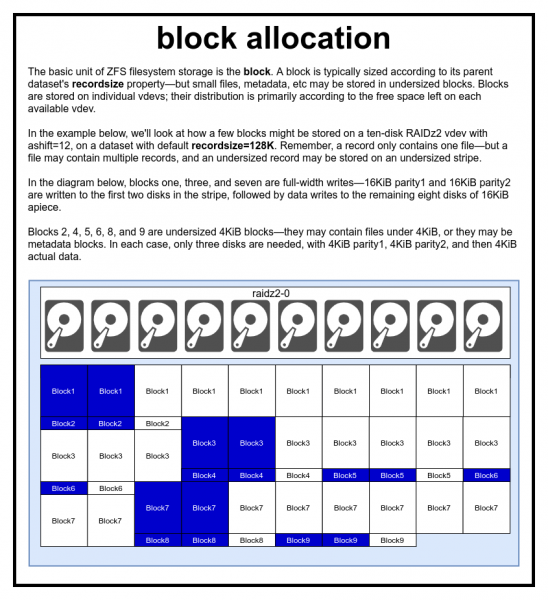
Een bestand wordt gepresenteerd door een of meerdere blokken. Elk blok wordt op één virtueel apparaat opgeslagen. De grootte van het blok is meestal gelijk aan de parameter recordsize, maar kan worden verminderd tot 2^ashift, als het metadata of een klein bestand bevat.
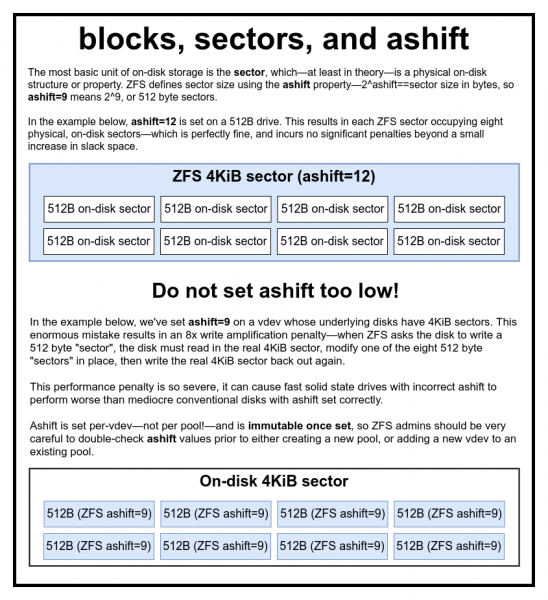
We bedoelen echt, inderdaad we maken geen grappen over enorme prestatiedalingen als je ashift te klein instelt.
In de ZFS-pool worden alle gegevens, inclusief metadata, opgeslagen in blokken. De maximale blokgrootte voor elke dataset wordt bepaald door de eigenschap recordsize (recordgrootte). De recordgrootte kan worden aangepast, maar dit verandert de grootte of locatie van bestaande blokken die al in de dataset zijn geschreven - het geldt alleen voor nieuwe blokken wanneer deze worden geschreven.
Als niets anders is gedefinieerd, is de huidige recordgrootte standaard 128 KiB. Dit is een soort moeilijk compromis, waarbij de prestaties in de meeste gevallen niet ideaal, maar ook niet slecht zijn. Recordgrootte kan worden ingesteld op elke waarde van 4K tot 1M (met extra instellingen recordsize kan het zelfs groter worden ingesteld, maar dat is zelden een goed idee).
Elk blok verwijst naar de gegevens van slechts één bestand - je kunt niet twee verschillende bestanden in één blok proppen. Elk bestand bestaat uit een of meerdere blokken, afhankelijk van de grootte. Als de bestandsgrootte kleiner is dan de recordgrootte, wordt het opgeslagen in een blok van kleinere grootte - bijvoorbeeld, een blok met een bestand van 2 KiB zal slechts één sector van 4 KiB op de schijf innemen.
Als een bestand groot genoeg is en meerdere blokken vereist, dan zullen alle records met dat bestand een grootte hebben recordsize - inclusief de laatste record, waarvan het grootste deel misschien .
Zvol volumes hebben geen eigenschap recordsize - in plaats daarvan hebben ze een equivalente eigenschap volblocksize..
Sectoren
De laatste, meest basale bouwsteen - de sector. Dit is de kleinste fysieke eenheid die kan worden geschreven of gelezen van het basisapparaat. Gedurende enkele tientallen jaren werden de meeste schijven geleverd met sectoren van 512 bytes. Tegenwoordig zijn de meeste schijven ingesteld op 4 KiB sectoren, en sommige, vooral SSD's, hebben sectoren van 8 KiB of zelfs meer.
In het ZFS-systeem is er een eigenschap waarmee je handmatig de sectorgrootte kunt instellen. Deze eigenschap ashift. Het is een beetje verwarrend omdat ashift een macht van twee is. Bijvoorbeeld, ashift=9 betekent een sector grootte van 2^9, of 512 bytes.
ZFS vraagt bij het toevoegen van elk blokapparaat aan een nieuwe vdev gedetailleerde informatie van het besturingssysteem en stelt theoretisch automatisch de ashift correct in op basis van deze informatie. Helaas liegen veel schijven over hun sectorgrootte om compatibiliteit met Windows XP te behouden (dat niet in staat was om schijven met andere sectorformaten te begrijpen).
Dit betekent dat een ZFS-beheerder ten zeerste wordt aangeraden om de werkelijke sectorgrootte van hun apparaten te kennen en deze handmatig in te stellen ashift. Als ashift te klein is ingesteld, neemt het aantal lees- en schrijfoperaties astronomisch toe. Het schrijven van 512-byte 'sectoren' naar een echte sector van 4 KiB betekent dat je eerst de eerste 'sector' moet schrijven, daarna de sector van 4 KiB moet lezen, deze moet wijzigen met de tweede 512-byte 'sector', deze terug moet schrijven naar de nieuwe sector van 4 KiB, en dat voor elke schrijfoperatie.
In de echte wereld heeft deze straf een grote impact op de Samsung EVO SSD's, waarvoor ashift=13, maar deze SSD's liegen over hun sectorgrootte, en daarom wordt standaard ingesteld op ashift=9. Als de ervaren systeembeheerder deze parameter niet wijzigt, werkt deze SSD trager van een gewone magnetische HDD.
Ter vergelijking, een te grote grootte heeft ashift bijna geen straf. Er is geen merkbare prestatievermindering en de toename van ongebruikt ruimte is verwaarloosbaar (of gelijk aan nul als compressie is ingeschakeld). Daarom raden we zelfs voor schijven die echt 512-byte sectoren gebruiken, aan om ashift=12 of zelfs ashift=13, om zeker naar de toekomst te kijken.
Eigenschap ashift wordt ingesteld voor elk virtueel apparaat vdev, en niet voor de pool, zoals velen ten onrechte denken — en wordt niet gewijzigd na de installatie. Als je per ongeluk deze instelling verstoort ashift bij het toevoegen van een nieuwe vdev aan de pool, heb je deze pool onherroepelijk verontreinigd met een apparaat met een lage prestatie, en meestal is er geen andere optie dan de pool te vernietigen en opnieuw te beginnen. Zelfs het verwijderen van de vdev zal niet helpen tegen de verstoorde configuratie. ashift!
Het mechanisme van copy-on-write
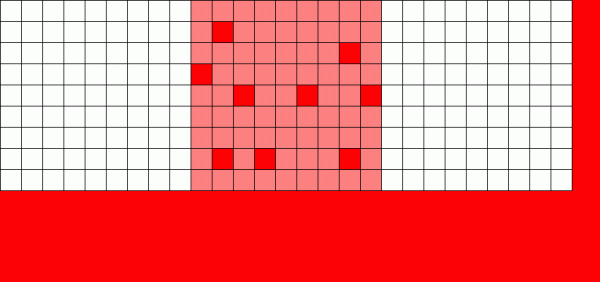
Als een gewone bestandssysteem gegevens opnieuw moet schrijven, wijzigt het elk blok waar het zich bevindt.
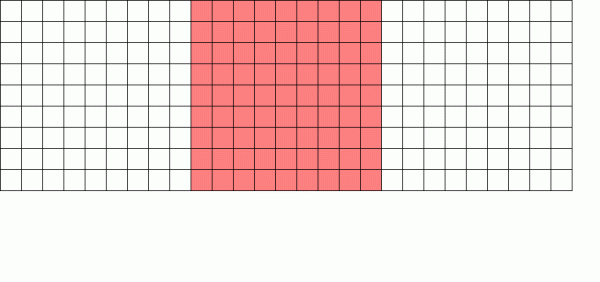
Een bestandssysteem met copy-on-write schrijft een nieuwe versie van een blok en ontgrendelt vervolgens de oude versie.
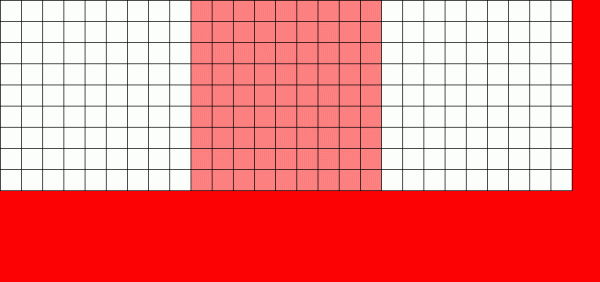
In abstracte termen, als we de echte fysieke locatie van de blokken negeren, vereenvoudigt onze 'datacomet' zich tot een 'datakrook', die van links naar rechts over de kaart van beschikbare ruimte beweegt.
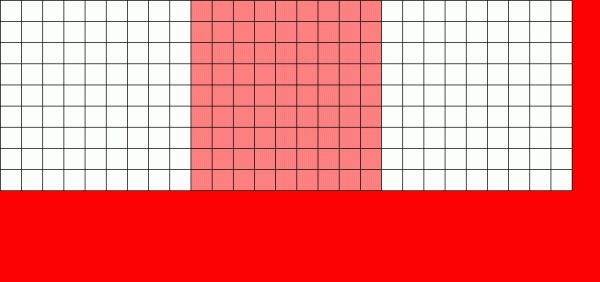
Nu kunnen we een goed begrip krijgen van hoe snapshots met copy-on-write werken - elk blok kan toebehoren aan meerdere snapshots en blijft bestaan totdat alle gekoppelde snapshots zijn vernietigd.
Het copy-on-write mechanisme (CoW) is de fundamentele basis van wat ZFS zo'n geweldig systeem maakt. Het belangrijkste concept is eenvoudig: als je een traditioneel bestandssysteem vraagt om een bestand te wijzigen, doet het precies wat je vraagt. Als je een bestandssysteem met copy-on-write hetzelfde vraagt, zegt het 'prima' - maar het liegt je.
In plaats daarvan schrijft een bestandssysteem met copy-on-write een nieuwe versie van het gewijzigde blok en werkt de metadata van het bestand bij om de verbinding met het oude blok te verbreken en deze te verbinden met het nieuwe blok dat je net hebt geschreven.
Het ontkoppelen van het oude blok en het koppelen van het nieuwe gebeurt in één operatie, zodat deze niet kan worden onderbroken - als je de stroom uitschakelt nadat dit is gebeurd, heb je een nieuwe versie van het bestand, en als je de stroom eerder uitschakelt, heb je de oude versie. In beide gevallen zullen er geen conflicten in het bestandssysteem optreden.
Copy-on-write in ZFS vindt niet alleen plaats op bestandssysteemniveau, maar ook op schijfbeheerniveau. Dit betekent dat ZFS niet onderhevig is aan een write hole () - een fenomeen waarbij de stripe slechts gedeeltelijk is geschreven voordat er een systeemfout optreedt, wat leidt tot beschadiging van de array na het opnieuw opstarten. Hier wordt de stripe atomair geschreven, vdev is altijd consistent, en .
ZIL: de intentie-log van ZFS
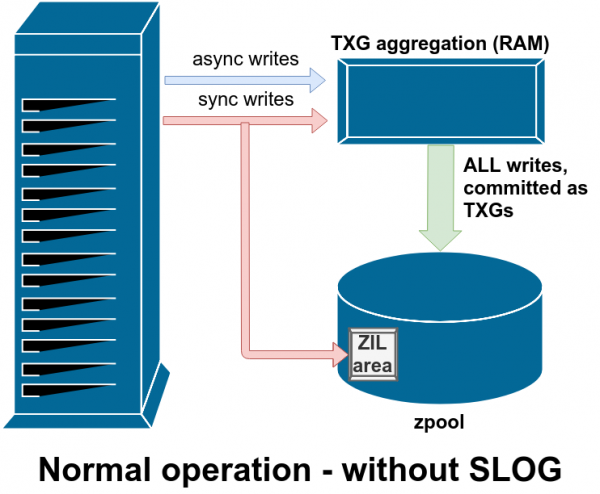
Het ZFS-systeem behandelt synchrone schrijfacties op een speciale manier - het slaat ze tijdelijk, maar onmiddellijk op in ZIL, voordat het ze later samen met asynchrone schrijfacties permanent opslaat.
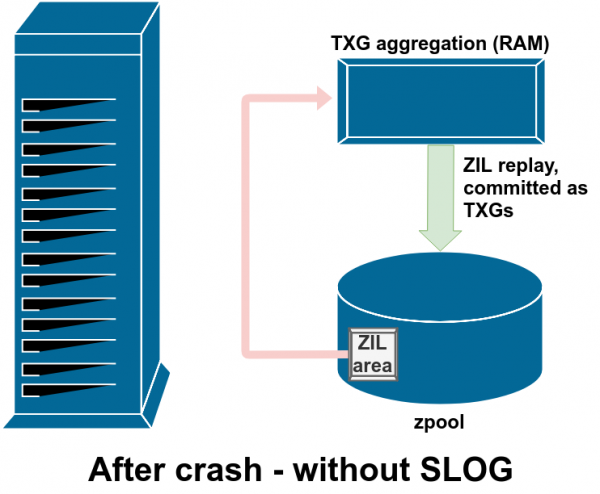
Gewoonlijk worden gegevens die op ZIL zijn geschreven, nooit meer gelezen. Maar dat is mogelijk na een systeemfout.
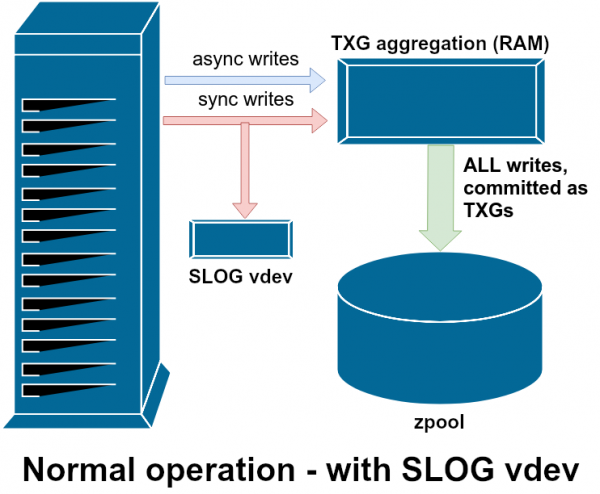
SLOG, of secundaire LOG-apparaat, is gewoon een speciale - en bij voorkeur zeer snelle - vdev, waar ZIL apart van de hoofdopslag kan worden opgeslagen.
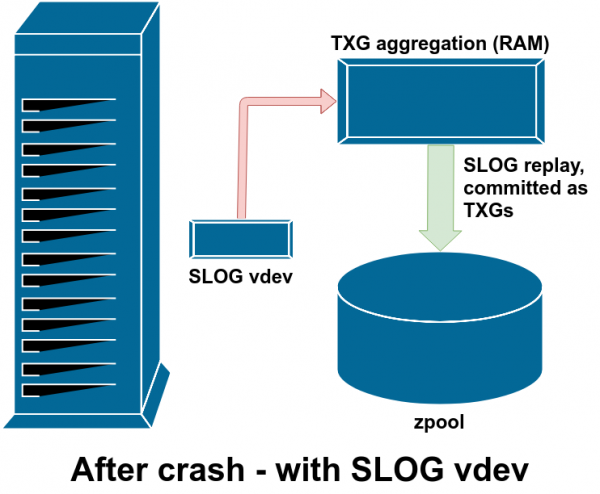
Na een crash worden alle onbenutte gegevens in ZIL hersteld - in dit geval bevindt ZIL zich op SLOG, dus worden ze precies vanaf daar hersteld.
Er zijn twee hoofdtypen schrijfoperaties - synchrone (sync) en asynchrone (async). Voor de meeste werkbelastingen zijn verreweg de meeste schrijfoperaties asynchroon - het bestandssysteem stelt hen in staat om te aggregeren en in pakketten uit te geven, wat fragmentatie vermindert en de doorvoer aanzienlijk verhoogt.
Synchrone schrijfinvoer is een totaal andere zaak. Wanneer een applicatie om een synchrone schrijfinvoer vraagt, zegt het bestandssysteem: 'Je moet dit vastleggen in niet-verliesgevoelige geheugen. direct nu, en totdat dat gebeurt kan ik niks meer doen.' Daarom moeten synchrone schrijfinvoeren onmiddellijk op de schijf worden vastgelegd - en als dit fragmentatie verhoogt of de doorvoer vermindert, dan zij dat maar zo.
ZFS behandelt synchrone schrijfinvoeren anders dan gewone bestandssystemen - in plaats van ze onmiddellijk in de normale opslag te gieten, legt ZFS ze vast in een speciaal opslaggebied dat de ZFS Intent Log wordt genoemd - ZIL. De truc is dat deze invoeren ook in het geheugen blijven, samen met gewone asynchrone schrijfinvoeren worden geaggregeerd, zodat ze later als volkomen normale TXG (transactiegroepen, Transaction Groups) naar de opslag kunnen worden weggeschreven.
In de normale werking wordt ZIL weggeschreven en nooit meer gelezen. Wanneer na een paar ogenblikken de invoeren uit ZIL in de hoofdopslag worden vastgelegd in de gewone TXG vanuit het RAM, worden ze losgekoppeld van ZIL. De enige keer dat iets uit ZIL wordt gelezen, is bij het importeren van een pool.
Als er een ZFS-fout optreedt - een storing in het besturingssysteem of een stroomuitval - wanneer er gegevens in ZIL staan, zullen deze gegevens worden gelezen tijdens de volgende import van de pool (bijvoorbeeld bij het herstarten van een noodsysteem). Alles wat in ZIL staat, wordt gelezen, samengevoegd in TXG-groepen, vastgelegd in de hoofdopslag en vervolgens losgekoppeld van ZIL tijdens het importproces.
Een van de hulpklassen van vdev heet LOG of SLOG, het secundaire LOG-apparaat. Het heeft één taak: om een pool te voorzien van een aparte en bij voorkeur veel snellere vdev met een zeer hoge schrijfstabiliteit voor het opslaan van ZIL, in plaats van ZIL op de hoofdopslagvdev op te slaan. De ZIL gedraagt zich hetzelfde, ongeacht de opslaglocatie, maar als de vdev met LOG zeer hoge schrijfsnelheden heeft, zullen synchronisatie-opnames sneller plaatsvinden.
Het toevoegen van een vdev met LOG aan de pool kan kan de prestaties van asynchrone schrijfopdrachten niet verbeteren - ook niet als je alle schrijfopdrachten geforceerd uitvoert naar ZIL met zfs set sync=always, ze zullen nog steeds verbonden zijn met de hoofdopslag in TXG op dezelfde manier en in hetzelfde tempo als zonder log. De enige directe prestatieverbetering is de vertraging van de synchronisatie-opname (aangezien de hogere snelheid van het log het uitvoeren van bewerkingen versnelt. sync).
Echter, in een omgeving die al veel synchronisatie-schrijfovergangen vereist, kan vdev LOG indirect asynchrone opname en ongecachede leesprestaties versnellen. Het uitladen van ZIL-opnames naar een aparte vdev LOG betekent minder concurrentie voor IOPS in de primaire opslag, wat in zekere mate de prestaties van alle lees- en schrijfoperaties verbetert.
Snapshots
De copy-on-write mechaniek is ook een noodzakelijke basis voor atomische snapshots van ZFS en incrementele asynchrone replicatie. In een actieve bestandssysteem is er een boom van pointers die alle records met actuele gegevens bijhouden - wanneer je een snapshot maakt, maak je simpelweg een kopie van deze boom van pointers.
Wanneer er een record in het actieve bestandssysteem wordt overschreven, schrijft ZFS eerst een nieuwe versie van de blok in ongebruikte ruimte. Daarna koppelt het de oude versie van het blok los van het huidig bestandssysteem. Maar als een snapshot naar de oude blok verwijst, blijft deze onveranderd. De oude blok zal feitelijk niet als vrije ruimte worden hersteld totdat alle snapshots die naar deze blok verwijzen, zijn vernietigd!
Replicatie
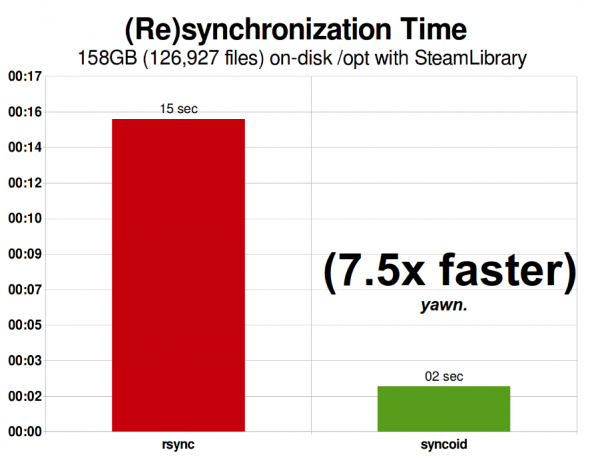
Mijn Steam-bibliotheek in 2015 bevatte 158 GiB en omvatte 126.927 bestanden. Dit is vrij dicht bij de optimale situatie voor rsync - de replicatie van ZFS over het netwerk was "slechts" 750% sneller.
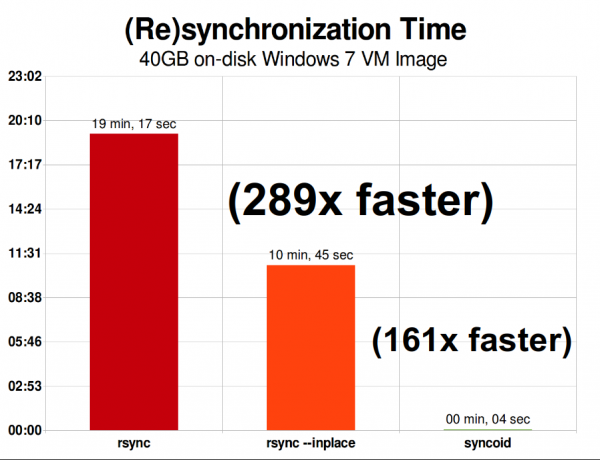
In hetzelfde netwerk is het repliceren van een 40-gigabyte afbeeldingsbestand van een Windows 7 virtuele machine een heel ander verhaal. ZFS-replicatie gebeurt 289 keer sneller dan rsync - of "slechts" 161 keer sneller als je goed genoeg bent om rsync met de --inplace optie aan te roepen.
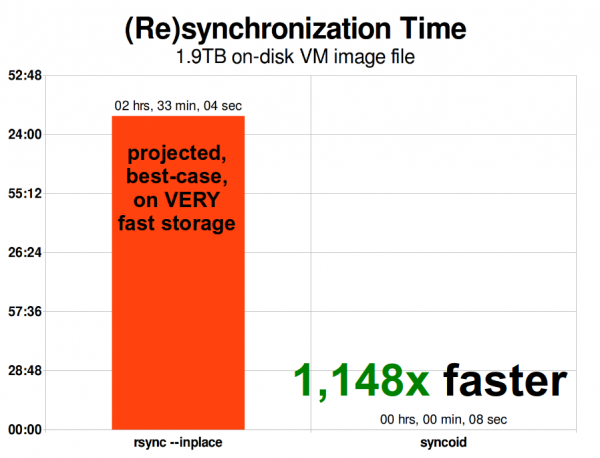
Wanneer de afbeelding van de virtuele machine wordt geschaald, worden de problemen van rsync mee geschaald. Een grootte van 1,9 TiB is niet zo groot voor een moderne virtuele machine afbeelding - maar het is groot genoeg dat ZFS-replicatie 1148 keer sneller is dan rsync, zelfs met de rsync --inplace argument.
Zodra je begrijpt hoe snapshots werken, is het niet moeilijk om de essentie van replicatie te begrijpen. Aangezien een snapshot eenvoudigweg een boom van verwijzingen naar records is, volgt hieruit dat als we een zfs send snapshot maken, we zowel deze boom als alle daaraan gerelateerde records verzenden. Wanneer we deze zfs send in zfs receive naar het doelobject sturen, schrijft het zowel de feitelijke inhoud van de blokken als de boom van verwijzingen die naar de blokken wijzen, naar de doel dataset.
Het wordt nog interessanter bij de tweede zfs send. Nu hebben we twee systemen, elk met poolname/datasetname@1, en je maakt een nieuwe snapshot poolname/datasetname@2.Daarom heb je in de oorspronkelijke pool datasetname@1 en datasetname@2,, terwijl de doelpool tot nu toe alleen de eerste snapshot heeft. datasetname@1.
Aangezien we een gemeenschappelijk snapshot hebben tussen de bron en het doel, kunnen we een datasetname@1incremental bovenop maken. Wanneer we het systeem zeggen zfs send zfs send -i poolname/datasetname@1 poolname/datasetname@2 , vergelijkt het de twee bomen van verwijzingen. Elke verwijzing die alleen inbestaat, verwijst duidelijk naar nieuwe blokken - daarom hebben we de inhoud van deze blokken nodig. @2In het externe systeem is het verwerken van de incrementele
even eenvoudig. Eerst schrijven we alle nieuwe records die in de stroom zijn opgenomen, en voegen dan de verwijzingen naar deze blokken toe. Voilà, we hebben send in het nieuwe systeem! sendAsynchrone incrementele ZFS-replicatie is een enorme verbetering ten opzichte van eerdere methoden die niet op snapshots zijn gebaseerd, zoals rsync. In beide gevallen worden alleen de gewijzigde gegevens verzonden - maar rsync moet eerst @2 alle gegevens van beide kanten vanaf de schijf lezen om de checksum te controleren en deze te vergelijken. In tegenstelling tot dit leest ZFS-replicatie niets, behalve de bomen van verwijzingen - en elke blok die niet wordt weergegeven in de gemeenschappelijke snapshot.
Asynchrone incrementele ZFS-replicatie is een enorme verbetering ten opzichte van eerdere methoden die niet op snapshots zijn gebaseerd, zoals rsync. In beide gevallen worden alleen de gewijzigde gegevens verzonden - maar rsync moet eerst lezen alle gegevens van beide kanten vanaf de schijf lezen om de checksum te controleren en deze te vergelijken. In tegenstelling tot dit leest ZFS-replicatie niets, behalve de bomen van verwijzingen - en elke blok die niet wordt weergegeven in de gemeenschappelijke snapshot.
Ingebouwde compressie
Het schrijfmechanisme vereenvoudigt ook het systeem van ingebouwde compressie. In traditionele bestandssystemen is compressie problematisch — zowel de oude als de nieuwe versie van gewijzigde gegevens bevinden zich in dezelfde ruimte.
Als we een gegevensfragment in het midden van een bestand bekijken, dat zijn leven begint als een megabyte nullen van 0x00000000 en zo verder — het is heel gemakkelijk samen te persen tot één sector op de schijf. Maar wat gebeurt er als we deze megabyte nullen vervangen door een megabyte niet-samendrukbare gegevens, zoals JPEG of pseudo-willekeurige ruis? Verbijsterend genoeg heeft deze megabyte gegevens plotseling niet één, maar 256 sectoren van 4 KiB nodig, terwijl er op dit punt op de schijf slechts één sector is gereserveerd.
ZFS heeft dit probleem niet, omdat gewijzigde opnamen altijd worden geschreven naar ongebruikte ruimte — het oorspronkelijke blok neemt slechts één sector van 4 KiB in beslag, en de nieuwe opname neemt er 256 in beslag, maar dat is geen probleem — het onlangs gewijzigde fragment uit het "midden" van het bestand zou naar ongebruikte ruimte worden geschreven, ongeacht of de grootte is veranderd of niet, dus voor ZFS is dit een volkomen normale situatie.
Ingebouwde compressie van ZFS is standaard uitgeschakeld, en het systeem biedt uitbreidbare algoritmen — momenteel zijn dat LZ4, gzip (1-9), LZJB en ZLE.
- LZ4 — dit is een streaming-algoritme dat extreem snelle compressie en decompressie biedt en prestatievoordelen oplevert voor de meeste gebruiksgevallen — zelfs op vrij langzame CPU's.
- GZIP — een gerenommeerd algoritme dat bekend en geliefd is bij alle gebruikers van Unix-systemen. Het kan worden geïmplementeerd met compressieniveaus van 1-9, waarbij de compressie toeneemt en het CPU-gebruik stijgt naarmate we dichter bij niveau 9 komen. Het algoritme is goed geschikt voor alle tekstuele (of andere extreem samen te drukken) gebruikstoepassingen, maar kan anderszins vaak problemen met CPU veroorzaken — gebruik het met voorzichtigheid, vooral op hogere niveaus.
- LZJB — het originele algoritme in ZFS. Het is verouderd en zou niet meer gebruikt moeten worden, LZ4 overtreft het op alle gebieden.
- ZLE — nul-niveau codering, Zero Level Encoding. Het raakt überhaupt geen normale gegevens aan, maar comprimeert grote reeksen nullen. Dit is nuttig voor volledig niet-samendrukbare datasets (zoals JPEG, MP4 of andere al gecomprimeerde formats), omdat het niet-samendrukbare gegevens negeert, maar ongebruikte ruimte in de uiteindelijke records comprimeert.
We raden LZ4-compressie aan voor vrijwel alle gebruikstoepassingen; de prestatiekosten bij het tegenkomen van niet-samendrukbare gegevens zijn zeer laag, en stijging de prestatieverbeteringen voor typische gegevens zijn aanzienlijk. Het kopiëren van een virtuele machine-image voor een nieuwe installatie van het Windows-besturingssysteem (een verse installatie, er zijn nog geen gegevens binnen) met compression=lz4 ging 27% sneller dan met compression=none, in .
ARC - adaptief vervangingscache
ZFS is het enige moderne bestandssysteem dat we kennen dat zijn eigen leescache-mechanisme gebruikt en niet afhankelijk is van de paginacache van het besturingssysteem om kopieën van recent gelezen blokken in het werkgeheugen op te slaan.
Hoewel de eigen cache niet zonder problemen is - ZFS kan niet zo snel reageren op nieuwe geheugenallocatieverzoeken als de kernel, waardoor een nieuwe aanvraag malloc() voor geheugenallocatie kan falen als het geheugen vereist dat momenteel door ARC wordt gebruikt. Maar er zijn goede redenen om de eigen cache te gebruiken, althans nu.
Alle bekende moderne besturingssystemen, inclusief MacOS, Windows, Linux en BSD, gebruiken een LRU (Least Recently Used) algoritme voor het implementeren van de paginacache. Dit is een primitief algoritme dat een gecachete blok 'omhoog in de rij' brengt na elke lezing en blokken 'omlaag in de rij' verdringt wanneer nodig om nieuwe cache-misses (blokken die van de schijf gelezen moesten worden en niet uit de cache) bovenaan toe te voegen.
Over het algemeen werkt het algoritme goed, maar in systemen met grote werklasten leidt LRU gemakkelijk tot thrashing - de verdringing van vaak benodigde blokken om ruimte vrij te maken voor blokken die nooit meer uit de cache gelezen zullen worden.
— een veel minder naïef algoritme dat kan worden beschouwd als een "gewichtige" cache. Na elke lezing van een gecached blok wordt het een beetje "zwaarder" en daardoor moeilijker om te verwijderen — en zelfs nadat het is verwijderd, blijft het blok wordt gevolgd gedurende een bepaalde tijd. Een blok dat is verwijderd, maar daarna terug in de cache moet worden gelezen, wordt ook "zwaarder".
Het uiteindelijke resultaat van dit alles is een cache met een veel hogere hitratio — de verhouding tussen hits in de cache (lezen, uitgevoerd uit de cache) en misses (lezen vanaf de schijf). Dit is een uiterst belangrijke statistiek - niet alleen worden cache-hits vele malen sneller bediend, maar ook cache-misses kunnen sneller worden bediend, omdat hoe meer cache-hits er zijn, hoe minder parallelle aanvragen naar de schijf en hoe minder vertraging voor de overgebleven misses die vanaf de schijf moeten worden bediend.
Conclusie
Na het bestuderen van de basissemantiek van ZFS — hoe schrijven met snapshots werkt, evenals de relaties tussen opslagpools, virtuele apparaten, blokken, sectoren en bestanden — zijn we klaar om over de werkelijke prestaties te praten met concrete cijfers.
In het volgende deel zullen we de daadwerkelijke prestaties van pools met mirror vdev en RAIDz met elkaar vergelijken, evenals met traditionele RAID-topologieën van de Linux-kernel die we hebben onderzocht. .
Aanvankelijk wilden we alleen de basisprincipes bekijken — de topologieën van ZFS zelf — maar daarna zoveel zijn we klaar om te spreken over meer geavanceerde configuratie en tuning van ZFS, inclusief het gebruik van auxiliaire vdev-typen, zoals L2ARC, SLOG en Special Allocation.
Bron: habr.com
