

SQL, wat kan er eenvoudiger zijn? Ieder van ons kan een eenvoudige query schrijven - we typen select, sommen de benodigde kolommen op, dan van, de naam van de tabel, een beetje voorwaarden in waar en dat is het - we hebben nuttige gegevens in onze handen, bijna (bijna) ongeacht welke DBMS er onder de motorkap draait (en misschien is het ook ). Hierdoor kan de interactie met bijna elke databasetoevoer (relationeel of niet) bekeken worden vanuit het perspectief van gewone code (met alle gevolgen van dien - version control, code review, statische analyse, autotests en al dat soort dingen). Dit betreft niet alleen de gegevens zelf, schema's en migraties, maar ook de algehele werking van het datacenter. In dit artikel bespreken we alledaagse taken en problemen bij het werken met verschillende databases onder de noemer "database as code".
We beginnen met . De eerste gevechten van het type "SQL vs ORM" werden al opgemerkt in .
Object-relationele mapping
Voorstanders van ORM waarderen traditioneel de snelheid en eenvoud van ontwikkeling, onafhankelijkheid van DBMS en de netheid van de code. Voor velen van ons ziet de code die met de database werkt (en vaak ook de database zelf)
er meestal ongeveer zo uit...
@Entity
@Table(name = "stock", catalog = "maindb", uniqueConstraints = {
        @UniqueConstraint(columnNames = "STOCK_NAME"),
        @UniqueConstraint(columnNames = "STOCK_CODE") })
public class Stock implements java.io.Serializable {

    @Id
    @GeneratedValue(strategy = IDENTITY)
    @Column(name = "STOCK_ID", unique = true, nullable = false)
    public Integer getStockId() {
        return this.stockId;
    }
  ...
Het model is uitgerust met slimme annotaties, terwijl ergens achter de schermen de dappere ORM tonnen aan SQL-code genereert en uitvoert. Trouwens, ontwikkelaars proberen met alle macht zich te omgeven met kilometers aan abstracties van hun database, wat wijst op een zekere .
Aan de andere kant van de barricade wijzen voorstanders van pure "handmade"-SQL op de mogelijkheid om het meeste uit hun DBMS te halen zonder extra lagen en abstracties. Dit resulteert in "data-centric" projecten, waar speciaal opgeleide mensen (de zogenaamde "database-experts", "db-admins", "db-specialisten" enz.) zich met de database bezighouden, terwijl ontwikkelaars alleen maar de kant-en-klare views en opgeslagen procedures hoeven aan te roepen, zonder in details te duiken.
Wat als we het beste van twee werelden combineren? Zoals gedaan in het geweldige hulpmiddel met de levensbevestigende naam . Ik zal een paar zinnen delen uit het algemene concept in mijn vrije vertaling, en je kunt er meer over leren. .
Clojure is een geweldige taal voor het creëren van DSL's, maar SQL is op zichzelf al een geweldige DSL en we hebben er niet nog een nodig. S-expressies zijn prachtig, maar voegen hier niets nieuws toe. Uiteindelijk krijgen we haakjes om de haakjes. Het er niet mee eens? Wacht dan tot het moment dat de abstractie boven de database begint te lekken en je een strijd met de functie begint. (raw-sql)
En wat te doen? Laten we SQL gewoon SQL laten blijven — één bestand voor één query:
-- naam: users-by-country
select *
  from users
 where country_code = :country_code
… en lees dat bestand vervolgens, en zet het om in een gewone Clojure-functie:
(defqueries "some/where/users_by_country.sql"
   {:connection db-spec})

;;; Een functie met de naam `users-by-country` is aangemaakt.
;;; Laten we het gebruiken:
(users-by-country {:country_code "GB"})
;=> ({:name "Kris" :country_code "GB" ...} ...)
Door je aan het principe 'SQL apart, Clojure apart' te houden, krijg je:
- Geen syntactische verrassingen. Je database (net als elke andere) volgt de SQL-standaard niet voor 100% — maar dat is voor Yesql niet belangrijk. Je hoeft nooit tijd te verspillen aan het jagen op functies met syntaxis die overeenkomt met SQL. Je hoeft nooit terug te keren naar de functie (raw-sql "some (‘funky’ :: SYNTAX)")).
- De beste ondersteuning voor de editor. Je editor heeft al geweldige ondersteuning voor SQL. Door SQL als SQL te houden, kun je het eenvoudig gebruiken.
- Teamcompatibiliteit. Jouw DBA's kunnen SQL lezen en schrijven die je gebruikt in je Clojure-project.
- Eenvoudigere prestatie-instellingen. Moet je een plan opstellen voor een probleemquery? Dat is geen probleem wanneer je query gewoon reguliere SQL is.
- Herbruikbaarheid van queries. Sleep dezelfde SQL-bestanden naar andere projecten, omdat het gewoon oude, vertrouwde SQL is — deel het gewoon.
Volgens mij is het idee heel gaaf en tegelijkertijd heel eenvoudig, waardoor het project talrijke op verschillende talen heeft. En we zullen verder proberen een soortgelijke filosofie toe te passen om SQL-code van de rest ver te scheiden, ver voorbij ORM.
IDE & DB-beheertools
Laten we beginnen met een eenvoudige dagelijkse taak. Vaak moeten we bepaalde objecten in de database zoeken, bijvoorbeeld een tabel in een schema vinden en de structuur ervan bestuderen (welke kolommen, sleutels, indexen, constraints, enzovoort, worden gebruikt). Van elke grafische IDE of zelfs een eenvoudige DB-manager verwachten we in de eerste plaats deze mogelijkheden. Het moet snel zijn, zodat we niet een half uur hoeven te wachten totdat het venster met de benodigde informatie verschijnt (vooral bij een trage verbinding met een externe database), en bovendien moet de verkregen informatie vers en actueel zijn, en niet verouderde gegevens uit de cache. Hoe complexer en groter de database is en hoe meer databases er zijn, hoe moeilijker dit te realiseren is.
Maar meestal gooi ik de muis aan de kant en schrijf gewoon code. Stel dat ik moet weten welke tabellen (en met welke eigenschappen) in het schema "HR" zijn. In de meeste databasesystemen kun je het gewenste resultaat bereiken met een eenvoudige query uit information_schema:
select table_name
     , ...
  from information_schema.tables
 where schema = 'HR'
De inhoud van dergelijke referentietabellen varieert van database naar database, afhankelijk van de mogelijkheden van elk databasesysteem. In MySQL kun je uit dezelfde referentietabel specifieke parameters voor dit databasesysteem krijgen:
select table_name
     , storage_engine -- De gebruikte "engine" ("MyISAM", "InnoDB" etc)
     , row_format     -- Rij-indeling ("Fixed", "Dynamic" etc)
     , ...
  from information_schema.tables
 where schema = 'HR'
Oracle heeft geen information_schema, maar het heeft , en er ontstaan geen grote problemen:
select table_name
     , pct_free       -- Minimum vrije ruimte in een datablok (%)
     , pct_used       -- Minimum gebruikte ruimte in een datablok (%)
     , last_analyzed  -- Datum van de laatste statistiekenverzameling
     , ...
  from all_tables
 where owner = 'HR'
ClickHouse vormt hierop geen uitzondering:
select name
     , engine -- De gebruikte "engine" ("MergeTree", "Dictionary" etc)
     , ...
  from system.tables
 where database = 'HR'
Een vergelijkbare aanpak is ook mogelijk in Cassandra (waar columnfamilies in plaats van tabellen en keyspaces in plaats van schema's bestaan):
select columnfamily_name
     , compaction_strategy_class  -- De strategie voor het opruimen van gegevens
     , gc_grace_seconds           -- De levensduur van afval
     , ...
  from system.schema_columnfamilies
 where keyspace_name = 'HR'
Voor de meeste andere databases kunnen ook soortgelijke queries worden bedacht (zelfs in Mongo is er , die informatie bevat over alle collecties in het systeem).
Natuurlijk kun je op deze manier informatie krijgen, niet alleen over tabellen, maar over elk object. Regelmatig delen goede mensen dergelijke code voor verschillende databases, zoals in de serie Habr-artikelen "Functies voor het documenteren van PostgreSQL-databases" (, , ). Uiteraard is het niet zo leuk om al die aanvragen in je hoofd te houden en ze steeds in te voeren, daarom heb ik in mijn favoriete IDE/editor een vooraf samengestelde set snippets voor vaak gebruikte queries, en hoef ik alleen maar de objectnamen in het sjabloon in te voeren.
Uiteindelijk is deze manier van navigeren en het zoeken naar objecten veel flexibeler, bespaart het veel tijd en geeft het precies die informatie in de vorm die op dat moment nodig is (zoals beschreven in de post ).
Bewerkingen met objecten
Nadat we de benodigde objecten hebben gevonden en bestudeerd, is het tijd om iets nuttigs met ze te doen. Natuurlijk zonder de vingers van het toetsenbord te halen.
Het is geen geheim dat het eenvoudig verwijderen van een tabel er in bijna alle databases hetzelfde uitziet:
drop table hr.personsMaar het creëren van een tabel is al interessanter. Vrijwel elke database (inclusief veel NoSQL-databases) kan in enige vorm "create table" aan, en het grootste deel zal nauwelijks verschillen (naam, lijst met kolommen, datatypes), maar de andere details kunnen sterk verschillen en hangen af van de interne structuur en mogelijkheden van de specifieke database. Mijn favoriete voorbeeld — in de documentatie van Oracle nemen alleen de "blote" BNF's voor de syntaxis "create table" . Andere databases hebben meer bescheiden mogelijkheden, maar elke database heeft ook veel interessante en unieke functies voor het creëren van tabellen (, , , ). Het is onwaarschijnlijk dat een grafische "wizard" uit een willekeurige IDE (vooral een algemene) al deze mogelijkheden volledig kan dekken, en als het dat kan, zal het een spectacle zijn dat niet voor de zwakken van hart is. Tegelijkertijd stelt een goed en tijdig geschreven operator create table je in staat om zonder moeite van al deze functies gebruik te maken, en om de opslag en toegang tot je gegevens betrouwbaar, optimaal en zo aangenaam mogelijk te maken.
Ook hebben veel databasespecifieke databasetypen die in andere databases ontbreken. We kunnen namelijk niet alleen bewerkingen uitvoeren op database-objecten, maar ook op de database zelf, zoals het "killen" van een proces, geheugen vrijmaken, tracing inschakelen, overschakelen naar de "alleen-lezen" modus en nog veel meer.
Laten we nu even wat tekenen.
Een van de meest voorkomende taken is het bouwen van een diagram met database-objecten, zodat we op een mooie afbeelding de objecten en de relaties ertussen kunnen zien. Dit kan vrijwel elke grafische IDE, aparte command-line tools, gespecialiseerde grafische tools en modelleringstoepassingen. Zij kunnen iets tekenen "zoals zij het kunnen", en invloed uitoefenen op dit proces kan vaak alleen via enkele parameters in het configuratiebestand of vinkjes in de interface.
Maar deze kwestie kan veel eenvoudiger, flexibeler en eleganter worden opgelost, natuurlijk met code. Voor het maken van diagrammen van elke complexiteit hebben we meteen verschillende gespecialiseerde opmaaktalen (DOT, GraphML, enz.), en daarnaast een hele reeks applicaties (GraphViz, PlantUML, Mermaid) die deze instructies kunnen lezen en visualiseren in de meest diverse formaten. En we weten al hoe we informatie over de objecten en de verbanden daartussen kunnen verkrijgen.
Laten we een klein voorbeeld geven van hoe dit eruit zou kunnen zien, met gebruik van PlantUML en (links de SQL-query die de benodigde instructie voor PlantUML genereert, en rechts het resultaat):
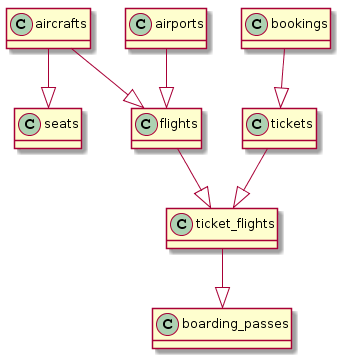
select '@startuml'||chr(10)||'hide methods'||chr(10)||'hide stereotypes' union all
select distinct ccu.table_name || ' --|> ' ||
       tc.table_name as val
  from table_constraints as tc
  join key_column_usage as kcu
    on tc.constraint_name = kcu.constraint_name
  join constraint_column_usage as ccu
    on ccu.constraint_name = tc.constraint_name
 where tc.constraint_type = 'FOREIGN KEY'
   and tc.table_name ~ '.*' union all
select '@enduml'
En als je een beetje moeite doet, kun je op basis van iets heel nauwkeurigs krijgen dat lijkt op een echte ER-diagram:
Een SQL-query die een beetje ingewikkelder is.
-- Koptekst
select '@startuml
!define Table(name,desc) class name as "desc" << (T,#FFAAAA) >>
!define primary_key(x) <b>x</b>
!define unique(x) <color:green>x</color>
!define not_null(x) <u>x</u>
verberg methoden
verberg stereotypen'
union all
-- Tabellen
select format('Table(%s, "%s n informatie over %s") {'||chr(10), table_name, table_name, table_name) ||
(select string_agg(column_name || ' ' || upper(udt_name), chr(10))
from information_schema.columns
where table_schema = 'public'
and table_name = t.table_name) || chr(10) || '}'
from information_schema.tables t
where table_schema = 'public'
union all
-- Relaties tussen tabellen
select distinct ccu.table_name || ' "1" --> "0..N" ' || tc.table_name || format(' : "Een %s kan veel %s hebben"', ccu.table_name, tc.table_name)
from information_schema.table_constraints as tc
join information_schema.key_column_usage as kcu on tc.constraint_name = kcu.constraint_name
join information_schema.constraint_column_usage as ccu on ccu.constraint_name = tc.constraint_name
where tc.constraint_type = 'FOREIGN KEY'
and ccu.constraint_schema = 'public'
and tc.table_name ~ '.*'
union all
-- Voettekst
select '@enduml' 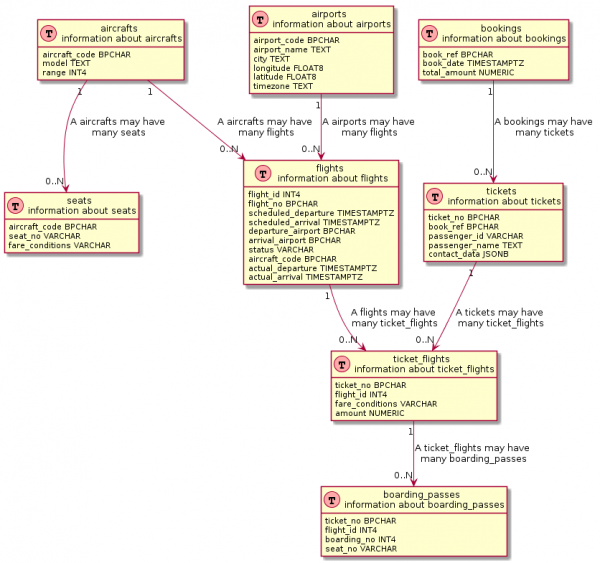
Als je goed kijkt, dan gebruiken veel visualisatie-instrumenten onderhuids ook vergelijkbare queries. Het zijn echter vaak queries die diep "verankerd" zijn in de code van de applicatie en moeilijk te begrijpen zijn. Statistieken en monitoring.
Meten en bewaking.
Laten we het hebben over een traditioneel moeilijk onderwerp: databaseprestat Monitoring. Laat me een klein waar verhaal delen dat "een vriend van mij" me vertelde. Bij een van de projecten was er een machtige DBA, en weinig ontwikkelaars waren persoonlijk met hem bekend of hadden hem ooit in het echt gezien (ondanks het feit dat hij, naar verluidt, ergens in het naastgelegen gebouw werkte). Op het moment suprême, wanneer het productie-systeem van een grote retailer weer eens "niet lekker in zijn vel zat", stuurde hij stilletjes screenshots van grafieken uit Oracle Enterprise Manager, waarop hij de kritieke punten met een rode marker omcirkelde voor de "duidelijkheid" (dit hielp, zacht gezegd, nauwelijks). En zo moest men deze "foto" gebruiken om de problemen op te lossen. Verder had niemand toegang tot de kostbare (in beide betekenissen van het woord) Enterprise Manager, omdat het systeem complex en duur was, en men dacht: "wat als de ontwikkelaars per ongeluk iets breken". Hierdoor vonden ontwikkelaars op empirische wijze de locaties en oorzaken van de vertragingen en brachten ze patches uit. Als er in de nabije toekomst geen dreigend bericht van de DBA terugkwam, ademden ze opgelucht en keerden terug naar hun lopende taken (tot het volgende briefje).
Maar het monitoringproces kan er veel vrolijker en vriendelijker uitzien, en belangrijker nog — toegankelijk en transparant voor iedereen. Tenminste het basisgedeelte, als aanvulling op de belangrijkste monitoringsystemen (die zeker nuttig zijn en in veel gevallen onmisbaar). Elke DBMS is vrij en volledig gratis bereid om informatie over zijn huidige toestand en prestaties te delen. In dezelfde "bloederige" Oracle DB is vrijwel alle informatie over de prestaties te verkrijgen uit systeemweergaven, te beginnen bij processen en sessies tot de status van de buffer cache (bijvoorbeeld, , het gedeelte "Monitoring"). In PostgreSQL zijn er ook tal van systeemweergaven voor , met name van onschatbare waarde in het dagelijks leven van elke DBA, zoals , , . In MySQL is er zelfs een aparte schema bedoeld voor . En in Mongo is er een ingebouwde die prestatiegegevens in een systeemcollectie aggregeert .
Dus, gewapend met een of andere metric aggregator (Telegraf, Metricbeat, Collectd), die aangepaste sql-queries kan uitvoeren, een opslag voor deze metrics (InfluxDB, Elasticsearch, Timescaledb) en een visualisatietool (Grafana, Kibana), kan men een vrij eenvoudige en flexibele monitoring systeem opzetten dat nauw geïntegreerd is met andere algemene systeem metrics (verkregen bijvoorbeeld van de applicatieserver, van het besturingssysteem, enz.). Zoals dat is gedaan in pgwatch2, waar de combinatie InfluxDB + Grafana en een set queries naar systeemschema's wordt gebruikt, waar ook aangepaste queries aan toegevoegd kunnen worden. .
Total
En dit is slechts een voorlopige lijst van wat je met onze database kunt doen via gewone SQL-code. Ik ben er zeker van dat er nog veel meer toepassingen zijn, laat het ons alsjeblieft weten in de reacties. En over hoe (en vooral waarom) we dit allemaal kunnen automatiseren en opnemen in onze CI/CD-pipeline, daar praten we de volgende keer over.
Bron: habr.com
