

Kubernetes is een fantastisch hulpmiddel voor het draaien van Docker-containers in een geclusterde productieomgeving. Er zijn echter taken die Kubernetes niet kan oplossen. Bij veelvuldige implementatie in de live omgeving hebben we een volledig geautomatiseerde Blue/Green deployment nodig om downtime in dit proces te voorkomen, waarbij ook externe HTTP-verzoeken moeten worden verwerkt en SSL moet worden afgehandeld. Dit vereist integratie met een load balancer zoals ha-proxy. Een andere uitdaging is het semi-geautomatiseerd schalen van het Kubernetes-cluster tijdens het werken in de cloud, bijvoorbeeld het gedeeltelijk afschalen van het cluster 's nachts.
Hoewel Kubernetes deze functies niet recht uit de doos biedt, geeft het wel een API die kan worden gebruikt om dergelijke taken aan te pakken. Tools voor geautomatiseerde Blue/Green deployment en schaalvergroting van een Kubernetes-cluster zijn ontwikkeld binnen het Cloud RTI-project, dat op open-source is gebaseerd.
In dit artikel, een video-uitleg, wordt beschreven hoe Kubernetes samen met andere open-source componenten kan worden ingesteld voor een productieklare omgeving die zonder downtime in de productie code uit een git commit accepteert.
Dus, nadat u toegang heeft gekregen tot uw applicaties vanuit de externe wereld, kunt u beginnen met de volledige automatisering, dat wil zeggen, het brengen naar een niveau waarop u een git commit kunt uitvoeren en kunt bevestigen dat deze git commit eindigt in de productie. Het is vanzelfsprekend dat we tijdens het uitvoeren van deze stappen en bij het implementeren geen downtime willen ervaren. Dus elke automatisering in Kubernetes begint met de API.
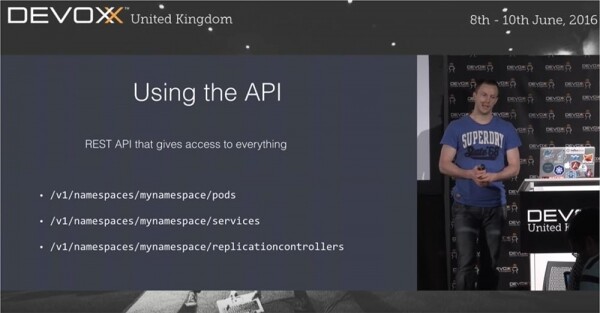
Kubernetes is niet het soort hulpmiddel dat direct productief kan worden gebruikt 'recht uit de doos'. Natuurlijk kunt u het zo doen, kubectl gebruiken, enzovoort, maar de API is toch het meest interessante en nuttige kenmerk van dit platform. Door de API als een set functies te gebruiken, heeft u toegang tot vrijwel alles wat u in Kubernetes wilt doen. Kubectl zelf maakt ook gebruik van de REST API.
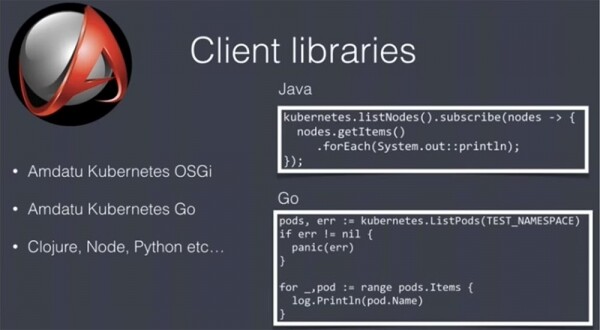
Dit is REST, dus je kunt elke taal en tool gebruiken om met deze API te werken, maar gebruikersbibliotheken maken je leven aanzienlijk gemakkelijker. Mijn team heeft 2 van zulke bibliotheken geschreven: één voor Java / OSGi en één voor Go. De tweede wordt niet vaak gebruikt, maar je hebt in ieder geval deze nuttige tools tot je beschikking. Ze vormen een gedeeltelijk gelicentieerd open-source project. Er zijn veel van zulke bibliotheken voor verschillende talen, zodat je de meest geschikte kunt kiezen.
Nou, voordat je begint met het automatiseren van de implementatie, is het belangrijk om ervoor te zorgen dat dit proces niet aan enige downtime onderhevig zal zijn. Bijvoorbeeld, ons team voert productie-implementaties uit halverwege de dag, wanneer mensen de applicaties het meest gebruiken, dus het is erg belangrijk om vertragingen in dit proces te vermijden. Om downtime te voorkomen, worden er 2 methoden gebruikt: blue/green deployment of rolling update. In het laatste geval, als je 5 replica's van de applicatie hebt draaien, worden ze één voor één geüpdatet. Deze methode werkt uitstekend, maar is niet geschikt als je tijdens de implementatie verschillende versies van de applicatie tegelijkertijd draait. In dat geval kun je de gebruikersinterface updaten terwijl de backend met de oude versie blijft werken, en zal de werking van de applicatie stoppen. Daarom is het programmeren onder zulke omstandigheden behoorlijk uitdagend.
Dit is een van de redenen waarom we de voorkeur geven aan blue/green deployment voor het automatiseren van de implementatie van onze applicaties. Bij deze methode moet je ervoor zorgen dat op een bepaald moment slechts één versie van de applicatie actief is.
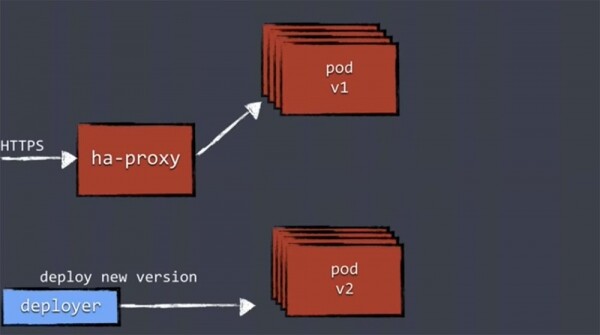
Het mechanisme van blue/green deployment werkt als volgt. We ontvangen het verkeer voor onze applicaties via ha-proxy, dat het doorstuurt naar de actieve replica's van de applicatie van dezelfde versie.
Bij een nieuwe uitrol gebruiken we Deployer, die nieuwe componenten ontvangt en de nieuwe versie uitrolt. Het uitrollen van een nieuwe versie van de applicatie betekent dat er een nieuwe set replica's 'opgestart' wordt, waarna deze replica's van de nieuwe versie in een aparte, nieuwe pod worden gestart. De ha-proxy weet echter niets van deze replica's en stuurt voorlopig geen werklast naar hen.
Daarom is het in de eerste plaats noodzakelijk om de werkzaamheid van de nieuwe versies te controleren met health checking, om te zorgen dat de replica's klaar zijn om werklast te verwerken.
Alle uitrolcomponenten moeten een vorm van health check ondersteunen. Dit kan een simpele HTTP-controle zijn, waarbij je een statuscode van 200 ontvangt, of een diepere controle waarbij je de verbinding van de replica's met de database en andere services controleert, de stabiliteit van de verbindingen in de dynamische omgeving, en of alles correct opstart en functioneert. Dit proces kan behoorlijk complex zijn.
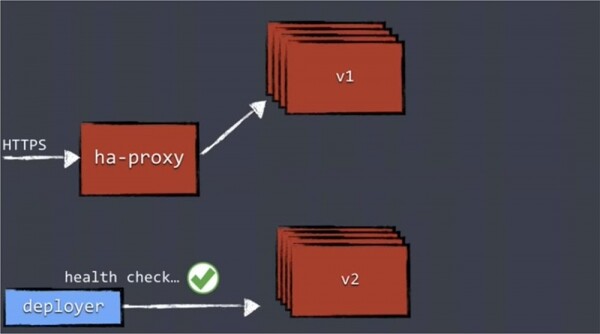
Nadat het systeem heeft bevestigd dat alle bijgewerkte replica's werken, zal Deployer de configuratie bijwerken en de juiste confd doorgeven, die de ha-proxy opnieuw configureert.
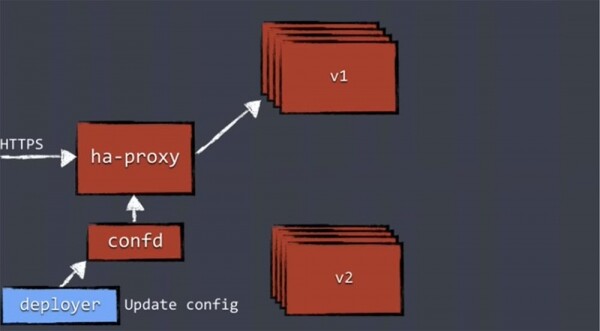
Pas daarna zal het verkeer naar de pod met de replica's van de nieuwe versie worden geleid, en verdwijnt de oude pod.
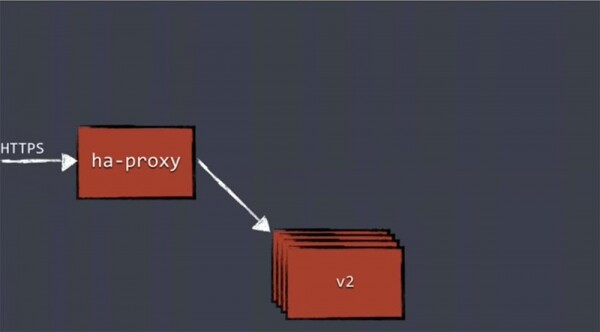
Dit mechanisme is geen kenmerk van Kubernetes. Het concept van Blue/green deployment bestaat al een geruime tijd en maakt altijd gebruik van een load balancer. Eerst stuur je al het verkeer naar de oude versie van de applicatie, en na de update schakel je volledig over naar de nieuwe versie. Dit principe wordt niet alleen in Kubernetes gebruikt.
Ik zal u nu een nieuwe uitrolcomponent presenteren – Deployer, die de werkzaamheid controleert, de proxy opnieuw configureert, enzovoort. Dit is een concept dat niet betrekking heeft op de externe wereld en binnen Kubernetes bestaat. Ik zal laten zien hoe je je eigen Deployer-concept kunt creëren met behulp van open-source tools.
Het eerste dat Deployer doet, is een replicatiecontroller (RC) maken met behulp van de Kubernetes API. Deze API creëert pods en services voor de verdere implementatie, dat wil zeggen, het creëert een volledig nieuwe cluster voor onze applicaties. Zodra de RC zich ervan heeft verzekerd dat de replica's zijn opgestart, voert hij een gezondheidscheck uit. Hiervoor gebruikt Deployer het commando GET /health. Dit start de bijbehorende controlecomponenten en controleert alle elementen die de werking van de cluster waarborgen.
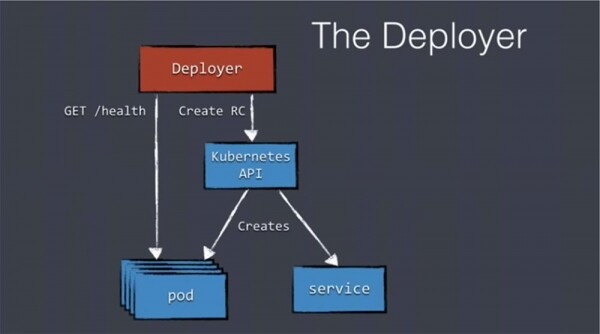
Nadat alle pods hebben gerapporteerd dat ze 'gezond' zijn, creëert Deployer een nieuw configuratie-element – een gedistribueerde opslag etcd, die binnen Kubernetes wordt gebruikt, onder andere voor het opslaan van de configuratie van de load balancer. We schrijven gegevens naar etcd, en een klein hulpmiddel genaamd confd houdt etcd in de gaten voor nieuwe gegevens.
Als het veranderingen in de oorspronkelijke configuratie heeft gedetecteerd, genereert het een nieuw configuratiebestand en geeft dit door aan ha-proxy. In dit geval wordt ha-proxy herstart zonder dat er verbindingen verloren gaan en wordt de belasting verdeeld over de nieuwe services die de werking van de nieuwe versie van onze applicaties waarborgen.
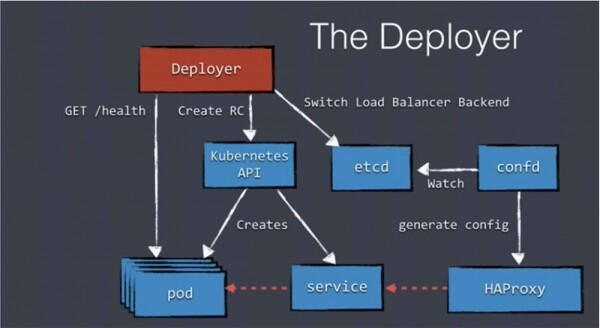
Zoals u kunt zien, is er ondanks het aantal componenten niets ingewikkelds aan. U hoeft alleen maar meer aandacht te besteden aan de API en etcd. Ik wil u vertellen over de open-source deployer die we zelf gebruiken – Amdatu Kubernetes Deployer.
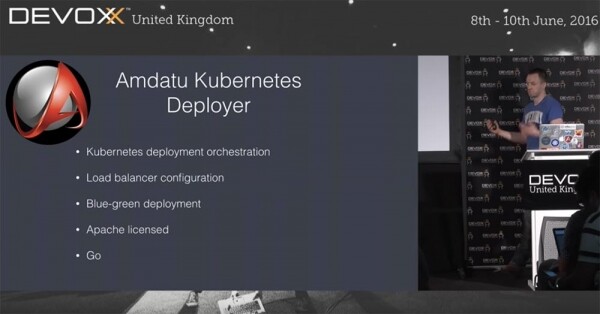
Dit is een tool voor het orkestreren van Kubernetes-implementaties met de volgende functies:
- Blue/Green deployment;
- instelling van een externe load balancer;
- beheer van deployment descriptors;
- beheer van de daadwerkelijke implementatie;
- gezondheidscontroles tijdens de implementatie;
- injectie van omgevingsvariabelen in pods.
Deze Deployer is gebouwd bovenop de Kubernetes API en biedt een REST API voor het beheren van descriptors en implementaties, evenals een Websocket API voor streaming logs tijdens de implementatie.
Het plaatst de configuratiegegevens van de load balancer in etcd, waardoor u geen ha-proxy met 'out of the box'-ondersteuning hoeft te gebruiken, maar gemakkelijk uw eigen configuratiebestand voor de load balancer kunt gebruiken. Amdatu Deployer is geschreven in Go, net als Kubernetes zelf, en is gelicenseerd onder Apache.
Voordat ik deze versie van de deployer begon te gebruiken, maakte ik gebruik van de volgende deploymentdescriptor waarin de parameters zijn vermeld die ik nodig heb.
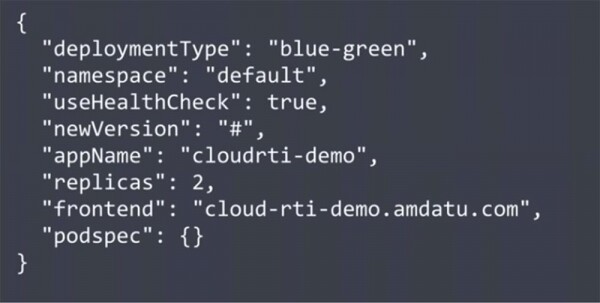
Een van de belangrijke parameters van deze code is het inschakelen van de 'useHealthCheck' vlag. We moeten aangeven dat tijdens de implementatie een gezondheidscontrole moet worden uitgevoerd. Deze parameter kan worden uitgeschakeld wanneer er containers van derden worden gebruikt die niet hoeven te worden gecontroleerd. In deze descriptor is ook het aantal replicas en de URL van de frontend vermeld die nodig is voor ha-proxy. Aan het einde is de podspec-specificatie vlag genoemd die Kubernetes aanspreekt voor informatie over poortconfiguraties, afbeeldingen, enz. Dit is een vrij eenvoudige descriptor in JSON-formaat.
Een andere tool die deel uitmaakt van het open-source project Amdatu is Deploymentctl. Het heeft een gebruikersinterface (UI) voor het configureren van implementaties, slaat de geschiedenis van implementaties op en bevat webhooks voor terugroepacties door derden en ontwikkelaars. U kunt de UI misschien niet gebruiken, omdat de Amdatu Deployer zelf een REST API is, maar deze interface kan het implementeren zonder gebruik te maken van een API veel gemakkelijker maken. Deploymentctl is geschreven in OSGi/Vertx met Angular 2.
Nu ga ik het bovenstaande demonstreren op het scherm met een vooraf gemaakte opname, zodat u niet hoeft te wachten. We gaan een eenvoudige applicatie implementeren in Go. Maak u geen zorgen als u nog niet met Go heeft gewerkt, dit is een zeer eenvoudige applicatie, dus het zou u allemaal duidelijk moeten zijn.
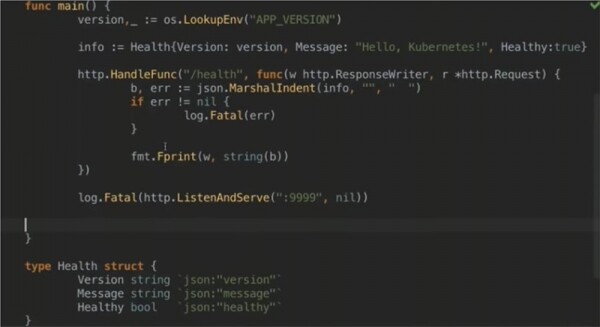
Hier creëren we een HTTP-server die alleen reageert op /health, zodat deze applicatie alleen de gezondheidscontrole controleert en niets meer. Als de controle slaagt, wordt de hieronder weergegeven JSON-structuur gebruikt. Deze bevat de versie van de applicatie die door de deployer zal worden geïmplementeerd, het bericht dat u bovenaan het bestand ziet, en een booleaanse datatype — of onze applicatie operationeel is of niet.
Met de laatste regel heb ik een beetje gefraudeerd, omdat ik bovenaan het bestand een vaste booleaanse waarde heb geplaatst, die me later zal helpen om zelfs een 'ongeschikte' applicatie te implementeren. Later zullen we dit bespreken.
Laten we beginnen. Eerst controleren we of er actieve pods zijn met het commando ~ kubectl get pods en aan de afwezigheid van een antwoord van de frontend-URL2 zien we dat er momenteel geen implementaties plaatsvinden.
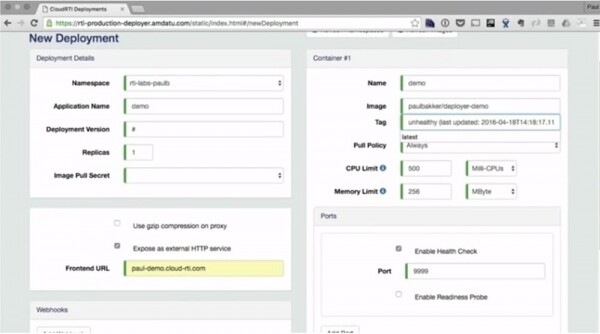
Vervolgens ziet u op het scherm de interface Deploymentctl die ik eerder noemde, waar de implementatieparameters worden ingesteld: namespace, applicatienaam, implementatieversie, aantal replica's, frontend-URL, containernaam, afbeelding, resource-limieten, poortnummer voor health check, enzovoorts. Resource-limieten zijn zeer belangrijk, omdat ze het maximale aantal middelen mogelijk maken. Hier kunt u ook het implementatiedagboek bekijken, Deployment log.
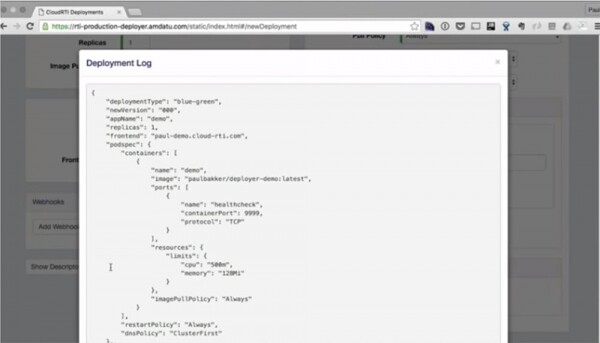
Als we nu het commando ~ kubectl get pods herhalen, is te zien dat het systeem 20 seconden 'bevriest', waarin de herconfiguratie van ha-proxy plaatsvindt. Na deze tijd wordt de pod gestart en kunnen we onze replica in het implementatielog zien.
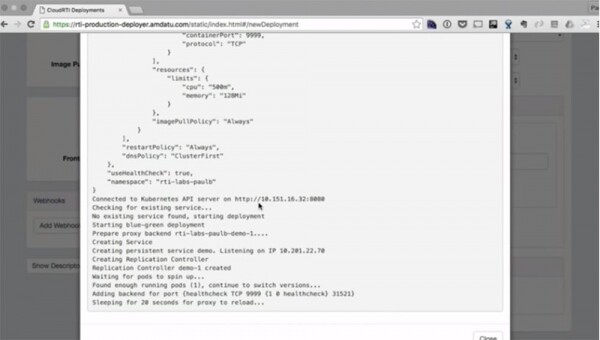
Ik heb de 20 seconden wachttijd uit de video geknipt en nu ziet u op het scherm dat de eerste versie van de applicatie is geïmplementeerd. Dit alles is gedaan met behulp van de UI.
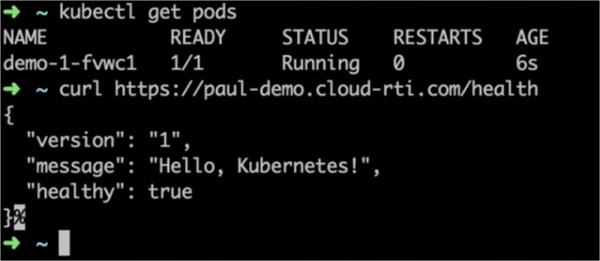
Laten we nu proberen de tweede versie. Hiervoor wijzig ik de message van de applicatie van 'Hello, Kubernetes!' naar 'Hello, Deployer!', het systeem maakt deze afbeelding aan en plaatst deze in de Docker-register, waarna we eenvoudig nogmaals op de knop 'Deploy' in het venster Deploymentctl klikken. Hierbij wordt automatisch het implementatiedagboek gestart, net zoals bij de implementatie van de eerste versie van de applicatie.
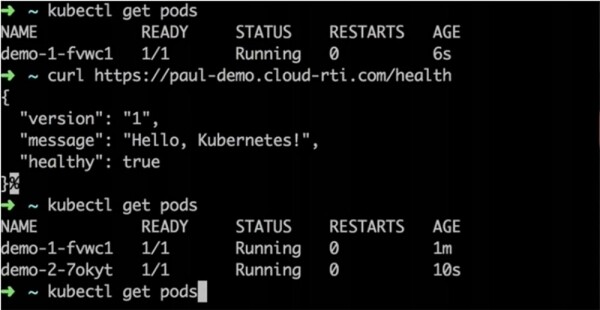
Het commando ~ kubectl get pods toont dat er momenteel 2 versies van de applicatie worden uitgevoerd, maar de frontend geeft aan dat we nog steeds versie 1 hebben draaien.
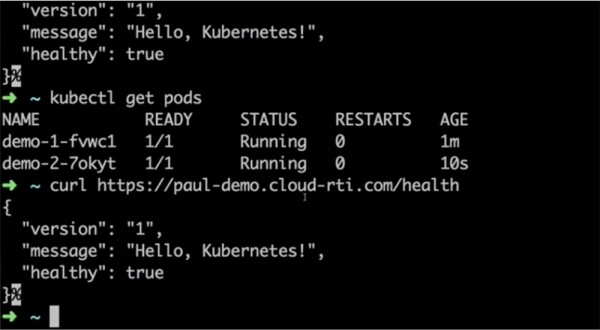
De load balancer wacht tot er een health check is uitgevoerd, waarna deze het verkeer naar de nieuwe versie omleidt. Na 20 seconden schakelen we over naar curl en zien we dat nu versie 2 van de applicatie is geïmplementeerd, en versie 1 is verwijderd.
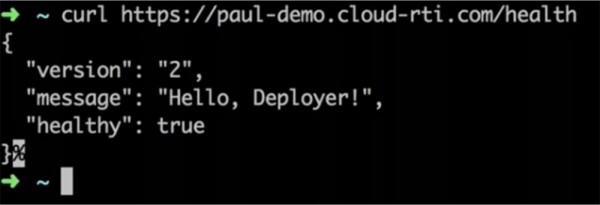
Dit was de implementatie van een 'gezonde' applicatie. Laten we eens kijken wat er gebeurt als ik de waarde van de parameter Healthy voor de nieuwe versie van de applicatie verander van true naar false, dat is, als ik probeer een ongezonde applicatie te implementeren die de functionaliteitscheck niet doorstaat. Dit kan gebeuren als er in de ontwikkelingsfase fouten in de configuratie van de applicatie zijn gemaakt en deze in deze staat naar productie is gestuurd.
Zoals u kunt zien, doorloopt de implementatie alle bovenstaande stappen, en ~ kubectl get pods toont aan dat beide pods draaien. Maar in tegenstelling tot de vorige implementatie, laat het logboek een timeout-status zien. Dat betekent dat de nieuwe versie van de applicatie niet kan worden geïmplementeerd omdat de health check is mislukt. Als resultaat ziet u dat het systeem terugkeert naar de oude versie van de applicatie, terwijl de nieuwe versie gewoon is verwijderd.
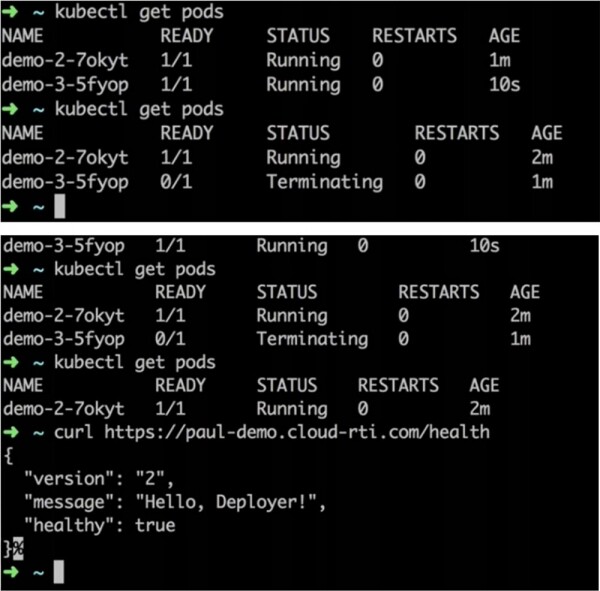
Het goede is dat zelfs als u een enorme hoeveelheid gelijktijdige aanvragen naar de applicatie heeft, ze de downtime tijdens de implementatieprocedure niet eens zullen opmerken. Als u deze applicatie test met het Gatling-framework, dat het maximale aantal aanvragen naar de applicatie stuurt, zullen geen van deze aanvragen worden afgewezen. Dit betekent dat onze gebruikers de versie-updates in realtime niet eens zullen merken. Als het mislukt, blijft de oude versie draaien; als het succesvol is, gaan de gebruikers over op de nieuwe versie.
Er is slechts één ding dat kan leiden tot een mislukking – als de health check succesvol is, maar de applicatie faalt zodra deze onder een belasting komt, dat wil zeggen dat de crash pas na de implementatie zal optreden. In dit geval moet u handmatig terugschakelen naar de oude versie. Dus, we hebben bekeken hoe je Kubernetes kunt gebruiken met de ervoor bestemde open-source tools. De implementatieprocedure zal veel eenvoudiger verlopen als u deze tools opneemt in de build/deploy pipelines. U kunt zowel de gebruikersinterface gebruiken voor de implementatie als het proces volledig automatiseren door bijvoorbeeld commit naar master toe te passen.
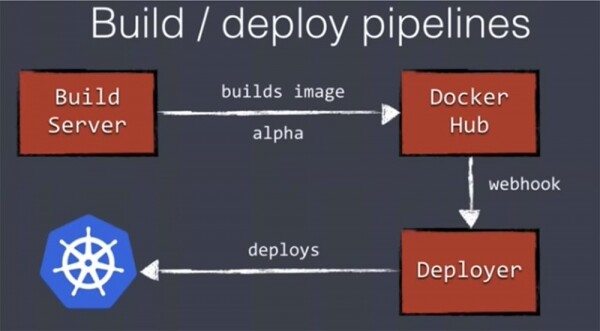
Onze Build Server maakt een Docker-image aan en plaatst deze in Docker Hub of elke andere registry die u gebruikt. Docker Hub ondersteunt webhook, waardoor we een externe implementatie kunnen starten via Deployer zoals hierboven getoond. Op deze manier kan de implementatie van de applicatie naar de potentiële productie volledig worden geautomatiseerd.
Laten we overgaan tot het volgende onderwerp: het schalen van een Kubernetes-cluster. Ik wil erop wijzen dat het kubectl-commando een schalingsopdracht is. Hiermee kunt u eenvoudig het aantal replica's in ons bestaande cluster verhogen. In de praktijk willen we echter meestal het aantal niet Pods, maar Nodes verhogen.
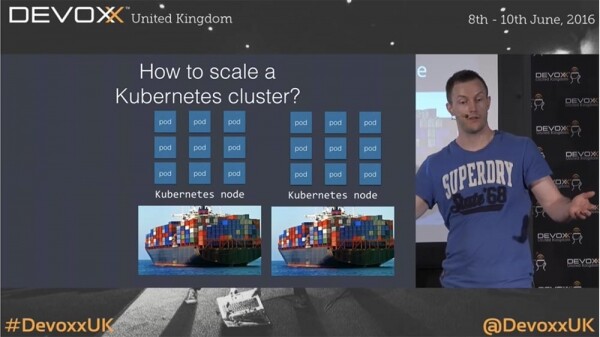
Tijdens werktijden kan het nodig zijn om schaalvergroting toe te passen, terwijl u 's nachts, om de kosten van de Amazon-diensten te verlagen, het aantal actieve exemplaren van de applicatie moet verminderen. Dit betekent niet dat het voldoende is om alleen het aantal Pods te schalen, want zelfs als een van de Nodes niet in gebruik is, moet u er nog steeds voor betalen aan Amazon. Dat wil zeggen, naast het schalen van Pods, moet u ook het aantal gebruikte machines schalen.
Dit kan complicaties met zich meebrengen, omdat Kubernetes, ongeacht of we Amazon of een andere cloudservice gebruiken, niets weet over het aantal gebruikte machines. Het mist een instrument om het systeem op het niveau van Nodes te schalen.
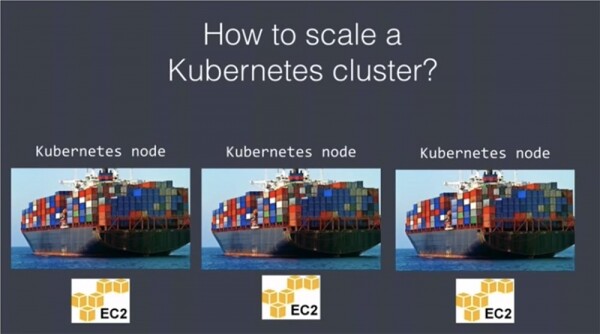
Dus we moeten zowel voor de Nodes als de Pods zorgen. We kunnen de implementatie van nieuwe Nodes eenvoudig schalen met behulp van de AWS API en de Auto Scaling-groep voor het instellen van het aantal werkende Kubernetes-werkknopen. Ook kan cloud-init of een soortgelijke script worden gebruikt om Nodes aan te melden in het Kubernetes-cluster.
Een nieuwe machine start in de Scaling-groep, initieert zichzelf als een node, schrijft zich in het masterregister en begint met werken. Hierna kan het aantal replicaties worden verhoogd voor gebruik op de gevormde nodes. Het verkleinen van de schaal vereist meer moeite, omdat ervoor gezorgd moet worden dat deze stap niet leidt tot het vernietigen van al draaiende applicaties na het uitschakelen van 'onnodige' machines. Om een dergelijk scenario te voorkomen, moeten de nodes in de status 'unschedulable' worden gebracht. Dit betekent dat de standaard scheduler bij het plannen van DaemonSet-pods deze nodes zal negeren. De scheduler zal niets verwijderen van deze servers, maar er zullen ook geen nieuwe containers worden gestart. De volgende stap is het afdrijven van de node, namelijk het verplaatsen van draaiende pods naar een andere machine of andere nodes die hierover voldoende capaciteit beschikken. Zodra er op deze nodes geen containers meer zijn, kunnen ze uit Kubernetes worden verwijderd. Hierna zullen ze simpelweg niet meer bestaan voor Kubernetes. Vervolgens moet de AWS API worden gebruikt om de onnodige nodes of machines uit te schakelen.
U kunt Amdatu Scalerd gebruiken - een ander open-source hulpmiddel voor schaalvergroting, vergelijkbaar met de AWS API. Het biedt een CLI voor het toevoegen of verwijderen van nodes in de cluster. Een interessante functie is de mogelijkheid om de scheduler in te stellen met behulp van het volgende json-bestand.
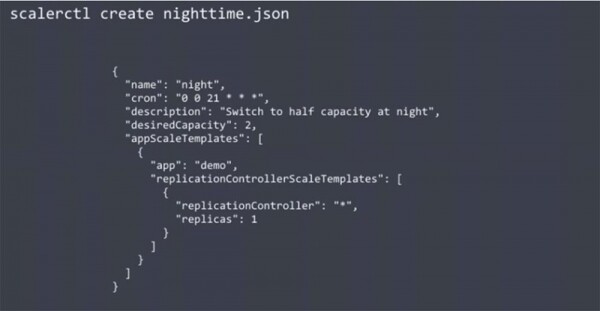
De weergegeven code vermindert de capaciteit van de cluster met de helft tijdens de nacht. Hierin is zowel het aantal bestaande replicaties als de gewenste capaciteit van de Amazon-cluster ingesteld. Het gebruik van deze scheduler zal automatisch het aantal nodes 's nachts verminderen en 's ochtends verhogen, waardoor het gebruik van nodes in een cloudservice zoals Amazon kan worden bespaard. Deze functie is niet ingebouwd in Kubernetes, maar het gebruik van Scalerd stelt u in staat om dit platform op elke gewenste manier te schalen.
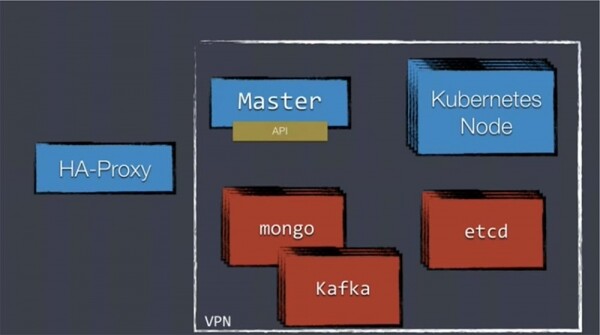
Ik wil uw aandacht vestigen op het feit dat veel mensen tegen me zeggen: "Dit is allemaal goed, maar hoe zit het met mijn database, die meestal in een statische toestand verkeert?" Hoe kun je zoiets opzetten in een dynamische omgeving zoals Kubernetes? Naar mijn mening moet je dit niet doen; je moet niet proberen om een databasemanagementsysteem in Kubernetes te organiseren. Technisch gezien is het mogelijk, en er zijn handleidingen op internet, maar het zal je leven aanzienlijk compliceren.
Ja, in Kubernetes bestaat het concept van persistente opslag, en je kunt proberen om databasemanagementsystemen zoals Mongo of MySQL te draaien, maar het is een behoorlijk arbeidsintensievelijke taak. Dit komt omdat databasemanagementsystemen niet volledig zijn afgestemd op dynamische omgevingen. De meeste databases vereisen aanzienlijke configuratie, waaronder handmatige clusterconfiguratie, en zij houden niet van autoscaling en andere vergelijkbare zaken.
Het is dus niet de moeite waard om je leven te compliceren door een databasemanagementsysteem in Kubernetes op te zetten. Organiseer hun werking op de traditionele manier met gebruik van bekende services en geef Kubernetes gewoon de mogelijkheid om ze te gebruiken.
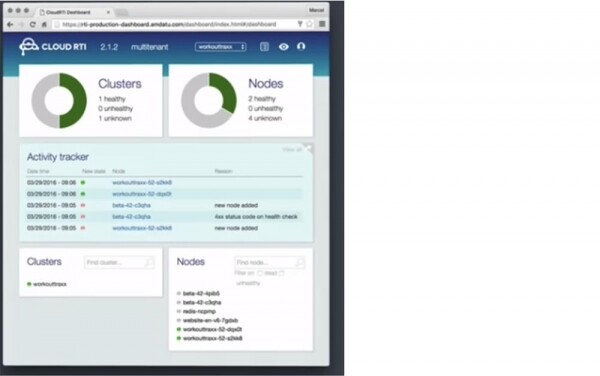
Tot slot wil ik u kennis laten maken met het Cloud RTI-platform op basis van Kubernetes, waar mijn team aan werkt. Het biedt gecentraliseerd logbeheer, monitoring van applicaties en clusters, en heeft tal van andere nuttige functies die van pas zullen komen. Het maakt gebruik van verschillende open-source tools, zoals Grafana voor monitorweergave.
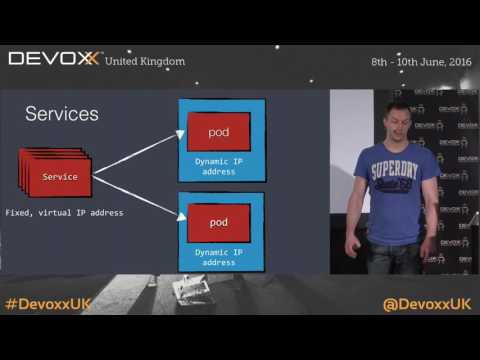
Er werd een vraag gesteld waarom je een load balancer ha-proxy met Kubernetes zou gebruiken. Een goede vraag, want momenteel zijn er 2 niveaus van load balancing. Kubernetes-services draaien nog steeds op virtuele IP-adressen. Je kunt ze niet gebruiken voor de poorten van externe hostmachines, omdat als Amazon zijn cloudhost overbelast, het adres verandert. Daarom plaatsen we ha-proxy voor de services — om een meer statische structuur te creëren voor ononderbroken verkeersinteractie met Kubernetes.
Een andere goede vraag is hoe je kunt omgaan met het wijzigen van het databaseschema tijdens blue/green deployment? Het feit is dat, ongeacht het gebruik van Kubernetes, het wijzigen van een databaseschema een complexe taak is. Je moet zorgen voor compatibiliteit tussen het oude en het nieuwe schema, waarna je de database kunt bijwerken en vervolgens de applicaties kunt bijwerken. Je kunt een 'hot swapping' van de database uitvoeren, en dan de applicaties bijwerken. Ik ken mensen die een volledig nieuwe databasecluster met een nieuw schema hebben geladen; dit is een optie als je een schemaloze database zoals Mongo hebt, maar hoe dan ook is het geen eenvoudige taak. Als er geen verdere vragen zijn, dank voor uw aandacht!
Een beetje reclame 🙂
Bedankt dat je bij ons blijft. Houd je van onze artikelen? Wil je meer interessante inhoud zien? Ondersteun ons door een bestelling te plaatsen of ons aan vrienden aan te bevelen, , een unieke variant van entry-level servers, die we voor jou hebben bedacht: (opties beschikbaar met RAID1 en RAID10, tot 24 cores en tot 40GB DDR4).
Dell R730xd is 2 keer goedkoper in datacenter Equinix Tier IV in Amsterdam? Alleen bij ons in Nederland! Dell R420 — 2x E5-2430 2.2Ghz 6C 128GB DDR3 2x960GB SSD 1Gbps 100TB — vanaf $99! Lees over hoe
Bron: habr.com
