

Uitleg van de presentatie uit 2015 van Ilya Kosmodemyanskiy "Linux-tuning om de prestaties van PostgreSQL te verbeteren"
Disclaimer: Ik wil erop wijzen dat deze presentatie dateert uit november 2015 – er zijn meer dan 4 jaar verstreken en er is veel tijd verstreken. De versie van PostgreSQL die in de presentatie wordt behandeld, 9.4, wordt al niet meer ondersteund. In de afgelopen 4 jaar zijn er 5 nieuwe releases van PostgreSQL en 15 versies van de Linux-kernel uitgebracht. Als we deze delen zouden herschrijven, zou het uiteindelijk een andere presentatie zijn. Maar hier wordt fundamentele tuning van Linux voor PostgreSQL behandeld, die nog steeds relevant is.
Mijn naam is Ilya Kosmodemyanskiy. Ik werk bij PostgreSQL-Consulting. En nu ga ik een beetje vertellen over wat te doen met Linux in verband met databases in het algemeen en met PostgreSQL in het bijzonder, omdat de principes behoorlijk vergelijkbaar zijn.
Waar gaat dit over? Als je met PostgreSQL werkt, moet je tot op zekere hoogte een UNIX-beheerder zijn. Wat betekent dat? Als we Oracle en PostgreSQL vergelijken, moet je in Oracle voor 80% een DBA (databasebeheerder) zijn en voor 20% een Linux-beheerder.
Met PostgreSQL is het iets ingewikkelder. Met PostgreSQL moet je veel beter begrijpen hoe Linux werkt. En daarbij moet je een beetje achter de feiten aanlopen, want de laatste tijd worden er behoorlijk veel updates uitgebracht. Nieuwe kernels komen uit, er verschijnt nieuwe functionaliteit en de prestaties verbeteren, enzovoort.
Waarom praten we over Linux? Niet omdat we op een Linux-conferentie in St. Petersburg zijn, maar omdat in de huidige omstandigheden een van de meest rechtvaardige besturingssystemen voor gebruik met databases in het algemeen en met PostgreSQL in het bijzonder, Linux is. Omdat FreeBSD, helaas, zich in een vreemde richting ontwikkelt. En er zullen problemen zijn met zowel de prestaties als met vele andere zaken. De prestaties van PostgreSQL onder Windows – dat is een geheel ander serieus onderwerp, dat te maken heeft met het feit dat Windows geen gedeeld geheugen heeft zoals UNIX, en PostgreSQL is daar helemaal van afhankelijk, omdat het een meerprocessysteem is.
En exotische systemen zoals Solaris zijn denk ik in mindere mate interessant voor iedereen, dus laten we verder gaan.
Een moderne Linux-distributie heeft meer dan 1.000 syctl-parameters, afhankelijk van hoe je de kernel compileert. Bovendien, als we nog eens naar verschillende instellingen kijken, zijn er nog veel manieren om zaken aan te passen. Er zijn parameters voor bestandssystemen, hoe ze moeten worden gemonteerd. Als het gaat om vragen over hoe te starten: wat in de BIOS moet worden ingeschakeld, hoe hardware moet worden ingesteld, enzovoort.
Dit is een zeer groot onderwerp waarover je meerdere dagen kunt praten en niet slechts in één korte presentatie, maar ik zal me nu richten op belangrijke zaken, zoals het vermijden van de valkuilen die er zeker voor zullen zorgen dat je de database op Linux niet goed kunt laten draaien als je deze niet oplost. En daarbij is het belangrijk om op te merken dat veel parameters standaard zijn ingeschakeld met instellingen die niet geschikt zijn voor databases. Dat wil zeggen, standaard zal het slecht functioneren of helemaal niet werken.
Welke traditionele tuningdoelen zijn er in Linux? Ik denk dat, aangezien jullie allemaal met Linux-beheer bezig zijn, het niet nodig is om uit te leggen wat doelen zijn.
Je kunt tunen:
- CPU.
- Geheugen.
- Opslag.
- Overige. Hierover zullen we aan het einde praten als een welkome afsluiting. Zelfs bijvoorbeeld zulke parameters als het energiebeheersbeleid kunnen op een zeer onvoorspelbare en onaangename manier de prestaties beïnvloeden.
Wat is de specificiteit van PostgreSQL en databases in het algemeen? Het probleem is dat je niet een enkele schroef kunt tunen en kijken of de prestaties aanzienlijk zijn verbeterd.
Ja, zulke schroeven zijn er, maar een database is een complex gegeven. Het interacteert met alle middelen die de server heeft en geeft er de voorkeur aan om volledig met hen samen te werken. Als je kijkt naar de moderne aanbevelingen van Oracle over hoe je het host-besturingssysteem moet gebruiken, dan is dat zoals de grap over die Mongoolse kosmonaut – voer de hond en raak niets aan. Geef de database alle middelen, de database regelt zelf alles.
In principe is de situatie met PostgreSQL in grote lijnen hetzelfde. Het verschil is dat de database niet alle middelen zelf kan verwerven, wat betekent dat je ergens op Linux dat zelf moet regelen.
De belangrijkste idee is niet om een enkel doel te kiezen en te beginnen met tunen, zoals geheugen, CPU of iets dergelijks, maar om de werklast te analyseren en te proberen de doorvoer zo veel mogelijk te verbeteren, zodat de belasting die vriendelijke programmeurs voor ons hebben gecreëerd, inclusief onze gebruikers, zo efficiënt mogelijk door onze database stroomt.
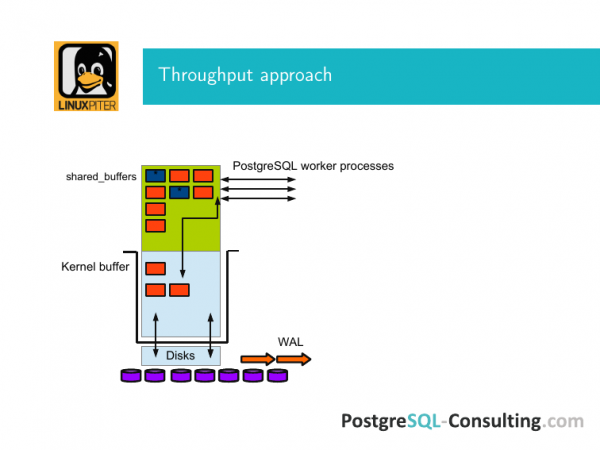
Hier is een afbeelding ter verduidelijking van wat dit is. Er is een buffer van Linux en er zijn gedeeld geheugen en gedeelde buffers van PostgreSQL. PostgreSQL werkt, in tegenstelling tot Oracle, alleen via de kernelbuffer, dat wil zeggen, om een pagina van de schijf in zijn gedeeld geheugen te krijgen, moet deze door de kernelbuffer gaan en weer terug, precies dezelfde situatie.
Onder dit systeem bevinden zich de schijven. Ik heb dit afgebeeld als schijven. In werkelijkheid kan er een RAID-controller zijn, enzovoort.
En deze invoer-uitvoer gebeurt op een of andere manier via dit alles.
PostgreSQL is een klassieke database. Binnenin zijn er pagina's. En alle invoer-uitvoer gebeurt met behulp van pagina's. We halen blokken in het geheugen met pagina's op. En als er niets is gebeurd en we hebben ze gewoon gelezen, dan verdwijnen ze geleidelijk uit deze cache, uit de gedeelde buffers, en komen ze terug op de schijf.
Als we ergens iets hebben vervangen, wordt de hele pagina gemarkeerd als 'vuil'. Ik heb ze hier blauwe gemarkeerd. En dit betekent dat deze pagina gesynchroniseerd moet worden met de blokopslag. Dat wil zeggen, wanneer we het vuil hebben gemaakt, hebben we een vermelding in WAL gemaakt. En op een zeker moment kwam er een fenomeen genaamd checkpoint. En in deze log is informatie over de aankomst genoteerd. En dit betekent dat alle vuile pagina's die op dat moment in deze gedeelde buffers waren, werden gesynchroniseerd met de opslagdisk via fsync via de kernelbuffer.
Waarom wordt dit gedaan? Als we stroom verliezen, krijgen we niet de situatie dat al onze gegevens verloren zijn. De persistente geheugen, waarover iedereen ons vertelde, is voorlopig een theorie in databases – het is een heldere toekomst waar we natuurlijk naar streven en dat vinden we fijn, maar voorlopig leven ze nog 20 jaar achter.
En de taak van het maximaliseren van de doorvoer is om al deze stappen te optimaliseren, zodat alles snel heen en weer gaat. Gedeeld geheugen is grotendeels paging cache. In PostgreSQL hebben we een select-verzoek verzonden, en hij haalde deze gegevens van de schijf. Ze kwamen in de gedeelde buffers. Dienovereenkomstig moet er veel geheugen zijn om dit beter te laten functioneren.
Om ervoor te zorgen dat alles goed en snel werkt, moet u het besturingssysteem op alle niveaus correct instellen. Kies ook gebalanceerde hardware, want als er ergens een onbalans is, kunt u veel geheugen hebben, maar zal het niet met de juiste snelheid worden bediend.
Laten we elk van deze punten een voor een doornemen.
Om ervoor te zorgen dat deze pagina's sneller heen en weer reizen, moet het volgende worden bereikt:
- Ten eerste moet er efficiënter met geheugen worden omgegaan.
- Ten tweede moet de overgang wanneer pagina's van geheugen naar schijf gaan, efficiënter zijn.
- En ten derde moeten er goede schijven zijn.
Als u 512 GB ram hebt in de server en dit uiteindelijk naar een SATA-harde schijf zonder enige cache gaat, dan verandert uw database server niet alleen in een pompoen, maar in een pompoen met SATA-interface. U zult er direct tegenaan lopen. En niets zal u redden.
Wat betreft het eerste punt over geheugen, er zijn drie dingen die het leven aanzienlijk kunnen compliceren.
De eerste is NUMA. NUMA is ontworpen om de prestaties te verbeteren. Afhankelijk van de workload kan er op verschillende punten worden geoptimaliseerd. En in zijn huidige vorm is het niet zo'n goede keuze voor applicaties zoals database die intensief gebruik maken van page cache en gedeelde buffers.
In het kort. Hoe herken je dat er iets mis is met NUMA? U krijgt een vervelend tikje, en opeens is een van de CPU's overbelast. En terwijl u de verzoeken in PostgreSQL analyseert, ziet u dat daar niets van vergelijkbare intensiteit is. Deze verzoeken zouden de CPU niet zo intensief moeten belasten. Dit probleem kan lang duren om op te sporen. Het is beter om vanaf het begin de juiste aanbeveling te volgen over hoe NUMA voor PostgreSQL te configureren.
Wat gebeurt er eigenlijk? NUMA staat voor Non-Uniform Memory Access. Waar gaat het om? U heeft een CPU, en daarnaast is er het bijbehorende lokale geheugen. Dit geheugen kan andere geheugenbronnen van andere CPU's aanroepen.
Als u numactl --hardware, dan ziet u zo'n uitgebreide uitvoer. Ondertussen zijn er ook velden met afstanden. Er zullen cijfers zijn – 10-20, iets dergelijks. Deze cijfers geven het aantal hops aan om dat externe geheugen aan te roepen en lokaal te gebruiken. In principe is dit een goed idee. Dit versnelt de prestaties bij bepaalde workloads.
Stel je nu voor dat je één CPU hebt die eerst probeert zijn lokale geheugen te gebruiken, en vervolgens probeert om via interconnect een ander geheugen erbij te halen voor iets. En al je page cache van PostgreSQL komt op deze CPU terecht - al die gigabytes. Je krijgt altijd het slechtste geval, omdat er meestal maar weinig beschikbare geheugenmodules zijn in deze CPU. En al het geheugen dat wordt bediend, gaat via deze interconnects. Het wordt traag en teleurstellend. En je hebt een processor die deze node constant overbelast. De toegangstijd tot dat geheugen is slecht en langzaam. Dit is de situatie die je wilt vermijden als je dit gebruikt voor een database.
Daarom is een betere optie voor databases dat het Linux-besturingssysteem helemaal niet weet wat er aan de hand is. Het zou moeten functioneren alsof het geheugen normaal wordt aangesproken.
Waarom is dat zo? Het lijkt erop dat het omgekeerd zou moeten zijn. Dit gebeurt om één simpele reden: we hebben veel geheugen nodig voor de page cache - tientallen, honderden gigabytes.
En als we dit allemaal toegewezen hebben en onze gegevens daar gecached hebben, zal de winst van het gebruik van cache aanzienlijk groter zijn dan de winst van een geavanceerde geheugenaanroep. Op deze manier winnen we niet te vergelijken met een efficiëntere geheugenaanroep met behulp van NUMA.
Daarom zijn er op dit moment twee benaderingen beschikbaar, totdat de toekomst helder wordt en de database zelf kan identificeren op welke CPU's ze draait en waar het iets vandaan moet halen.
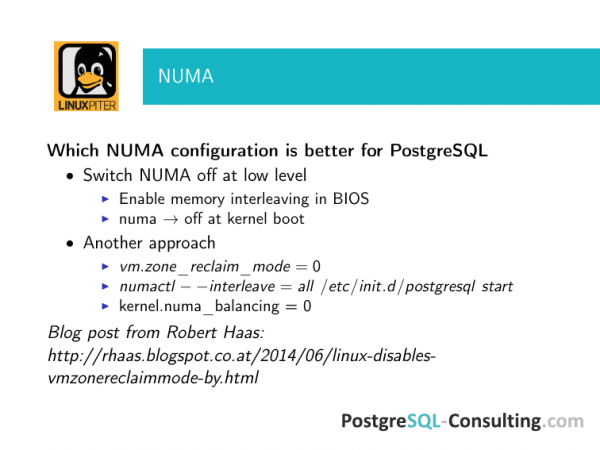
De juiste benadering is daarom om NUMA helemaal uit te schakelen., bijvoorbeeld bij het opnieuw opstarten. In de meeste gevallen zijn de winsten van dien aard dat er geen vraag is over wat beter is.
Er is een andere optie. We gebruiken deze vaker dan de eerste, omdat het voor een klant die ondersteuning vraagt een grote stap is om de server opnieuw op te starten. Zijn bedrijf draait daar. En ze ervaren problemen door NUMA. Daarom proberen we NUMA uit te schakelen op minder invasieve manieren dan reboot, maar wees voorzichtig om te controleren of het echt is uitgeschakeld. Want, zoals de ervaring leert, het uitschakelen van NUMA voor het bovenliggende PostgreSQL-proces is goed, maar het is niet zeker dat dit effectief zal zijn. Je moet controleren en zien of het daadwerkelijk is uitgeschakeld.
Er is een interessante post van Robert Haas. Hij is een van de committer van PostgreSQL en een van de sleutelontwikkelaars van alle low-level componenten. Als je de links in deze post volgt, vind je verschillende kleurrijke verhalen over hoe NUMA het leven van mensen bemoeilijkte. Kijk naar de checklist voor systeembeheerders over wat er op de server moet worden ingesteld om ervoor te zorgen dat onze database goed functioneert. Deze instellingen moeten worden genoteerd en gecontroleerd, want anders kan het problematisch worden.
Ik wil erop wijzen dat dit geldt voor alle instellingen waar ik het over ga hebben. Maar databases worden meestal in een master-slave configuratie opgezet voor redundantie. Vergeet niet deze instellingen ook op de slave aan te brengen, want op een gegeven moment gebeurt er iets en schakel je over naar de slave, die dan master wordt.
In een noodsituatie, wanneer alles echt slecht is, blijft je telefoon constant rinkelen en komt de baas met een grote stok langs, dan heb je geen tijd om na te denken over controles. Dat kan voor teleurstellende resultaten zorgen.
Een volgend punt zijn huge pages. Huge pages zijn lastig apart te testen en dat heeft ook niet veel zin, hoewel er benchmarks zijn die dit kunnen. Ze zijn gemakkelijk te vinden via Google.
Wat is de essentie? Je hebt een server die niet erg duur is, maar veel RAM heeft, bijvoorbeeld meer dan 30 GB. Huge pages worden niet gebruikt. Dit betekent dat je ongetwijfeld een overhead hebt in het geheugenverbruik. En die overhead is beslist onaangenaam.
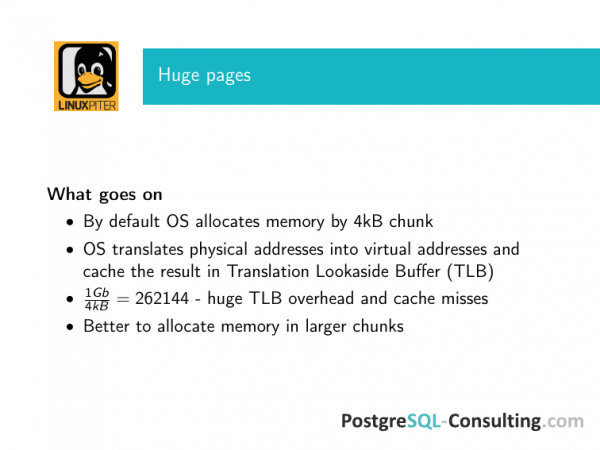
Waarom is dat zo? En wat gebeurt er? Het besturingssysteem wijst het geheugen in kleine stukjes toe. Dat is handig en zo is het historisch gezien ontstaan. Als we dieper ingaan op de details, dan moet het besturingssysteem virtuele adressen vertalen naar fysieke. En dit is een vrij complexe operatie, daarom cachet het besturingssysteem het resultaat van deze operatie in de Translation Lookaside Buffer (TLB).
En aangezien TLB een cache is, ontstaan in deze situatie alle problemen die bij caches horen. Ten eerste, als je veel RAM hebt en alles in kleine stukjes is toegewezen, dan wordt deze buffer erg groot. En als de cache groot is, wordt het zoeken erdoorheen trager. De overhead is aanzienlijk en het neemt zelf ruimte in, dat wil zeggen, iets foutief neemt RAM in beslag.
Twee – naarmate de cache in zo'n situatie groter wordt, neemt de kans op cache misses toe. En de efficiëntie van deze cache daalt snel naarmate de grootte toeneemt. Daarom hebben besturingssystemen een eenvoudige aanpak bedacht. In Linux wordt dit al lange tijd gebruikt. In FreeBSD is het niet zo lang geleden geïntroduceerd. Maar we spreken hier over Linux. Dit zijn huge pages.
Hier moet worden opgemerkt dat het idee van huge pages oorspronkelijk is gepromoot door gemeenschappen, waaronder Oracle en IBM, dat wil zeggen dat databaseproducenten goed nadenkten over de nuttigheid hiervan, ook voor databases.
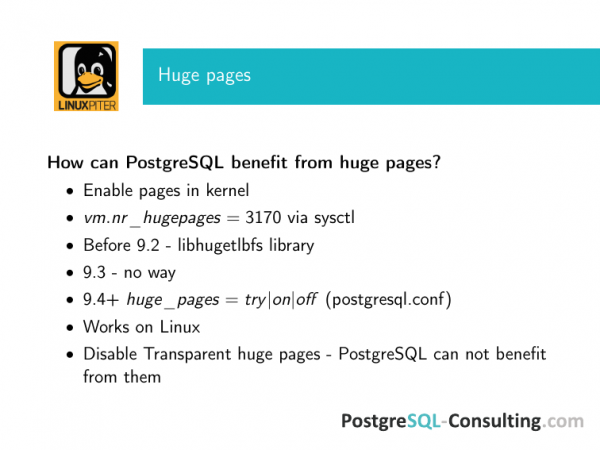
En hoe koppel je dit aan PostgreSQL? Ten eerste moeten huge pages ingeschakeld zijn in de Linux-kernel.
Ten tweede moeten ze expliciet worden aangegeven met de sysctl parameter – hoeveel ervan. De cijfers hier komen van een oude server. Je kunt ongeveer berekenen hoeveel shared buffers je hebt, zodat huge pages daarin passen.
En als je de hele server voor PostgreSQL gebruikt, dan is een goed startpunt om ofwel 25% van het RAM aan shared buffers toe te wijzen, ofwel 75% als je er zeker van bent dat je database in die 75% past. Dit is de eerste startpunt. En reken, als je 256 GB RAM hebt, dan heb je dus 64 GB shared buffers. Bereken het een beetje met een marge – wat deze waarde moet zijn.
Tot versie 9.2 (als ik het goed heb, sinds versie 8.2) kon je PostgreSQL met huge pages koppelen via een externe bibliotheek. En dit is altijd nodig. Ten eerste moet de kernel in staat zijn om huge pages correct toe te wijzen. En ten tweede moet de applicatie die hiermee werkt, deze kunnen benutten. Gewoonlijk zal deze niet vanzelf worden gebruikt. Aangezien PostgreSQL geheugen allocaties maakt op de manier van system 5, kon dit gedaan worden met behulp van libhugetlbfs – dat is de volledige naam van de bibliotheek.
In versie 9.3 is de prestatie van PostgreSQL bij het werken met geheugen verbeterd en is de system 5-methode voor geheugenallocatie afgeschaft. Iedereen was erg blij, omdat je anders twee instanties van PostgreSQL op één machine probeert te draaien, en dan zegt hij dat er niet genoeg gedeeld geheugen is. En hij zegt dat sysctl aangepast moet worden. En dat sysctl is zo dat je opnieuw moet opstarten, enzovoort. Kortom, iedereen was blij. Maar de mmap-geheugenallocatie heeft het gebruik van huge pages verbroken. De meeste van onze klanten gebruiken grote gedeelde buffers. En we hebben sterk aangeraden om niet over te stappen naar 9.3, omdat daar de overhead in goede percentages begon op te lopen.
Maar de community besteedde aandacht aan dit probleem en in 9.4 is deze functie heel goed herijkt. In 9.4 is er een parameter in postgresql.conf toegevoegd, waarmee je try, on of off kunt inschakelen.
Try is de veiligste parameter. Bij de opstart van PostgreSQL, wanneer hij gedeeld geheugen toewijst, probeert hij deze geheugen uit de huge pages te halen. En als dat niet lukt, valt hij terug op gewone toewijzing. En als je FreeBSD of Solaris hebt, kun je try instellen, dat is altijd veilig.
Als je on instelt, start het simpelweg niet op als het niet uit de huge pages kan toewijzen. Dit is meer een kwestie van voorkeur. Maar als je try hebt ingesteld, controleer dan of je daadwerkelijk hebt gekregen wat je nodig had, want er is veel ruimte voor fouten. Momenteel werkt deze functionaliteit alleen op Linux.
Een kleine opmerking voordat we verder gaan. Transparent huge pages zijn vooralsnog niet voor PostgreSQL. Het kan ze niet op de juiste manier benutten. En bij Transparent huge pages, voor een workload waarbij een groot stuk gedeeld geheugen nodig is, komen de voordelen alleen bij zeer grote volumes naar voren. Als je terabytes aan geheugen hebt, kan dit een rol spelen. Als we het hebben over meer alledaagse toepassingen, wanneer je 32, 64, 128, 256 GB geheugen op de machine hebt, is gewone huge pages prima en zetten we Transparent gewoon uit.
En het laatste punt over geheugen hangt niet direct samen met de doorvoer, maar kan het leven behoorlijk moeilijk maken. De totale bandbreedte lijdt enorm onder het feit dat de server voortdurend aan het swappen is.
En dit zal op een aantal momenten zeer onplezant zijn. Het voornaamste probleem is dat het gedrag in moderne Linux-kernelversies iets verschilt van dat in oudere versies. Dit is een punt waarop het vervelend kan zijn, omdat wanneer we het hebben over een operatie met swap, dit niet tijdig leidt tot de komst van de OOM-killer. En een OOM-killer die niet op tijd komt en PostgreSQL beëindigt, is erg vervelend. Dit wordt door iedereen opgemerkt, dat wil zeggen, tot de laatste gebruiker.
Wat gebeurt er? Je hebt daar een groot aantal RAM, alles werkt goed. Maar om de een of andere reden hangt de server in swap en vertraagt dit. Het lijkt erop dat er voldoende geheugen is, maar toch gebeurt het.
Eerder adviseerden we om vm.swappiness op nul te zetten, dat wil zeggen swap uit te schakelen. We dachten vroeger dat 32 GB RAM en bijbehorende gedeelde buffers een enorm aantal waren. De hoofdreden voor swap is dat er altijd ruimte moet zijn om iets te dumpen als we afgesneden worden. En dat gebeurde niet echt meer. En wat moest je daarna met dat iets doen? Dat wordt een taak waarbij het niet zo duidelijk is waarom swap nodig is, vooral van deze grootte.
Maar in meer moderne, dus derde versies van de kernel, is het gedrag veranderd. En als je swap op nul zet, dat wil zeggen, uitschakelt, zal de OOM-killer vroeg of laat bij jou aankomen, zelfs als je nog wat RAM over hebt, om de meest intensieve verbruikers te beëindigen. Omdat hij zal aannemen dat met een dergelijke werkbelasting we nog maar een beetje over hebben en we over de rand zullen schieten, dat wil zeggen, niet het systeembestand beëindigen, maar iets minder belangrijks. Dit minder belangrijke zal een intensieve gebruiker van gedeeld geheugen zijn, namelijk de postmaster. En daarna is het maar goed als we de database niet hoeven te herstellen.
Daarom is het nu standaard, voor zover ik me herinner, dat de meeste distributies rond de 6 zijn, dat wil zeggen, op welk punt te beginnen met het gebruik van swap afhankelijk van hoeveel geheugen er nog over is. Momenteel adviseren we om vm.swappiness = 1 in te stellen, omdat dit praktisch swap uitschakelt, maar niet de effecten genereert die komen met een onverwacht opkomende OOM-killer die alles beëindigt.
Wat nu? Wanneer we het hebben over de prestaties van databases en geleidelijk aan bij de schijven komen, beginnen mensen in paniek te raken. Want de waarheid dat schijven langzaam zijn en geheugen snel is, is voor iedereen al sinds hun kindertijd bekend. Iedereen weet dat er in databases problemen zullen zijn met de schijfprestaties.
Het belangrijkste probleem met de prestaties van PostgreSQL, gerelateerd aan checkpoints spikes, komt niet voort uit het feit dat de schijf langzaam is. Het heeft eerder te maken met het feit dat de doorvoercapaciteit van geheugen en schijf niet in balans is. Bovendien kunnen ze op verschillende plaatsen niet in balans zijn. PostgreSQL is niet geconfigureerd, het besturingssysteem is niet geconfigureerd, de hardware is niet goed ingesteld en de hardware is ongeschikt. Dit probleem doet zich alleen voor als alles goed gaat, dat wil zeggen, of er is geen belasting, of de instellingen en hardware zijn goed gekozen.
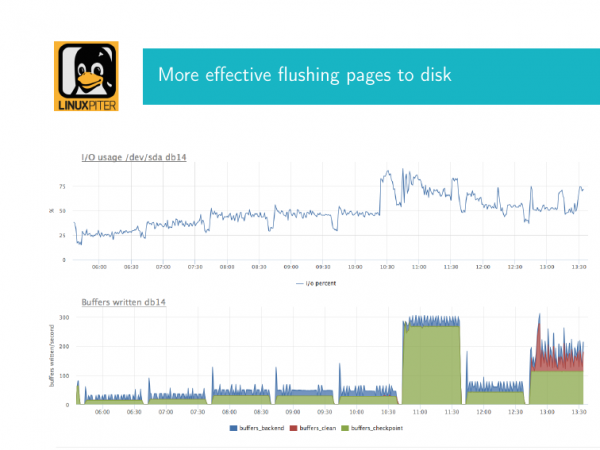
Wat is dit en hoe ziet het eruit? Gewoonlijk hebben mensen die met PostgreSQL werken dit probleem meerdere keren ervaren. Ik zal het uitleggen. Zoals ik al zei, maakt PostgreSQL periodiek checkpoints om vuile pagina's in het gedeelde geheugen naar de schijf te dumpen. Als we een groot volume aan gedeeld geheugen hebben, begint de checkpoint intensief op de schijf in te werken, omdat deze pagina's fsync. Het komt in de kernelbuffer en wordt naar de schijven geschreven met behulp van fsync. En als het volume groot is, kunnen we een onaangenaam effect waarnemen, namelijk een zeer hoge schijfutilisatie.
Hier heb ik twee afbeeldingen. Ik zal nu uitleggen wat dit is. Dit zijn twee grafieken die temporeel gecorreleerd zijn. De eerste grafiek toont de schijfutilisatie. Hier bereikt het bijna 90% op dat moment. Als u een database heeft die met fysieke schijven en een RAID-controller werkt en de utilisatie schiet naar bijna 90%, dan zijn dat slechte nieuws. Dit betekent dat, als dit zo doorgaat, we 100% zullen bereiken en de invoer/uitvoer zal stoppen.
Als u een schijfarray heeft, is er een iets ander verhaal. Het hangt af van hoe deze is ingesteld, wat voor soort array het is, enz.
Ondertussen is hier een grafiek geconfigureerd vanuit een interne Postgres-view, die aangeeft hoe de checkpoint plaatsvindt. En in groen is hier weergegeven hoeveel buffers, deze vuile pagina's op dat moment in deze checkpoint zijn aangekomen voor synchronisatie. Dit is het belangrijkste wat je hier moet weten. We zien dat er veel pagina's zijn aangekomen en op een bepaald moment stuitten we op de schijf, dat wil zeggen, we schreven en schreven, hier is de schijf duidelijk erg druk. En onze checkpoint heeft een aanzienlijke impact op de schijf. Idealiter zou de situatie er eerder zo uit moeten zien, dat wil zeggen, we hadden hier minder schrijfwerk. Met de juiste instellingen kunnen we dit corrigeren, zodat het zo blijft. Dat wil zeggen, de utilisatie is laag, maar we schrijven hier en daar iets.
Wat moet je doen om dit probleem op te lossen? Als je IO voor de database is gestopt, betekent dit dat alle gebruikers die hun verzoeken willen uitvoeren, zullen moeten wachten.
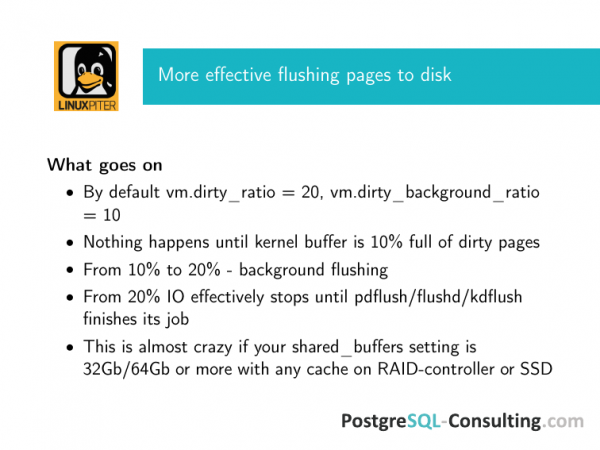
Als je het vanuit Linux bekijkt, als je goede hardware hebt, deze goed hebt ingesteld, en PostgreSQL normaal hebt ingesteld zodat het minder vaak deze checkpoints uitvoert en ze over de tijd verspreidt, kom je bij de standaardinstellingen van Debian. Voor de meeste Linux-distributies ziet het beeld er zo uit: vm.dirty_ratio=20, vm.dirty_background_ratio=10.
Wat betekent dit? Sinds kernel 2.6 is er een demon voor het flushen toegevoegd. Pdglush, afhankelijk van wie wat gebruikt, die zich bezighoudt met het achtergrondmatig leegmaken van vuile pagina's uit de kernelbuffer en het leegmaken wanneer het absoluut nodig is om vuile pagina's te legen, wanneer het achtergrondflushen niet helpt.
Wanneer vindt het achtergrondflushen plaats? Wanneer 10% van het totale RAM dat op de server beschikbaar is, bezet is met vuile pagina's in de kernelbuffer, wordt er een speciale functie voor achtergrondflushen aangeroepen. Waarom wordt het achtergrondflushen genoemd? Het neemt als parameter op hoeveel pagina's er moeten worden geflusht. En laten we zeggen dat het N pagina's flusht. En voor een bepaalde tijd slaat dit ding in slaap. En daarna komt het weer terug en flusht nog een aantal pagina's.
Het is een heel eenvoudig verhaal. Het is als met een zwembad, waar in de ene pijp water wordt geloosd, terwijl in de andere wordt ingevoerd. Onze checkpoint is gekomen en als het maar een paar vuile pagina's heeft verzonden om te flushen, dan zal alles langzaam vanuit de kernelbuffer via pgflush netjes worden opgelost.
Als deze vieze pagina's blijven zich ophopen, kunnen ze tot 20% oplopen, waarna het besturingssysteem prioriteit geeft aan het wegschrijven naar de schijf, omdat de stroom kan uitvallen en we in de problemen komen. We zullen bijvoorbeeld deze gegevens verliezen.
Wat is de truc? De truc is dat deze parameters in de moderne wereld 20 en 10% van het totale RAM zijn dat op de machine aanwezig is, dat vanuit het perspectief van de doorvoersnelheid van elk schijfsysteem dat je hebt, werkelijk belachelijk is.
Stel je voor dat je 128 GB RAM hebt. 12,8 GB komt binnen in je schijfsysteem. En wat voor cache je daar ook hebt staan, wat voor array je daar ook hebt, ze zullen het niet aankunnen.
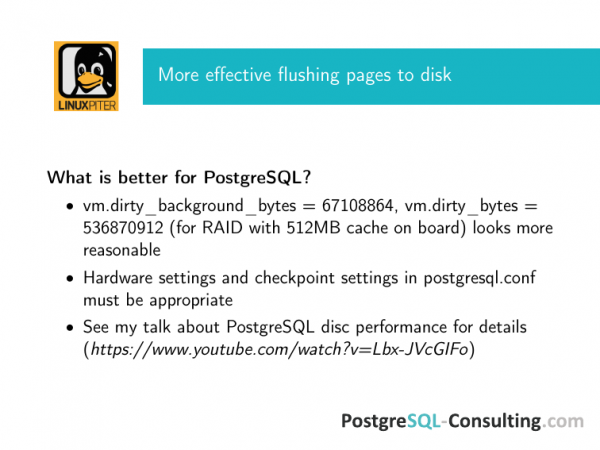
Daarom raden we aan om deze cijfers direct in te stellen op basis van de mogelijkheden van je RAID-controller. Ik geef hier meteen een aanbeveling voor een controller die 512 MB cache heeft.
Het is heel eenvoudig te berekenen. Je kunt vm.dirty_background in bytes instellen. En deze instellingen annuleren de vorige twee. Of het ratio standaard is, of die met bytes zijn geactiveerd, die met bytes zullen werken. Maar omdat ik DBA-consultant ben en met verschillende klanten werk, probeer ik het veilig te spelen en daarom, als het in bytes is, dan in bytes. Niemand heeft enige garantie gegeven dat een goedwillende admin de server geen extra geheugen geeft, of deze opnieuw opstart, terwijl het cijfer hetzelfde blijft. Bereken gewoon deze cijfers zodat je met zekerheid kunt zeggen dat alles erin past.
Wat gebeurt er als je niet past? Het is geschreven dat elke flushing effectief stopt, maar in werkelijkheid is dat een figuurlijke uitspraak. Het besturingssysteem heeft een groot probleem - het heeft veel vieze pagina's, dus het IO dat door jouw klanten wordt gegenereerd, stopt effectief. Dus als er een SQL-query van een applicatie naar de database wordt verzonden, wacht deze. Elk input/output in het laagste prioriteit, omdat de database bezig is met checkpoint. En wanneer het daar klaar mee is, is totaal onduidelijk. En wanneer je de niet-achtergrond flushing hebt bereikt, betekent dat dat al je IO daarmee bezig is. En zolang dat niet compleet is, kun je niets doen.
Er zijn nog twee belangrijke punten die buiten dit rapport vallen. Deze instellingen moeten overeenkomen met de instellingen in postgresql.conf, dat wil zeggen de instellingen voor checkpoints. En je schijfsysteem moet adequaat ingesteld zijn. Als je cache op RAID hebt, moet er een batterij zijn. Mensen kopen RAID met goede cache zonder batterij. Als je SSD in RAID hebt, moeten ze serverversies zijn met condensatoren. Hier is een uitgebreide checklist. Via deze link vind je mijn presentatie over het configureren van schijfprestaties in PostgreSQL. Alle checklists zijn daar te vinden.
Wat kan het leven nog meer compliceren? Dit zijn twee parameters. Ze zijn relatief nieuw en kunnen standaard ingeschakeld zijn in verschillende toepassingen. Ze kunnen evenzeer het leven compliceren als ze verkeerd zijn ingesteld.
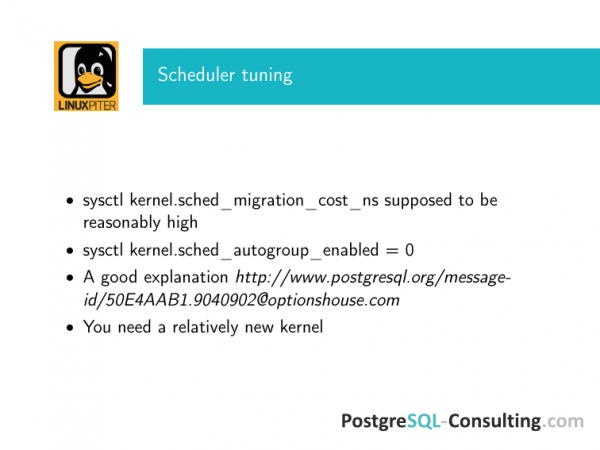
Er zijn twee relatief nieuwe zaken. Deze zijn al in de derde kernels verschenen. Dit is sched_migration_cost in nanoseconden en sched_autogroup_enabled, dat standaard op één staat.
En hoe verpesten ze het leven? Wat is sched_migration_cost? De Linux-scheduler kan een proces van de ene CPU naar de andere migreren. Voor PostgreSQL, dat queries uitvoert, is migratie naar een andere CPU volkomen onduidelijk. Voor de database is dit heel slecht. Daarom is het verstandig om migration_cost een grote waarde te geven, ten minste enkele duizenden nanoseconden.
Wat betekent dit voor de scheduler? Het zal aannemen dat het proces gedurende deze tijd nog steeds 'heet' is. Dus als je een lange transactie hebt die ergens mee bezig is, zal de scheduler dat begrijpen. Hij zal aannemen dat zolang de timeout niet is verstreken, het proces niet hoeft te migreren. Als het proces ondertussen iets doet, zal het nergens naartoe worden gemigreerd en gewoon doorwerken op de CPU die aan hem is toegewezen. Het resultaat is uitstekend.
Het tweede punt is autogroup. Dit is een goed idee voor specifieke workloads die niets met moderne databases te maken hebben – processen groeperen op basis van de virtuele terminal van waaruit ze zijn gestart. Dit is handig voor bepaalde taken. In practice, PostgreSQL is a multi-process system with a prefork model, started from a single terminal. You have a lock writer, checkpoint, and all your client requests will be grouped on one scheduler, on one CPU. They will wait there together until it is freed up, interfering with each other and occupying it longer. This scenario is completely unnecessary under such a load, so it needs to be turned off.
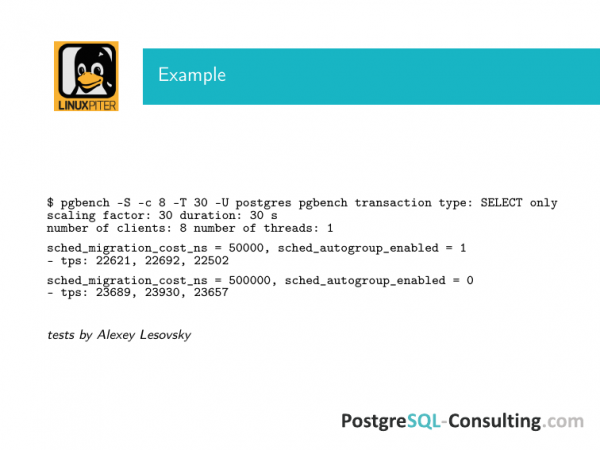
My colleague Alexey Lesovsky conducted tests with a simple pgbench, where he increased migration_cost by an order of magnitude and turned off autogroup. The difference on poor hardware turned out to be almost 10%.There is a discussion in the PostgreSQL mailing list where people provide results on how such changes have affected query speed. It influenced by 50%.There are quite a few such cases.
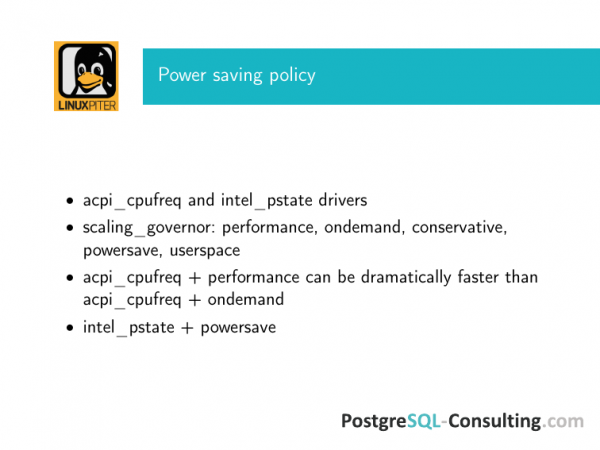
And lastly about the power saving policy. It's good that Linux can now be used on laptops. And it will supposedly conserve battery well. But it turns out that this can unexpectedly happen on servers as well.
Moreover, if you rent servers from some hoster, then the "kind" hostingproviders do not care about improving your performance. Their task is to ensure that their hardware is utilized as efficiently as possible. Therefore, they may enable laptop power-saving mode by default on the operating system.
If you are using this goodness on a database server under heavy load, your choice should be acpi_cpufreq + performance. Even with ondemand, there will already be problems.
Intel_pstate is a slightly different driver. And now preference is given to this one, as it is more recent and works better.
Accordingly, the governor should be set to performance only. Ondemand, powersave, and everything else is not for you.
Results from explain analyze in PostgreSQL can differ by several orders of magnitude if you enable powersave, because your CPU will schedule under the database in a completely unpredictable manner.
These features may be enabled by default. Check carefully whether they have been enabled by default. This can indeed be a significant issue.
En uiteindelijk wil ik de jongens van ons DBA-team PosgreSQL-Consulting bedanken, in het bijzonder Max Boguk en Alexey Lesovsky, die dagelijks met deze kwestie bezig zijn. Voor onze klanten proberen we alles zo goed mogelijk te laten werken. Het is als met instructies voor luchtvaartveiligheid. Alles is met bloed geschreven. Elke van deze problemen is ontdekt tijdens een bepaalde kwestie. Ik deel ze graag met jullie.
Vragen:
Dank je! Als een bedrijf bijvoorbeeld wil besparen en zowel de database als de applicatielogica op dezelfde server wilt draaien, of als het bedrijf de modieuze trend van microservices volgt waarbij PostgreSQL in een container draait. Wat is het idee? Sysctl heeft invloed op de hele kernel. Ik heb niet gehoord dat sysctl op de een of andere manier gevirtualiseerd zijn, zodat ze apart in de container werken. Er is alleen cgroup en daar is er alleen controle over een deel. Hoe kun je hiermee leven? Of als je performance wilt, dan draai je PostgreSQL op een aparte fysieke server en optimaliseer je het?
We hebben je vraag op ongeveer drie manieren beantwoord. Als het niet gaat om een fysieke server die je kunt tuning en dergelijke, dan ontspan je maar, het zal zonder deze instellingen goed werken. Als je zoveel belasting hebt dat je deze instellingen moet maken, dan kom je eerder bij de fysieke server dan bij deze instellingen.
Wat is het probleem? Als het een virtuele machine is, heb je waarschijnlijk veel problemen, bijvoorbeeld met de inconsistente schijf-latentie op de meeste virtuele machines. Zelfs als de schijfbandbreedte goed is, kan een enkele gefaalde transactie van een invoer-uitvoerbewerking, die niet veel invloed heeft op de gemiddelde bandbreedte, die plaatsvond tijdens een checkpoint of op het moment van schrijven naar WAL, de database ernstig schaden. En je zal dit eerder opmerken dan dat je tegen deze problemen aanloopt.
Als je NGINX op dezelfde server draait, zal er ook hetzelfde probleem optreden. Het zal strijden om gedeeld geheugen. En je zult niet komen tot de problemen die hier zijn beschreven.
Aan de andere kant zijn sommige van deze parameters nog steeds relevant voor u. Bijvoorbeeld, met sysctl de dirty_ratio instellen, zodat het niet zo gek is – dit zal in ieder geval helpen. Hoe dan ook, u zult interactie hebben met de schijf. En dit zal op een onjuiste manier gebeuren. Dit zijn sowieso de standaardinstellingen die ik liet zien. En hoe dan ook, het is beter om ze te wijzigen.
Met NUMA kunnen er problemen zijn. VmWare bijvoorbeeld werkt goed met NUMA met precies tegenovergestelde instellingen. En hier moet je kiezen – bare metal server of geen bare metal.
Ik heb een vraag over Amazon AWS. Ze hebben voorgedefinieerde images. Een daarvan heet Amazon RDS. Zijn daar enige aangepaste instellingen voor hun besturingssysteem?
Er zijn instellingen, maar het zijn andere instellingen. Hier configureren we het besturingssysteem vanuit het perspectief van hoe de database het zal gebruiken. En daar zijn parameters die bepalen, waar moeten we nu heen, zo'n shaping. Dat wil zeggen, we hebben zoveel middelen nodig, en we gaan ze nu gebruiken. Daarna koppelt Amazon RDS deze middelen aan, en de prestaties dalen. Er zijn aparte verhalen over hoe mensen hiermee beginnen te rommelen. Soms zelfs met enige succes. Maar dit heeft niets te maken met de OS-instellingen. Dit is soort van cloud hacking. Dit is een ander verhaal.
Waarom hebben Transparent huge pages geen effect vergeleken met Huge TLB?
Ze hebben geen effect. Dit kan op verschillende manieren worden uitgelegd. Maar feitelijk geven ze gewoon geen effect. Wat is het verhaal met PostgreSQL? Bij de opstart wijst hij een groot stuk gedeeld geheugen toe. Of ze Transparent zijn of niet, dat is helemaal niet belangrijk. Het feit dat ze bij de opstart worden toegewezen, verklaart alles. En als er veel geheugen is en de shared_memory segment moet worden opgebouwd, dan wordt Transparent huge pages relevant. Bij PostgreSQL is het gewoon enorm toegewezen bij de opstart en verder gebeurt er niets bijzonders. Je kunt het natuurlijk gebruiken, maar er is kans op corruptie van het shared_memory wanneer het iets opnieuw gaat toewijzen. PostgreSQL weet hierover niets.
Bron: habr.com
