

Wat zou je voelen als op een prachtige zomerdag datacenter met jouw apparatuur er zo uit zou zien?
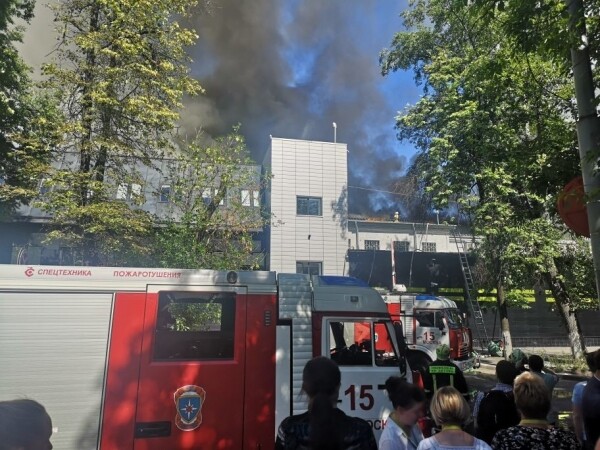
Hallo allemaal! Mijn naam is Dmitry Samsonov, ik ben hoofd sysadmin bij «». Op de foto is een van de vier datacenters waar apparatuur is geïnstalleerd die ons project ondersteunt. Achter deze muren bevinden zich ongeveer 4000 apparaten: servers, opslag systemen, netwerktechnologie, enzovoorts - bijna ⅓ van al onze apparatuur.
De meeste servers draaien op Linux. Er zijn ook enkele tientallen Windows-servers (MS SQL) - ons erfgoed, waarvan we al jaren gestaag afzien.
Dus, op 5 juni 2019 om 14:35 meldden ingenieurs van een van onze datacenters een brandalarm.
Ontkenning
14:45. Kleine incidenten met rook in datacenters komen vaker voor dan je zou denken. De waarden binnen de zalen waren normaal, dus onze eerste reactie was relatief kalm: we hebben een verbod op productiewerkzaamheden ingesteld, dat wil zeggen op alle configuratiewijzigingen, het uitrollen van nieuwe versies, enzovoorts, behalve werkzaamheden gerelateerd aan het herstel van iets.
Woede
Heb je ooit geprobeerd om aan de brandweer te vragen waar precies op het dak de brand was of zelf op het brandende dak te komen om de situatie te beoordelen? Wat is de betrouwbaarheid van informatie die door vijf mensen is doorgegeven?
14:50. Er kwam informatie binnen dat het vuur zich naar het koelsysteem beweegt. Maar zal het dat bereiken? De waarnemende sysadmin haalt het externe verkeer weg van de fronten van dit datacenter.
Op dit moment zijn de fronten van al onze diensten gedupliceerd in drie datacenters, met balans op DNS-niveau, wat het mogelijk maakt om de adressen van één datacenter uit DNS te verwijderen, zodat gebruikers beschermd zijn tegen mogelijke problemen met de toegang tot de diensten. Als er al problemen zijn opgeroepen in het datacenter, wordt het automatisch uit de rotatie gehaald. Lees hier meer:
De brand heeft ons vooralsnog niet beïnvloed - noch de gebruikers, noch de apparatuur zijn beschadigd. Is dit een storing? Het eerste gedeelte van het document 'Actieplan bij een storing' geeft een definitie van het begrip 'storing', en eindigt als volgt:
«Als er twijfels zijn of het een storing is of niet, dan is het dat!»
14:53. De noodcoördinator wordt aangesteld.
De coördinator is de persoon die de communicatie tussen alle betrokkenen beheert, de omvang van de noodsituatie inschat, het "noodactieplan" gebruikt, het benodigde personeel mobiliseert, de afronding van de reparaties controleert en, het allerbelangrijkste, taken delegeert. Met andere woorden, dit is de persoon die het hele proces van het afhandelen van de noodsituatie aanstuurt.
Bod
15:01. We beginnen met het uitschakelen van servers die niet op de productie zijn aangesloten.
15:03. We schakelen alle gereserveerde diensten op een correcte manier uit.
Dit omvat niet alleen de front-ends (waarop op dit moment geen gebruikers meer inloggen) en hun ondersteunende diensten (business logic, caches, etc.), maar ook verschillende databases met een replicatiefactor van 2 of hoger (, , , enzovoorts).
15:06. Er is informatie binnengekomen dat een brand een van de zalen van het datacenter bedreigt. In deze zaal hebben we geen apparatuur, maar de mogelijkheid dat het vuur van het dak overspringt naar de andere zalen verandert de situatie aanzienlijk.
(Later bleek dat er geen fysieke bedreiging voor de zaal was, aangezien deze hermetisch van het dak was geïsoleerd. De bedreiging was alleen voor het koelsysteem van deze zaal.)
15:07. We staan versnelde uitvoering van opdrachten op servers toe zonder extra controles ().
15:08. De temperatuur in de zalen is binnen normaal.
15:12. Er is een verhoging van de temperatuur in de zalen vastgesteld.
15:13. Meer dan de helft van de servers in het datacenter is uitgeschakeld. We gaan verder.
15:16. De beslissing is genomen om al het apparatuur uit te schakelen.
15:21. We beginnen met het uitschakelen van de voeding op stateless-servers zonder correcte afsluiting van de applicatie en het besturingssysteem.
15:23. Er is een groep aangesteld die verantwoordelijk is voor MS SQL (er zijn er maar weinig, de afhankelijkheid van de diensten van hen is niet groot, maar de hersteltijd is langer en complexer dan bijvoorbeeld die van Cassandra).
Depressie
15:25. Er is informatie over het uitschakelen van de voeding in vier zalen van de 16 (nr. 6, 7, 8, 9). In zaal 7 en 8 bevindt zich onze apparatuur. Van twee van onze zalen (nr. 1 en 3) is er nog geen informatie.
Normaal gesproken wordt bij branden de elektriciteit onmiddellijk uitgeschakeld, maar in dit geval, dankzij de gecoördineerde inspanningen van de brandweer en het technische personeel van het datacenter, werd de elektriciteit niet overal en niet onmiddellijk uitgeschakeld, maar alleen waar nodig.
(Later it became clear that the power in halls 8 and 9 had not been turned off.)
15:28. We are starting to restore MS SQL databases from backups in other data centers.
How much time will this take? Is there enough bandwidth across the entire route?
15:37. Some network segments have been reported as down.
The management and production networks are physically isolated from each other. If the production network is available, you can access the server, stop the application, and shut down the OS. If it is not available, you can access via IPMI, stop the application, and shut down the OS. If neither network is available, you can’t do anything. "Thanks, Captain!" you might think.
"And really, there's a lot of commotion going on," you might also think.
The thing is, servers generate a tremendous amount of heat even without a fire. More precisely, when there is cooling, they generate heat, and when there isn't, they create an inferno that at best melts some equipment and disables others, and at worst... causes a fire inside the hall, which will almost certainly destroy everything.
15:39. We are noting issues with the conf database.
The conf database serves as the backend for the namesake service, which is used by all production applications for real-time settings adjustment. Without this database, we cannot manage the portal’s operation, but the portal itself can still function.
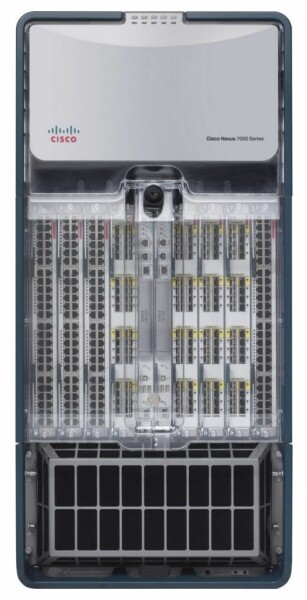
15:41. Temperature sensors on Core network equipment are reporting readings close to the permissible limit. This is a box that occupies an entire rack and ensures the operation of all networks within the data center.
15:42. Issue tracker and wiki are unavailable, switching to standby.
This is not production, but in case of an emergency, the availability of any knowledge base may be critical.
15:50. One of the monitoring systems has gone down.
There are several of them, and they are responsible for different aspects of service operation. Some are configured for autonomous operation within each data center (i.e., they only monitor their own data center), while others consist of distributed components that seamlessly handle the loss of any data center.
In this case, the , which operates in master-standby mode. Switched to standby.
Acceptance
15:51. Powered down all servers without a proper shutdown via IPMI, except for MS SQL.
Bent u voorbereid op massaal serverbeheer via IPMI indien nodig?
Dat is het moment waarop de redding van apparatuur in de datacenters op dit punt is voltooid. Alles wat gedaan kon worden, is gedaan. Sommige collega's kunnen uitrusten.
16:13. Er is informatie binnengekomen dat de koelmiddelenleidingen op het dak zijn gesprongen — dit zal de oplevering van het datacenter na de brand vertragen.
16:19. Volgens gegevens van het technische personeel van het datacenter is de temperatuurstijging in de zalen gestopt.
17:10. De werking van de conf-database is hersteld. Nu kunnen we de instellingen van de applicaties aanpassen.
Waarom is dit zo belangrijk, als alles failover is en zelfs zonder één datacenter werkt?
Ten eerste is niet alles failover. Er zijn verschillende secundaire diensten die momenteel niet goed omgaan met de uitval van het datacenter, en er zijn databases in master-standby modus. De mogelijkheid om instellingen te beheren maakt het mogelijk alles te doen wat nodig is om zelfs onder moeilijke omstandigheden de impact van de ramp op gebruikers te minimaliseren.
Ten tweede werd duidelijk dat het datacenter de komende uren niet volledig zal functioneren, daarom moesten er maatregelen worden genomen om te voorkomen dat langdurige onbeschikbaarheid van de replica's leidde tot extra problemen zoals schijfoverloop in de resterende datacenters.
17:29. Tijd voor pizza! Wij hebben mensen aan het werk, geen robots.
Rehabilitatie
18:02. In de zalen №№8 (de onze), 9, 10 en 11 is de temperatuur gestabiliseerd. In een van de zalen die nog steeds uitgeschakeld zijn (№7) bevindt zich onze apparatuur en de temperatuur blijft stijgen.
18:31. We hebben groen licht gegeven voor de start van de apparatuur in zalen №№1 en 3 — deze zalen zijn niet door de brand aangetast.
Momenteel worden servers in de zalen №№1, 3, 8 opnieuw opgestart, te beginnen met de meest kritische. De correctheid van het functioneren van alle opgestarte diensten wordt gecontroleerd. Er zijn nog steeds problemen met zaal №7.
18:44. Het technische personeel van het datacenter ontdekte dat in zaal №7 (waar alleen onze apparatuur staat) veel servers niet zijn uitgeschakeld. Volgens onze gegevens blijven er 26 servers ingeschakeld. Na een tweede controle ontdekken we dat er 58 servers zijn.
20:18. Het technische personeel van het datacenter blaast lucht in de zaal zonder airconditioning door mobiele luchtkanalen die door de gangen zijn gelegd.
23:08. We sent the first admin home. Someone needs to get some sleep tonight to continue the work tomorrow. Next, we are releasing more admins and developers.
02:56. We have launched everything that could be launched. We are conducting a comprehensive check of all services with automated tests.
03:02. Air conditioning in the last, 7th room has been restored.
03:36. We have initiated the DNS traffic routing in the data center. From this point, user traffic begins to arrive.
We are sending most of the admin team home. However, we are keeping a few people.
A brief FAQ:
Q: What happened from 18:31 to 02:56?
A: Following the "Disaster Response Plan", we launch all services starting with the most critical. During this, the coordinator in the chat assigns a service to a free admin, who checks if the OS and application have started, if there are any errors, and if everything is functioning normally. After the launch is complete, they inform the chat that they are available and receive a new service from the coordinator.
The process is further delayed by failed hardware. Even if the OS stop and server shutdown were successful, some servers do not return due to unexpectedly failed disks, memory, or chassis. The percentage of failures increases when there is a power loss.
Q: Why can't we just launch everything at once, and then fix what shows up in monitoring?
A: Everything must be done gradually, because there are dependencies between services. And everything should be checked right away, without waiting for monitoring — because it’s better to resolve issues immediately rather than waiting for them to escalate.
7:40. The last admin (the coordinator) went to sleep. The work of the first day is complete.
8:09. The first developers, engineers in the data centers, and admins (including the new coordinator) began recovery efforts.
09:37. We started bringing up room #7 (the last one).
Simultaneously, we continue to recover what was not completed in the other rooms: replacing disks/memory/servers, fixing everything that is flagged in monitoring, reverting roles in master-standby schemas, and other small tasks, of which there are still quite a few.
17:08. We allow all routine work with production.
21:45. The work of the second day is complete.
09:45. Vandaag is het vrijdag. In de monitoring zijn er nog steeds behoorlijk wat kleine problemen. Het weekend staat voor de deur en iedereen wil uitrusten. We blijven massaal bezig met het repareren van alles wat kan. De standaardbeheer taken die uitgesteld konden worden, zijn uitgesteld. We hebben een nieuwe coördinator.
15:40. Onverwacht heeft de helft van de Core-netwerkhardware in een ANDERE datacenter opnieuw opgestart. De fronten zijn uit de rotatie gehaald om risico's te minimaliseren. Er zijn geen effecten voor de gebruikers. Later bleek dat het een defecte chassis was. De coördinator werkt aan de reparatie van twee storingen tegelijk.
17:17. Het netwerk in het andere datacenter is hersteld, alles is gecontroleerd. Het datacenter is weer in rotatie.
18:29. De werkzaamheden van de derde dag en het herstel na de storing zijn afgerond.
Naschrift
04-04-2013, , "Odnoklassniki" — gedurende drie dagen was de portal volledig of gedeeltelijk onbereikbaar. Gedurende deze tijd hebben meer dan 100 mensen uit verschillende steden en verschillende bedrijven (nogmaals bedankt!), op afstand en persoonlijk in de datacenters, handmatig en automatisch duizenden servers gerepareerd.
We hebben lessen getrokken. Om dergelijke situaties te voorkomen, hebben we grondige werkzaamheden uitgevoerd en voeren we deze nog steeds uit.
Wat zijn de belangrijkste verschillen tussen de huidige storing en 404?
- We hebben een ‘Actieplan bij storingen’ geïntroduceerd. Elk kwartaal oefenen we — we simuleren een storing die de groep beheerders (iedereen om beurten) moet verhelpen met behulp van het ‘Actieplan bij storingen’. De belangrijkste systeembeheerders oefenen om beurten de rol van coördinator uit.
- Kwartaalgewijs isoleren we in testmodus de datacenters (iedereen om beurten) via LAN en WAN, wat ons in staat stelt om tijdig knelpunten te identificeren.
- Minder defecte schijven, omdat we de normen hebben aangescherpt: minder draaiuren, striktere drempelwaarden voor S.M.A.R.T.,
- We zijn volledig afgestapt van BerkeleyDB — de oude en onbetrouwbare database die veel tijd vereiste voor herstel na een herstart van de server.
- We hebben het aantal servers met MS SQL verminderd en onze afhankelijkheid van de overgebleven servers verkleind.
- We hebben onze eigen , waarin we al twee jaar actief alle diensten migreren. De cloud vereenvoudigt de gehele cyclus van werken met de applicatie en biedt in geval van storingen unieke hulpmiddelen zoals:
- eenvoudige stop van alle applicaties met één klik;
- eenvoudige migratie van applicaties van defecte servers;
- automatische rangschikking (op prioriteit van services) van een hele datacenter.
De storing die in dit artikel wordt beschreven, is de grootste sinds de 404. Natuurlijk verliep niet alles vlekkeloos. Tijdens de downtime van het getroffen datacenter viel bijvoorbeeld een schijf uit op een van de servers in een ander datacenter, waardoor slechts één van de drie replica's in het Cassandra-cluster beschikbaar bleef, waardoor 4,2% van de gebruikers van de mobiele applicaties niet kon inloggen. Aangesloten gebruikers konden echter wel blijven werken. In totaal zijn er meer dan 30 problemen aan het licht gekomen door de storing — van banale bugs tot tekortkomingen in de architectuur van de services.
Maar het belangrijkste verschil tussen de huidige storing en die van 404 is dat terwijl we de gevolgen van de brand aanpakten, gebruikers nog steeds berichten verstuurden en videogesprekken voerden in , spellen speelden, muziek luisterden, elkaar cadeaus gaven, video's, series en tv-zenders keken in , en ook streamden in .
Hoe verlopen jouw storingen?
Bron: habr.com
