

Zes maanden geleden — een openbare voor PostgreSQL.
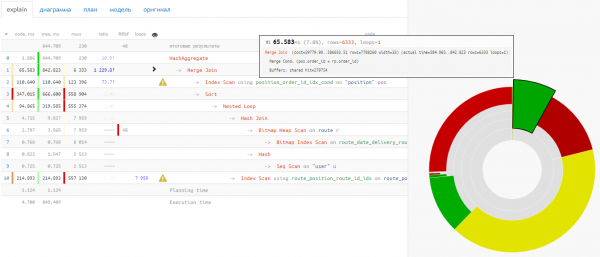
In de afgelopen maanden hebben we hierover een , een samenvattend op basis van de aanbevelingen die het biedt… maar het belangrijkste is dat we jullie feedback hebben verzameld en gekeken hebben naar echte use cases.
En nu zijn we klaar om te vertellen over de nieuwe mogelijkheden die je kunt gebruiken.
Ondersteuning van verschillende formaten van plannen
Een plan uit de log, samen met de query
markeren we rechtstreeks vanuit de console, beginnend met de regel met Query Text, met al die leidende spaties:
        Query Text: INSERT INTO  dicquery_20200604  VALUES ($1.*) ON CONFLICT (query)
                           DO NOTHING;
        Insert on dicquery_20200604  (cost=0.00..0.05 rows=1 width=52) (actual time=40.376..40.376 rows=0 loops=1)
          Conflict Resolution: NOTHING
          Conflict Arbiter Indexes: dicquery_20200604_pkey
          Tuples Inserted: 1
          Conflicting Tuples: 0
          Buffers: shared hit=9 read=1 dirtied=1
          ->  Result  (cost=0.00..0.05 rows=1 width=52) (actual time=0.001..0.001 rows=1 loops=1)
… en we gooien alles wat gekopieerd is rechtstreeks in het veld voor het plan, zonder iets te splitsen:
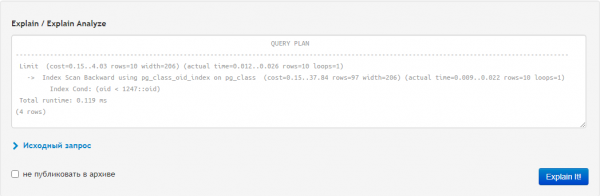
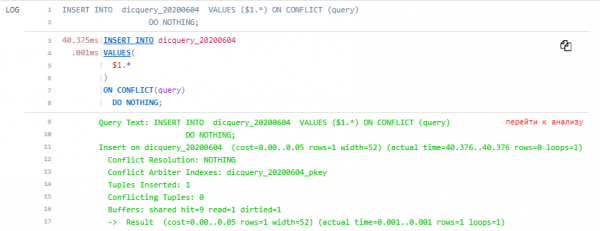
Als resultaat krijgen we als bonus bij het geanalyseerde plan ook het tabblad 'context', waar onze query in al zijn glorie wordt gepresenteerd:
JSON en YAML
EXPLAIN (ANALYZE, BUFFERS, FORMAT JSON)
SELECT * FROM pg_class;
[
{
"Plan": {
"Node Type": "Seq Scan",
"Parallel Aware": false,
"Relation Name": "pg_class",
"Alias": "pg_class",
"Startup Cost": 0.00,
"Total Cost": 1336.20,
"Plan Rows": 13804,
"Plan Width": 539,
"Actual Startup Time": 0.006,
"Actual Total Time": 1.838,
"Actual Rows": 10266,
"Actual Loops": 1,
"Shared Hit Blocks": 646,
"Shared Read Blocks": 0,
"Shared Dirtied Blocks": 0,
"Shared Written Blocks": 0,
"Local Hit Blocks": 0,
"Local Read Blocks": 0,
"Local Dirtied Blocks": 0,
"Local Written Blocks": 0,
"Temp Read Blocks": 0,
"Temp Written Blocks": 0
},
"Planning Time": 5.135,
"Triggers": [
],
"Execution Time": 2.389
}
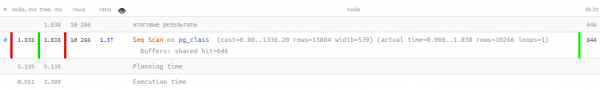
]Of met externe aanhalingstekens, zoals pgAdmin het kopieert, of zonder — we gooien het in hetzelfde veld en het resultaat — prachtig:
Uitgebreide visualisatie
Planningstijd / Uitvoeringstijd
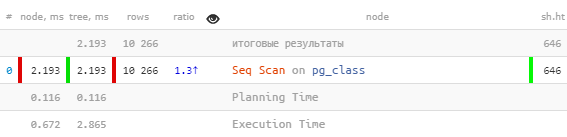
Nu is het beter zichtbaar waar een deel van de extra tijd verloren is gegaan bij het uitvoeren van de query:
I/O Timing
Soms doen zich situaties voor waarin het lijkt alsof er niet te veel resources zijn gelezen en geschreven in het plan, maar de uitvoeringstijd toch ongewoon hoog is.
Dan moet je zeggen: "Oh, waarschijnlijk was de schijf op de server op dat moment te druk, daarom duurde het zo lang om te lezen!" Maar dat is niet echt nauwkeurig...
Maar je kunt dit absoluut betrouwbaar bepalen. Het punt is dat onder de configuratieopties van de PG-server :
de meting van de tijd van invoer-/uitvoeroperaties inschakelt. Deze parameter is standaard uitgeschakeld, omdat hiervoor voortdurend de huidige tijd van het besturingssysteem moet worden opgevraagd, wat de prestaties op sommige platforms aanzienlijk kan vertragen. Voor het inschatten van de overhead van tijdmeting op jouw platform kun je gebruikmaken van de tool pg_test_timing. Statistieken over invoer-/uitvoer kunnen worden verkregen via de weergave pg_stat_database, in de uitvoer van EXPLAIN (wanneer de parameter BUFFERS wordt gebruikt) en via de weergave pg_stat_statements.
Deze parameter kan ook binnen een lokale sessie worden ingeschakeld:
SET track_io_timing = TRUE;Nou, en nu het leukste — we hebben geleerd deze gegevens te begrijpen en weer te geven met inachtneming van alle transformaties van de uitvoeringsboom:
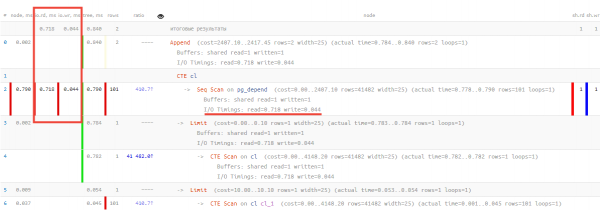
Hier kun je opmerken dat van de 0.790ms totale uitvoeringstijd 0.718ms werd besteed aan het lezen van één gegevenspagina, 0.044ms aan het schrijven ervan, en dat er voor alle andere nuttige activiteiten in totaal slechts 0.028ms werd besteed!
Toekomst met PostgreSQL 13
Je kunt een volledige overzicht van de nieuwe functies vinden , en wij kijken specifiek naar de veranderingen in de plannen.
Planning buffers
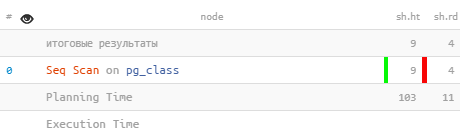
De rekening van de middelen die aan de planner zijn toegewezen, vond zijn weerslag in een andere patch die niet gerelateerd is aan pg_stat_statements. EXPLAIN met de optie BUFFERS zal het aantal buffers rapporteren dat is gebruikt tijdens de planningsfase:
 Seq Scan op pg_class (werkelijke rijen=386 loops=1)
   Buffers: gedeeld hit=9 gelezen=4
 Planningstijd: 0.782 ms
   Buffers: gedeeld hit=103 gelezen=11
 Uitvoeringstijd: 0.219 ms
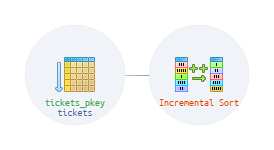
Incrementele sortering
In gevallen waar sortering op veel sleutels nodig is (k1, k2, k3…), kan de planner nu profiteren van de kennis dat de gegevens al zijn gesorteerd op enkele van de eerste sleutels (bijvoorbeeld k1 en k2). In dit geval is het niet nodig om alle gegevens opnieuw te sorteren, maar kunnen ze worden verdeeld in opeenvolgende groepen met dezelfde waarden k1 en k2, en vervolgens "doorgsorteren" op sleutel k3.
Op deze manier wordt de volledige sortering verdeeld in verschillende opeenvolgende sorteringen van kleinere omvang. Dit vermindert de benodigde geheugenhoeveelheid en maakt het mogelijk om de eerste gegevens eerder te geven dan dat de volledige sortering compleet is.
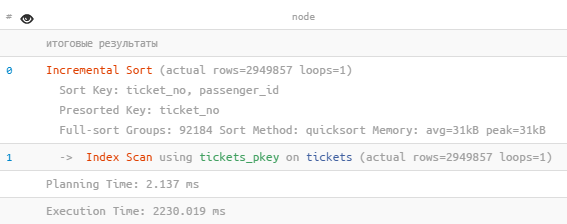
 Incrementele Sorte (werkelijke rijen=2949857 loops=1)
   Sorteersleutel: ticket_no, passagier_id
   Vooraf gesorteerde sleutel: ticket_no
   Volledige sorteer groepen: 92184 Sorteermethode: quicksort Geheugen: gemiddeld=31kB piek=31kB
   ->  Index Scan met gebruik van tickets_pkey op tickets (werkelijke rijen=2949857 loops=1)
 Planningsduur: 2.137 ms
 Uitvoeringsduur: 2230.019 ms
Verbeteringen UI/UX
Screenshots, ze zijn overal!
Nu is er op elk tabblad de mogelijkheid om snel een screenshot van het tabblad naar het klembord te nemen over de volle breedte en diepte van het tabblad — de "scope" rechtsboven:
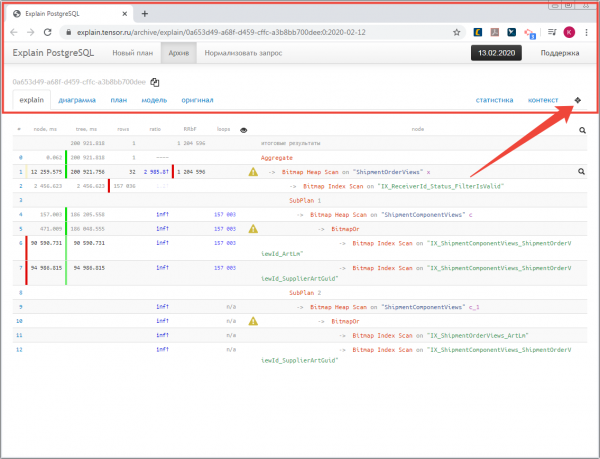
Eigenlijk zijn de meeste afbeeldingen voor deze publicatie precies zo verkregen.
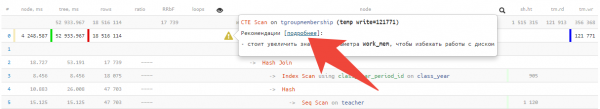
Aanbevelingen op de knooppunten
Ze zijn niet alleen talrijker geworden, maar ook van elke kan men , door de link te volgen:
Verwijderen uit het archief
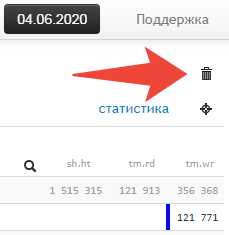
Sommigen vroegen echt om de mogelijkheid toe te voegen om "helemaal" te verwijderen zelfs niet-gepubliceerde plannen in het archief — alstublieft, druk gewoon op het juiste pictogram:
Nou, en vergeet niet dat we hebben , waar je je opmerkingen en suggesties kunt schrijven.
Bron: habr.com
