

Opdracht Wat betreft de tweede IT-gigant, hun ingenieur Rahul Bhatia van Clairvoyant over de verschillende bestandsformaten in big data, de meest voorkomende functies van Hadoop-formaten en welk formaat het beste is om te gebruiken.
Waarom verschillende bestandsformaten nodig zijn
Een ernstig knelpunt in de prestaties van applicaties die HDFS ondersteunen, zoals MapReduce en Spark, is de tijd voor het zoeken, lezen en schrijven van gegevens. Deze problemen worden verergerd door de uitdagingen in het beheer van grote datasets, vooral wanneer we te maken hebben met een evoluerend schema of beperkingen voor opslag.
De verwerking van big data verhoogt de belasting van het opslagsysteem – Hadoop slaat gegevens redundant op voor fouttolerantie. Naast schijven worden ook de CPU, netwerk, invoer/uitvoersystemen, en meer belast. Naarmate de hoeveelheid gegevens groeit, stijgen ook de kosten voor verwerking en opslag.
Verschillende bestandsformaten in zijn ontworpen om precies deze problemen op te lossen. De keuze voor het juiste bestandsformaat kan aanzienlijke voordelen opleveren:
- Snellere leessnelheid.
- Snellere schrijftijd.
- Deelbare bestanden.
- Ondersteuning voor schema-evolutie.
- Uitgebreide ondersteuning voor compressie.
Sommige bestandsformaten zijn bedoeld voor algemeen gebruik, terwijl andere meer specifieke gevallen dekken, en sommige zijn ontworpen met bepaalde kenmerken van gegevens in gedachten. De keuze is dus behoorlijk groot.
Bestandsformaat Avro
Voor gegevensserialisatie wordt veel gebruikt. Avro is een regelgebaseerd, dat wil zeggen een regelgebaseerd, opslagformaat voor gegevens in Hadoop. Het slaat het schema op in JSON-indeling, waardoor het eenvoudig door elke applicatie gelezen en geïnterpreteerd kan worden. De gegevens zelf worden opgeslagen in een binaire indeling, compact en efficiënt.
Het Avro-serialisatiesysteem is taalneutraal. Bestanden kunnen door verschillende talen worden verwerkt, momenteel zijn dat C, C++, C#, Java, Python en Ruby.
Een belangrijk kenmerk van Avro is de robuuste ondersteuning voor gegevensschema's die in de loop van de tijd veranderen, dat wil zeggen evolueren. Avro begrijpt schemawijzigingen – het verwijderen, toevoegen of wijzigen van velden.
Avro ondersteunt verschillende datastructuren. Bijvoorbeeld, een record kan een array, een enumeratietype en een subrecord bevatten.
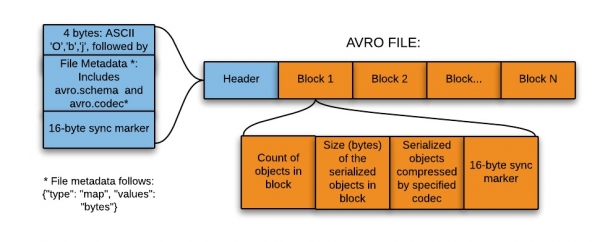
Dit formaat is perfect geschikt voor het schrijven naar de landing (transitie) zone van een data lake (, ofwel data lake - een verzameling instanties voor het opslaan van verschillende soorten gegevens, aanvullend op de gegevensbronnen).
Voor opname in het gegevensmeer is dit formaat het meest geschikt om de volgende redenen:
- Gegevens uit dit gebied worden meestal in zijn geheel gelezen voor verdere verwerking door downstream-systemen, en het op basis van rijen gebaseerde formaat is in dit geval efficiënter.
- Downstream-systemen kunnen gemakkelijk schema-tabellen uit bestanden extraheren - het is niet nodig om schema's apart op te slaan in een externe metadata-opslag.
- Elke wijziging in het oorspronkelijke schema kan eenvoudig worden afgehandeld (evolutie van het schema).
Parquet-bestandsformaat
Parquet is een open-source bestandsformaat voor Hadoop, dat geneste datastructuren opslaat in een plat kolomvormaat..
In vergelijking met de traditionele rijbenadering is Parquet efficiënter wat betreft opslag en prestaties.
Dit is vooral nuttig voor queries die bepaalde kolommen uit een brede (met veel kolommen) tabel lezen. Dankzij het bestandsformaat worden alleen de benodigde kolommen gelezen, zodat de input-output tot een minimum wordt beperkt.
Een kleine uitweiding: om het Parquet-bestandsformaat in Hadoop beter te begrijpen, laten we eens kijken naar wat een kolomgebaseerd - dat wil zeggen kolom- -formaat is. In dit formaat worden gelijksoortige waarden van elke kolom samen opgeslagen.
, de opname bevat de velden ID, Naam en Afdeling. In dit geval worden alle waarden van de ID-kolom samen opgeslagen, net als de waarden van de Naam-kolom, enzovoort. De tabel krijgt ongeveer dit uitzicht:
ID
Naam
Afdeling
1
emp1
d1
2
emp2
d2
3
emp3
d3
In het rijformaat worden de gegevens als volgt opgeslagen:
1
emp1
d1
2
emp2
d2
3
emp3
d3
In het kolomformaat worden dezelfde gegevens als volgt opgeslagen:
1
2
3
emp1
emp2
emp3
d1
d2
d3
Het kolomformaat is efficiënter wanneer u meerdere kolommen uit een tabel moet opvragen. Het leest alleen de benodigde kolommen, omdat deze naast elkaar zijn opgeslagen. Hierdoor wordt de input-output tot een minimum beperkt.
Bijvoorbeeld, als u alleen de kolom NAAM nodig heeft. In moet elke opname in de dataset worden geladen, worden ontleed in velden, en vervolgens worden de NAAM-gegevens geëxtraheerd. Het kolomformaat maakt het mogelijk om rechtstreeks naar de kolom Naam te gaan, omdat alle waarden voor deze kolom samen worden opgeslagen. U hoeft niet de hele opname te scannen.
Op deze manier verhoogt het kolomformaat de prestaties van zoekopdrachten, omdat er minder zoektijd nodig is om de vereiste kolommen te bereiken en het aantal invoer-/uitvoerbewerkingen wordt verminderd, aangezien alleen de benodigde kolommen worden gelezen.
Een van de unieke kenmerken is dat dit formaat gegevens met geneste structuren kan. Dit betekent dat in een Parquet-bestand zelfs geneste velden afzonderlijk kunnen worden gelezen zonder dat het nodig is om alle velden in de geneste structuur te lezen. Voor het opslaan van geneste structuren gebruikt Parquet het shredding- en assemblage-algoritme.
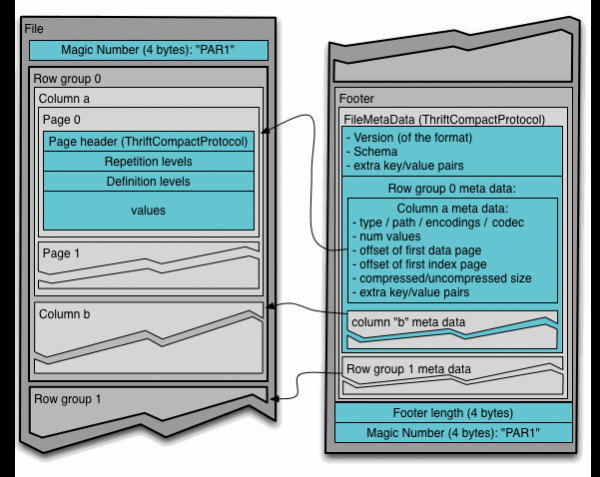
Om het Parquet-bestandsformaat in Hadoop te begrijpen, is het belangrijk om de volgende termen te kennen:
- Regelgroep (row group): een logische horizontale verdeling van gegevens over rijen. Een regelgroep bestaat uit een fragment van elke kolom in de dataset.
- Kolomfragment (column chunk): een fragment van een specifieke kolom. Deze kolomfragmenten bevinden zich in een bepaalde regelgroep en zijn gegarandeerd aangrenzend in het bestand.
- Pagina (page): kolomfragmenten worden verdeeld in pagina's die achtereenvolgens zijn geschreven. Pagina's hebben een gemeenschappelijke header, zodat onnodige pagina's kunnen worden overgeslagen tijdens het lezen.
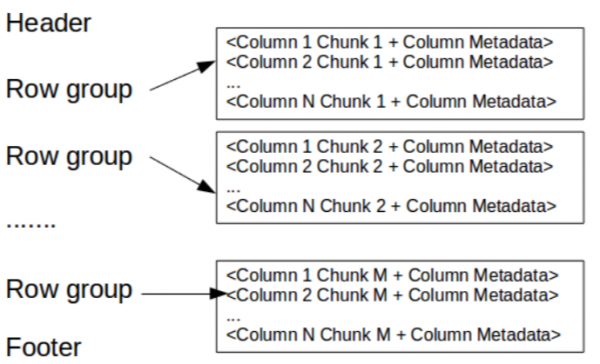
Hier bevat de header eenvoudigweg een magisch nummer PAR1 (4 bytes), dat het bestand identificeert als een Parquet-indeling.
In de footer zijn de volgende gegevens opgenomen:
- Bestandsmetadata die de startcoördinaten van de metadata voor elke kolom bevatten. Bij het lezen moeten eerst de metadata van het bestand worden gelezen om alle interessante kolomfragmenten te vinden. Vervolgens moeten de kolomfragmenten opeenvolgend worden gelezen. De metadata bevatten ook de versie van het formaat, het schema en eventuele extra sleutel-waardeparen.
- Lengte van de metadata (4 bytes).
- Magisch getal PAR1 (4 bytes).
Bestandsformaat ORC
Geoptimaliseerd rij-kolomformaat (Optimized Row Columnar, ) biedt een zeer efficiënte manier om gegevens op te slaan en is ontworpen om de beperkingen van andere formaten te overwinnen. Het slaat gegevens op in een perfect compacte vorm, waardoor onnodige details kunnen worden overgeslagen - zonder dat grote, complexe of handmatig te onderhouden indexen nodig zijn.
Voordelen van het ORC-formaat:
- Één bestand als output van elke taak, wat de belasting op de NameNode (namenode) vermindert.
- Ondersteuning voor Hive-gegevensindelingen, inclusief DateTime, decimale en complexe gegevensindelingen (struct, lijst, kaart en union).
- Gelijktijdige lezing van hetzelfde bestand door verschillende RecordReader-processen.
- Mogelijkheid om bestanden te splitsen zonder te scannen op markers.
- Beoordeling van de maximaal mogelijke heap-geheugentoewijzing voor lees-/schrijfbewerkingen op basis van informatie in de voettekst van het bestand.
- Metadata wordt opgeslagen in een binair Protocol Buffers-serieformaat, dat het mogelijk maakt om velden toe te voegen en te verwijderen.
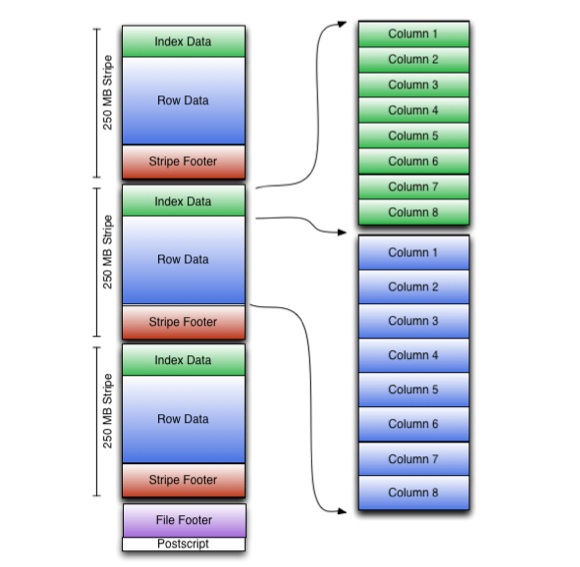
ORC slaat collecties van rijen in één bestand op, terwijl binnen de collectie de regelgegevens in kolomformaat worden opgeslagen.
Het ORC-bestand bevat groepen rijen, die stripes worden genoemd, en aanvullende informatie in de voettekst van het bestand. De postscript aan het einde van het bestand bevat compressieparameters en de grootte van de gecomprimeerde voettekst.
Standaard is de grootte van een stripe 250 MB. Door stripes van deze grote omvang wordt het lezen vanuit HDFS efficiënter uitgevoerd: in grote aaneengeschakelde blokken.
In de voettekst van het bestand staat een lijst van stripes in het bestand, het aantal rijen per stripe en het gegevenstype van elke kolom. Daarin staat ook de resulterende waarde van count, min, max en sum voor elke kolom.
De voettekst van een stripe bevat een catalogus van stroomspecificaties.
Regelinformatie wordt gebruikt bij het scannen van tabellen.
Indexgegevens bevatten minimale en maximale waarden voor elke kolom en de posities van rijen in elke kolom. ORC-indexen worden alleen gebruikt voor het selecteren van stripes en groepen rijen, niet voor het beantwoorden van vragen.
Vergelijking van verschillende bestandsindelingen
Avro vergeleken met Parquet
- Avro is een regel-gebaseerd opslagformaat, terwijl Parquet gegevens in kolommen opslaat.
- Parquet is beter geschikt voor analytische vragen, dat wil zeggen dat leesbewerkingen en gegevensverzoeken veel efficiënter zijn dan schrijven.
- Schrijfbewerkingen in Avro worden efficiënter uitgevoerd dan in Parquet.
- Avro is rijper in het omgaan met schema-evolutie. Parquet ondersteunt alleen het toevoegen van schema's, terwijl Avro multifunctionele evolutie implementeert, wat betekent dat er kolommen kunnen worden toegevoegd of gewijzigd.
- Parquet is ideaal voor het opvragen van een subset van kolommen in een multi-kolom tabel. Avro is geschikt voor ETL-bewerkingen, waar we alle kolommen opvragen.
ORC vergeleken met Parquet
- Parquet slaat geneste gegevens beter op.
- ORC is beter in staat om predicate pushdown te ondersteunen.
- ORC ondersteunt ACID-eigenschappen.
- ORC comprimeert gegevens beter.
Wat verder te lezen over dit onderwerp:
- .
- .
- .
Bron: habr.com
