

In het najaar van 2019 vond er een langverwachte gebeurtenis plaats in het iOS-team van Mail.ru Cloud. De belangrijkste database voor persistente opslag van de status van de applicatie werd een vrij exotische keuze voor de mobiele wereld. (LMDB). Hieronder bieden we een gedetailleerde beoordeling in vier delen. Laten we eerst bespreken waarom deze niet-triviale en moeilijke keuze gemaakt is. Vervolgens gaan we in op de drie pijlers van de LMDB-architectuur: geheugen-gemapped bestanden, B+-boom, en de copy-on-write benadering voor de implementatie van transacties en multi-versioning. Tenslotte, voor het praktische deel — we bekijken hoe je bovenop de low-level key-value API een schema met meerdere tabellen kunt ontwerpen en implementeren, inclusief indexering.
Inhoud
3.1.
3.2.
3.3.
4.1.
4.2.
4.3.
1. Motivatie voor implementatie
Een keer, rond 2015, maakten we ons zorgen over het meten van hoe vaak de interface van onze app haperde. We deden dit niet zonder reden. We kregen steeds meer klachten dat de app soms niet meer reageerde op gebruikersacties: knoppen konden niet worden ingedrukt, lijsten konden niet worden gescrold, enzovoort. Wat betreft de meetmechanica aan AvitoTech, dus hier vermeld ik alleen de cijfers.
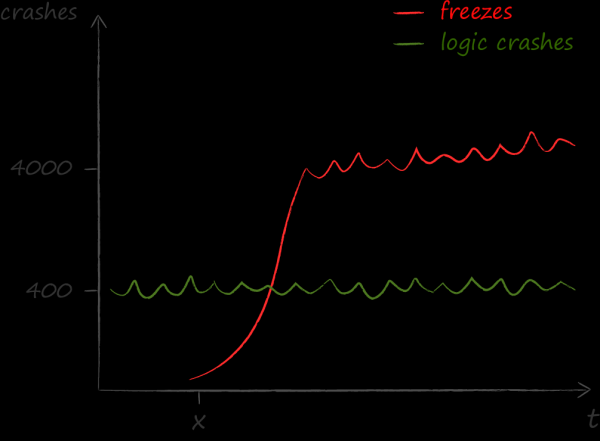
De resultaten van de metingen waren voor ons een koude douche. Het bleek dat er veel meer problemen door haperingen waren dan door andere factoren. Voordat we ons hiervan bewust werden, was de belangrijkste technische prestatie-indicator voor kwaliteit crashvrij zijn, maar na deze ontdekking verschoof de focus Door een
dashboard voor haperingen te bouwen kwantitatieve en twee threads een artikel op Habr. . In het kader van het huidige verhaal wil ik de aspecten van de oplossing benadrukken die invloed hebben gehad op de keuze voor de database.
Het actormodel voor het organiseren van het systeem houdt in dat multi-threading zijn tweede natuur wordt. De objecten in dit model houden ervan om grenzen van threads te overschrijden. En dat doen ze niet af en toe en op bepaalde plekken, maar vrijwel constant en overal.
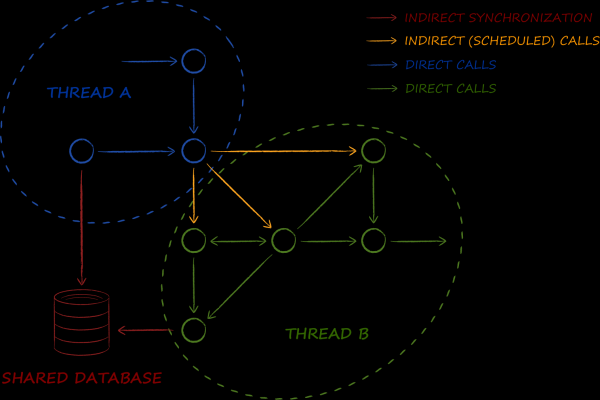
De database is een van de hoekstenen in het gepresenteerde schema. De belangrijkste taak is de implementatie van het macro-patroon . Als in de enterprise-wereld hiermee de synchronisatie van gegevens tussen services wordt georganiseerd, dan is het in het geval van de actor-architectuur gegevens tussen threads. Daarom hadden we een database nodig die in een multi-threading omgeving geen minimale complicaties met zich meebrengt. Dit betekent in het bijzonder dat de objecten die eruit komen ten minste thread-veilig moeten zijn, en idealiter volledig immutable. Zoals bekend kunnen de laatsten gelijktijdig uit meerdere threads worden gebruikt, zonder enige vorm van locking, wat een positieve invloed heeft op de prestaties.
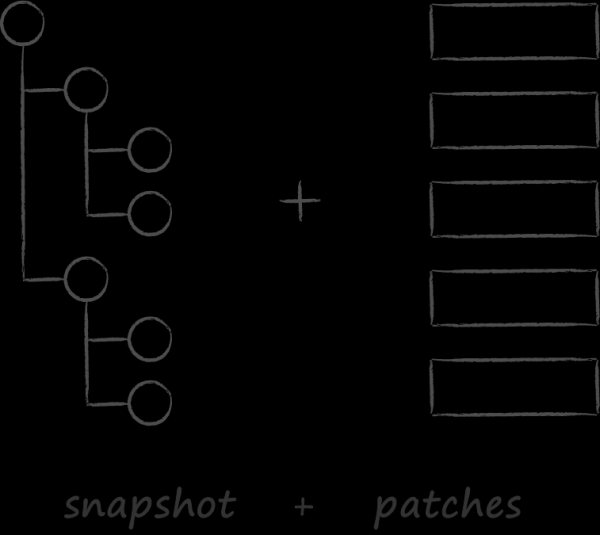 Een tweede belangrijke factor die de keuze voor de database heeft beïnvloed, is onze cloud API. Het was geïnspireerd door de benadering van synchronisatie die door git is omarmd. Net als hij mikten we op , wat voor cloudklanten meer dan passend lijkt. Er werd aangenomen dat ze slechts één keer de volledige status van de cloud zouden downloaden, en dat de synchronisatie in de overgrote meerderheid van de gevallen zou plaatsvinden via het aanbrengen van wijzigingen. Helaas bevindt deze mogelijkheid zich nog steeds in de theoretische zone, en in de praktijk hebben klanten nog steeds niet geleerd om met patches te werken. Er zijn verschillende objectieve redenen voor, die we, om inleiding niet te verlengen, achterwege zullen laten. Op dit moment zijn de leerzame lessen van wat er gebeurt wanneer de API 'A' zegt, maar de consument niet 'B' zegt, aanzienlijk interessanter.
Stel je voor dat als je een git-commando uitvoert, bij een pull in plaats van patches toe te passen op een lokale snapshot, het de volledige status vergelijkt met die van de server. Dit geeft je een redelijk goed beeld van hoe de synchronisatie in cloudclients plaatsvindt. Het is niet moeilijk te raden dat hiervoor in het geheugen twee DOM-bomen met metadata over alle server- en lokale bestanden moeten worden toegewezen. Dus als een gebruiker 500.000 bestanden in de cloud opslaat, moeten er twee bomen met in totaal 1 miljoen knopen worden gerecreëerd en vernietigd voor synchronisatie. Elke knoop is immers een aggregaat die een grafiek van subobjecten bevat. In dit licht zijn de resultaten van de profilering te verwachten. Het bleek dat zelfs zonder rekening te houden met de algoritmiek van de samenvoeging, de procedure voor het creëren en vervolgens vernietigen van een enorm aantal kleine objecten al veel kosten met zich meebrengt. De situatie wordt verergerd doordat de basisoperatie van synchronisatie is opgenomen in tal van gebruikersscenario’s. Als resultaat stellen we een tweede belangrijke criterium vast bij de keuze van een database - de mogelijkheid om CRUD-operaties uit te voeren zonder dynamische toewijzing van objecten.
De andere vereisten zijn meer traditioneel en de volledige lijst ziet er als volgt uit.
- Draadveiligheid.
- Multiprocessing. Dit is gedicteerd door de wens om dezelfde database-instantie te gebruiken voor synchronisatie van status niet alleen tussen threads, maar ook tussen de hoofdapplicatie en iOS-extensies.
- De mogelijkheid om opgeslagen entiteiten voor te stellen als onveranderlijke objecten.
- Afwezigheid van dynamische toewijzingen tijdens CRUD-operaties.
- Ondersteuning van transacties voor basisattributen : atomiciteit, consistentie, isolatie en betrouwbaarheid.
- Snelheid bij de meest populaire use cases.
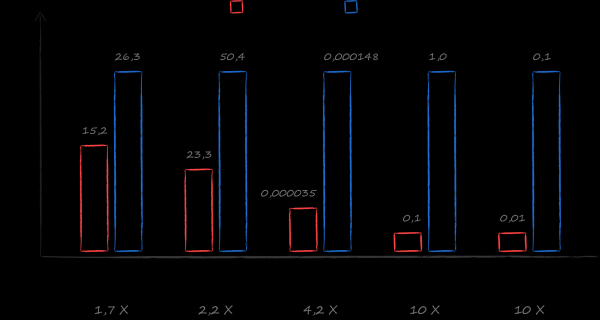
Een goede keuze met deze set vereisten is en blijft SQLite. Tijdens het onderzoeken van alternatieven kwam ik echter een boek tegen . Onder haar leiding werd een benchmark geschreven die de snelheid van verschillende databases vergeleek binnen echte cloudscenario's. Het resultaat overtrof de meest optimistische verwachtingen. Bij de meest populaire use cases — het verkrijgen van een cursor op een gesorteerde lijst van alle bestanden en een gesorteerde lijst van alle bestanden voor een bepaalde directory — bleek LMDB 10 keer sneller te zijn dan SQLite. De keuze werd voor de hand liggend.
2. Positionering van LMDB
LMDB is een bibliotheek, zeer klein (slechts 10K regels), die de allerbasislaag van databases implementeert — een opslag.
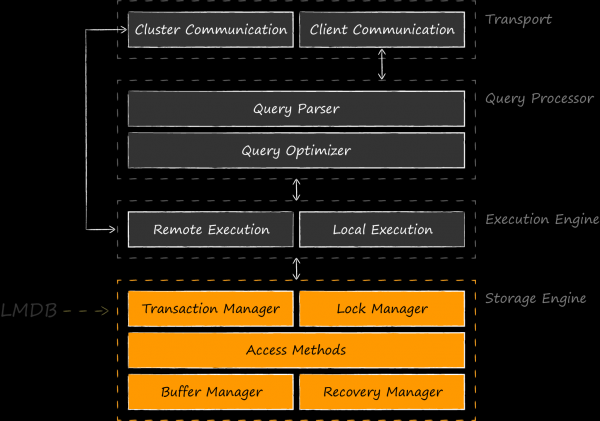
Het schema laat zien dat het niet helemaal correct is om LMDB met SQLite te vergelijken, dat ook hogere niveaus implementeert, net zoals het niet helemaal correct is om SQLite met Core Data te vergelijken. Het zou eerlijker zijn om vergelijkbare opslagmotoren — BerkeleyDB, LevelDB, Sophia, RocksDB, enz. — als gelijkwaardige concurrenten te noemen. Er zijn zelfs ontwikkelingen waarin LMDB als component van de opslagmotor voor SQLite fungeert. De eerste zo'n experiment vond in 2012 plaats. door de auteur van LMDB . bleken zo intrigerend te zijn dat zijn initiatieven werden opgepakt door OSS-enthousiasten en voortgezet in de vorm van . In januari 2020 presenteerde de auteur van dit project, Den Shearer, LinuxConfAu.
De belangrijkste toepassing van LMDB is als engine voor toepassingsdatabases. De bibliotheek is ontstaan dankzij de ontwikkelaars van , die zeer ontevreden waren over BerkeleyDB als basis voor hun project. Vertrekkend vanuit de bescheiden bibliotheek , kon Howard Chu een van de populairste alternatieven van deze tijd creëren. Deze geschiedenis en de interne werking van LMDB wijdde hij zijn geweldige lezing . Een goed voorbeeld van opslagoverwinning werd gedeeld door Leonid Yuriev (ook bekend als ) van Positive Technologies in zijn lezing op Highload 2015 . Hierin bespreekt hij LMDB in de context van een soortgelijke opdracht om ReOpenLDAP te implementeren, terwijl LevelDB onderhevig was aan vergelijkende kritiek. Als gevolg van de implementatie ontstond er bij Positive Technologies zelfs een actieve fork met zeer aantrekkelijke functies, optimalisaties en .
LMDB wordt ook vaak gebruikt als opslag as is. Bijvoorbeeld, de browser Mozilla Firefox het voor een aantal doeleinden, en vanaf versie 9 heeft Xcode SQLite voor het opslaan van indexen.
De engine heeft zich ook binnen de wereld van mobiele ontwikkeling bewezen. Sporen van het gebruik ervan zijn in de iOS-client voor Telegram. LinkedIn is nog verder gegaan en heeft LMDB als standaard opslag gekozen voor het zelfontworpen datacachingframework Rocket Data, waarover in zijn artikel in 2016 werd geschreven.
LMDB strijdt succesvol om een plaats onder de zon in de niche die door BerkeleyDB is achtergelaten na de overname door Oracle. De bibliotheek wordt gewaardeerd om zijn snelheid en betrouwbaarheid, zelfs in vergelijking met soortgelijke systemen. Zoals bekend, zijn er geen gratis lunches, en het is belangrijk om de trade-off te benadrukken die je tegenkomt bij de keuze tussen LMDB en SQLite. De bovenstaande schema's tonen duidelijk aan hoe de verhoogde snelheid wordt bereikt. Ten eerste betalen we niet voor extra abstractielaag bovenop de schijflocatie. Het is duidelijk dat, in een goede architectuur, we niet zonder die lagen kunnen, en ze zullen onvermijdelijk in de code van de applicatie verschijnen, maar ze zullen veel dunner zijn. Ze zullen geen functies bevatten die niet door de specifieke applicatie worden gevraagd, zoals ondersteuning voor SQL-querytalen. Ten tweede wordt het mogelijk om applicatieoperaties optimaal te mappen naar verzoeken aan het schijfsysteem. Terwijl SQLite uitgaat van de gemiddelde behoeften van een gemiddelde applicatie, ben je als applicatieontwikkelaar goed op de hoogte van de belangrijkste belastingscenario's. Voor een meer prestatiegerichte oplossing moet je betalen met hogere kosten, zowel voor de ontwikkeling van de initiële oplossing als voor het latere onderhoud ervan.
3. Drie pijlers van LMDB
Na een globaal overzicht van LMDB is het tijd om dieper te duiken. De volgende drie secties zijn gewijd aan het bespreken van de belangrijkste pijlers waarop de architectuur van de opslag is gebaseerd:
- Geheugengehechte bestanden als mechanisme voor schijfwerking en synchronisatie van interne datastructuren.
- B+-boom als organisatie van de structuur van opgeslagen gegevens.
- Copy-on-write als aanpak voor het waarborgen van ACID-eigenschappen van transacties en multiversioning.
3.1. Pijler №1. Geheugengehechte bestanden
De in het geheugen weergegeven bestanden zijn zo'n belangrijk architectonisch element dat ze zelfs in de naam van de opslag voorkomen. Vragen over caching en synchronisatie van toegang tot de opgeslagen informatie worden volledig aan het besturingssysteem overgelaten. LMDB bevat geen caches. Dit is een bewust besluit van de auteur, omdat het lezen van gegevens rechtstreeks uit de weergegeven bestanden vele hoeken in de implementatie van de engine kan snijden. Hieronder volgt een zeker niet uitputtende lijst van enkele van deze aspecten.
- Het handhaven van gegevensconsistentie in de opslag bij toegang vanuit meerdere processen wordt de verantwoordelijkheid van het besturingssysteem. In de volgende sectie wordt deze mechaniek gedetailleerd en met afbeeldingen besproken.
- De afwezigheid van caches elimineert volledig de overhead van dynamische toewijzingen. Het lezen van gegevens komt in de praktijk neer op het installeren van een pointer op het juiste adres in het virtuele geheugen en niet meer. Het klinkt als fantasie, maar in de bronbestanden van de opslag zijn alle aanroepingen van calloc geconcentreerd in de configuratiefunctie van de opslag.
- De afwezigheid van caches betekent ook de afwezigheid van vergrendelingen die met de synchronisatie van hun toegang samenhangen. Lezers, van wie er gelijktijdig een willekeurig aantal kan bestaan, stuiten op hun weg naar gegevens op geen enkele mutex. Hierdoor heeft het lezen een perfecte lineaire schaalbaarheid met het aantal CPU's. In LMDB zijn alleen de modificerende bewerkingen onderworpen aan synchronisatie. Er kan op elk moment maar één schrijver zijn.
- Minimaal cache- en synchronisatielogica voorkomt dat de code zeer complexe fouten vertoont die verband houden met werken in een multithread-omgeving. Op de Usenix OSDI 2014-conferentie waren er twee interessante studies over databases: en . Daaruit kan men informatie halen over zowel de ongeëvenaard betrouwbaarheid van LMDB als de praktisch onberispelijke implementatie van de ACID-eigenschappen van transacties, die deze in SQLite overtreft.
- De minimalistische aard van LMDB stelt het machine-leesbare deel van de code in staat om volledig in de L1-cache van de processor te passen, met de daaruit voortvloeiende snelheidseigenschappen.
Helaas is het met in het geheugen opgeladen bestanden op iOS niet zo rooskleurig als we zouden willen. Om de bijbehorende tekortkomingen beter te begrijpen, moeten we de algemene principes van de implementatie van dit mechanisme in besturingssystemen herinneren.
Algemene informatie over in het geheugen opgeladen bestanden
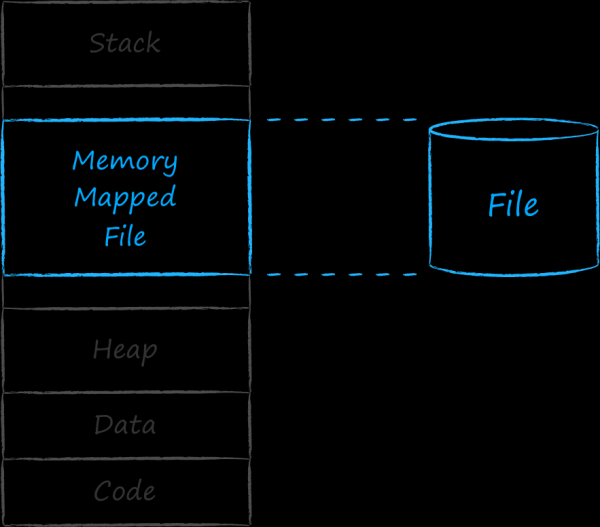 Met elk uitvoerbaar programma associeert het besturingssysteem een entiteit genaamd een proces. Aan elk proces wordt een aaneengeschakeld adresbereik toegewezen, waarin het alles plaatst wat nodig is voor zijn werking. In de laagste adressen bevinden zich secties met code en hardgecodeerde gegevens en bronnen. Daarboven bevindt zich een oplopende blok van dynamische adresruimte, die we beter kennen als de heap. Hierin staan de adressen van entiteiten die tijdens de uitvoering van het programma verschijnen. Bovenaan bevindt zich het geheugengebied dat door de stack van de toepassing wordt gebruikt. Dit groeit en krimpt, met andere woorden, zijn grootte heeft ook een dynamische aard. Om ervoor te zorgen dat de stack en de heap elkaar niet in de weg zitten, zijn ze aan de tegenovergestelde uiteinden van de adresruimte geplaatst. Tussen de twee dynamische secties, boven en onder, is er een gat. De adressen in dit middelste stuk worden door het besturingssysteem gebruikt om verschillende entiteiten aan het proces te associëren. In het bijzonder kan het een aaneengeschakelde reeks adressen toewijzen aan een bestand op de schijf. Dit bestand wordt een in het geheugen opgeladen bestand genoemd.
De toegewezen adresruimte voor het proces is enorm. Theoretisch is het aantal adressen slechts beperkt door de grootte van de pointer, die wordt bepaald door de bitheid van het systeem. Als fysieke geheugen 1-op-1 zou worden toegewezen, zou het eerste proces al het RAM opslokken en zou multitasking geen optie zijn.
Echter, uit onze ervaring weten we dat moderne besturingssystemen tegelijkertijd een onbeperkt aantal processen kunnen uitvoeren. Dit is mogelijk omdat ze alleen op papier een enorme hoeveelheid geheugen aan processen toewijzen, terwijl ze in werkelijkheid alleen die delen in het fysieke geheugen laden die hier en nu nodig zijn. Daarom wordt het geheugen dat aan een proces is geassocieerd, virtueel genoemd.
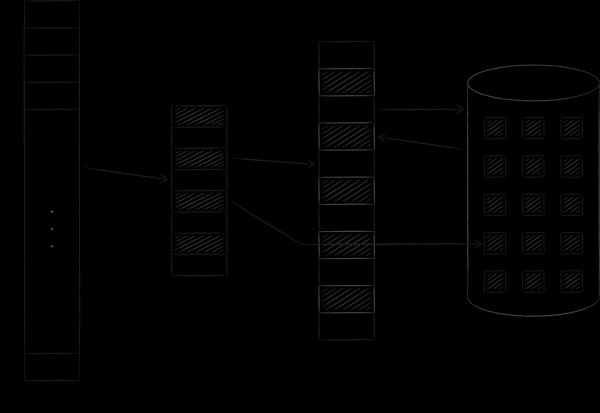
Het besturingssysteem organiseert virtueel en fysiek geheugen in pagina's van een bepaalde grootte. Zodra een bepaalde pagina van virtueel geheugen wordt opgeroepen, laadt het besturingssysteem deze in fysiek geheugen en legt het een overeenkomst vast in een speciale tabel. Als er geen vrije slots beschikbaar zijn, wordt een van de eerder geladen pagina's naar de schijf gekopieerd, terwijl de opgeroepen pagina deze plek inneemt. Deze procedure, waar we binnenkort op terugkomen, wordt swapping genoemd. De afbeelding hieronder illustreert het beschreven proces. Hierin is pagina A met adres 0 geladen en geplaatst op de hoofdmemorypagina met adres 4. Dit feit wordt weerspiegeld in de overeenkomtabel in cel nummer 0.
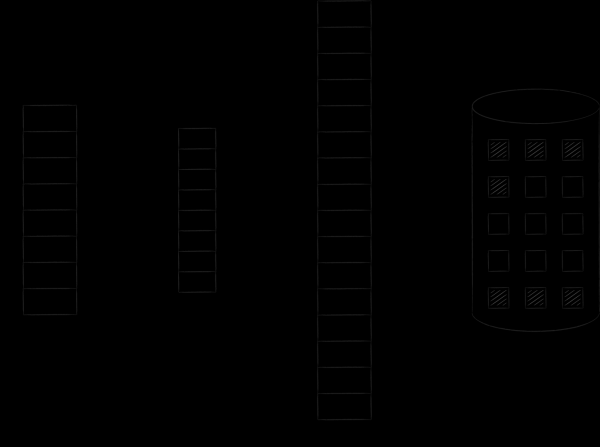
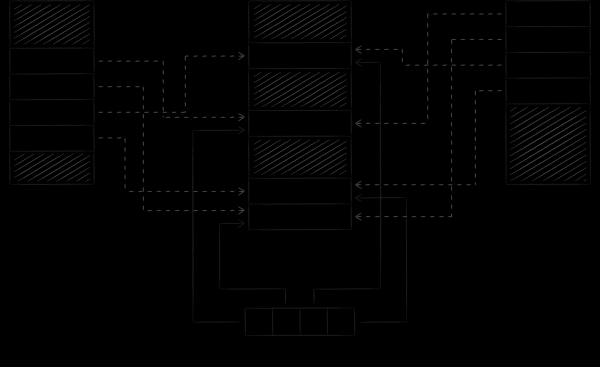
Met de in geheugen weergegeven bestanden is de historie precies dezelfde. Logisch gezien worden ze zogenaamd continu en volledig geplaatst in de virtuele adresruimte. Echter, ze komen pagina voor pagina in het fysieke geheugen binnen en alleen op verzoek. De aanpassing van deze pagina's wordt gesynchroniseerd met het bestand op de schijf. Op deze manier kan men bestand in/output uitvoeren door simpelweg met bytes in geheugen te werken – alle wijzigingen worden automatisch door de kernel van het besturingssysteem naar het oorspronkelijke bestand overgebracht.
De afbeelding hieronder toont hoe LMDB zijn toestand synchroniseert bij het werken met een database vanuit verschillende processen. Door de virtuele geheugens van verschillende processen naar hetzelfde bestand te mappen, verplichten we het besturingssysteem de bepaalde blokken van hun adresruimten transitief te synchroniseren, waar LMDB naar kijkt.
Een belangrijk punt is dat LMDB standaard het gegevensbestand wijzigt via de systeemaanroep write, terwijl het bestand zelf in read-only modus wordt weergegeven. Deze aanpak heeft twee belangrijke gevolgen.
Het eerste gevolg is algemeen voor alle besturingssystemen. Het gaat erom bescherming toe te voegen tegen onopzettelijke beschadiging van de database door incorrecte code. Zoals bekend, kunnen uitvoerbare instructies van een proces vrij toegang krijgen tot gegevens vanuit elke locatie in hun adresruimte. Tegelijkertijd betekent het, zoals we zojuist hebben vermeld, dat het weergeven van een bestand in read-write modus betekent dat elke instructie het ook kan modificeren. Als het dit per ongeluk doet, bijvoorbeeld door te proberen een array-element op een niet-bestaande index te herschrijven, kan het per ongeluk het bestand dat op dit adres is gemapt wijzigen, wat kan leiden tot databasacorruptie. Als het bestand echter in read-only modus is weergegeven, zal een poging om de bijbehorende adresruimte te wijzigen leiden tot een crash van het programma met een signaal SIGSEGV, en het bestand blijft intact.
Het tweede gevolg is specifiek voor iOS. Noch de auteur, noch andere bronnen vermelden dit expliciet, maar zonder dit zou LMDB ongeschikt zijn voor gebruik in dit mobiele besturingssysteem. De volgende sectie is gewijd aan deze beschouwing.
De specificiteit van geheugen-gemapte bestanden in iOS
Tijdens WWDC 2018 was er een geweldige presentatie . Hierin wordt uitgelegd dat in iOS alle pagina's die zich in het fysieke geheugen bevinden, tot een van de 3 types behoren: dirty, compressed en clean.
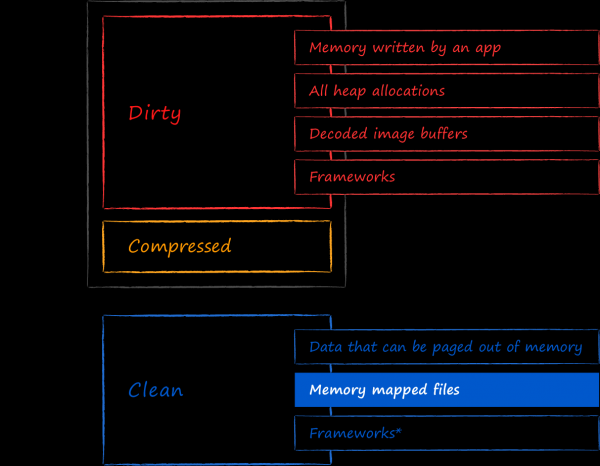
Clean memory is de verzameling pagina's die zonder problemen uit het fysieke geheugen kunnen worden verwijderd. De gegevens daarin kunnen indien nodig opnieuw uit hun oorspronkelijke bronnen worden geladen. Read-only memory-mapped bestanden vallen precies in deze categorie. iOS is niet bang om op elk moment geheugen-gemapte pagina's uit geheugen te verwijderen, aangezien ze gegarandeerd gesynchroniseerd zijn met het bestand op de schijf.
In dirty memory vallen alle gewijzigde pagina's, ongeacht waar ze oorspronkelijk waren. In het bijzonder zullen ook memory-mapped bestanden die zijn gewijzigd door het schrijven naar de bijbehorende virtuele geheugen, op deze manier worden gecategoriseerd. Door LMDB te openen met de vlag MDB_WRITEMAP, kan men dit persoonlijk bevestigen na de aanpassingen.
Zodra een applicatie te veel fysieke geheugenruimte in beslag neemt, ondergaat iOS een compressie van de dirty pagina's. De totale hoeveelheid geheugen, die door dirty en gecomprimeerde pagina's wordt gebruikt, vormt de zogenaamde memory footprint van de applicatie. Zodra dit een bepaalde drempelwaarde bereikt, komt er een systeemdaemon, de OOM killer, en beëindigt het proces. Dit is een bijzonderheid van iOS in vergelijking met desktop besturingssystemen. In tegenstelling tot hen is het verlagen van de memory footprint door pagina's van fysiek geheugen naar schijf te swappen niet voorzien in iOS. De redenen hiervoor zijn speculatief. Mogelijk is de procedure van het intensief verplaatsen van pagina's naar de schijf en terug te energiekosten voor mobiele apparaten, of bespaart iOS de herhaalde schrijfcyclus op SSD's, of wellicht waren de ontwerpers niet tevreden met de algehele prestatie van het systeem, waar alles constant wordt geswapt. Hoe dan ook, het blijft een feit.
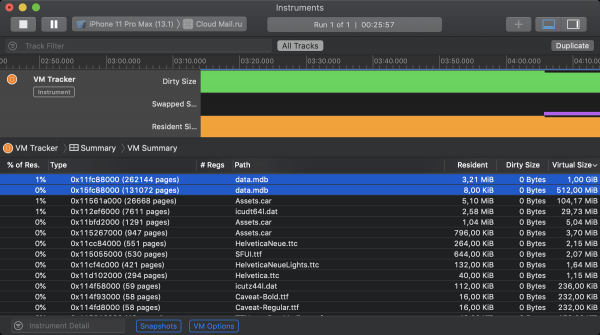
Het goede nieuws, zoals eerder vermeld, is dat LMDB standaard geen mmap-mechanisme gebruikt voor het bijwerken van bestanden. Dit betekent dat de weergegeven gegevens door iOS worden geclassificeerd als clean memory en geen bijdrage leveren aan de memory footprint. Dit kan worden bevestigd met behulp van een Xcode-tool genaamd VM Tracker. Op de onderstaande screenshot staat de status van het virtuele geheugen van de iOS-applicatie Cloud tijdens het gebruik. Bij de start waren er 2 instanties van LMDB geïnitialiseerd. De eerste kreeg toestemming om zijn bestand op 1GiB virtueel geheugen weer te geven, de tweede op 512MiB. Ondanks dat beide opslagplaatsen een bepaald volume residentieel geheugen in beslag nemen, draagt geen van beiden bij aan de dirty size.
En nu is het tijd voor slecht nieuws. Dankzij het swappen in 64-bits desktop besturingssystemen kan elk proces zoveel virtuele adresruimte innemen als de vrije schijfruimte toelaat voor zijn potentiële swap. Het vervangen van swappen door compressie in iOS verlaagt de theoretische maximum drastisch. Nu moeten alle actieve processen in het hoofdgeheugen passen (lees: RAM), en alle processen die niet passen, moeten geforceerd worden beëindigd. Dit wordt ook vermeld in het bovenstaande. , alsook in Als gevolg hiervan beperkt iOS strikt de hoeveelheid geheugen die beschikbaar is voor toewijzing via mmap. Dat is. Je kunt de empirische grenzen van het geheugen bekijken dat is toegewezen aan verschillende apparaten met behulp van deze systeemoproep. Op de nieuwste iPhone-modellen zijn er 2 gigabyte beschikbaar gesteld, terwijl de topmodellen van de iPad 4 gigabyte krijgen. In de praktijk moet je echter rekening houden met de meest basismodellen van apparaten, waar het er heel somber uitziet. Nog verergerend is dat wanneer je de status van het geheugen van de applicatie in de VM Tracker bekijkt, je kunt ontdekken dat LMDB niet de enige is die aanspraak maakt op gemapt geheugen. Goede delen worden opgeëist door systeemallocators, bestanden met middelen, afbeeldingswerkframeworks en andere kleinere roofdieren.
Na de experimenten in de Cloud kwamen we tot de volgende compromiswaarden voor de toegewezen LMDB-geheugen: 384 megabyte voor 32-bits apparaten en 768 megabyte voor 64-bits apparaten. Na het verbruiken van deze hoeveelheid beginnen alle wijzigingsoperaties te eindigen met de code MDB_MAP_FULL. Dergelijke fouten zien we in onze monitoring, maar ze zijn zo zeldzaam dat ze op dit moment genegeerd kunnen worden.
Een onopvallende oorzaak van overmatig geheugengebruik door de opslag kan komen door langdurige transacties. Om te begrijpen hoe deze twee verschijnselen met elkaar verband houden, helpt het om naar de overige twee pijlers van LMDB te kijken.
3.2. Pijler nr. 2. B+-boom
Om tabellen bovenop de key-value opslag te emuleren, moeten de volgende bewerkingen in de API aanwezig zijn:
- Invoegen van een nieuw element.
- Zoeken naar een element met een gegeven sleutel.
- Verwijderen van een element.
- Itereren over sleutelintervallen in volgorde van sortering.
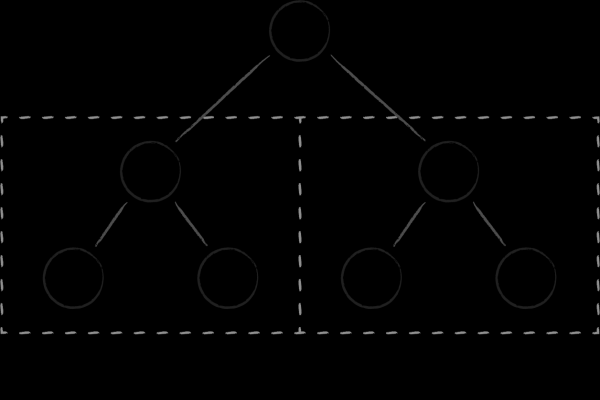 De eenvoudigste datastructuur waarmee je gemakkelijk alle vier de operaties kunt implementeren, is de binaire zoekboom. Elke knoop vertegenwoordigt een sleutel, die het hele subset van dochtersleutels in twee subbomen splitst. In de linkerboom zijn die sleutels die kleiner zijn dan de ouder, en in de rechterboom die groter zijn. Het verkrijgen van een geordende set sleutels wordt bereikt door een van de klassieke boomdoorlopen.
Binaire bomen hebben twee fundamentele tekortkomingen die hen inefficiënt maken als opslagstructuur voor gegevens. Ten eerste is de mate van hun balans onvoorspelbaar. Er is een aanzienlijke kans om bomen te krijgen waarvan de hoogte van verschillende takken sterk kan verschillen, wat de algoritmische complexiteit van het zoeken aanzienlijk verslechtert in vergelijking met wat wordt verwacht. Ten tweede veroorzaakt de overvloed aan kruisverwijzingen tussen knooppunten dat binaire bomen hun geheugenlocaliteit verliezen. Dichte knooppunten (in termen van verbindingen tussen hen) kunnen zich op totaal verschillende pagina's in het virtuele geheugen bevinden. Het gevolg is dat zelfs voor een eenvoudige doorloop van enkele naburige knooppunten in de boom een vergelijkbaar aantal pagina's moet worden bezocht. Dit is een probleem, zelfs als we de efficiëntie van binaire bomen als in-memory gegevensstructuur overwegen, omdat de constante rotatie van pagina's in de cache van de processor een dure aangelegenheid is. Wanneer het echter gaat om het vaak ophalen van de pagina's die aan knooppunten zijn gekoppeld vanaf de schijf, wordt de situatie helemaal .
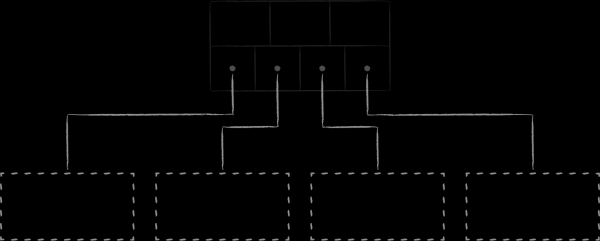 B-bomen, als een evolutie van binaire bomen, lossen de in de vorige alinea beschreven problemen op. Ten eerste zijn ze zelfbalancerend. Ten tweede splitst elk van hun knooppunten een set van dochtersleutels niet in 2, maar in M geordende subsets, waarbij het aantal M behoorlijk groot kan zijn, van enkele honderden tot zelfs duizenden.
Hierdoor:
- Bevinden er zich in elk knooppunt een groot aantal reeds geordende sleutels, waardoor de bomen erg laag worden.
- De boom krijgt de eigenschap van geheugenspecificiteit, omdat dicht bij elkaar liggende sleutels op natuurlijke wijze dicht bij elkaar op één of aangrenzende knooppunten worden geplaatst.
- Het aantal transitieve knooppunten neemt af tijdens het afdalen in de boom tijdens de zoekoperatie.
- Het aantal te lezen doelknooppunten bij range-aanvragen neemt af, omdat elk van hen al een groot aantal geordende sleutels bevat.
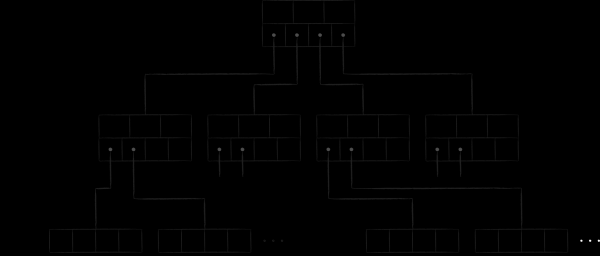
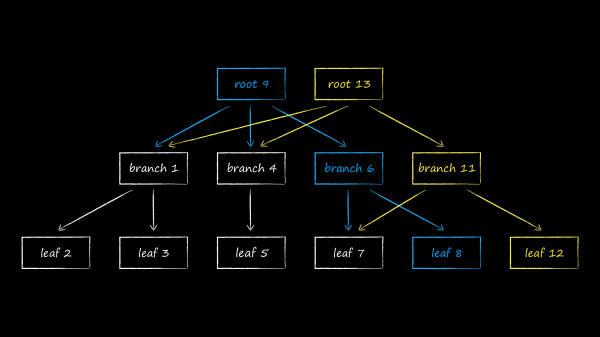
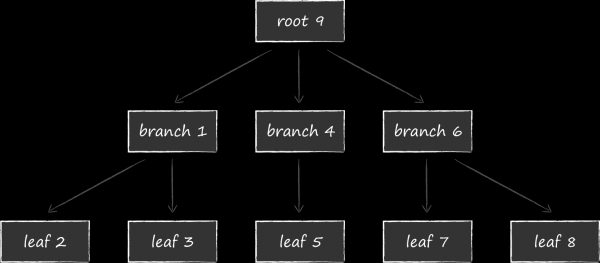
In LMDB wordt een van de varianten van de B-boom gebruikt, genaamd B+-boom. In het bovenstaande diagram staan drie soorten knooppunten die erin voorkomen:
- Aan de top bevindt zich de root. Deze vertegenwoordigt niets minder dan het concept van een database binnen de opslag. Binnen één LMDB-instantie kunnen meerdere databases worden aangemaakt, die een gemapt virtueel adresruimte delen. Elke database begint met zijn eigen root.
- Op het laagste niveau bevinden zich de bladeren. Zij zijn de enigen die de opgeslagen sleutel-waarde paren in de database bevatten. Dit is de specifieke eigenschap van B+-bomen. Waar een gewone B-boom de value-componenten opslaat in knooppunten op alle niveaus, doet de B+-variatie dit alleen op het laagste niveau. Dit feit vastleggend, zullen we deze subtype van de boom die in LMDB wordt gebruikt, eenvoudigweg een B-boom noemen.
- Tussen de root en de bladeren bevinden zich 0 of meer technische niveaus met navigatieknopen. Hun taak is om de gesorteerde set van sleutels tussen de bladeren te verdelen.
Fysiek zijn de knooppunten geheugenblokken van een vooraf gedefinieerde lengte. Hun grootte is een veelvoud van de pagina-grootte in het besturingssysteem, waar we eerder over spraken. Hieronder is de structuur van een knooppunt weergegeven. In de header bevindt zich metadata, waarvan de meest voor de hand liggende bijvoorbeeld de controle som is. Vervolgens komt informatie over de offsets waar de datacellen zich bevinden. In de rol van gegevens kunnen ofwel sleutels optreden, als we het hebben over navigatieknopen, of volledig sleutel-waarde paren in het geval van bladeren. Meer informatie over de structuur van pagina's kan in het werk worden gelezen. .
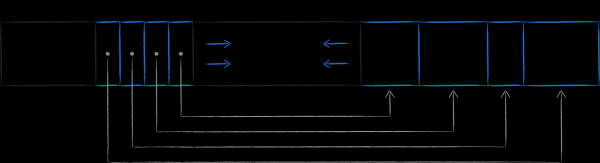
Na het begrijpen van de interne samenstelling van de knooppuntpagina's, zullen we de B-boom van LMDB vereenvoudigd voorstellen in de volgende vorm.
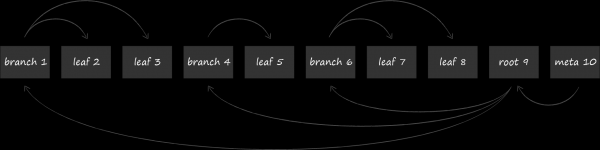
De pagina's met knooppunten zijn opeenvolgend op de schijf geplaatst. Pagina's met een hoger nummer bevinden zich dichter bij het einde van het bestand. De zogenaamde metapagina bevat informatie over de offsets waarlangs de roots van alle bomen gevonden kunnen worden. Bij het openen van een LMDB-bestand scant deze pagina voor pagina het bestand van einde naar begin om een geldige metapagina te vinden en vindt vervolgens via deze metapagina de bestaande databases.
Nu je een inzicht hebt in de logische en fysieke structuur van de gegevensorganisatie, kunnen we doorgaan naar de bespreking van de derde pijler van LMDB. Dit is namelijk hoe alle aanpassingen aan de opslag transactioneel en geïsoleerd van elkaar plaatsvinden, waardoor de database als geheel ook een eigenschap van multi-versioning krijgt.
3.3. Pijler №3. Copy-on-write
Sommige bewerkingen met de B-boom vereisen een serie wijzigingen in de knooppunten. Een voorbeeld hiervan is het toevoegen van een nieuwe sleutel aan een knooppunt dat al zijn maximale capaciteit heeft bereikt. In dit geval is het nodig om eerst het knooppunt in tweeën te splitsen en vervolgens een verwijzing naar de nieuw afgetakte kindknoop aan de ouder toe te voegen. Deze procedure is potentieel zeer gevaarlijk. Als om welke reden dan ook (crash, stroomuitval, enz.) slechts een deel van de wijzigingen in de reeks plaatsvindt, blijft de boom in een inconsistente toestand.
Een van de traditionele oplossingen voor het waarborgen van data-integriteit bij een storing is het toevoegen van een aanvullende schijfstructuur naast de B-boom - een transactielog, ook bekend als de write-ahead log (WAL). Dit is een bestand waarin de verwachte bewerking strikt vóór de modificatie van de B-boom wordt genoteerd. Als tijdens zelfdiagnose gegevensbeschadiging wordt vastgesteld, raadpleegt de database het logboek om zichzelf weer in orde te brengen.
LMDB heeft een andere methode gekozen voor foutbestendigheid, die copy-on-write wordt genoemd. Het idee is dat in plaats van gegevens op een bestaande pagina bij te werken, de pagina eerst volledig wordt gekopieerd en alle wijzigingen in die kopie worden doorgevoerd.
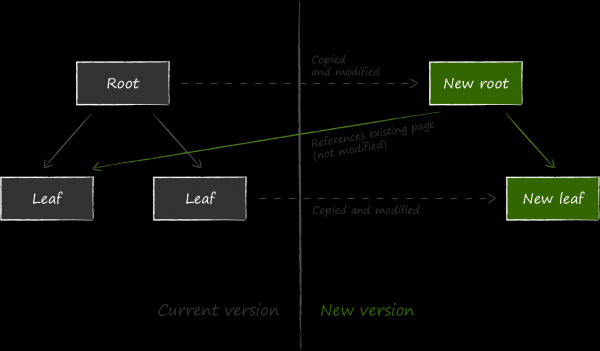
Vervolgens, om de bijgewerkte gegevens beschikbaar te maken, is het noodzakelijk om de verwijzing naar het actuele knooppunt in de ouderknoop in relatie tot hem te wijzigen. Aangezien hiervoor ook schouder moet worden aangepast, wordt deze ook vooraf gekopieerd. Dit proces gaat recursief door tot aan de wortel. De gegevens op de meta-pagina worden als laatste gewijzigd.
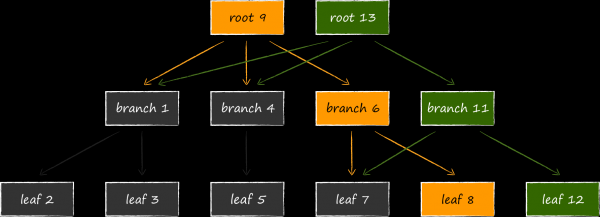
Als er tijdens het updateproces een onverwachte afsluiting van het proces optreedt, wordt er geen nieuwe meta-pagina aangemaakt, of deze wordt niet op schijf geschreven tot het einde, en de controleprefix zal ongeldig zijn. In beide gevallen zullen de nieuwe pagina's onbereikbaar zijn, terwijl de oude onbeschadigd blijven. Dit onthoudt LMDB van de noodzaak om een write ahead log bij te houden voor gegevensconsistentie. De de facto structuur voor gegevensopslag op schijf, zoals hierboven beschreven, vervult tegelijkertijd deze functie. Het ontbreken van een transactie-log in expliciete vorm is een van de kenmerken van LMDB, die zorgt voor een hoge leessnelheid van gegevens.
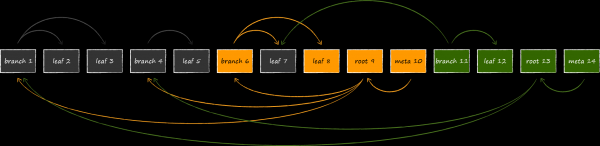
De resulterende constructie, genaamd append-only B-tree, biedt van nature transactiescheiding en multi-versioning. In LMDB is elke geopende transactie gekoppeld aan de actuele boomwortel. Zolang de transactie niet is afgerond, zullen de pagina's van de aan de transactie gekoppelde boom nooit worden gewijzigd of hergebruikt voor nieuwe versies van gegevens. Zo kan men onbeperkt blijven werken met precies die dataset die beschikbaar was op het moment van het openen van de transactie, zelfs als de opslag op dat moment actief wordt bijgewerkt. Dit is de essentie van multi-versioning, waardoor LMDB een ideale gegevensbron is voor ons allemaal. UICollectionViewBij het openen van een transactie is het niet nodig om de geheugengebruik van de applicatie te verhogen door haastig actuele gegevens naar een in-memory structuur te halen, uit angst om met lege handen te blijven. Deze eigenschap onderscheidt LMDB gunstig van SQLite, dat niet kan opscheppen over zo'n totale isolatie. Als in dat laatste twee transacties worden geopend en een bepaalde record binnen een van hen wordt verwijderd, kan dezezelfde record niet meer worden verkregen in het kader van de tweede resterende.
De keerzijde is een potentieel aanzienlijk hogere verbruik van virtueel geheugen. De dia toont hoe de database-structuur eruit zal zien als deze tegelijkertijd wordt gemodificeerd met 3 open leestransacties die naar verschillende versies van de database kijken. Aangezien LMDB geen knooppunten kan hergebruiken die toegankelijk zijn vanuit de wortels die verbonden zijn met actuele transacties, blijft het opslaghuis niets anders over dan een vierde wortel in het geheugen te plaatsen en opnieuw de aanpasbare pagina's eronder te klonen.
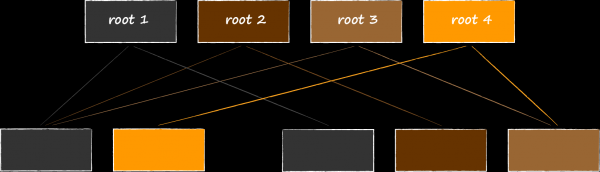
Het is nuttig om de sectie over memory-mapped bestanden te herinneren. Hoewel een extra verbruik van virtueel geheugen ons niet al te veel zou moeten bezighouden, omdat dit geen bijdrage levert aan de geheugenvoetafdruk van de applicatie. Tegelijkertijd is gebleken dat iOS zeer terughoudend is met het toewijzen ervan, en we kunnen niet zoals op een server of desktop zomaar een gebied van 1 terabyte aan LMDB toekennen zonder na te denken over deze eigenschap. We moeten, waar mogelijk, proberen de levensduur van transacties zo kort mogelijk te maken.
4. Ontwerpen van het dataschema bovenop de key-value API
We beginnen de bespreking van de API met een blik op de basisabstracties die door LMDB worden aangeboden: omgevingen en databases, sleutels en waarden, transacties en cursors.
Opmerking over de codevoorbeelden
Alle functies in de openbare LMDB API geven het resultaat van hun werking weer als een foutcode, maar in alle volgende voorbeelden is deze controle weggelaten ten gunste van beknoptheid. In de praktijk hebben we onze eigen C++ wrapper , waarin fouten zich materialiseren als C++-exclusies.
Als de snelste manier om LMDB aan een project voor iOS of macOS te koppelen, stel ik mijn CocoaPod voor .
4.1. Basisabstracties
Omgeving (environment)
Structuur MDB_env is de opslagplaats van de interne staat van LMDB. Een reeks functies met de prefix mdb_env stelt ons in staat om enkele van zijn eigenschappen te configureren. In de eenvoudigste vorm ziet de initialisatie van de engine er als volgt uit.
mdb_env_create(env);
mdb_env_set_map_size(*env, 1024 * 1024 * 512)
mdb_env_open(*env, path.UTF8String, MDB_NOTLS, 0664);In de Mail.ru Cloud-applicatie hebben we de standaardwaarden alleen voor twee parameters gewijzigd.
De eerste is de grootte van de virtuele adresruimte waarvoor het opslagbestand is toegewezen. Helaas kan, zelfs op hetzelfde apparaat, de specifieke waarde aanzienlijk verschillen van uitvoering tot uitvoering. Om deze eigenschap van iOS in overweging te nemen, wordt de maximale opslagcapaciteit dynamisch ingesteld. Begonnen met een bepaalde waarde, wordt deze halverwege verlaagd totdat de functie mdb_env_open een resultaat teruggeeft dat anders is dan ENOMEM. In theorie bestaat er ook een tegenovergestelde benadering — eerst het minimum aan geheugen toewijzen aan de engine en dan, bij het ontvangen van fouten, dit verhogen. Echter, deze aanpak is veel lastiger. De reden hiervoor is dat de procedure voor geheugenherallocatie (remap) met behulp van de functie MDB_MAP_FULLmdb_env_set_map_size alle entiteiten (cursussen, transacties, sleutels en waarden) die eerder van de engine zijn verkregen, ongeldig maakt. Het rekening houden met deze wending in de code zal het aanzienlijk complexer maken. Als virtueel geheugen echter van groot belang voor je is, dan kan dit een reden zijn om naar de verder gevorderde fork te kijken , waar onder de aangegeven functies "automatische on-the-fly databasegrootte aanpassing" is. De tweede parameter, waarvan de standaardwaarde niet geschikt was, reguleert de mechanismen voor het garanderen van threadveiligheid. Helaas zijn er, in ieder geval in iOS 10, problemen met de ondersteuning van thread local storage. Om deze reden wordt de opslag in het bovenstaande voorbeeld geopend met de vlag
MDB_NOTLS . Daarnaast was het ook nodig om eenfork te maken , om de variabelen met deze eigenschap daarin te verwijderen. De database is een aparte instantie van een B-tree, waar we eerder over hebben gesproken. Het openen ervan gebeurt binnen een transactie, wat in het begin misschien een beetje vreemd lijkt.
Databases
MDB_txn *txn; MDB_dbi dbi; mdb_txn_begin(env, NULL, MDB_RDONLY, &txn); mdb_dbi_open(txn, NULL, MDB_CREATE, &dbi); mdb_txn_abort(txn);
In feite is een transactie in LMDB een opslagentiteit, en niet een specifieke database. Dit begrip maakt atomische operaties mogelijk op entiteiten die zich in verschillende databases bevinden. In theorie opent dit de mogelijkheid om tabellen in de vorm van verschillende databases te modelleren, maar ik heb destijds een andere weg gekozen, die hieronder in detail wordt beschreven.Sleutels en waarden
MDB_val
Structuur MDB_val modelleert het concept van zowel sleutel als waarde. De opslag heeft geen enkele notie van hun semantiek. Voor haar is iets dat iets anders is gewoon een array van bytes van een bepaalde grootte. De maximale grootte van een sleutel is 512 bytes.
typedef struct MDB_val {
size_t mv_size;
void *mv_data;
} MDB_val;Met behulp van een comparator ordent de opslag de sleutels in oplopende volgorde. Indien je deze niet vervangt door een eigen versie, wordt de standaard gebruikt, die ze byte-gewijs in lexicografische volgorde sorteert.
Transacties
De transactie-eisen worden uitvoerig beschreven in , daarom herhaal ik hier kort hun belangrijkste eigenschappen:
- Ondersteuning voor alle basisattributen : atomariteit, consistentie, isolatie en betrouwbaarheid. Ik wil opmerken dat er een bug is in de duurzaamheid op macOS en iOS, die is verholpen in MDBX. Meer informatie kan worden gevonden in hun .
- De benadering van multithreading wordt beschreven met het schema "single writer / multiple readers". Schrijvers blokkeren elkaar, maar blokkeren geen lezers. Lezers blokkeren geen schrijvers of elkaar.
- Ondersteuning voor geneste transacties.
- Ondersteuning voor multi-versioning.
Multi-versioning in LMDB is zo goed dat ik het in actie wil demonstreren. Uit de onderstaande code blijkt dat elke transactie precies met die versie van de database werkt die geldig was op het moment van openen, volledig geïsoleerd van alle daaropvolgende wijzigingen. De initialisatie van de opslag en het toevoegen van een testrecord zijn niet bijzonder interessant, daarom zijn deze rituelen onder een spoiler geplaatst.
Toevoegen van een testrecord
MDB_env *env;
MDB_dbi dbi;
MDB_txn *txn;

mdb_env_create(&env);
mdb_env_open(env, ".\/testdb", MDB_NOTLS, 0664);

mdb_txn_begin(env, NULL, 0, &txn);
mdb_dbi_open(txn, NULL, 0, &dbi);
mdb_txn_abort(txn);

char k = 'k';
MDB_val key;
key.mv_size = sizeof(k);
key.mv_data = (void *)&k;

int v = 997;
MDB_val value;
value.mv_size = sizeof(v);
value.mv_data = (void *)&v;

mdb_txn_begin(env, NULL, 0, &txn);
mdb_put(txn, dbi, &key, &value, MDB_NOOVERWRITE);
mdb_txn_commit(txn);
MDB_txn *txn1, *txn2, *txn3;
MDB_val val;
// We open 2 transactions, each looking at the database version with a single entry.
mdb_txn_begin(env, NULL, 0, &txn1); // read-write
mdb_txn_begin(env, NULL, MDB_RDONLY, &txn2); // read-only
// Within the first transaction, we delete the existing entry in the database.
mdb_del(txn1, dbi, &key, NULL);
// We commit the deletion.
mdb_txn_commit(txn1);
// We open a third transaction, which looks at the
// current version of the database, where the entry no longer exists.
mdb_txn_begin(env, NULL, MDB_RDONLY, &txn3);
// We ensure that the entry for the queried key no longer exists.
assert(mdb_get(txn3, dbi, &key, &val) == MDB_NOTFOUND);
// We abort the transaction.
mdb_txn_abort(txn3);
// We ensure that within the second transaction, opened while
// the entry existed in the database, it can still be found by key.
assert(mdb_get(txn2, dbi, &key, &val) == MDB_SUCCESS);
// We check that valid data is received for the key, not just any junk.
assert(*(int *)val.mv_data == 997);
// We abort the transaction, which, although working with outdated, is consistent data.
mdb_txn_abort(txn2);Optioneel raad ik aan om een soortgelijke truc met SQLite te proberen en te kijken wat eruit komt.
Multiversie brengt zeer aangename voordelen met zich mee voor iOS-ontwikkelaars. Met deze eigenschap kunnen we soepel en zonder problemen de snelheid van de gegevensbron (data source) voor schermformulieren reguleren, rekening houdend met gebruikerservaring. Neem bijvoorbeeld de functie van de Mail.ru Cloud-app zoals automatische contentlading uit de systeem mediagalerie. Bij een goed netwerk kan de klant meerdere foto's per seconde naar de server toevoegen. Als we na elke upload de UICollectionView media-inhoud in de cloud van de gebruiker actualiseren, kunnen we 60 fps en soepel scrollen tijdens dit proces vergeten. Om frequente schermupdates te voorkomen, moet de snelheid van gegevenswijzigingen aan de basis op een of andere manier beperkt worden. UICollectionViewDataSource.
Als de database geen multi-versioning ondersteunt en alleen werkt met de huidige actuele staat, dan is het noodzakelijk om voor het creëren van een stabiele snapshot van de gegevens deze te kopiëren naar een bepaalde in-memory datastructuur of naar een tijdelijke tabel. Beide benaderingen zijn zeer kostbaar. In het geval van een in-memory opslag hebben we kosten zowel voor het geheugen, veroorzaakt door de opslag van geconstrueerde objecten, als voor de tijd, gerelateerd aan overbodige ORM-transformaties. Wat betreft de tijdelijke tabel is dat een nog duurdere optie, die alleen zinvol is in niet-triviale gevallen.
De multi-versioning van LMDB lost het probleem van het handhaven van een stabiele gegevensbron op een zeer elegante manier op. Het is voldoende om gewoon een transactie te openen en voilà — zolang we deze niet afsluiten, is de set gegevens gegarandeerd vastgelegd. De logica van de snelheid van de update ligt nu volledig en geheel in handen van de presentatie-laag zonder significante overheadkosten.
Cursussen
Cursussen bieden een mechanisme voor geordende iteratie over sleutel-waardeparen door het doorlopen van een B-boom. Zonder hen zou het onmogelijk zijn om effectief tabellen in de database te modelleren, die we nu gaan bekijken.
4.2. Modellering van tabellen
De eigenschap van de ordening van sleutels maakt het mogelijk om op basis van de basisabstracties een hoge abstractie zoals een tabel te construeren. Laten we dit proces bekijken aan de hand van de hoofdtafel van de cloudklant, waarin informatie over alle bestanden en mappen van de gebruiker is gecachet.
Tabelschema
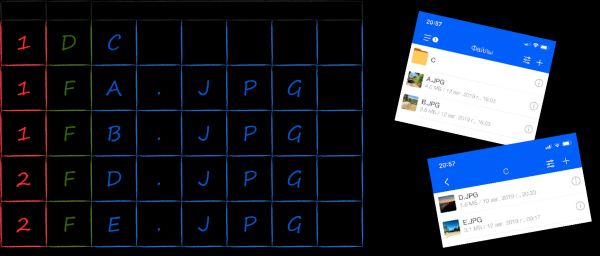
Een van de veelvoorkomende scenario's waarvoor de tabelstructuur met een mappenboom moet zijn ontworpen, is het ophalen van alle elementen die zich binnen een opgegeven directory bevinden. Een goede datamodelorganisatie voor effectieve verzoeken van dit type is . Voor de implementatie hiervan boven een key-value opslag is het noodzakelijk om de sleutels van bestanden en mappen zo te sorteren dat ze worden gegroepeerd op basis van hun ouderdirectory. Bovendien, om de inhoud van de directory op de door de gebruiker vertrouwde manier in Windows weer te geven (eerst de mappen, dan de bestanden, en beide zijn alfabetisch gesorteerd), moeten er relevante extra velden in de sleutel worden opgenomen.
De afbeelding hieronder toont hoe, afhankelijk van de gestelde taak, de weergave van sleutels in de vorm van een byte-array kan zijn. Eerst worden de bytes met het ID van de bovenliggende map geplaatst (rood), daarna de met het type (groen) en uiteindelijk de met de naam (blauw). Bij het sorteren door de standaard LMDB-comparator in lexicografische volgorde, worden ze op de vereiste manier geordend. Een opeenvolgende doorloop van sleutels met dezelfde rode prefix geeft ons de bijbehorende waarden in de volgorde waarin ze in de gebruikersinterface (rechts) moeten worden weergegeven, zonder dat extra nabewerking nodig is.
Serialisatie van sleutels en waarden
In de wereld zijn er veel methoden uitgevonden voor de serialisatie van objecten. Aangezien we geen andere vereiste hadden dan snelheid, kozen we voor de snelste beschikbare methode: een dump van het geheugen dat door een instantie van een C-structuur wordt gebruikt. Zo kan de sleutel van een directory-element worden gemodelleerd met de volgende structuur NodeKey.
typedef struct NodeKey {
EntityId parentId;
uint8_t type;
uint8_t nameBuffer[256];
} NodeKey;Voor opslag NodeKey moet in het object MDB_val een aanwijzer naar de gegevens worden gepositioneerd op het adres van het begin van de structuur, en de grootte ervan moet worden berekend met de functie sizeof.
MDB_val serialize(NodeKey * const key) {
    return MDB_val {
        .mv_size = sizeof(NodeKey),
        .mv_data = (void *)key
    };
}
In het eerste hoofdstuk over de criteria voor het kiezen van een database heb ik als belangrijk kiesfactor het minimaliseren van dynamische allocaties binnen CRUD-operaties genoemd. De code van de functie serialize toont hoe in het geval van LMDB deze volledig kunnen worden vermeden bij het invoegen van nieuwe records in de database. De binnenkomende byte-array van de server wordt eerst omgevormd naar stack-structuren, waarna deze op triviale wijze in de opslag worden gedumpt. Gezien het feit dat er binnen LMDB ook geen dynamische allocaties zijn, kan een fantastische situatie voor iOS ontstaan: het gebruik van alleen stack-geheugen voor het werken met gegevens tijdens hun hele traject van netwerk naar schijf!
Ordling van sleutels met een binaire comparator
De volgorde van de sleutels wordt ingesteld met een speciale functie die een comparator wordt genoemd. Aangezien de engine niets weet over de semantiek van de bytes die erin zitten, moet de standaard comparator zich beperken tot het lexicografisch ordenen van de sleutels door ze byte-voor-byte te vergelijken. Het gebruik hiervan voor het ordenen van structuren is vergelijkbaar met scheren met een hakbijl. Desondanks vind ik deze methode in eenvoudige gevallen acceptabel. Een alternatief wordt hieronder beschreven, en hier wil ik een paar struikelblokken op deze weg opmerken.
Het eerste wat je moet onthouden, is de representatie in het geheugen van primitieve datatypes. Op alle Apple-apparaten worden gehele variabelen opgeslagen in het formaat . Dit betekent dat de minst significante byte aan de linkerkant staat, en het is niet mogelijk om gehele getallen te sorteren met behulp van byte-vergelijking. Bijvoorbeeld, proberen dit te doen met een reeks getallen van 0 tot 511 zal het volgende resultaat opleveren.
// value (hex dump)
000 (0000)
256 (0001)
001 (0100)
257 (0101)
...
254 (fe00)
510 (fe01)
255 (ff00)
511 (ff01)
Om dit probleem op te lossen, moeten gehele getallen in de sleutel in een formaat dat geschikt is voor byte-comparators worden opgeslagen. De benodigde conversie kan worden uitgevoerd met functies uit de familie hton* (in het bijzonder htons voor de tweebyte-getallen uit het voorbeeld).
Het formaat waarin strings in programmeren worden weergegeven, is algemeen bekend als . Als de semantiek van strings en de codering die voor hun representatie in het geheugen wordt gebruikt, veronderstelt dat er meer dan één byte aan een teken kan worden toegewezen, is het beter om het idee van de standaard comparator direct te laten vallen.
Het tweede dat je in gedachten moet houden, zijn de die de compiler toepast op de velden van een structuur. Hierdoor kunnen er bytes met ongewenste waarden in het geheugen ontstaan tussen de velden, wat natuurlijk de byte-sorting verstoort. Om het ongewenste op te ruimen, moet je ofwel de velden in een strikte volgorde declareren, rekening houdend met de uitlijnregels, of in de struct-declaratie het attribuut packed.
Sleutels ordenen met een externe comparator
De logica van het vergelijken van sleutels kan te complex zijn voor een binaire comparator. Een van de vele redenen is de aanwezigheid van technische velden binnen structuren. Ik zal hun ontstaan illustreren aan de hand van de al bekende sleutel voor een directory-element.
typedef struct NodeKey {
EntityId parentId;
uint8_t type;
uint8_t nameBuffer[256];
} NodeKey;Ondanks zijn eenvoud gebruikt het in de meeste gevallen te veel geheugen. De buffer voor de naam neemt 256 byte in beslag, terwijl bestands- en mappenamen gemiddeld zelden meer dan 20-30 tekens bevatten.
Een van de standaardmethoden om de grootte van een record te optimaliseren, bestaat uit het 'afsnijden' tot de werkelijke grootte. Dit houdt in dat de inhoud van alle velden met variabele lengte aan het einde van de structuur in de buffer wordt opgeslagen, terwijl hun lengtes in aparte variabelen worden bewaard. Volgens deze aanpak wordt de sleutel NodeKey als volgt getransformeerd.
typedef struct NodeKey {
    EntityId parentId;
    uint8_t type;
    uint8_t nameLength;
    uint8_t nameBuffer[256];
} NodeKey;
Daarnaast wordt bij serialisatie niet de grootte van de hele structuur opgegeven, maar de grootte van alle velden met vaste lengte plus de grootte van het daadwerkelijk gebruikte deel van de buffer. sizeof MDB_val serialize(NodeKey * const key) { return MDB_val { .mv_size = offsetof(NodeKey, nameBuffer) + key->nameLength, .mv_data = (void *)key }; }
Als gevolg van de uitgevoerde refactoring hebben we een aanzienlijke besparing van ruimte door de sleutels verkregen. Echter, vanwege het technische veldnameLength , is de standaard binaire comparator niet langer geschikt voor het vergelijken van sleutels. Als we deze niet door onze eigen vervangen, zal de lengte van de naam een belangrijker factor zijn bij het sorteren dan de naam zelf.LMDB stelt in staat om voor elke database een eigen functie voor het vergelijken van sleutels in te stellen. Dit gebeurt met behulp van de functie
mdb_set_compare en moet strikt vóór het openen worden gedaan. Om voor de hand liggende redenen kan dit gedurende de levensduur van de database niet worden gewijzigd. De comparator ontvangt twee sleutels in binaire vorm als input en geeft als output het resultaat van de vergelijking: minder (-1), meer (1) of gelijk (0). De pseudocode voor ziet er als volgt uit. NodeKey int compare(MDB_val * const a, MDB_val * const b) { NodeKey * const aKey = (NodeKey * const)a->mv_data; NodeKey * const bKey = (NodeKey * const)b->mv_data; return // ... }
Zolang alle sleutels in de database hetzelfde type hebben, is onvoorwaardelijke conversie van hun byte-representatie naar het type van de toepassingsstructuur van de sleutel legaal. Er is echter één nuance, maar deze zal iets lager worden behandeld in de sectie 'Records lezen'.Serialisatie van waarden
Serialisatie van waarden
De sleutels van de opgeslagen LMDB-records werken extreem intensief. Hun vergelijking vindt plaats binnen elke applicatieoperatie, en de snelheid van de comparator beïnvloedt de prestaties van de hele oplossing. In een ideale wereld zou de standaard binaire comparator voldoende moeten zijn voor het vergelijken van sleutels, maar als je je eigen moet gebruiken, moet de procedure voor het deserialiseren van sleutels daarin zo snel mogelijk zijn.
De waarde-deel van de record (waarde) is voor de database niet bijzonder interessant. De conversie van de byte-representatie naar een object vindt alleen plaats wanneer dit al nodig is voor de applicatiecode, bijvoorbeeld voor de weergave op het scherm. Aangezien dit relatief zeldzaam gebeurt, zijn de eisen aan de snelheid van deze procedure niet zo kritisch, en in de implementatie hiervan zijn we in veel grotere mate vrij om ons te richten op het gemak. Bijvoorbeeld, voor het serialiseren van metadata over nog niet geladen bestanden gebruiken we NSKeyedArchiver.
NSData *data = serialize(object);
MDB_val value = {
.mv_size = data.length,
.mv_data = (void *)data.bytes
};Toch zijn er gevallen waarin de prestaties er wel toe doen. Bijvoorbeeld, bij het opslaan van metadata over de bestandsstructuur van de gebruikerscloud gebruiken we nog steeds de geheugen-dump van objecten. Het unieke van de taak om hun geserialiseerde representatie te vormen is het feit dat de elementen van de map worden gemodelleerd met een hiërarchie van klassen.
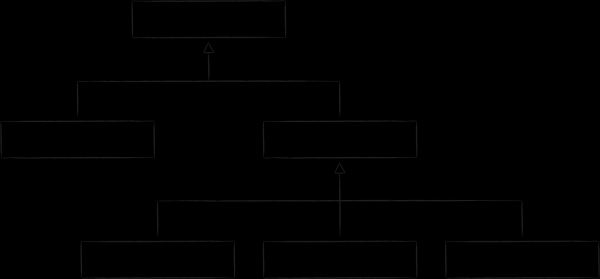
Voor de implementatie in de programmeertaal C worden de specifieke velden van de afstammelingen in afzonderlijke structuren geplaatst, en hun verbinding met de basis wordt vastgesteld via een union-veld. De actuele inhoud van de union wordt ingesteld via het technische attribuut type.
typedef struct NodeValue {
EntityId localId;
EntityType type;
union {
FileInfo file;
DirectoryInfo directory;
} info;
uint8_t nameLength;
uint8_t nameBuffer[256];
} NodeValue;Toevoegen en bijwerken van records
Geserialiseerde sleutel en waarde kunnen aan de opslag worden toegevoegd. Hiervoor wordt de functie gebruikt mdb_put.
// key и value имеют тип MDB_val
mdb_put(..., &key, &value, MDB_NOOVERWRITE);In de configuratiefase kan de opslag worden toegestaan of verboden om meerdere records met dezelfde sleutel op te slaan. Als duplicatie van sleutels is verboden, kan bij het invoegen van een record worden bepaald of het toegestaan is om een reeds bestaand record bij te werken of niet. Als overschrijven alleen kan plaatsvinden door een fout in de code, kan men zich hiertegen beschermen door een vlag op te geven. NOOVERWRITE.
Records lezen
De functie mdb_getis bedoeld voor het lezen van records. Als het sleutel-waarde paar eerder is gepresenteerd met de gedumpte structuren, ziet deze procedure er als volgt uit.
NodeValue * const readNode(..., NodeKey * const key) {
MDB_val rawKey = serialize(key);
MDB_val rawValue;
mdb_get(..., &rawKey, &rawValue);
return (NodeValue * const)rawValue.mv_data;
}De gegeven listing toont aan hoe serialisatie via het dumpen van structuren het mogelijk maakt om niet alleen bij het schrijven, maar ook bij het lezen van gegevens dynamische allocaties te vermijden. De verkregen pointer uit de functie mdb_get wijst precies naar dat adres in het virtuele geheugen waar de database de byte-representatie van het object opslaat. In feite krijgen we een soort ORM, die vrijwel gratis een zeer hoge snelheid van gegevenslezen mogelijk maakt. Ondanks de schoonheid van deze benadering, moet men enkele bijbehorende kenmerken onthouden.
- Voor readonly transacties blijft de pointer naar de structuur-waarde gegarandeerd geldig totdat de transactie is afgesloten. Zoals eerder opgemerkt, blijven de B-tree pagina's waarop het object zich bevindt, dankzij het principe copy-on-write onveranderd zolang er ten minste één transactie naar verwijst. Zodra de laatste transactie die ermee verbonden is, echter is beëindigd, kunnen de pagina's opnieuw worden gebruikt voor nieuwe gegevens. Als het nodig is dat objecten de transactie waarmee ze zijn geproduceerd overleven, moeten ze echter wel worden gekopieerd.
- Voor readwrite transacties blijft de pointer naar de verkregen structuur-waarde geldig totdat de eerste wijzigende procedure (het schrijven of verwijderen van gegevens) wordt uitgevoerd.
- Ondanks het feit dat de structuur
NodeValuegeen volledige, maar een afgeslankte versie is (zie het onderdeel 'Sorteer sleutels met een externe comparator'), kan men via de pointer gerust naar zijn velden verwijzen. Het is alleen belangrijk om deze niet te dereferenceren! - Onder geen enkele omstandigheid mag de structuur worden gemodificeerd via de ontvangen pointer. Alle wijzigingen moeten uitsluitend via de methode worden uitgevoerd
mdb_put. Hoezeer je het ook probeert, het zal niet lukken, omdat het geheugen waar deze structuur zich bevindt in read-only modus is gemapped. - Remap van de bestanden naar de adresruimte van het proces met als doel bijvoorbeeld de maximale opslagcapaciteit te vergroten met behulp van de functie
alle entiteiten (cursussen, transacties, sleutels en waarden) die eerder van de engine zijn verkregen, ongeldig maakt. Het rekening houden met deze wending in de code zal het aanzienlijk complexer maken. Als virtueel geheugen echter van groot belang voor je is, dan kan dit een reden zijn om naar de verder gevorderde fork te kijkenheeft een volledige ongeldigmaking van alle transacties en de daaraan gerelateerde entiteiten en pointers naar gelezen objecten tot gevolg.
Tenslotte is er nog een eigenschap die zo verraderlijk is dat het uitleggen daarvan niet eenvoudig in een extra punt past. In het hoofdstuk over B-bomen gaf ik een schema van hoe de pagina's ervan in het geheugen zijn opgebouwd. Hieruit volgt dat het adres van de buffer met de geserialiseerde gegevens volledig willekeurig kan zijn. Hierdoor is de pointer naar deze gegevens, verkregen in de structuur MDB_val en omgevormd tot een pointer naar de structuur, in het algemeen geval niet uitgelijnd. Tegelijkertijd vereisen de architecturen van sommige chips (in het geval van iOS is dit armv7) dat het adres van elke gegevens een veelvoud is van de grootte van een machinewoord of met andere woorden, de bitgrootte van het systeem (voor armv7 is dit 32 bits). Met andere woorden, een operatie zoals *(int *foo)0x800002 wordt gelijkgesteld aan een ontsnapping en leidt tot een veroordeling met het oordeel EXC_ARM_DA_ALIGN. Je kunt zo'n treurige uitkomst op twee manieren vermijden.
De eerste bestaat uit het vooraf kopiëren van gegevens naar een bij voorbaat uitgelijnde structuur. Op een aangepaste comparator zou dit als volgt blijken.
int compare(MDB_val * const a, MDB_val * const b) {
    NodeKey aKey, bKey;
    memcpy(&aKey, a->mv_data, a->mv_size);
    memcpy(&bKey, b->mv_data, b->mv_size);
    return \\ ...
}
Een alternatieve manier is om de compiler vooraf te informeren dat structuren met sleutel en waarde niet uitgelijnd kunnen zijn met behulp van het attribuut aligned(1). Op ARM kan hetzelfde effect worden bewerkstelligd met behulp van het attribuut packed. Aangezien dit ook bijdraagt aan de optimalisatie van de ruimte die door de structuur wordt ingenomen, lijkt mij deze methode de voorkeur te hebben, ook al verhoogt het de kosten van datatoegang.
typedef struct __attribute__((packed)) NodeKey {
    uint8_t parentId;
    uint8_t type;
    uint8_t nameLength;
    uint8_t nameBuffer[256];
} NodeKey;
Range-aanvragen
Voor het itereren door een groep records in LMDB is er een cursorabstractie. We zullen aan de hand van een voorbeeld van de reeds bekende metadata-tabel van de cloud van de gebruiker bekijken hoe we hiermee kunnen werken.
Bij het weergeven van de bestandslijst in een directory moet je alle sleutels vinden waarmee de dochterbestanden en -mappen zijn geassocieerd. In de vorige secties hebben we de sleutels gesorteerd NodeKey zodat ze in de eerste plaats zijn geordend op het identificatienummer van de bovenliggende directory. Technisch gezien komt de taak om de inhoud van de map te verkrijgen neer op het positioneren van de cursor op de bovenrand van de sleutels met de gegeven prefix, gevolgd door het itereren naar de onderrand.
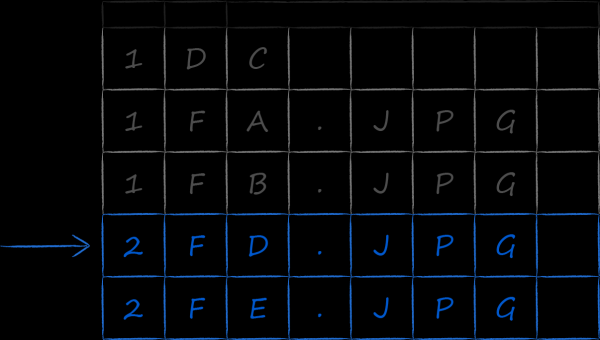
De bovenrand kan "rechtstreeks" worden gevonden door een sequentiële zoekopdracht uit te voeren. Hiervoor wordt de cursor aan het begin van de volledige lijst met sleutels in de database geplaatst en vervolgens wordt deze verhoogd totdat er een sleutel met het identificatienummer van de bovenliggende directory onder ligt. Deze benadering heeft twee duidelijke nadelen:
- Lineaire zoektijd, terwijl het evenals bekend in bomen en in een B-boom in het bijzonder kan worden uitgevoerd in logaritmische tijd.
- Onterecht worden alle pagina's die aan het gezochte voorafgaan uit het bestand naar het hoofdgeheugen geladen, wat extreem kostbaar is.
Gelukkig biedt de LMDB API een efficiënte manier om de cursor in te stellen. Hiervoor moet je een sleutel genereren waarvan de waarde zeker kleiner of gelijk is aan de sleutel die zich aan de bovenrand van het interval bevindt. Bijvoorbeeld, met betrekking tot de lijst in de bovenstaande afbeelding kunnen we een sleutel maken waarbij het veld parentId gelijk is aan 2, terwijl alle andere op nul zijn ingesteld. Deze gedeeltelijk ingevulde sleutel wordt doorgegeven aan de functie mdb_cursor_get met de operatie MDB_SET_RANGE.
NodeKey upperBoundSearchKey = {
.parentId = 2,
.type = 0,
.nameLength = 0
};
MDB_val value, key = serialize(upperBoundSearchKey);
MDB_cursor *cursor;
mdb_cursor_open(..., &cursor);
mdb_cursor_get(cursor, &key, &value, MDB_SET_RANGE);Als de bovenrand van de groep sleutels is gevonden, worden we verder geïtereerd totdat we ofwel een sleutel met een andere tegenkomen parentId, of de sleutels helemaal zijn opgebruikt.
do {
rc = mdb_cursor_get(cursor, &key, &value, MDB_NEXT);
// verwerking...
} while (MDB_NOTFOUND != rc && // controleer het einde van de tabel
IsTargetKey(key)); // controleer het einde van de sleutelgroepWat prettig is, is dat we tijdens iteraties met behulp van mdb_cursor_get niet alleen de sleutel, maar ook de waarde ontvangen. Als het nodig is om voorwaarden voor selectie te controleren, inclusief velden uit het waarde-gedeelte van de record, zijn ze zonder extra moeite toegankelijk.
4.3. Modelleren van relaties tussen tabellen
Tot nu toe hebben we alle aspecten van het ontwerp en de werking van een enkelvoudige databank behandeld. Men kan zeggen dat een tabel een verzameling gesorteerde records is, bestaande uit vergelijkbare sleutel-waarde paren. Als we de sleutel voorstellen als een rechthoek en de gerelateerde waarde als een parallelepiped, krijgen we een visueel schema van de databank.

Echter, in de praktijk lukt het zelden om met zo weinig moeite toe te komen. Vaak is het nodig om, ten eerste, meerdere tabellen in de databank te hebben, en ten tweede, om selecties te maken in een volgorde die verschilt van de primaire sleutel. Deze laatste sectie is gewijd aan de vragen van hun creatie en de onderlinge koppeling.
Indextabellen
In de cloudtoepassing is er een sectie 'Galerij'. Hierin wordt mediacontent uit de hele cloud weergegeven, gesorteerd op datum. Voor een optimale uitvoering van deze selectie moet naast de hoofdtafel een andere tabel met een nieuw type sleutels worden aangemaakt. Hierin zal een veld met de aanmaakdatum van het bestand worden opgenomen, dat als primaire sorteerkriterium fungeert. Aangezien de nieuwe sleutels naar dezelfde gegevens verwijzen als de sleutels in de hoofdtafel, worden ze index-sleutels genoemd. Op de afbeelding hieronder zijn ze in het oranje gemarkeerd.
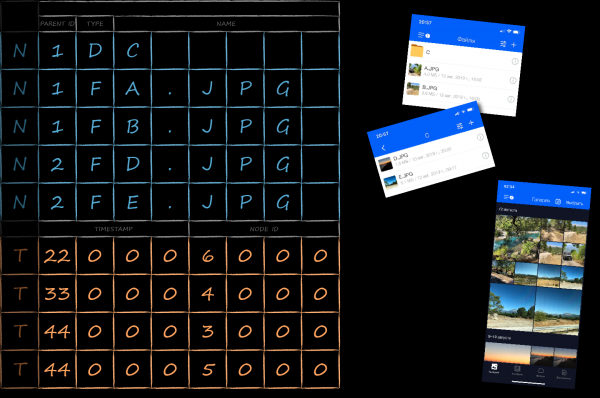
Om binnen dezelfde databank de sleutels van verschillende tabellen van elkaar te scheiden, is er aan allemaal een extra technisch veld tableId toegevoegd. Door dit het belangrijkste criterium voor sortering te maken, bereiken we de groepering van sleutels eerst naar tabellen en vervolgens binnen tabellen naar hun eigen regels.
De index-sleutel verwijst naar dezelfde gegevens als de primaire. Een rechttoe rechtaan implementatie van deze eigenschap door een kopie van het value-gedeelte van de primaire sleutel te associëren is niet optimaal vanuit meerdere invalshoeken:
- Vanuit het perspectief van de benodigde ruimte, omdat metadata behoorlijk rijk kan zijn.
- Vanuit het perspectief van de prestaties, omdat bij het bijwerken van de metadata de knopen moeten worden herschreven op twee sleutels.
- Vanuit het perspectief van codeondersteuning, als we vergeten om gegevens voor een van de sleutels bij te werken, krijgen we een moeilijk te traceren bug in de inconsistentie van gegevens in de opslag.
Laten we vervolgens bekijken hoe we deze tekortkomingen kunnen verhelpen.
Organisatie van relaties tussen tabellen
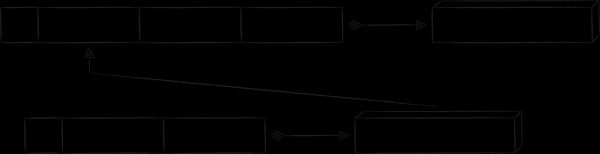
Voor het verbinden van de index tabel met de hoofd tabel is het patroon «sleutel als waarde». Zoals de naam al aangeeft, fungeert een kopie van de waarde van de primaire sleutel als value-gedeelte van de indexvermelding. Deze aanpak elimineert alle eerder genoemde tekortkomingen die verband houden met het opslaan van een kopie van het value-gedeelte van de primaire registratie. De enige prijs is dat het voor het verkrijgen van een waarde op basis van de indexsleutel nodig is om 2 verzoeken aan de database te doen in plaats van één. Schema's van de resulterende database ziet er als volgt uit.
Een ander patroon voor het organiseren van relaties tussen tabellen is «overmatige sleutel». De essentie is het toevoegen van extra attributen aan de sleutel, die niet nodig zijn voor sortering, maar voor het recreëren van de bijbehorende sleutel. In de Mail.ru Cloud-app zijn er echte voorbeelden van het gebruik ervan, maar om een diepe duik in de context van specifieke iOS-frameworks te vermijden, geef ik een verzonnen, maar duidelijker voorbeeld.
In cloud mobiele clients is er een pagina waar alle bestanden en mappen worden weergegeven waartoe de gebruiker toegang heeft verleend aan andere mensen. Aangezien er relatief weinig van dergelijke bestanden zijn en er veel verschillende soorten gerelateerde informatie over de publiciteit zijn (wie toegang heeft gekregen, met welke rechten, enz.), zou het niet rationeel zijn om de value-gedeelte van de record in de hoofdtafel hiermee te verzwaren. Maar als men deze bestanden offline wil weergeven, moet het ergens worden opgeslagen. Een natuurlijke oplossing is het oprichten van een aparte tabel daarvoor. In het onderstaande schema heeft de sleutel een prefix «P» en kan de placeholder «propname» worden vervangen door een specifieker waarde zoals «openbare informatie».
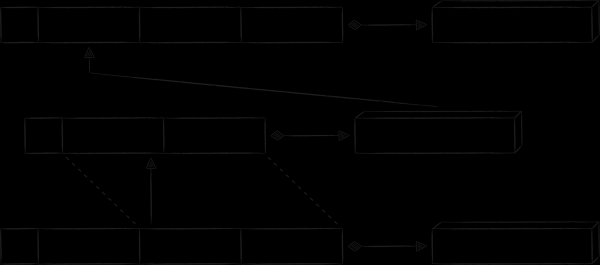
Alle unieke metadata waarvoor een nieuwe tabel is aangemaakt, worden in de value-gedeelte van het record geplaatst. Tegelijkertijd willen we de gegevens over bestanden en mappen die al in de hoofdtabel zijn opgeslagen, niet dupliceren. In plaats daarvan worden in de sleutel "P" overbodige gegevens toegevoegd in de vorm van de velden "node ID" en "timestamp". Hierdoor kan een indexsleutel worden geconstrueerd, waarmee de primaire sleutel kan worden verkregen, waarna uiteindelijk de metadata van de node kan worden verkregen.
Conclusie
We beoordelen de resultaten van de implementatie van LMDB positief. Na de implementatie is het aantal vastlopers van de applicatie met 30% verminderd.
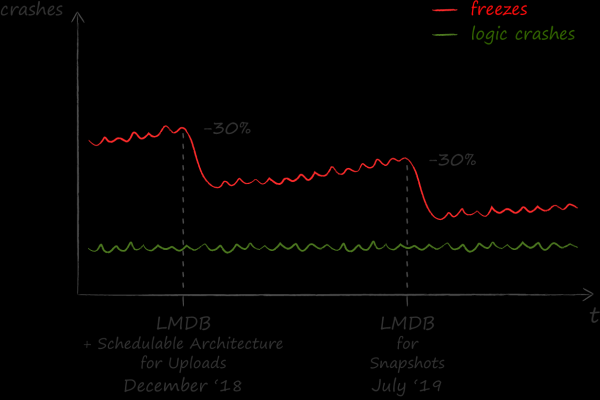
De resultaten van het verrichte werk hebben weerklank gevonden buiten het iOS-team. Op dit moment is een van de belangrijkste secties "Bestanden" in de Android-app ook overgestapt op het gebruik van LMDB, terwijl andere delen in de pijplijn zitten. De programmeertaal C, waarin de key-value opslag is geïmplementeerd, was een goede ondersteuning om oorspronkelijk een applicatiebinding eromheen cross-platform in C++ te maken. Voor de naadloze integratie van de resulterende C++-bibliotheek met de platformcode in Objective-C en Kotlin is een codegenerator gebruikt. van Dropbox, maar dat is alweer een heel ander verhaal.
Bron: habr.com
