

In-Memory — een set concepten voor gegevensopslag waarbij de gegevens in het werkgeheugen van de applicatie worden opgeslagen en de schijf wordt gebruikt voor back-up. In klassieke benaderingen worden gegevens op de schijf opgeslagen en het geheugen als cache gebruikt. Bijvoorbeeld, een webapplicatie met een backend voor gegevensverwerking vraagt gegevens op uit de opslag: ontvangt, transformeert en verzendt veel gegevens via het netwerk. Bij In-Memory worden de berekeningen naar de gegevens gestuurd — naar de opslag, waar ze worden verwerkt en het netwerk minder wordt belast.

Welke andere mogelijkheden zijn beschikbaar met In-Memory en wat voor benadering is dit, zal Vladimir Pligin — ingenieur bij GridGain. Dit overzichtsmateriaal zal nuttig zijn voor backend-ontwikkelaars van webapplicaties die nog niet met In-Memory hebben gewerkt en het willen proberen, of geïnteresseerd zijn in hedendaagse trends in softwareontwikkeling en architectuurontwerp.
Opmerking. Dit artikel is gebaseerd op de transcriptie van de presentatie van Vladimir op de conferentie #GetIT Conf. Voor de invoering van de zelfisolatie organiseerden we regelmatig meetups en conferenties voor ontwikkelaars in Moskou en Sint-Petersburg: we bespraken trends, actuele vraagstukken in de ontwikkeling, problemen en hun oplossingen. Nu kunnen de conferenties niet plaatsvinden, maar is het een goed moment om nuttige materialen van eerder te delen.
Wie en hoe gebruikt In-Memory
In-Memory wordt vaak gebruikt waar snelle interactie met de gebruiker of verwerking van grote hoeveelheden gegevens vereist is.
- Banken gebruiken In-Memory bijvoorbeeld om vertragingen te verminderen bij het gebruik van applicaties door klanten of voor klantanalyse voorafgaand aan het verstrekken van een lening.
- Fintech gebruikt In-Memory om de prestaties van services en applicaties voor banken te verbeteren, die de verwerking en analyse van gegevens uitbesteden.
- Verzekeringsmaatschappijen: voor risicobeoordeling, bijvoorbeeld door klantgegevens over meerdere jaren te analyseren.
- Logistieke bedrijven. Ze verwerken veel gegevens, bijvoorbeeld om de optimale routes voor vracht- en personenvervoer te berekenen met duizenden parameters en om de status van zendingen te volgen.
- Retail. In-Memory oplossingen helpen bij het sneller bedienen van klanten en het verwerken van grote hoeveelheden informatie: zendingen, facturen, transacties, voorraad van duizenden producten in magazijnen, en het opstellen van analytische rapporten.
- In IoT In-Memory vervangt traditionele databases.
- Farmaceutische bedrijven gebruiken In-Memory, bijvoorbeeld voor het doorlopen van combinaties van geneesmiddel samenstellingen.
Ik zal een paar voorbeelden geven van hoe onze klanten In-Memory oplossingen gebruiken en hoe u deze kunt implementeren.
In-Memory als primaire opslag
Een van onze klanten is een grote leverancier van medisch wetenschappelijk apparatuur uit de VS. Ze gebruiken een In-Memory oplossing als primaire opslag voor gegevens. Alle gegevens worden op schijf opgeslagen, terwijl een subset van gegevens die actief gebruikt worden, in het RAM blijft. De toegangsmethoden tot de opslag zijn standaard: GDBC (Generic Database Connector) en SQL-querytaal.
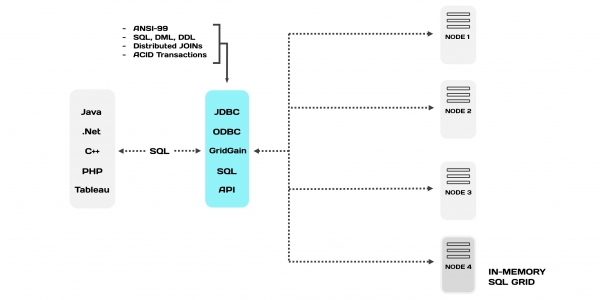
Dit alles wordt een In-Memory Database (IMDB) of Memory-Centric Storage genoemd. Deze klasse oplossingen heeft veel namen, dit zijn er niet de enige.
Kenmerken van IMDB:
- De gegevens die in In-Memory zijn opgeslagen en via SQL toegankelijk zijn, zijn dezelfde als in andere benaderingen. Ze zijn gesynchroniseerd; het enige verschil is de manier van presentatie en toegang. Tussen de gegevens is er transactionele consistentie.
- IMDB is sneller dan relationele databases, omdat het verkrijgen van informatie uit het RAM sneller is dan van de schijf.
- Interne optimalisatie-algoritmen hebben minder instructies.
- IMDB is geschikt voor databeheer, evenementen en transacties in applicaties.
IMDB ondersteunt gedeeltelijk ACID: atomiciteit, consistentie en isolatie. Maar ze ondersteunen geen 'duurzaamheid' — bij stroomuitval gaan alle gegevens verloren. Om dit probleem op te lossen kunnen snapshots worden gebruikt — een 'snapshot' van de database, vergelijkbaar met een databaseback-up op een harde schijf, of transacties (logs) kunnen worden vastgelegd om gegevens te herstellen na herstart.
Voor het creëren van fouttolerante applicaties
Laten we de klassieke architectuur van een fouttolerante webapplicatie bekijken. Het werkt als volgt: een webbalancer verdeelt alle verzoeken over de servers. Dit systeem is robuust, omdat de servers elkaar dupliceren en steun bieden bij incidenten.
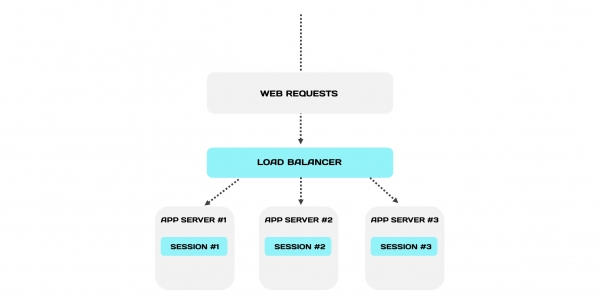
De balancer stuurt alle verzoeken van één sessie strikt naar één server. Dit is het sticky session-mechanisme: elke sessie is gekoppeld aan server, waarin deze lokaal wordt opgeslagen en verwerkt.
Wat gebeurt er als een van de servers?
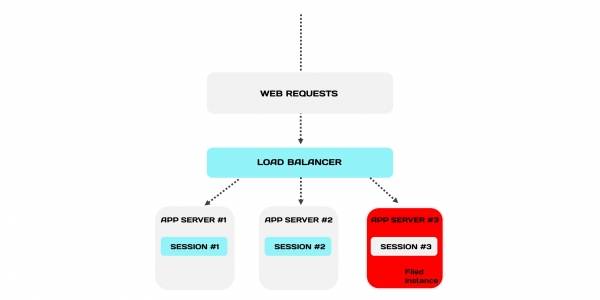
servers uitvalt? De service zal niet lijden, omdat de architectuur gedupliceerd is. Maar we verliezen een subset van de sessies van de uitgevallen server. En bovendien de gebruikers die aan deze sessies zijn gekoppeld. Stel je voor: een klant plaatst een bestelling en wordt plotseling uit het account gegooid. Hij zal ontevreden zijn wanneer hij zich opnieuw aanmeldt en ontdekt dat hij alles opnieuw moet doen.
Van een webapplicatie wordt verwacht dat deze een groot aantal gebruikers ondersteunt en niet "traag" is, zodat het prettig gewerkt kan worden. Maar bij uitval zal de tijd voor elke volgende aanvraag om te communiceren met de sessieopslag steeds langer worden. Dit verhoogt de gemiddelde latentie voor de overige gebruikers. Maar zij willen niet langer wachten dan ze gewend zijn.
Dit probleem kan worden opgelost, zoals een andere klant van ons — een grote PASS-provider uit de VS. Hij gebruikt In-Memory om websessies te clusteren. Hij slaat ze niet lokaal op, maar gecentraliseerd — in een In-Memory cluster. In dit geval zijn de sessies veel sneller toegankelijk omdat ze al in het RAM zijn opgeslagen.
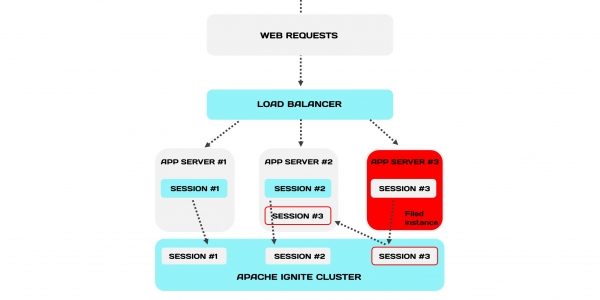
Wanneer een server uitvalt, stuurt de balancer de aanvragen van de uitgevallen server naar andere servers, net zoals in de klassieke architectuur. Maar er is een belangrijk verschil: sessies worden opgeslagen in het In-Memory cluster en de servers hebben toegang tot de sessies van de uitgevallen server.
Deze architectuur verhoogt de fouttolerantie van het hele systeem. Bovendien is het mogelijk om helemaal van het sticky session-mechanisme af te zien.
Hybride transactionele-analytische verwerking (HTAP)
Normaal gesproken worden transactie- en analytische systemen apart gehouden. Wanneer ze gescheiden zijn, komt de hoofddatabase onder druk te staan. Voor analytische verwerking worden de gegevens gekopieerd naar een replica, zodat analytische verwerking de transactieprocessen niet verstoort. Maar de kopie gebeurt met vertraging — zonder vertraging is replicatie onmogelijk. Als we dit synchronisch doen, vertraagt dat ook de hoofddatabase en behalen we geen winst.
Bij HTAP werkt alles anders — dezelfde database wordt gebruikt voor de transactiebelasting van applicaties, en voor analytische queries die lang kunnen duren. Wanneer de gegevens in het werkgeheugen liggen, worden analytische queries sneller uitgevoerd, en de database-server wordt minder belast (gemiddeld).
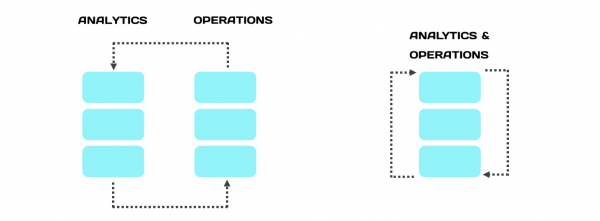
De hybride benadering 'doorbreekt de muur' tussen transactieprocessing en analytics. Als we analytics op dezelfde opslag uitvoeren, worden analytische queries uitgevoerd op gegevens uit het werkgeheugen. Ze zijn veel precisievere, beter interpreteerbaar en adequaat.
Integratie van In-Memory oplossingen
Een eenvoudige (relatieve) manier is — alles vanaf nul te ontwikkelen. We houden de gegevens op de schijf, terwijl we de actieve gegevens in het geheugen opslaan. Dit helpt om serverherstarts of uitval te overleven.
Hier zijn er twee hoofdscenario's waarin gegevens op schijf worden opgeslagen. In het eerste willen we uitvallen of routineherstarts van de cluster of delen meemaken — we willen het gebruiken als een eenvoudige database. In het tweede scenario, wanneer er te veel gegevens zijn, wordt een deel in het geheugen opgeslagen.
Als het niet mogelijk is alles vanaf nul op te bouwen, kan In-Memory mogelijk worden geïntegreerd in de reeds bestaande architectuur. Maar niet alle In-Memory oplossingen zijn hiervoor geschikt. Er zijn drie verplichte voorwaarden. De In-Memory oplossing moet ondersteunen:
- een standaard manier van verbinding maken met de database die eronder zal staan (bijvoorbeeld MySQL);
- een standaard querytaal, zodat de logica van interactie met de opslag niet herschreven of veranderd hoeft te worden;
- transactiebeheer — de semantiek van interactie behouden.
Als aan alle drie voorwaarden wordt voldaan, is integratie mogelijk. We plaatsen de In-Memory Data Grid tussen de applicatie en de database. Nu worden schrijfqueries gedelegeerd naar de onderliggende database, terwijl leesqueries naar de database gaan als de gegevens niet in de cache staan.
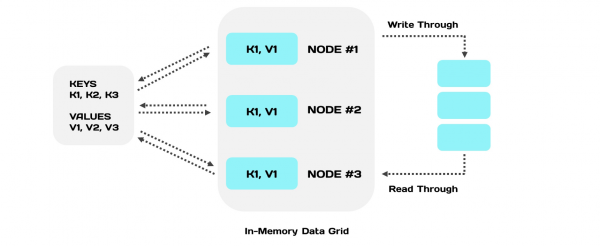
Als snelle toegang tot gegevens en hun verwerking belangrijk voor u zijn, bijvoorbeeld voor bedrijfsanalyses, overweeg dan de implementatie van In-Memory. En voor de uitvoering kunt u beide methoden gebruiken bij het ontwerpen van een nieuwe architectuur.
Bron: habr.com
