

Opmerking vertaler.: de auteurs van dit artikel zijn ingenieurs van een klein Tsjechisch bedrijf, pipetail. Ze hebben een geweldige lijst samengesteld van [soms banale, maar nog steeds] zeer relevante problemen en misvattingen rond het gebruik van Kubernetes-clusters.
In de jaren dat we Kubernetes hebben gebruikt, hebben we met veel clusters gewerkt (zowel beheerde als niet-beheerde – op GCP, AWS en Azure). In de loop der tijd merkten we dat sommige fouten zich voortdurend herhaalden. Maar daar is niets om je voor te schamen: we hebben zelf de meeste ervan gemaakt!
In het artikel zijn de meest voorkomende fouten verzameld, evenals hoe je ze kunt corrigeren.
1. Hulpbronnen: verzoeken en limieten
Dit punt verdient zeker de meeste aandacht en staat op de eerste plaats van de lijst.
De CPU-aanvraag is meestal of helemaal niet ingesteld, of heeft een zeer lage waarde (om zoveel mogelijk pods op elke node te plaatsen). Daardoor zijn de nodes overbelast. Tijdens hoge belasting wordt de CPU-capaciteit van de node volledig benut en krijgt de specifieke werklast alleen datgene wat het "verzocht" heeft door middel van CPU-throttling. Dit leidt tot verhoogde latencies in de applicatie, time-outs en andere onaangename gevolgen. (Meer hierover kun je lezen in een van onze recentere vertalingen: ") — bron: vert.
Beste inspanning (uitermate niet aanbevolen):
resources: {}Extreem lage CPU-aanvraag (uitermate niet aanbevolen):
   resources:
      Requests:
        cpu: "1m"
Aan de andere kant kan het hebben van een CPU-limiet leiden tot onterecht gemiste cycli door de pods, zelfs als de CPU van de node niet volledig belast is. Dit kan opnieuw leiden tot verhoogde latencies. Er zijn voortdurende debatten over de parameter CPU CFS-quota in de Linux-kernel en CPU-throttling afhankelijk van de ingestelde limieten, evenals het uitschakelen van de CFS-quota... Helaas kunnen CPU-limieten meer problemen veroorzaken dan ze kunnen oplossen. Meer hierover is te vinden op de onderstaande link.
Overmatig toewijzen (overcommitting) van geheugen kan leiden tot grotere problemen. Het bereiken van de CPU-limiet resulteert in gemiste cycli, terwijl het bereiken van de geheugenlimiet leidt tot het "doden" van de pod. Heb je ooit OOMkill? Да, речь идет именно о нем.
Wilt u de kans op dit voorval minimaliseren? Vermijd het toewijzen van buitensporige hoeveelheden geheugen en gebruik Guaranteed QoS (Quality of Service) door de memory request gelijk te stellen aan de limiet (zoals in het voorbeeld hieronder). Lees hier meer over in (hoofdingenieur bij Zalando).
Burstable (hogere kans om OOMkilled te worden):
   resources:
      requests:
        memory: "128Mi"
        cpu: "500m"
      limits:
        memory: "256Mi"
cpu: 2Gegarandeerd:
   resources:
      requests:
        memory: "128Mi"
        cpu: 2
      limits:
        memory: "128Mi"
        cpu: 2
Wat kan potentieel helpen bij het instellen van resources?
Met metrics-server kan het huidige CPU-gebruik en het geheugengebruik van pods (en de containers binnen hen) laten zien. Waarschijnlijk maakt u er al gebruik van. Voer gewoon de volgende commando's uit:
kubectl top pods
kubectl top pods --containers
kubectl top nodes
Echter, ze tonen alleen het huidige gebruik. Dit kan een ruwe schatting geven van de orde van grootte, maar uiteindelijk is historie van metrische wijzigingen in de tijd (om antwoorden te geven op vragen zoals: 'Wat was de piekbelasting op CPU?', 'Wat was de belasting gisteren ochtend?' — enzovoort). Hiervoor kunnen Prometheus, DataDog en andere tools worden gebruikt. Deze verkrijgen simpelweg de metrics van de metrics-server en slaan deze op, zodat de gebruiker deze kan opvragen en de bijbehorende grafieken kan opbouwen.
toe te automatiseren dit proces. Het houdt de geschiedenis van CPU- en geheugengebruik bij en stelt nieuwe requests en limits in op basis van deze informatie.
Efficiënt gebruik van rekenkracht is geen gemakkelijke opgave. Het is alsof je voortdurend Tetris speelt. Als je te veel betaalt voor rekenkracht bij een laag gemiddeld gebruik (zeg, ~10 %), raden we aan om naar producten te kijken die gebaseerd zijn op AWS Fargate of Virtual Kubelet. Ze zijn gebouwd op een serverless/pay-per-usage model, wat in dergelijke omstandigheden goedkoper kan zijn.
2. Liveness en readiness probes
Standaard zijn liveness en readiness statuschecks in Kubernetes niet ingeschakeld. En soms vergeten ze ze in te schakelen...
Maar hoe kun je anders de herstart van een service initiëren in het geval van een onherstelbare fout? En hoe weet de load balancer dat een bepaalde pod klaar is om verkeer te ontvangen? Of dat deze meer verkeer kan verwerken?
Deze probes worden vaak met elkaar verward:
- Liveness — de 'levensvatbaarheid'-check, die een pod herstart bij een mislukte beëindiging;
- Readiness — gereedheidsevaluatie, deze schakelt de pod uit van de Kubernetes-service bij een mislukking (dit kan worden gecontroleerd met behulp van
kubectl get endpoints) en het verkeer ernaartoe komt pas binnen zodra de volgende evaluatie succesvol is afgerond.
Beide evaluaties WORDEN UITGEVOERD DOOR DE HELE LEVENSCYCLUS VAN DE POD. Dit is erg belangrijk.
Er is een wijdverbreide misvatting dat readiness probes alleen bij de start worden uitgevoerd, zodat de load balancer kan begrijpen dat de pod gereed is (Klaar) en verkeer kan beginnen te verwerken. Maar dit is slechts één van de toepassingsmogelijkheden.
Een andere is om te kunnen vaststellen dat het verkeer naar de pod te groot is en het overbelast (of de pod uitvoerende rekentaken heeft). In dat geval helpt de readiness-evaluatie de belasting op de pod te verlagen en deze "af te koelen". Een succesvolle voltooiing van de readiness-evaluatie in de toekomst stelt je in staat de belasting op de pod weer te verhogen. In dat geval zou een mislukking van de liveness-evaluatie zeer contraproductief zijn. Waarom een pod opnieuw opstarten die gezond is en hard werkt?
Daarom is het in sommige gevallen beter om helemaal geen evaluaties uit te voeren dan ze in te schakelen met verkeerd geconfigureerde parameters. Zoals eerder gezegd, als de liveness-evaluatie de readiness-evaluatie kopieert, dan heb je een groot probleem. Een mogelijke optie is om , met behulp van 1 bit, gelijk aan 0, terzijde te laten.
Geen van beide type evaluaties zou moeten mislukken bij het falen van gemeenschappelijke afhankelijkheden, anders leidt dat tot een cascade (lawineachtige) uitval van alle pods. Met andere woorden, .
3. LoadBalancer voor elke HTTP-service
Waarschijnlijk heb je HTTP-services in je cluster die je naar de externe wereld wilt doorgeven.
Als je de service als opent type: LoadBalancer, dan zal zijn controller (afhankelijk van de dienstverlener) een externe LoadBalancer aanbieden en overeenkomen (niet noodzakelijkerwijs werkend op L7, maar waarschijnlijker op L4), wat invloed kan hebben op de kosten (externe statische IPv4-adres, rekenkracht, per-seconde facturering) vanwege de noodzaak om een groot aantal van dergelijke middelen te creëren.
In dit geval is het veel logischer om één externe load balancer te gebruiken, door de services als type: NodePortte openen. Of, nog beter, iets als nginx-ingress-controller (of traefik), die zal fungeren als de enige NodePort een endpoint dat is verbonden met een externe load balancer en het verkeer in het cluster zal routeren met behulp van ingress- Kubernetes-resources.
Andere intra-cluster (micro)services die met elkaar interageren, kunnen met elkaar 'communiceren' via services van het type ClusterIP en het ingebouwde servicenetwerkmechanisme via DNS. Gebruik echter niet hun publieke DNS/IP, omdat dit de latency kan beïnvloeden en kan leiden tot hogere kosten voor cloudservices.
4. Autoscaling van het cluster zonder rekening te houden met zijn kenmerken.
Bij het toevoegen of verwijderen van knooppunten in het cluster, moet je niet vertrouwen op enige basisstatistieken zoals het CPU-gebruik op deze knooppunten. Pod-planning moet rekening houden met een aantal beperkingen, zoals pod/node affiniteit, taints en tolerances, resource requests, QoS, enz. Het gebruik van een externe autoscaler die deze nuances negeert, kan problemen veroorzaken.
Stel je voor dat een bepaalde pod moet worden gepland, maar alle beschikbare CPU-mogelijkheden zijn aangevraagd/uitgegeven en de pod blijft vastzitten in de status Pending. De externe autoscaler ziet de gemiddelde huidige CPU belasting (en niet de aangevraagde) en initieert geen uitbreiding (scale-out) — voegt geen extra knooppunt toe. Als gevolg daarvan zal deze pod niet worden gepland.
Aan de andere kant is het terugschalen (scale-in) — het verwijderen van een knooppunt uit het cluster — altijd moeilijker te realiseren. Stel je voor dat je een stateful pod hebt (met een gekoppelde persistente opslag). Persistent volumes behoren meestal tot een bepaalde beschikbaarheidszone en worden niet gerepliceerd in de regio. Als de externe autoscaler dus een knooppunt met deze pod verwijdert, kan de scheduler deze pod niet op een ander knooppunt plannen, aangezien dit alleen kan worden gedaan in die beschikbaarheidszone waar de persistente opslag zich bevindt. De pod blijft vastzitten in de status Pending.
In de Kubernetes-gemeenschap is er veel populariteit voor . Het werkt in het cluster, ondersteunt API's van de belangrijkste cloudleveranciers, houdt rekening met alle beperkingen en kan schalen in de bovengenoemde gevallen. Het kan ook scale-in uitvoeren terwijl alle afgesproken beperkingen worden gehandhaafd, waardoor kosten worden bespaard (die anders zouden worden uitgegeven aan ongebruikte resources).
5. Vernietiging van IAM/RBAC-mogelijkheden
Wees voorzichtig met het gebruik van IAM-gebruikers met permanente geheimen voor machines en applicaties.Organiseer tijdelijke toegang met behulp van rollen en serviceaccounts (serviceaccounts).
We komen vaak tegen dat toegangssleutels (en geheimen) 'hardcoded' zijn in de applicatieconfiguratie, en dat er geen geheimen worden geroteerd, ondanks dat er toegang tot Cloud IAM is. Gebruik IAM-rollen en serviceaccounts in plaats van gebruikers, waar dat passend is.
Vergeet kube2iam en ga direct naar IAM-rollen voor serviceaccounts (zoals beschreven in de Štěpán Vraný):
apiVersion: v1
kind: ServiceAccount
metadata:
  annotations:
    eks.amazonaws.com/role-arn: arn:aws:iam::123456789012:role/my-app-role
  name: my-serviceaccount
  namespace: default
Een annotatie. Niet zo moeilijk, toch?
Bovendien, geef serviceaccounts en instance-profiles geen privileges admin en cluster-admin, als ze daar niet om vragen. Dit is wat complexer om te implementeren, vooral in RBAC K8s, maar het is absoluut de moeite waard.
6. Vertrouw niet op automatische anti-affinity voor pods
Stel je voor dat je drie replicas van een bepaalde deployment op een node hebt. De node crasht, en met hem alle replicas. Dat is vervelend, toch? Maar waarom zaten alle replicas op dezelfde node? Moet Kubernetes niet zorgen voor hoge beschikbaarheid (HA)?!
Helaas houdt de Kubernetes-scheduler niet automatisch rekening met gescheiden bestaan (anti-affinity) voor pods. Dit moet expliciet worden gespecificeerd:
// опущено для краткости
      labels:
        app: zk
// опущено для краткости
      affinity:
        podAntiAffinity:
          requiredDuringSchedulingIgnoredDuringExecution:
            - labelSelector:
                matchExpressions:
                  - key: "app"
                    operator: In
                    values:
                    - zk
              topologyKey: "kubernetes.io/hostname"
Dat is alles. Nu zullen pods op verschillende nodes worden gepland (deze voorwaarde wordt alleen tijdens de planning gecontroleerd, maar niet tijdens hun werking — vandaar de requiredDuringSchedulingIgnoredDuringExecution).
Hier hebben we het over podAntiAffinity op verschillende nodes: topologyKey: "kubernetes.io/hostname", — en niet over verschillende beschikbaarheidszones. Om echte HA te implementeren, moet je dieper in dit onderwerp graven.
7. Negeer PodDisruptionBudget's
Stel je voor dat je een productiebelasting in een Kubernetes-cluster hebt. Periodiek moeten nodes en het cluster zelf worden bijgewerkt (of buiten gebruik worden gesteld). PodDisruptionBudget (PDB) is een soort garantieovereenkomst tussen clusterbeheerders en gebruikers.
PDB helpt om onderbrekingen in de dienstverlening te voorkomen die worden veroorzaakt door een gebrek aan nodes:
apiVersion: policy/v1beta1
kind: PodDisruptionBudget
metadata:
  name: zk-pdb
spec:
  minAvailable: 2
  selector:
    matchLabels:
      app: zookeeper
In dit voorbeeld geef je als gebruiker van het cluster aan de beheerders: "Hé, ik heb een zookeeper-service, en ongeacht wat je doet, wil ik dat er altijd minstens 2 replica's van deze service beschikbaar zijn."
Hierover kun je meer lezen .
8. Meerdere gebruikers of omgevingen in hetzelfde cluster
Kubernetes-namespaces (namespaces) garanderen geen sterke isolatie.
Het is een veelvoorkomende misvatting dat als je een niet-prod belasting in één namespace uitrolt en een prod belasting in een andere, ze geen invloed op elkaar zullen hebben… Maar er kan wel een zeker niveau van isolatie worden bereikt met behulp van aanvragen/beperkingen voor middelen, het instellen van quotum, en het toekennen van priorityClasses. Een zekere "fysieke" isolatie in het datavlak wordt verzekerd door affinities, tolerations, taints (of nodeselectors), maar zo'n scheiding is vrij moeilijk te realiseren.
Degenen die beide soorten werkbelastingen in één cluster moeten combineren, zullen met deze complexiteit moeten leren leven. Als er echter geen behoefte is en je kunt het je veroorloven om een extra cluster op te zetten (bijvoorbeeld in de publieke cloud), dan is dat de beste optie. Dit zal een veel hoger niveau van isolatie bieden.
9. externalTrafficPolicy: Cluster
Vaak zien we dat al het verkeer in het cluster binnenkomt via een service zoals NodePort, waarvoor standaard het beleid is ingesteld op externalTrafficPolicy: Cluster.Dit betekent dat NodePort het op elk knooppunt in het cluster open is, en dat ieder van deze knooppunten kan worden gebruikt om met de gewenste service (set van pods) te communiceren.
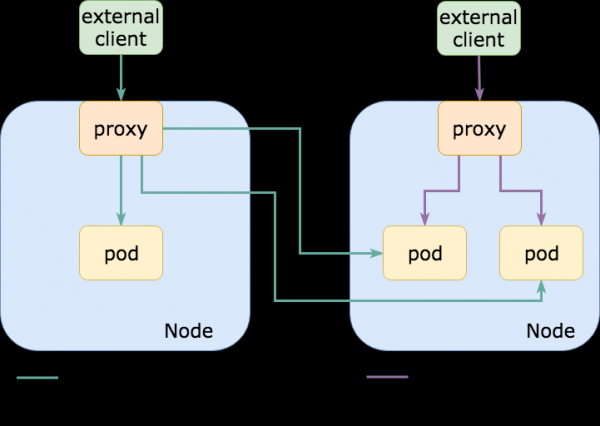
De werkelijke pods die aan de hierboven genoemde NodePort-service zijn gekoppeld, zijn meestal alleen op een subset van deze knooppunten. Met andere woorden, als ik verbinding maak met een knooppunt zonder de benodigde pod, wordt het verkeer doorgestuurd naar een ander knooppunt, waardoor een transitlaad wordt toegevoegd en de latentie toeneemt (als de knooppunten zich in verschillende beschikbaarheidszones/datacenters bevinden, kan de latentie behoorlijk hoog zijn; bovendien zullen de kosten voor egress-verkeer toenemen).
Aan de andere kant, als voor een bepaalde Kubernetes-service het beleid is ingesteld op externalTrafficPolicy: Local,dan wordt de NodePort alleen geopend op die knooppunten waar de benodigde pods daadwerkelijk draaien. Bij het gebruik van een externe load balancer, die de status van (healthchecking) eindpunten controleert (zoals AWS ELB,) zal het verkeer alleen naar de benodigde knooppunten sturen., wat gunstig zal zijn voor latenties, rekenkrachtbehoeften en egress-kosten (gezond verstand dikteert hetzelfde).
Het is zeer waarschijnlijk dat je al iets gebruikt als traefik of nginx-ingress-controller als eindige NodePort-punt (of LoadBalancer, die ook NodePort gebruikt) voor het routeren van HTTP ingress-verkeer, en het instellen van deze optie kan de latentie bij dergelijke verzoeken aanzienlijk verminderen.
In je kunt meer details krijgen over externalTrafficPolicy, de voor- en nadelen.
10. Verbind je niet aan clusters en misbruik het control plane niet
Vroeger werden servers vaak vernoemd naar eigen namen: , HAL9000 en Colossus… Vandaag de dag zijn ze vervangen door willekeurig gegenereerde identificaties. Maar de gewoonte blijft, en nu krijgen clusters de eigen namen.
Een typisch verhaal (gebaseerd op waarheidsgetrouwe gebeurtenissen): het begon met een proof of concept, dus de cluster kreeg de trotse naam testing… Jaren later wordt hij NOG STEEDS in productie gebruikt, en iedereen is bang om hem aan te raken.
Er is niets grappigs aan het feit dat clusters in huisdieren veranderen, dus we raden aan om ze regelmatig te verwijderen, terwijl je oefent met herstel na storingen (dit kan helpen – opmerking vert.)). Bovendien kan het ook geen kwaad om de managementlaag te verzorgen (control plane). Bang zijn om het aan te raken — is geen goed teken. Is Etcd dood? Jongens, jullie zijn echt in de problemen!
Aan de andere kant moet je niet te veel met hem knoeien. Met de tijd kan de managementlaag traag worden.Waarschijnlijk komt dit door het grote aantal objecten dat wordt aangemaakt zonder rotatie (een gebruikelijke situatie bij gebruik van Helm met standaardinstellingen, waardoor de status niet wordt bijgewerkt in configmaps/secrets — als gevolg hiervan stapelen duizenden objecten zich op in de managementlaag) of door constant objecten in kube-api te bewerken (voor autoscaling, voor CI/CD, voor monitoring, logboeken van gebeurtenissen, controllers, enz.).
Daarnaast raden we aan om de SLA/SLO-overeenkomsten met de managed Kubernetes-leverancier te controleren en aandacht te besteden aan garanties. De leverancier kan garanderen de beschikbaarheid van de managementlaag (of zijn subcomponenten), maar niet de p99-latentie van de verzoeken die je naar hem verzendt. Met andere woorden, je kunt invoeren kubectl get nodes, en het antwoord pas na 10 minuten krijgen is geen schending van de serviceovereenkomsten.
11. Bonus: het gebruik van de latest-tag
Dit is al klassiek. De laatste tijd zien we deze techniek niet zo vaak meer, omdat velen, geleerd door bitter ervaring, zijn gestopt met het gebruik van de tag :latest en begonnen zijn versies vast te pinnen. Hoera!
ECR ; we raden aan om deze opmerkelijke functie te bekijken.
Samenvatting
Verwacht niet dat alles met een vingerknip zal werken: Kubernetes is geen wondermiddel. Slechte applicaties (en kunnen zelfs nog slechter worden). Onzorgvuldigheid leidt tot overmatige complexiteit, trage en stressvolle werking van de beheerlaag. Bovendien loop je het risico geen noodherstelstrategie te hebben. Rekening houden met het feit dat Kubernetes 'uit de doos' geen isolatie en hoge beschikbaarheid biedt. Neem de tijd om je applicatie echt cloud native te maken.
Er zijn verschillende teams met mislukte ervaringen over te lezen in van Henning Jacobs.
Wie de lijst met fouten die in dit artikel zijn genoemd, wil aanvullen, kan contact met ons opnemen via Twitter (, ).
P.S. van de vertaler
Lees ook op onze blog:
- «»;
- «»;
- «» (overzicht en video van de presentatie);
- «».
Bron: habr.com
