

Netflix — de marktleider in internettelevisie — is een bedrijf dat dit segment heeft gecreëerd en actief ontwikkelt. Netflix staat niet alleen bekend om zijn uitgebreide catalogus van films en series, die toegankelijk is vanuit bijna elke hoek van de wereld en vanaf elk apparaat met een scherm, maar ook om zijn betrouwbare infrastructuur en unieke engineeringcultuur.
Een duidelijk voorbeeld van Netflix' aanpak van de ontwikkeling en ondersteuning van complexe systemen werd gepresenteerd op DevOops 2019 door — directeur ontwikkeling bij Netflix. Als afgestudeerde van de faculteit Wiskunde en Computerwetenschappen van de Lobachevsky Universiteit in Nizhny Novgorod, is Sergei een van de eerste ingenieurs van Open Connect — het CDN-team van Netflix. Hij heeft monitoring- en video-analyse systemen ontwikkeld, de populaire service voor het meten van internetsnelheid FAST.com gelanceerd en werkt de afgelopen jaren aan het optimaliseren van internetverzoeken, zodat de Netflix-app zo snel mogelijk voor gebruikers functioneert.
De presentatie kreeg de beste recensies van de deelnemers aan de conferentie, en we hebben een tekstversie voor u voorbereid.
In zijn presentatie sprak Sergei uitgebreid over
- wat de vertraging van internetverzoeken tussen klant en server beïnvloedt;
- hoe deze vertraging kan worden verminderd;
- hoe robuuste, foutbestendige systemen te ontwerpen, onderhouden en monitoren;
- hoe resultaten te behalen in korte tijd, met minimaal risico voor het bedrijf;
- hoe resultaten te analyseren en te leren van fouten.
Antwoorden op deze vragen zijn niet alleen nodig voor mensen die in grote bedrijven werken.
De gepresenteerde principes en technieken moeten worden gekend en toegepast door iedereen die internetproducten ontwikkelt en ondersteunt.
Daarna volgt het verhaal vanuit het perspectief van de spreker.
Het belang van internetsnelheid
De snelheid van internetverzoeken staat direct in verband met het bedrijfsleven. Laten we de winkelsector bekijken: in 2009 zei het bedrijf Amazon Er komen steeds meer mobiele apparaten, en daarmee ook mobiele websites en apps. Als uw pagina langer dan 3 seconden laadt, verliest u ongeveer de helft van de gebruikers. Sinds
juli 2018 Verbindingsnelheid is ook belangrijk in financiële instellingen, waar vertraging cruciaal is. In 2015 voltooide het bedrijf Hibernia Networks
De snelheid van de verbinding is ook belangrijk in financiële organisaties, waar vertraging cruciaal is. In 2015 voltooide Hibernia Networks de kabelverbinding tussen New York en Londen kost 400 miljoen dollar, om de vertraging tussen de steden met 6 ms te verminderen. Stel je voor, 66 miljoen dollar voor elke 1 ms vertraging vermindering!
Volgens , de verbinding snelheid boven 5 Mbit/s heeft geen directe invloed meer op de laadsnelheid van een typische website. Er is echter een lineair verband tussen de verbindingsvertraging en de laadsnelheid van de pagina:
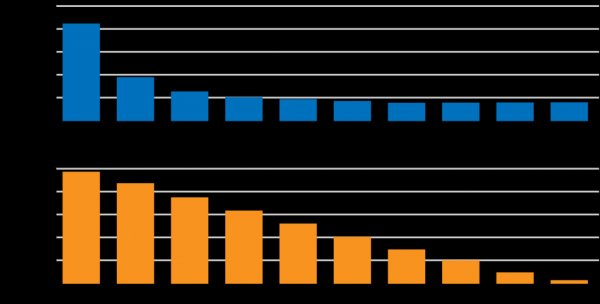
Maar Netflix is geen typisch product. De impact van vertraging en snelheid op de gebruiker is een actieve gebied van analyse en ontwikkeling. Er zijn applicatie laad- en content keuzes die afhankelijk zijn van de vertraging, maar het laden van statische elementen en streaming hangt ook af van de verbindingssnelheid. De analyse en optimalisatie van de sleutel factoren die van invloed zijn op de servicekwaliteit voor de gebruiker is een actief ontwikkelingsgebied van verschillende teams binnen Netflix. Een van de taken is het verminderen van de vertraging van aanvragen tussen Netflix apparaten en de cloudinfrastructuur.
In het rapport zullen we ons specifiek richten op het verminderen van de latency aan de hand van de infrastructuur van Netflix. We zullen vanuit een praktisch perspectief kijken naar hoe we de processen van ontwerp, ontwikkeling en operatie van complexe gedistribueerde systemen moeten benaderen, en tijd moeten besteden aan innovatie en resultaten, in plaats van de diagnostiek van operationele problemen en storingen.
Binnen Netflix
Duizenden verschillende apparaten ondersteunen de Netflix-apps. Vier verschillende teams zijn verantwoordelijk voor de ontwikkeling, die afzonderlijke clientversies maken voor Android, iOS, TV en web browsers. We besteden veel moeite aan het verbeteren en personaliseren van de gebruikersinterface. Hiervoor voeren we tegelijkertijd honderden A/B-tests uit.
Personalisatie wordt ondersteund door honderden microservices in de AWS-cloud, die gepersonaliseerde gegevens voor de gebruiker leveren, verzoeken beheren, telemetrie, Big Data en encoding bieden. De visualisatie van het verkeer ziet eruit als volgt:
Links bevindt zich het entry point, en vervolgens wordt het verkeer verdeeld over meerdere honderden microservices, die door verschillende backendteams worden ondersteund.
Een ander belangrijk onderdeel van onze infrastructuur is Open Connect CDN, dat statische content — video's, afbeeldingen, code voor klanten, enzovoort — tot aan de eindgebruikers levert. De CDN is gevestigd op aangepaste servers (OCA — Open Connect Appliance). Binnenin bevinden zich SSD en HDD arrays, beheerd door geoptimaliseerd FreeBSD, met NGINX en een set van diensten. We ontwerpen en optimaliseren de hardware- en softwarecomponenten zodanig dat de CDN-server zoveel mogelijk data aan gebruikers kan leveren.
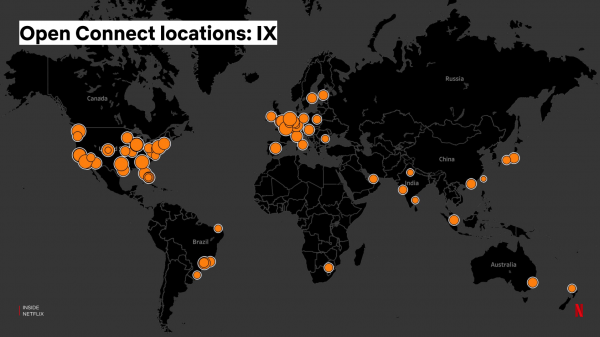
Een "muur" van deze servers op het internetverkeersuitwisselpunt (Internet eXchange — IX), ziet er als volgt uit:
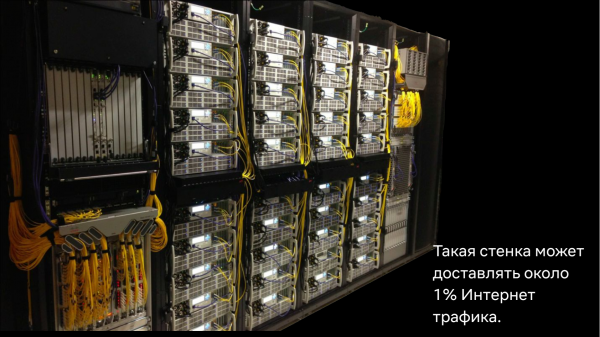
Het Internet Exchange biedt internetproviders en contentleveranciers de mogelijkheid om met elkaar te "verbinden" voor een directere gegevensuitwisseling op het internet. Wereldwijd zijn er ongeveer 70-80 Internet Exchange-punten waar onze servers zijn geïnstalleerd, en wij verzorgen zelf de installatie en het onderhoud:
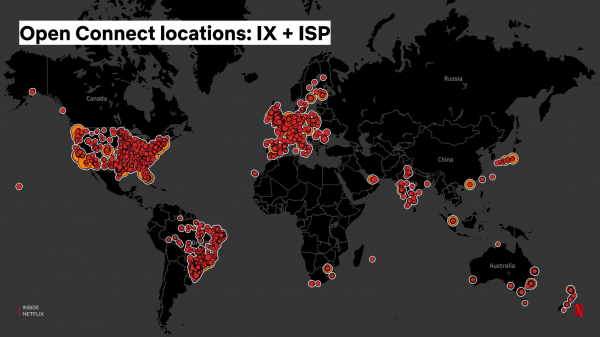
Bovendien bieden we servers ook rechtstreeks aan internetproviders die ze in hun netwerk installeren, waardoor de lokalisatie van Netflix-verkeer en de kwaliteit van streaming voor gebruikers verbetert:
De set AWS-diensten is verantwoordelijk voor het routeren van videorequests van klanten naar de CDN-servers, evenals het configureren van de servers zelf — content, programmatuur, instellingen, enzovoort. Voor dit laatste hebben we ook een backbone network gebouwd, dat servers op Internet Exchange-punten met AWS verbindt. Het backbone network is een wereldwijd netwerk van glasvezelkabels en routers, die we kunnen ontwerpen en configureren op basis van onze behoeften.
Volgens , levert onze CDN-infrastructuur tijdens piekuren ongeveer ⅛ van het wereldwijde internetverkeer en ⅓ van het verkeer in Noord-Amerika, waar Netflix het langst bestaat. Indrukwekkende cijfers, maar voor mij is een van de meest verbazingwekkende prestaties dat het hele CDN-systeem wordt ontwikkeld en onderhouden door een team van nog geen 150 mensen.
Aanvankelijk werd de CDN-infrastructuur ontworpen voor het leveren van videogegevens. Na verloop van tijd realiseerden we ons echter dat we deze ook konden gebruiken voor het optimaliseren van dynamische verzoeken van klanten naar de AWS-cloud.
Over de versnelling van het internet
Vandaag heeft Netflix 3 AWS-regio's, en de vertraging van verzoeken naar de cloud hangt af van hoe ver de klant van de dichtstbijzijnde regio verwijderd is. We hebben echter vele CDN-servers die worden gebruikt voor het leveren van statische content. Is het mogelijk om deze infrastructuur te gebruiken om dynamische verzoeken te versnellen? Helaas kunnen we deze verzoeken niet cachen — de API's zijn gepersonaliseerd en elk resultaat is uniek.
Laten we een proxy op de CDN-server opzetten en het verkeer daarheen leiden. Zal dit sneller zijn?
Materiaal
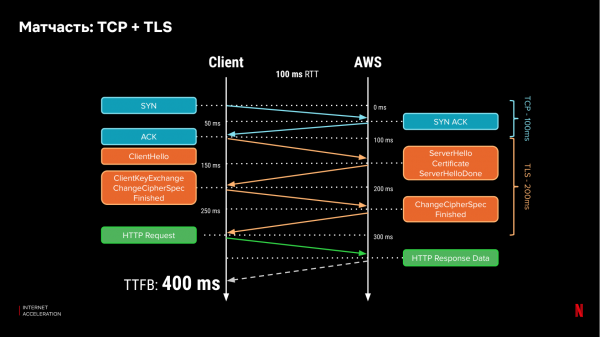
Laten we herinneren hoe netwerksprotocols werken. Vandaag de dag gebruikt het grootste deel van het internetverkeer HTTPs, dat afhangt van de onderliggende protocollen TCP en TLS. Om verbinding te maken met de server voert de client een handshake uit, en om een beveiligde verbinding te maken, moet de client drie keer berichten uitwisselen met de server en nog minstens één keer om gegevens te verzenden. Bij een vertraging van één uitwisseling (RTT) van 100 ms hebben we 400 ms nodig om het eerste bit gegevens te ontvangen:
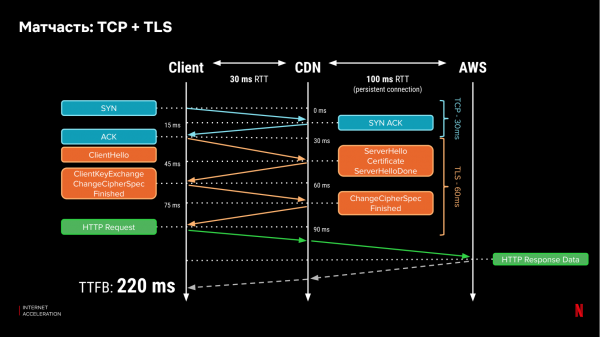
Als we de certificaten op de CDN-server plaatsen, kunnen we de tijd van de ‘handshake’ tussen de klant en de server aanzienlijk verkorten, als de CDN dichterbij is. Laten we aannemen dat de vertraging naar de CDN-server 30 ms bedraagt. Dan hebben we maar 220 ms nodig om het eerste bit te ontvangen:
Maar dat zijn niet de enige voordelen. Nadat de verbinding eenmaal is tot stand gebracht, verhoogt TCP het congestion window (de hoeveelheid informatie die het parallel via deze verbinding kan verzenden). Als er een datapakket verloren gaat, verkleinen klassieke implementaties van het TCP-protocol (zoals TCP New Reno) het open ‘venster’ met de helft. De groei van het congestion window en de snelheid waarmee het zich herstelt van verlies hangt weer af van de vertraging (RTT) naar de server. Als deze verbinding alleen naar de CDN-server gaat, zal dit herstel sneller zijn. Daarbij is pakketverlies een standaardverschijnsel, vooral voor draadloze netwerken.
De internetcapaciteit kan afnemen, vooral tijdens piekuren door het verkeer van gebruikers, wat kan leiden tot 'files'. Er zijn echter geen manieren om prioriteit te geven aan het ene verzoek boven het andere op internet. Bijvoorbeeld, prioriteit geven aan kleine, latency-gevoelige verzoeken boven 'zware' datastromen die het netwerk belasten. In ons geval stelt ons eigen backbone-netwerk ons in staat om dit te doen op een deel van de route van het verzoek — tussen de CDN en de cloud, en we kunnen deze volledig configureren. We kunnen ervoor zorgen dat kleine en latency-gevoelige pakketten prioriteit krijgen, terwijl grote datastromen iets later worden verwerkt. Hoe dichter de CDN bij de klant staat, hoe effectiever het wordt.
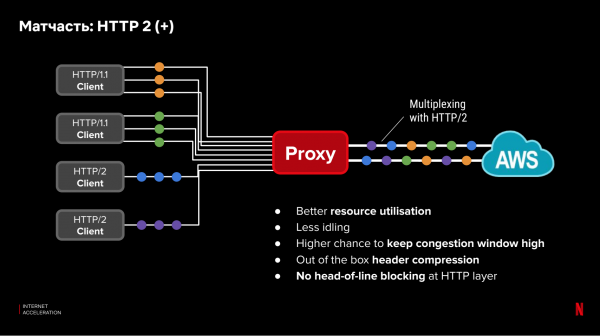
Ook de latentie wordt beïnvloed door applicatieniveau protocollen (OSI Level 7). Nieuwe protocollen, zoals HTTP/2, maken het mogelijk om de prestaties van gelijktijdige verzoeken te optimaliseren. Echter, bij Netflix hebben we klanten met oudere apparaten die deze nieuwe protocollen niet ondersteunen. Niet alle klanten kunnen worden bijgewerkt of optimaal worden geconfigureerd. Tussen de CDN proxy en de cloud hebben we echter volledige controle en de mogelijkheid om nieuwe, optimale protocollen en instellingen te gebruiken. De ondoeltreffende delen met oude protocollen zullen alleen functioneren tussen de klant en de CDN-server. Bovendien kunnen we verzoeken multiplexen over een reeds gevestigde verbinding tussen de CDN en de cloud, waardoor de benutting van de verbinding op TCP-niveau verbetert.
Meten
Hoewel de theorie verbeteringen belooft, springen we niet meteen in de productieomgeving. In plaats daarvan moeten we eerst bewijzen dat het idee in de praktijk zal werken. Hiervoor moeten we een aantal vragen beantwoorden:
- Snelheid: zal de proxy sneller zijn?
- Betrouwbaarheid: zal deze vaker uitvallen?
- Complexiteit: hoe te integreren met applicaties?
- Cost: wat zijn de kosten voor het implementeren van extra infrastructuur?
Laten we onze aanpak voor de eerste vraag in detail bekijken. De andere worden op een vergelijkbare manier behandeld.
Voor de analyse van de snelheid van verzoeken willen we gegevens voor alle gebruikers verzamelen, niet te veel tijd besteden aan ontwikkeling en de productieomgeving niet verstoren. Hiervoor zijn er verschillende benaderingen:
- RUM, of passieve meting van verzoeken. We meten de uitvoeringstijd van huidige verzoeken van gebruikers en zorgen voor volledige gebruikersdekking. Een nadeel is het onbetrouwbare signaal door verschillende factoren, zoals verschillende groottes van verzoeken, verwerkings tijd op de server en client. Daarnaast kan een nieuwe configuratie niet getest worden zonder gevolgen voor de productie.
- Laboratoriumtests. Specifieke servers en infrastructuur die klanten imiteren. Hiermee voeren we de noodzakelijke tests uit. Zo krijgen we volledige controle over de meetresultaten en een duidelijk signaal. Maar er is geen volledige dekking van apparaten en gebruikerslocaties (vooral bij een wereldwijde service en ondersteuning voor duizenden modellen apparaten).
Hoe kunnen we de voordelen van beide methoden combineren?
Ons team heeft een oplossing gevonden. We hebben een klein stuk code — een proef — geschreven die we in onze applicatie hebben geïntegreerd. Proeven stellen ons in staat om volledig gecontroleerde netwerk tests vanuit onze apparaten uit te voeren. Zo werkt het:
- Kort na het laden van de applicatie en het voltooien van de initiële activiteiten starten we onze proeven.
- De cliënt doet een verzoek aan de server en ontvangt een "recept" voor de test. Het recept is een lijst van URL-adressen waarvoor een HTTP(s) verzoek moet worden gedaan. Daarnaast configureert het recept de parameters van de verzoeken: vertragingen tussen verzoeken, hoeveelheid opgevraagde gegevens, HTTP(s) headers, etc. Hiermee kunnen we meerdere verschillende recepten gelijktijdig testen — bij het verzoek om een configuratie wordt willekeurig bepaald welk recept moet worden gegeven.
- De starttijd van de proef wordt gekozen om conflicten met het actieve gebruik van netwerkmiddelen aan de cliënt te vermijden. In wezen wordt de tijd gekozen wanneer de cliënt niet actief is.
- Na ontvangst van het recept doet de cliënt gelijktijdig verzoeken naar elk van de URL-adressen. Een verzoek naar elk van de adressen kan worden herhaald — zogenaamde "pulsen". Bij de eerste puls meten we hoe lang het duurde om de verbinding op te zetten en gegevens te downloaden. Bij de tweede puls meten we de laadtijd van gegevens via de al opgezetten verbinding. Voor de derde kunnen we een vertraging instellen en de snelheid van het opnieuw tot stand brengen van de verbinding meten, enz.
Tijdens de test meten we alle parameters die het apparaat kan verkrijgen:
- de tijd van de DNS-aanvraag;
- de tijd om een TCP-verbinding tot stand te brengen;
- de tijd om een TLS-verbinding tot stand te brengen;
- de tijd tot het ontvangen van de eerste byte gegevens;
- de totale laadtijd;
- de statuscode van het resultaat.
- Na afloop van alle pulse verzamelt de test de resultaten van alle metingen voor analyse.
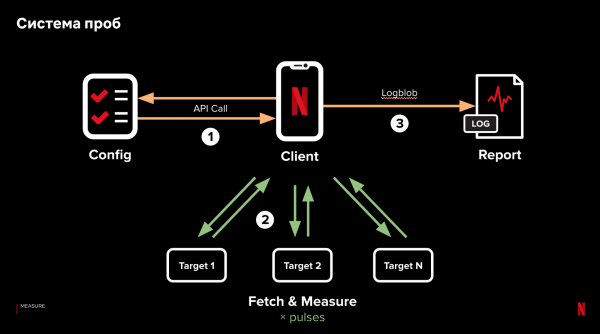
De sleutelpunten zijn minimale afhankelijkheid van de logica aan de clientzijde, gegevensverwerking aan de serverzijde en het meten van parallelle aanvragen. Op deze manier krijgen we de mogelijkheid om de invloed van verschillende factoren die van invloed zijn op de prestaties van aanvragen te isoleren en te testen, deze binnen één recept te variëren en resultaten te behalen met echte klanten.
Deze infrastructuur bleek niet alleen nuttig te zijn voor de analyse van de prestaties van aanvragen. Op dit moment hebben we 14 actieve recepten, meer dan 6000 monsters per seconde, die gegevens verzamelen van over de hele wereld met een volledige dekking van apparaten. Als Netflix een dergelijke service van derde partijen zou kopen, zou dat miljoenen dollars per jaar kosten met veel slechtere dekking.
We testen de theorie in de praktijk: prototype
Met een dergelijk systeem hebben we de mogelijkheid gekregen om de efficiëntie van de CDN-proxy op vertraging van aanvragen te beoordelen. Nu moeten we:
- een proxy-prototype creëren;
- het prototype op de CDN plaatsen;
- bepalen hoe klanten naar de proxy op een specifieke CDN-server te leiden;
- de prestaties vergelijken met aanvragen in AWS zonder proxy.
De taak is om de efficiëntie van de voorgestelde oplossing zo snel mogelijk te beoordelen. Voor de implementatie van het prototype hebben we gekozen voor Go, dankzij de aanwezigheid van goede netwerklibraries. Op elke CDN-server hebben we het proxy-prototype geïnstalleerd als een statische binary om de afhankelijkheden te minimaliseren en de integratie te vereenvoudigen. In de initiële implementatie hebben we zoveel mogelijk gebruik gemaakt van standaardcomponenten en kleine aanpassingen voor HTTP/2 connection pooling en request multiplexing.
Voor de balans tussen AWS-regio's hebben we een geografische DNS-database gebruikt, dezelfde als die voor de belasting van klanten wordt gebruikt. Voor het kiezen van de CDN-server voor de klant gebruiken we TCP Anycast voor servers in het Internet Exchange (IX). In dit geval gebruiken we één IP-adres voor alle CDN-servers, waarbij de klant wordt doorgestuurd naar de CDN-server met het minste aantal IP-hops. Voor de CDN-servers die bij internetproviders (ISP's) zijn geïnstalleerd, hebben we geen controle over de router voor het configureren van TCP Anycast, dus maken we gebruik van , waardoor klanten naar internetproviders worden geleid voor videostreaming.
Dus, we hebben drie soorten paden voor het verzoek: naar de cloud via het openbare internet, via een CDN-server in IX of via een CDN-server gevestigd bij de internetprovider. Ons doel is om te begrijpen welk pad beter is en welke voordelen proxies bieden in vergelijking met hoe verzoeken naar productie worden geleid. Hiervoor gebruiken we het systeem van probes als volgt:
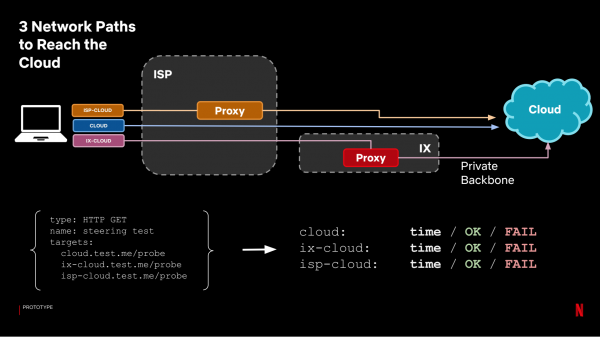
Ieder van de paden wordt een aparte target en we kijken naar de tijd die we hebben behaald. Voor de analyse combineren we de proxyresultaten in één groep (we kiezen de beste tijd tussen IX en ISP-proxy) en vergelijken we dit met de tijd van verzoeken naar de cloud zonder proxy:
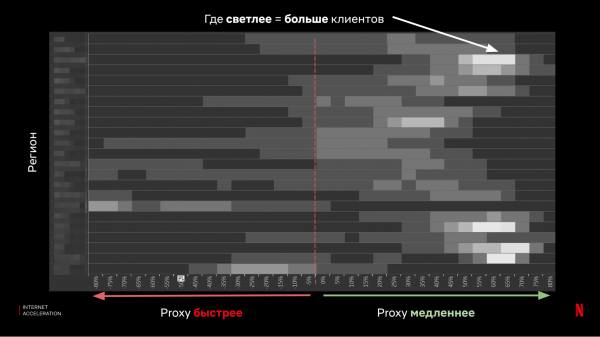
Zoals te zien is, zijn de resultaten dubbelzinnig — in de meeste gevallen biedt de proxy een goede versnelling, maar er zijn ook genoeg klanten voor wie de situatie aanzienlijk verslechtert.
Uiteindelijk hebben we een paar belangrijke dingen gedaan:
- We hebben de verwachte prestaties van verzoeken van klanten naar de cloud via de CDN-proxy beoordeeld.
- We hebben gegevens verzameld van echte klanten, van alle soorten apparaten.
- We hebben begrepen dat de theorie niet voor 100% bevestigd kon worden en dat het oorspronkelijke voorstel voor een CDN-proxy voor ons niet zal werken.
- We hebben geen risico's genomen — we hebben de productieconfiguraties voor klanten niet gewijzigd.
- We hebben niets kapotgemaakt.
Prototype 2.0
Dus, we gaan terug naar het bord en herhalen het proces opnieuw.
Het idee is — in plaats van 100% proxy, zullen we voor elke klant de snelste route bepalen en de verzoeken daarheen sturen — dat wil zeggen, we zullen doen wat client steering wordt genoemd.
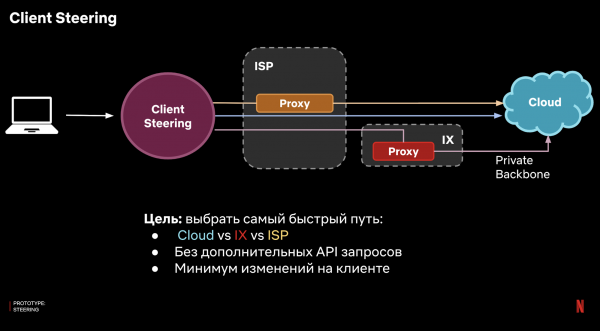
Hoe dit te realiseren? We kunnen geen logica aan de serverzijde gebruiken, omdat het doel is om verbinding te maken met deze server. We moeten dit op de een of andere manier aan de clientzijde doen. En idealiter moet dit gebeuren met een minimal hoeveelheid complexe logica, om te voorkomen dat we integratieproblemen met een breed scala aan clientplatforms oplossen.
Het antwoord is het gebruik van DNS. In ons geval hebben we onze eigen DNS-infrastructuur en kunnen we een domeinzones instellen waarvoor onze servers autoritatief zullen zijn. Dit werkt als volgt:
- De client doet een verzoek naar de DNS-server met behulp van de host, bijvoorbeeld api.netflix.com.
- Het verzoek komt binnen op onze DNS-server.
- De DNS-server weet wat de snelste route voor deze client is en geeft het bijbehorende IP-adres.
In de oplossing is er een extra complicatie: autoritatieve DNS-providers zien het IP-adres van de client niet en kunnen alleen het IP-adres van de recursieve resolver zien die door de client wordt gebruikt.
Uiteindelijk moet onze autoritatieve resolver een beslissing nemen niet voor een enkele client, maar voor een groep clients op basis van de recursieve resolver.
Voor de oplossing gebruiken we dezelfde probes, aggregeren we de meetresultaten van clients per recursieve resolver en beslissen we waar we deze groep naartoe sturen — via proxy over IX met behulp van TCP Anycast, via ISP-proxy of rechtstreeks naar de cloud.
We krijgen zo een systeem:
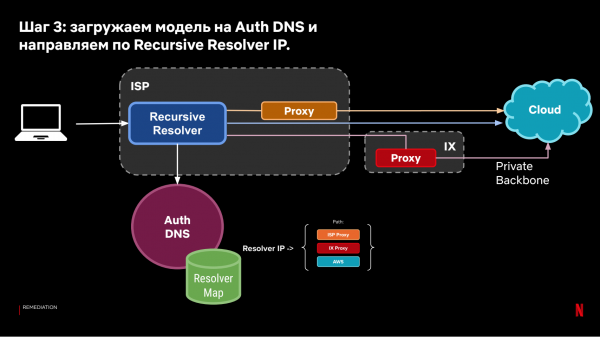
Het verkregen model van DNS-sturing stelt ons in staat om clients te sturen op basis van historische observaties van de verbindingssnelheden van clients naar de cloud.
Nogmaals, de vraag is: hoe effectief zal deze aanpak zijn? Om deze vraag te beantwoorden, gebruiken we opnieuw ons systeem van probes. Daarom stellen we de recente configuratie in, waarbij een van de doelen de richting van DNS-sturing volgt, terwijl de andere rechtstreeks naar de cloud gaat (huidige productie).
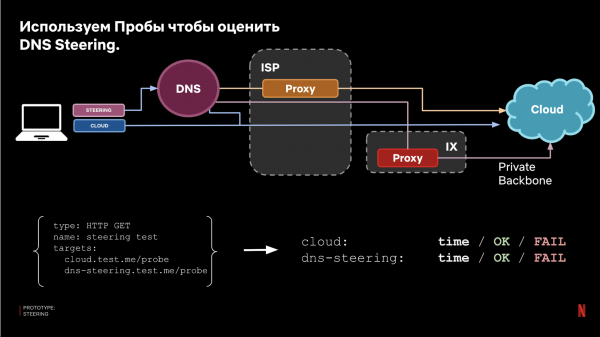
Uiteindelijk vergelijken we de resultaten en krijgen we een beoordeling van de effectiviteit:
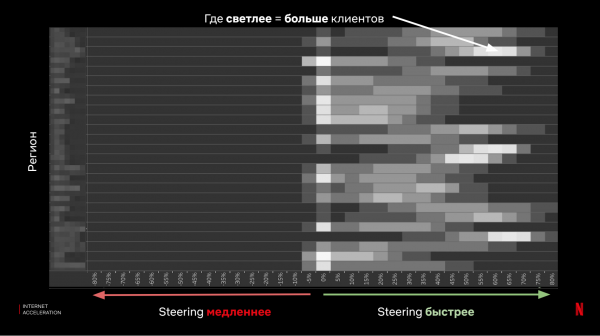
Uiteindelijk hebben we een paar belangrijke dingen geleerd:
- We hebben de verwachte prestaties van verzoeken van clients naar de cloud met behulp van DNS-sturing beoordeeld.
- We hebben gegevens verzameld van echte klanten, van alle soorten apparaten.
- We hebben de effectiviteit van het voorgestelde idee bewezen.
- We hebben geen risico's genomen — we hebben de productieconfiguraties voor klanten niet gewijzigd.
- We hebben niets kapotgemaakt.
Nu komt het moeilijke gedeelte — we starten in productie.
Het moeilijkste staat nu achter ons — er is een werkend prototype. Nu komt het lastige deel — de oplossing voor al het Netflix-verkeer uitrollen, voor 150 miljoen gebruikers, duizenden apparaten, honderden microservices en een voortdurend veranderend product en infrastructuur. De servers van Netflix ontvangen miljoenen verzoeken per seconde, en het is gemakkelijk om de service te breken door een ondoordachte actie. Ondertussen willen we het verkeer dynamisch leiden via duizenden CDN-servers, in een internet waar alles constant verandert en breekt, vaak op het slechtst mogelijke moment.
En met dit alles bestaat het team uit 3 ingenieurs die verantwoordelijk zijn voor de ontwikkeling, uitrol en volledige ondersteuning van het systeem.
Daarom gaan we het nu hebben over een rustige en gezonde nachtrust.
Hoe blijven we ontwikkelen zonder al onze tijd aan ondersteuning te besteden? Onze aanpak is gebaseerd op 3 principes:
- We verkleinen de mogelijke omvang van storingen (blast radius).
- We bereiden ons voor op verrassingen — we verwachten dat er iets kapot gaat, ondanks tests en persoonlijke ervaring.
- Geleidelijke degradatie (graceful degradation) — als er iets niet werkt zoals het hoort, moet het automatisch worden hersteld, ook al is het niet de meest efficiënte manier.
Het bleek dat we in ons geval, met deze aanpak van het probleem, een eenvoudige en effectieve oplossing konden vinden die de ondersteuning van het systeem aanzienlijk vereenvoudigde. We realiseerden ons dat we een klein stukje code aan de client konden toevoegen en de netwerkfouten die werden veroorzaakt door verbindingsproblemen konden volgen. Bij netwerkfouten maken we een fallback direct naar de cloud. Deze oplossing vereist niet veel inspanning van de klantenteams, maar vermindert het risico van onverwachte storingen en verrassingen voor ons sterk.
Uiteraard, ondanks de fallback, volgen we toch een strikte discipline tijdens de ontwikkeling:
- Test op monsters.
- A/B-testen of Canaries.
- Geleidelijke uitrol (progressive rollout).
Met de monsters werd de aanpak beschreven — wijzigingen worden eerst getest met behulp van een ingestelde maatregel.
Voor canary-testen moeten we vergelijkbare serverparen krijgen waarop we kunnen vergelijken hoe het systeem werkt voor en na de wijzigingen. Hiervoor maken we een selectie van paar servers uit onze talloze CDN-sites die vergelijkbaar verkeer ontvangen:
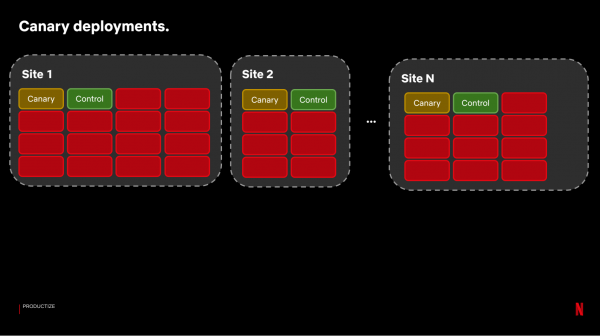
Daarna plaatsen we de opbouw met wijzigingen op de Canary-servers. Om de resultaten te evalueren, starten we een systeem dat ongeveer 100-150 metrics vergelijkt met gegevens van de Control-servers:
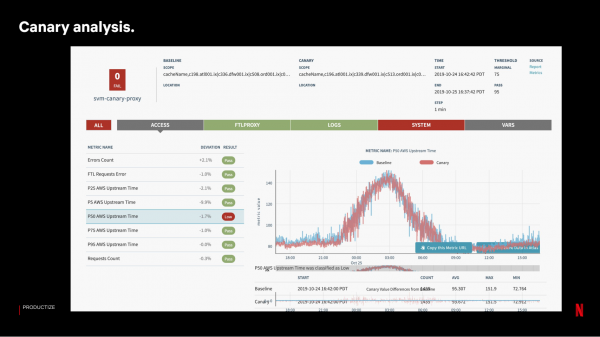
Als de Canary-test succesvol is verlopen, brengen we de release geleidelijk uit, in fasen. Op elk van de sites updaten we de servers niet tegelijkertijd — het verlies van een complete site in geval van problemen heeft een grotere impact op de service voor gebruikers dan het verlies van een gelijke hoeveelheid servers op verschillende locaties.
Over het algemeen hangt de effectiviteit en veiligheid van deze aanpak af van de hoeveelheid en kwaliteit van de verzamelde metrics. Voor ons systeem voor het versnellen van verzoeken verzamelen we metrics van alle mogelijke componenten:
- van klanten — aantal sessies en verzoeken, fallback rates;
- proxy's — statistieken over aantal en duur van verzoeken;
- DNS — aantal en resultaten van verzoeken;
- cloud edge — aantal en tijd voor het verwerken van verzoeken in de cloud.
Al deze gegevens worden verzameld in een enkele pipeline, en afhankelijk van de behoeften beslissen we welke metrics we doorsturen naar real-time analytics en welke we naar Elasticsearch of Big Data voor gedetailleerde diagnose.
We monitoren
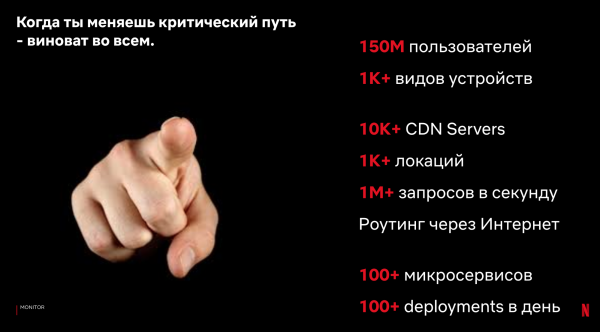
In ons geval brengen we wijzigingen aan in de kritische route van verzoeken tussen de klant en de server. Daarbij is het aantal verschillende componenten aan de klantkant, serverkant, en op de route via het internet enorm. Wijzigingen aan de klant en server vinden continu plaats — door het werk van tientallen teams en natuurlijke veranderingen in het ecosysteem. Wij zitten ertussenin — bij de diagnose van problemen is de kans groot dat we hierbij betrokken zijn. Daarom moeten we duidelijk begrijpen hoe we metrics moeten definiëren, verzamelen en analyseren voor een snelle probleemlocatie.
Ideaal gezien hebben we volledige toegang tot alle soorten metrics en filters in real-time. Maar er zijn enorm veel metrics, dus de vraag van kosten komt op. In ons geval splitsen we de metrics en ontwikkeltools als volgt op:
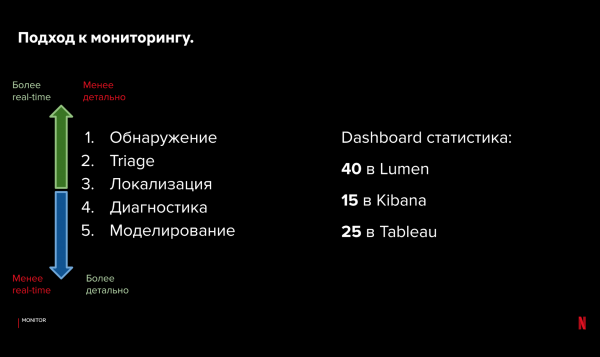
Voor het opsporen en triage van problemen gebruiken we ons eigen real-time systeem met open source en — voor visualisatie. Dit systeem slaat geaggregeerde metrics in het geheugen op, is betrouwbaar en integreert met het alerting-systeem. Voor probleemlocatie en diagnose hebben we toegang tot logs met Elasticsearch en Kibana. Voor statistische analyse en modellering — maken we gebruik van big data en visualisatie in Tableau.
Het lijkt heel moeilijk om met deze aanpak te werken. Maar met een hiërarchische organisatie van metrics en tools kunnen we snel het probleem analyseren, het type probleem bepalen en vervolgens dieper ingaan op de gedetailleerde metrics. Om de oorzaak van de storing te identificeren, besteden we meestal zo'n 1-2 minuten. Daarna werken we al met een specifiek team aan de diagnose — van enkele tientallen minuten tot enkele uren.
Ook al gebeurt de diagnose snel, we willen niet dat dit vaak voorkomt. Idealiter ontvangen we een kritieke waarschuwing alleen wanneer er een significante impact op de service is. Voor ons verzoekversnelling systeem hebben we slechts 2 waarschuwingen die ons op de hoogte houden:
- percentage Client Fallback — een beoordeling van het gedrag van klanten;
- percentage Probe errors — gegevens over de stabiliteit van netwerkcomponenten.
Deze kritieke waarschuwingen houden in de gaten of het systeem werkt voor de meeste gebruikers. We kijken naar het aantal klanten dat fallback heeft gebruikt als ze de verzoekversnelling niet konden verkrijgen. Gemiddeld hebben we minder dan 1 kritieke waarschuwing per week, hoewel er ontzettend veel veranderingen in het systeem plaatsvinden. Waarom is dit voldoende voor ons?
- Er is client fallback in het geval dat onze proxy niet werkt.
- Er is een automatisch stuurprogramma systeem dat reageert op problemen.
Daarover meer. Ons prob systeem en het systeem voor automatische optimalisatie van de route voor verzoeken van de klant naar de cloud, stellen ons in staat om automatisch enkele problemen aan te pakken.
Laten we teruggaan naar onze configuratie van probes en de 3 categorieën van wegen. Naast de laadtijd kunnen we ook kijken naar het feit van de levering zelf. Als het niet gelukt is om gegevens te laden, kunnen we door naar de resultaten van verschillende wegen te kijken, bepalen waar en wat is misgegaan, en of we dit automatisch kunnen repareren door het pad van het verzoek te wijzigen.
Voorbeelden:
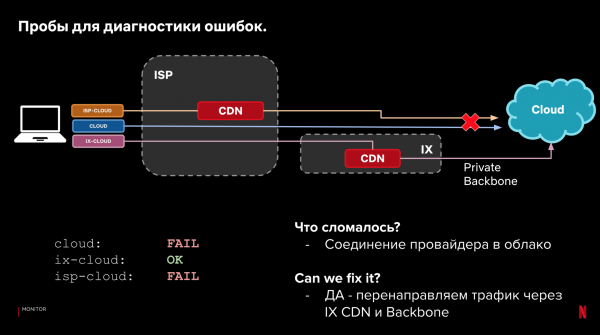
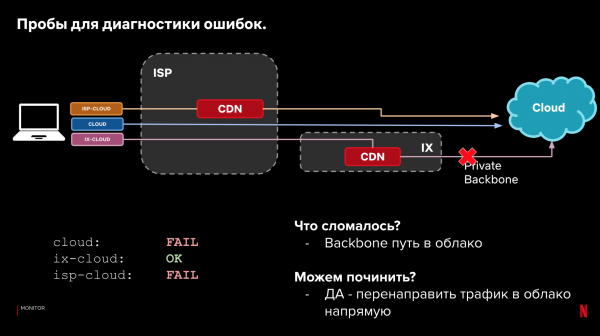
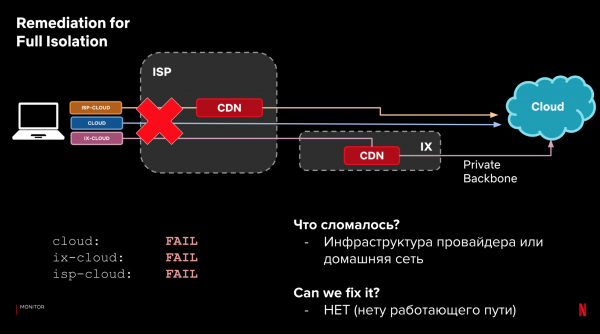
Dit proces kan worden geautomatiseerd. Het kan worden opgenomen in het stuurprogramma systeem. En we kunnen het leren reageren op problemen met prestaties en betrouwbaarheid. Als er iets begint te falen — reageren als er een betere optie is. Een onmiddellijke reactie is daarbij niet kritisch, dankzij de fallback bij de klanten.
Dus de principes voor systeemondersteuning kunnen als volgt worden geformuleerd:
- we verkleinen de schaal van storingen;
- we verzamelen metrics;
- we repareren storingen automatisch, als we kunnen;
- als we dat niet kunnen — geven we een waarschuwing;
- We are working on dashboards and a triage toolset for quick response.
Lessons learned
Creating a prototype doesn’t take much time. In our case, it was ready in just 4 months. With it, we gathered new metrics, and after 10 months from the start of development, we received our first production traffic. Then began the tedious and very complex work: gradually productizing and scaling the system, migrating the main traffic, and learning from mistakes. This efficient process will not be linear — despite all efforts, you cannot foresee everything. A much more effective strategy is rapid iteration and responding to new data.
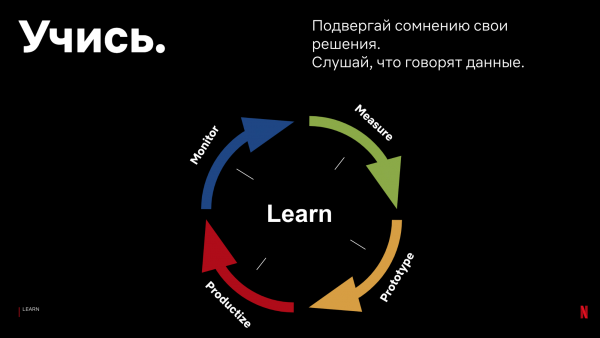
Based on our experience, we can advise the following:
- Don't trust your intuition.
Our intuition constantly let us down, despite the extensive experience of the team members. For example, we incorrectly predicted the expected acceleration from using a CDN proxy, or the behavior of TCP Anycast.
- Get data from production.
It's important to quickly gain access to at least a small amount of production data. The number of unique cases, configurations, and settings in lab conditions is nearly impossible to achieve. Quick access to results will allow you to learn more quickly about potential issues and consider them in the architecture of the system.
- Don't follow others' advice and results — collect your own data.
Follow the principles of data collection and analysis, but don't blindly take others' results and claims. Only you can know what works for your users. Your systems and your clients may differ significantly from those of other companies. Fortunately, analysis tools are now available and easy to use. The results you obtain may not correspond to what Netflix, Facebook, Akamai, and other companies claim. In our case, TLS performance, HTTP2, or DNS request statistics differ from the results of Facebook, Uber, Akamai — because we have different devices, clients, and data streams.
- Don't chase trendy techniques unnecessarily and without evaluating effectiveness.
Start simple. It's better to have a simple working system in a short time than to spend an enormous amount of time developing components you don’t need. Address tasks and problems that are important based on your measurements and results.
- Wees voorbereid op nieuwe toepassingen.
Net zoals het moeilijk is om alle problemen te voorzien, is het ook moeilijk om de voordelen en toepassingen vooraf te voorspellen. Kijk naar startups — hun vermogen om zich aan te passen aan de behoeften van klanten. In jouw geval kun je nieuwe problemen en oplossingen ontdekken. In ons project stelden we ons als doel om de latentie van verzoeken te verminderen. Echter, tijdens de analyse en discussies realiseerden we ons dat we proxyservers ook konden toepassen:
- voor het balanceren van het verkeer over AWS-regio's en het verminderen van kosten;
- voor het modelleren van de stabiliteit van CDN;
- voor het configureren van DNS;
- voor het configureren van TLS/TCP.
Conclusie
In mijn presentatie heb ik beschreven hoe Netflix het probleem oplost van het versnellen van internetverzoeken tussen klanten en de cloud. Hoe we gegevens verzamelen met behulp van een systeem van steekproeven bij klanten, en de verzamelde historische gegevens gebruiken om productieverzoeken van klanten via de snelste route op internet te leiden. Hoe we de principes van netwerkprotocollen, onze CDN-infrastructuur, de backbone-netwerk en DNS-servers gebruiken om deze taak te bereiken.
Onze oplossing is echter slechts een voorbeeld van hoe wij bij Netflix een dergelijk systeem hebben geïmplementeerd. Wat voor ons heeft gewerkt. Het praktische deel van mijn presentatie voor jou zijn de ontwikkelingsprincipes en -ondersteuning die wij volgen en waarmee we goede resultaten bereiken.
Onze oplossing voor jouw probleem is misschien niet geschikt. Echter, de theorie en de ontwikkelingsprincipes blijven bestaan, zelfs als je geen eigen CDN-infrastructuur hebt, of als deze wezenlijk verschilt van de onze.
De snelheid van verzoeken blijft ook belangrijk voor het bedrijfsleven. En zelfs voor een eenvoudige dienst moet je de keuze maken tussen 'cloud' providers, de locatie van servers, CDN en DNS-providers. Jouw keuze zal invloed hebben op de efficiëntie van internetverzoeken voor jouw klanten. Het is belangrijk voor jou om deze impact te meten en te begrijpen.
Begin met eenvoudige oplossingen, let op hoe je het product verandert. Leer in het proces en verbeter het systeem op basis van gegevens van jouw klanten, jouw infrastructuur en jouw bedrijf. Denk na over de mogelijkheid van onverwachte storingen tijdens het ontwerpproces. Dan kun je je ontwikkelingsproces versnellen, de efficiëntie van oplossingen verbeteren, overbelasting van de ondersteuning vermijden en rustig slapen.
Dit jaar in online-formaat. U kunt vragen stellen aan een van de vaders van DevOps, namelijk John Willis!
Bron: habr.com
