

Twee jaar geleden heb ik al een bericht geschreven over . Nu is er enige ontwikkeling van het project en ik heb ook de onder , daarom besloot ik om deze kleine review op Habrahabr te schrijven.
[ ]
Wie kan hierin geïnteresseerd zijn
Dit kan interessant zijn voor u als u met een klein team werkt of helemaal alleen. U heeft geen monitoring en weet niet zeker of het echt nodig is. Of u heeft geprobeerd een populaire, serieuze monitoring ‘voor grote jongens’, maar het werkte voor u eigenlijk niet, of het werkt in bijna de standaardconfiguratie en heeft uw leven niet echt veranderd. En ook — als u niet van plan bent om een volledige medewerker (of zelfs een afdeling) toe te wijzen om minstens een paar uur per dag de monitoring-dashboard te bekijken of in te stellen.
Wat maakt okerr ongebruikelijk
Verder zal ik interessante kenmerken van okerr laten zien die het onderscheiden van enkele andere monitoringtools.
Okerr is een hybride monitoring
Bij interne monitoring draait er een 'agent' op de waargenomen machines die gegevens naar de monitoringserver verzendt (bijvoorbeeld vrije schijfruimte). Bij externe monitoring voert de server netwerkcontroles uit (bijvoorbeeld ping of toegankelijkheid van de website). Elke benadering heeft zijn eigen beperkingen. Okerr maakt gebruik van beide opties. De controles binnen servers worden uitgevoerd door een zeer lichte (30Kb) agent of uw eigen scripts en applicaties, terwijl netwerkcontroles worden uitgevoerd via okerr-sensoren in verschillende landen.
okerr is niet alleen software, maar ook een service
De serverkant van elke monitoring is groot en complex, het is moeilijk te installeren en in te stellen, het vereist middelen. Met okerr kunt u uw eigen monitoringserver installeren (het is gratis en open-source), of u kunt alleen de klantkant gebruiken en de service van onze server gebruiken. Ook gratis.
Als monitoring kan compenseren en het gebrek aan betrouwbaarheid van servers en applicaties kan verbergen, rijst de filosofische vraag — wie bewaakt de bewaker? Hoe zal monitoring ons informeren over een probleem, als het zelf om de een of andere reden 'is overleden', afzonderlijk of samen met andere bronnen (bijvoorbeeld als de verbinding naar het datacenter uitvalt)? Met de externe service okerr wordt dit probleem opgelost — je ontvangt een alert, zelfs als het hele datacenter met jouw servers zonder stroom komt te zitten of wordt aangevallen door zombies.
Natuurlijk is er het risico dat de server van okerr zelf niet bereikbaar is, dat klopt (zoals bekend, 90% betrouwbaarheid komt altijd eenvoudig en 'gratis', 99% met minimale inspanning, en elke volgende negen is exponentieel moeilijker). Maar ten eerste is de kans daarop kleiner, en ten tweede kan het probleem onopgemerkt blijven, tenzij het samenvallt met problemen op onze servers. Als wij 99,9% betrouwbaarheid hebben, en jij ook 99,9% (dat zijn geen al te hoge cijfers), dan is de kans op een onopgemerkte storing — 0,1% van 0,1% = 0,0001%. Drie nines aan betrouwbaarheid bijna zonder moeite en kosten toevoegen — dat is heel netjes!
Een ander voordeel van monitoring als service is dat de hostingprovider of webstudio okerr-server kan installeren en toegang kan bieden aan klanten als een betaalde of gratis aanvullende dienst. Je concurrenten hebben gewoon hosting en websites — jij hebt betrouwbare hosting met monitoring.
Okerr — dat gaat over indicatoren.
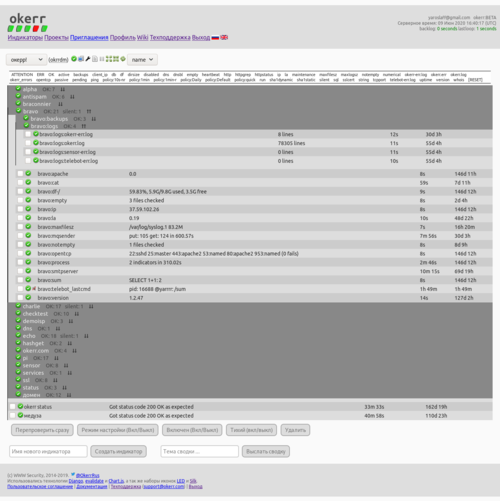
Een indicator is een 'lampje'. Het heeft twee belangrijkste toestanden — groen (OK) of rood (ERR). In het project zijn er veel gegroepeerde indicatoren (bijvoorbeeld per server). Op de hoofdpagina van het project zie je meteen of alles groen is (en je kunt sluiten) of dat er iets rood brandt en gecorrigeerd moet worden. Bij het wisselen tussen deze toestanden wordt er een melding verzonden. Eén keer per dag, terwijl je het instelt — wordt er een samenvatting van het project verzonden.
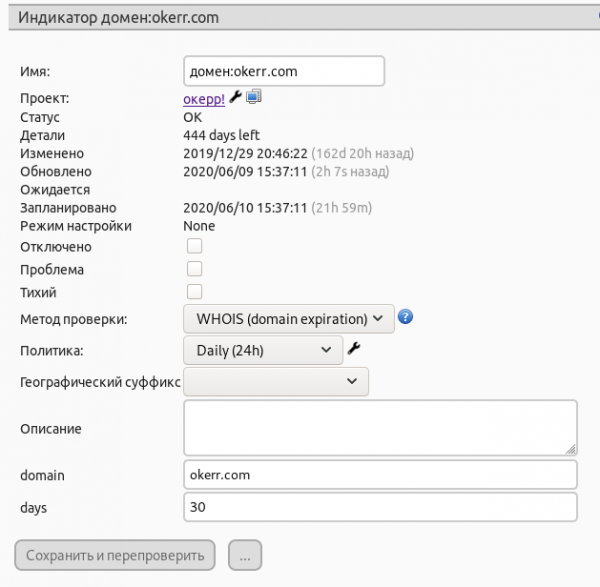
Elke indicator van okerr heeft ingebouwde voorwaarden waarop het zijn status verandert (in Zabbix wordt dit trigger genoemd). Bijvoorbeeld, de load average mag niet hoger zijn dan 2 (natuurlijk is dit instelbaar). En voor elke interne controle (load average, schijfruimte vrij, …) is er een watchdog. Als we om een of andere reden niet binnen de afgesproken tijd een succesvolle bevestiging hebben ontvangen — wordt er een fout geregistreerd en een alert verzonden.
Onze gebruikelijke werkwijze is dat we 's ochtends de e-mail controleren, waar we onder andere een samenvatting bekijken (de tijd daarvoor stellen we in aan het begin van de werkdag). Als alles in orde is, besteden we tijd aan andere belangrijke zaken (maar we kunnen voor de zekerheid snel het Okerr-dashboard bekijken om er zeker van te zijn dat alles op dat moment groen is). Als er een alert binnenkomt, reageren we daarop.
Natuurlijk is het mogelijk om gewoon ‘informatie’ indicatoren te hebben (om een beeld van het netwerk vanuit de monitoring te zien), maar alles is zo gedaan dat je eenvoudig, snel en gemakkelijk indicatoren kunt maken voor automatische monitoring en het verzenden van alerts.
De reden waarom je Okerr instelt, is voor de alerts, zodat je in één minuut een indicator kunt maken. Deze kan een jaar ‘slapen’, gewoon updates ontvangen, en wanneer er over een jaar iets kapotgaat, gaat hij branden en stuurt hij een alert. De minuut die je eenmaal aan het maken van een indicator hebt besteed, heeft zich terugbetaald; je hoorde als eerste over het probleem. Wellicht hebben jullie het opgelost voordat iemand anders het opmerkte. Snel hersteld wordt niet als gevallen beschouwd!
Beveiliging
Het zou jammer zijn als je monitoring instelt voor hogere betrouwbaarheid, maar vervolgens via deze gemonitord wordt en dat er behoorlijk veel netwerkwijzigingen zijn in verschillende monitoringtools (, ).
Agent (okerrmod uit het pakket ) draait op de systemen — dit is geen netwerkserver, maar een client. Daarom zijn er geen extra open poorten op de geobserveerde server; de client werkt eenvoudig achter een firewall of NAT en is heel moeilijk (ik zou zeggen ‘bijna onmogelijk’) via het netwerk te hacken, omdat hij in principe geen netwerk socket luister.
Volledige monitoringdekking
Momenteel hebben we de regel - we horen over alle technische problemen via Okerr. Als de regel wordt geschonden (Okerr heeft niet gewaarschuwd voor een op handen zijnde gebeurtenis (indien mogelijk) of dat deze al heeft plaatsgevonden) - dan voegen we controles toe in Okerr.
Externe controles
Een vrij typische set:
- ping
- http status
- controle van de geldigheid en actualiteit van het SSL-certificaat (waarschuwt als de vervaldatum nadert)
- open TCP-poort en de banner daarop
- http grep (er moet [geen] bepaalde tekst op de pagina staan)
- sha1 hash om pagina-aanpassingen te detecteren.
- DNS (DNS-record moet een bepaalde waarde hebben)
- WHOIS (waarschuwt als het domein binnenkort verloopt)
- Antispam DNSBL (controleert de host meteen tegen 50+ anti-spam blacklists)
Interne controles
Ook een vrij typische set (maar gemakkelijk uitbreidbaar).
- df (beschikbare schijfruimte)
- load average
- opentcp (open luisterende TCP-sockets — waarschuwt als er iets is gestart of is neergestort)
- uptime — simpele uptime van de server. Waarschuwt als het naar beneden verandert (d.w.z. als de server opnieuw is opgestart)
- client_ip
- dirsize — we gebruiken het om bij te houden wanneer onze rootfs van virtuele machines boven de toegestane grootte uitkomen, zonder strikte limieten in te stellen, en om de grootte van gebruikers thuiscatalogi bij te houden.
- empty en nonempty — houden toezicht op bestanden die leeg (of niet leeg) moeten zijn. Bijvoorbeeld, de error log van de server okerr — moet leeg zijn, en als er ook maar een regel in staat — ontvang ik een melding en controleer ik. De mail.log op de mailserver moet NIET leeg zijn (door N minuten na rotatie). Soms was het leeg na een systeemupdate, wanneer logrotate rsyslog niet correct opnieuw kon opstarten.
- linecount — aantal regels in het bestand (zoals wc -l). We gebruiken het als een mildere vervanging voor empty, wanneer de error log wel kan groeien, maar alleen langzaam (bijvoorbeeld, onze Googlebot heeft toegang tot bepaalde gesloten pagina's). Er is een limiet van 2 regels in 20 minuten. Als het hoger is — zal er een melding komen.
Interessante interne controles
Als je tot dit punt "diagonaal" hebt gelezen, wordt het nu interessanter om aandachtiger te lezen.
backups
Houdt toezicht op de backups in de map. Onze backupbestanden hebben namen zoals "ServerName-20200530.tar.gz". Voor elke server wordt er een indicator in okerr gemaakt genaamd ServerName-DATE.tar.gz (de daadwerkelijke datum verandert in de regel "DATE"). Zowel de aanwezigheid van een recente backup als de grootte ervan wordt gevolgd (bijvoorbeeld, deze mag niet kleiner zijn dan 90% van de vorige backup).
Wat moet er gedaan worden zodat een nieuwe backup wordt gevolgd, nadat we deze zijn begonnen te maken en in deze map plaatsen? Niets! Dit is een zeer handige benadering wanneer je "niets" moet doen, omdat:
- Niets doen is vrij snel, dat bespaart tijd.
- Het is moeilijk om te vergeten om "niets" te doen.
- Het is moeilijk om "niets" verkeerd te doen, met een fout. Niets is de betrouwbaarste methode.
Als er plotseling geen nieuwe backupbestanden meer verschijnen — komt er een melding. Als je bijvoorbeeld een van de servers hebt uitgeschakeld, en er zouden geen backups meer moeten zijn — dan moet je de indicator verwijderen (via de webinterface of vanuit de shell via de API).
maxfilesz
Houdt de grootte van de grootste bestanden in de gaten (meestal: /var/log/*). Dit helpt bij het opsporen van onvoorspelbare problemen, zoals wachtwoordoverbelastingen of spamverspreiding via de server.
runstatus/runline
Dit zijn twee belangrijke proxy-modules voor het starten van andere programma's op de server. Runstatus rapporteert de uitgangscode van het programma. Bijvoorbeeld, in okerr is er geen module vereist om te controleren of systemd-diensten actief zijn. Dit wordt gedaan via runstatus (zie hieronder). Runline geeft de server de regel die het programma genereert. Bijvoorbeeld, temp_RUN="cat /sys/class/thermal/thermal_zone0/temp" in de configuratie van Runline op onze server creëert het een indicator servernaam:temp met de temperatuur van de processor.
sql
Voert een numerieke query naar MySQL uit en rapporteert het resultaat in de indicator. In eenvoudige gevallen kan je bijvoorbeeld "SELECT 1" doen — dit controleert of de database überhaupt functioneert.
Maar een veel interessantere toepassing is bijvoorbeeld het bijhouden van het aantal bestellingen in een webwinkel. Als je weet dat je in elk uur ongeveer 100 bestellingen hebt, kan je een minimumgrens van 100 of 80 instellen. Als je plotseling in de verkoop zakt — krijg je een alert en kun je het probleem onderzoeken.
Let op — het maakt niet uit om welke onvoorspelbare reden dit is gebeurd:
- De server is gewoon niet bereikbaar (geen stroom of netwerk), en de alert kwam omdat de indicator 'vervallen' was.
- De server is overbelast, werkt traag of er gaan pakketten verloren, waardoor het onhandig is voor gebruikers en ze zonder aankopen vertrekken.
- De server staat op spamlijsten en e-mail van deze server wordt niet geaccepteerd, gebruikers kunnen zich niet registreren.
- Het budget voor de reclamecampagne is op, banners draaien niet.
Er kunnen talloze redenen zijn, en je kunt ze niet allemaal van tevoren voorzien, en technisch is het moeilijk om ze te traceren. Maar je kunt gemakkelijk het eindparameter (bestellingen) volgen en daarmee bepalen dat de situatie verdacht is en dat je het moet onderzoeken.
Logische indicatoren
Stelt je in staat om logische expressies (Python-syntax) te gebruiken via de module (). Voor de expressie zijn de gegevens van het project en zijn indicatoren beschikbaar. Bijvoorbeeld, in het hoofdstuk over de SQL-controle hierboven, heb je misschien het zwakke punt opgemerkt — overdag hebben we misschien 100 verkopen per uur, maar 's nachts is dat slechts 20, en dat is normaal, geen probleem. Wat te doen? De indicator zal 's nachts voortdurend panikeren.
Je kunt twee indicatoren maken, een dag- en een nachtindicator. Beide 'stil' maken (ze zullen geen meldingen verzenden). En een logische indicator creëren die vereist dat de dagindicator tot 20:00 in orde is, en na 20:00 is het voldoende dat de nachtindicator in orde is.
Een ander voorbeeld van het gebruik van een logische indicator is escalatie. Bijvoorbeeld, de projectmanager meldt zich af van alerts (hij heeft dit niet nodig, de systeembeheerders moeten reageren op reguliere problemen), maar meldt zich aan voor de logische indicator die rood wordt als een indicator in het project niet binnen de gestelde tijd is hersteld.
Er is ook de mogelijkheid om een toegestane tijd voor werkzaamheden aan te wijzen, bijvoorbeeld van 3 tot 5 uur 's ochtends. Het maakt ons niet uit als servers en websites in deze tijd 'uitvallen'. Maar om 5:00 moeten ze werken. Als ze op een ander tijdstip niet werken — alert. Ook de logische indicator houdt rekening met de redundantie van servers. Als je 5 webservers hebt, kunnen de beheerders 1-2 servers op elk moment uitschakelen. Maar als er minder dan 3 van de 5 servers actief zijn — komt er een alert.
De bovenstaande voorbeelden zijn geen functies van okerr, geen speciale functies die geactiveerd en ingesteld moeten worden. Al deze functies zijn niet in okerr aanwezig, maar er is wel een logische module die deze functionaliteit kan implementeren (Ongeveer zoals in programmeertalen — als we rekenoperators hebben, dan hebben we in de taal geen speciale functie nodig voor het berekenen van 20% btw, dat kan altijd zelf worden gedaan naar behoefte).
De logische indicator is waarschijnlijk een van de weinige relatief complexe onderwerpen in okerr, maar het goede nieuws is dat je ze niet hoeft te beheersen totdat dat nodig is. Maar ze vergroten wel de mogelijkheden aanzienlijk, terwijl het systeem zelf vrij eenvoudig blijft.
Het toevoegen van je eigen controles
Ik wil heel graag het idee overbrengen dat okerr geen set van duizend kant-en-klare controles voor alle situaties is, maar integendeel — in de eerste plaats — een eenvoudige engine met de mogelijkheid om je eigen controles te creëren. Het creëren van je eigen controles in okerr is geen taak voor hackers, mede-ontwikkelaars van het systeem, of tenminste gevorderde gebruikers van okerr, maar een haalbare taak voor elke beheerder die een maand geleden voor het eerst Linux heeft geïnstalleerd.
Basiscontroles worden gedaan via de module :
Deze regel in de configuratie zal je op de hoogte stellen als plotseling /bin/true niet start of niet 0 teruggeeft.
true_OK=\/bin\/trueSlechts één regel - en hier zijn we al een beetje uitgebreid de functionaliteit van okerr.
Zelfs zo'n controle heeft al zijn waarde: als uw server plotseling uitvalt, wordt de bijbehorende indicator op de okerr-server niet tijdig bijgewerkt, en na een bepaalde tijd ontstaat er een alert.
Deze controle zal aangeven dat de apache2-server is neergegaan (je weet maar nooit…):
apache_OK="systemctl is-active --quiet apache2"Dus als je enige programmeertaal beheerst, kun je tenminste shell-scripts schrijven - dan kun je al je eigen controles toevoegen.
Complexer - je kunt (in elke taal) je eigen module voor okerrmod schrijven. In de eenvoudigste vorm ziet het er zo uit:
#!/usr/bin/python3

print("STATUS: OK")
Helemaal niet moeilijk, toch? De module moet de controle uitvoeren en de resultaten naar STDOUT geven. Een complexere module kan bijvoorbeeld dit geven:
$ okerrmod --dump df
NAME: pi:df-\/\
TAGS: df
METHOD: numeriek|maxlim=90
DETAILS: 49.52%, 13.9G\/28.2G gebruikt, 13.0G vrij
STATUS: 49.52

NAME: pi:df-\/boot
TAGS: df
METHOD: numeriek|maxlim=90
DETAILS: 84.32%, 53.1M\/62.9M gebruikt, 9.9M vrij
STATUS: 84.32
Het werkt meerdere indicatoren tegelijk bij (gescheiden door een lege regel), creëert indien nodig indicatoren, geeft controle-details en een tag aan waardoor de juiste indicatoren gemakkelijk in het dashboard te vinden zijn.
Telegram
Er is een Telegram-bot . Je hoeft je telefoon niet vol te laden met afzonderlijke applicaties (ik houd er ook niet van dat je voor de Pjatjorik een app met een kaart nodig hebt, voor Lenta een andere, voor MTS weer een andere, en zo voor alles). Eén Telegram is genoeg. Via Telegram kun je onmiddellijk alerts ontvangen, de status van het project controleren en een opdracht geven om alle problematische indicatoren opnieuw te controleren. Je bent uit het theater\/vliegtuig gegaan, hebt twee uur niet op de hoogte gehouden, hebt de telefoon aangezet, op één knop in de chatbot gedrukt en gecontroleerd of alles in orde is.
Statuspagina's
In onze tijd zijn statuspagina's al bijna een must-have voor elk bedrijf dat IT heeft, een verantwoordelijke houding ten opzichte van betrouwbaarheid heeft en zijn klanten\/gebruikers respecteert.
Stel je voor dat een gebruiker iets wil doen, informatie wil bekijken of een bestelling wil plaatsen, en dat er iets niet werkt. Hij weet niet wat het probleem is, aan wiens kant het probleem ligt en wanneer het opgelost zal zijn. Heeft uw bedrijf misschien gewoon een niet-functionerende website? Of is het al zes maanden kapot en wordt het over twee jaar gerepareerd? Maar de koelkast moet nu al gekocht worden, hij ligt al in het winkelwagentje… En het is heel iets anders wanneer iemand ziet dat er iets mis is met uw dienst (ten minste is het duidelijk dat het probleem niet aan zijn kant ligt), dat het probleem is vastgesteld, dat u eraan werkt en misschien zelfs een schatting heeft gegeven voor wanneer het opgelost zal zijn. De gebruiker kan zich inschrijven en een melding ontvangen per e-mail wanneer het probleem is opgelost en hij kan doen wat hij wilde (de koelkast kopen).
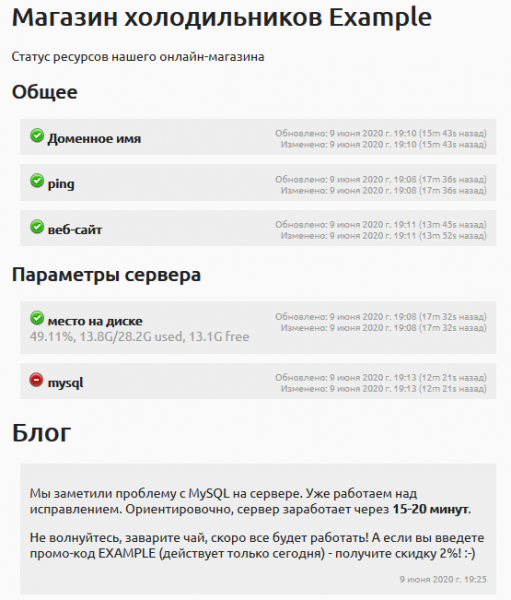
Problemen, downtime — ze komen voor bij iedereen. Maar gebruikers en partners hebben meer vertrouwen in degenen die transparanter zijn en verantwoordelijk omgaan met dit soort situaties.
Hier is . Dit zijn voorbeelden van hoe deze pagina's eruitzien bij projecten en . .
Failover
Om dit artikel niet nog langer te maken, verwijs ik opnieuw naar mijn vorige artikel — . Als u een duplicaatserver kunt maken, dan heeft u in principe geen lange downtime met behulp van failover — zodra het probleem is vastgesteld, worden gebruikers automatisch doorverwezen naar de werkende reserve-server. En ik denk dat dit een zeer interessante, opvallende functie is die nauwelijks ergens anders beschikbaar is.
Lage systeemeisen
Voor de okerr-servers — gebruiken we machines met RAM vanaf 2 GB. Voor netwerksensoren is zelfs 512 MB voldoende. De client-side vereist bijna niets. (Het pakket weegt 26 Kb, maar vereist Python3 en standaard bibliotheken). De client wordt uitgevoerd vanuit een cron-script, zodat het een nul-continuverbruik van geheugen heeft. Onder de waargenomen machines hebben we sensoren (supergoedkope VPS's met 512 MB RAM) en Raspberry Pi. Je kunt zelfs zonder client-side ! (zie hieronder)
Met dit in gedachten — is okerr waarschijnlijk de meest gratis Een monitoring systeem uit de bestaande middelen, want om een andere gratis open-source systeem zoals Zabbix of Nagios te gebruiken, moet je middelen (server) toewijzen, en dat kost al geld. bovendien is er toch enig serveronderhoud vereist. Met okerr kan deze stap worden overgeslagen. Of je kunt deze stap ook behouden en je eigen server gebruiken — afhankelijk van wat je het prettigst vindt.
API en integratie in eigen software
Eenvoudige en open architectuur. Okerr heeft een vrij eenvoudige , waarmee je gemakkelijk kunt werken. Wil je 1000 indicatoren creëren? Eén shell-script in 3-4 regels doet dat. Moet je 1000 indicatoren opnieuw configureren? Ook dat is heel eenvoudig. Bijvoorbeeld, we willen al onze HTTPS-certificaten opnieuw controleren met de Russische sensor:
#!/bin/sh

for indicator in `okerrclient --api-filter sslcert`
do
    echo set location for $indicator
    okerrclient --api-set location=ru retest=1 --name $indicator
done
Een indicator kan je gewoon bijwerken met onze clientmodule, of zelfs zonder, simpelweg via curl.
# short and nice (using okerrupdate and config file)
$ okerrupdate MyIndicator OK

# only curl is enough!
$ curl -d 'textid=MyProject&name=MyIndicator&secret=MySecret&status=OK' https://bravo.okerr.com/
Je kunt indicatoren direct vanuit je eigen programma bijwerken. Bijvoorbeeld door heartbeat-signalen te verzenden, zodat okerr weet dat het actief is, en een alarm oproept als het is uitgevallen of vastloopt. Overigens, de componenten van okerr doen dit ook — okerr houdt zelf toezicht, en problemen in bijna elke module worden gedetecteerd en zullen een probleemwaarschuwing genereren. (En voor dat ‘bijna’ — ze worden kruisgewijs gecontroleerd met een andere server)
Dit is een dergelijke code (vereenvoudigd) in onze Telegram-bot:
from okerrupdate import OkerrProject, OkerrExc

op = OkerrProject()
uptimei = op.indicator("{}:telebot_uptime".format(hostname))
...
uptimei.update('OK', 'pid: {} Uptime: {} cmds: {}'.format(
        os.getpid(), dhms(uptime), commands_cnt))
Voor het bijwerken van indicatoren vanuit Python-programma's — er is een bibliotheek , voor andere talen is er geen bibliotheek, maar je kunt ofwel het script okerrupdate aanroepen, of een HTTP-verzoek naar de okerr-server uitvoeren.
Hoe okerr ons helpt
Okerr heeft ons leven veranderd. Echt waar. Misschien zou een ander monitorsysteem dat ook kunnen, maar met okerr werken gaat ons gemakkelijk af en het heeft alle functies die we nodig hadden (wat er niet was — hebben we toegevoegd). Trouwens, als een specifieke functie mist — vraag het, en ik zal deze toevoegen (ik beloof niets, maar ik wil dat okerr het beste monitorsysteem voor kleine en middelgrote projecten is). Of nog beter, voeg het zelf toe — het is eenvoudig.
Wij hebben het principe aangenomen om 'over alle problemen te vernemen via okerr'. Als er een probleem is ontstaan dat we niet van okerr hebben vernomen, voegen we een controle toe in okerr. (Met 'wij' bedoel ik hier de gebruikers van het systeem, en niet de mede-ontwikkelaars). In het begin kwam dit vaak voor, maar nu is het heel zeldzaam geworden.
Monitoring
Via okerr houden we de loggrootte op alle servers in de gaten. Het is natuurlijk onmogelijk om elke regel van de log met de ogen grondig te lezen, maar het simpelweg volgen van de groeisnelheid biedt al veel inzicht. Hiermee hebben we spamverspreiding en brute-force aanvallen ontdekt, en wanneer sommige applicaties "gek worden", iets niet lukt en ze het steeds opnieuw proberen (elke keer voegen ze een paar regels toe aan de log).
SSL-certificaten. Bijna onmiddellijk na de lancering begon onze klant zijn klanten gratis SSL-certificaten aan te bieden (ongeveer duizend). En dat bleek gewoon een hel voor het beheer te zijn! Het probleem is dat de websites 'levend' zijn, klanten vragen af en toe om iets te doen, en programmeurs doen dat. Ze kunnen bijvoorbeeld vrij elk moment een website naar een andere DocumentRoot verplaatsen. Of een onvoorwaardelijke Rewrite aan de virtuele host-configuratie toevoegen. Natuurlijk, na zo'n verandering werkt de automatische certificaatvernieuwing niet meer. Nu worden al onze SSL-hosts automatisch aan okerr toegevoegd via een ander nuttig hulpmiddel uit ons pakket. . We starten gewoon a2okerr.py — en als er meerdere nieuwe websites op de server verschijnen, worden ze automatisch aan okerr toegevoegd. Als om de een of andere reden het certificaat niet vernieuwd wordt, zijn we drie weken voor de vervaldatum op de hoogte, en kijken we waarom het niet wordt vernieuwd, die hond. a2certbot.py uit hetzelfde pakket — helpt hier enorm bij (het controleert onmiddellijk de meest waarschijnlijke problemen — en meldt wat goed is gecontroleerd en waar waarschijnlijk een probleem is).
We houden de vervaldatum van al onze domeinen in de gaten. En al onze mailservers die e-mail verzenden — worden ook gecontroleerd op meer dan 50 verschillende zwarte lijsten. (En soms komen ze daarop terecht). Trouwens, wist je dat de mailservers van Google ook op zwarte lijsten staan? Gewoon voor zelftesting hebben we mail-wr1-f54.google.com toegevoegd aan de te volgen servers, en hij staat inderdaad op de zwarte lijst van SORBS! (Dit is een vraag over de waarde van "anti-spammers")
Back-ups — hierboven heb ik geschreven hoe eenvoudig het is om ze te volgen met okerr. Maar we houden ook rekening met de recente back-ups op onze server, en (met behulp van een aparte tool die okerr gebruikt) — met de back-ups die we uploaden naar Amazon Glacier. En ja — af en toe treden er problemen op. Niet voor niets houden we het in de gaten.
We gebruiken een escalatie-indicator. Hieraan kun je zien of er een probleem al lange tijd niet is opgelost. En ikzelf kan, wanneer ik aan bepaalde taken werk, soms vergeten ernaar te kijken. Escalatie is een goede herinnering, ook als je zelf toezicht houdt.
Over het algemeen denk ik dat de kwaliteit van ons werk aanzienlijk is verbeterd. Downtime is bijna niet meer (of de klant merkt het niet op. Alleen sssst!), en ondertussen zijn de werklasten afgenomen en de werkvoorwaarden rustiger geworden. We zijn overgestapt van het chaotische werk waarbij we gaten moesten dichten met tape naar rustig en methodisch werk, waarbij veel problemen vooraf worden voorspeld en er tijd is om ze te voorkomen. Zelfs als er al problemen zijn opgetreden, is het nu eenvoudiger om ze op te lossen: ten eerste komen we er vaak achter voordat klanten in paniek raken, ten tweede is het vaak zo dat een probleem verband houdt met recent werk (terwijl ik het een deed, heb ik iets anders kapotgemaakt) — daardoor is het eenvoudiger om het probleem snel op te lossen.
En er was nog een geval...
Wist je dat in het populaire Debian 9 (Stretch) zo'n populair pakket als phpmyadmin al maanden in de kwetsbare status staat? (). Toen de kwetsbaarheid naar buiten kwam, hebben we deze snel op verschillende manieren afgedekt. Maar ik heb okerr ingesteld om de pagina van de security-tracker te volgen, zodat ik weet wanneer er een "mooie" oplossing komt (via de SHA1-hash van de inhoud). Een paar keer heeft de indicator me getrokken, de pagina veranderde, maar zoals je ziet — tot nu toe (sinds januari 2019!) wordt er niet aangegeven dat het probleem is opgelost. Misschien dat iemand weet wat het probleem is, zodat een zo belangrijk pakket al meer dan een jaar kwetsbaar is?
Een andere keer in een soortgelijke situatie: na de kwetsbaarheid in SSH moesten we alle servers updaten. En wanneer je een taak stelt, moet je de uitvoering controleren. (Ondergeschikten hebben de neiging om dingen anders te begrijpen, te vergeten, in de war te raken en fouten te maken). Daarom hebben we eerst in okerr een controle op de SSH-versie op alle servers toegevoegd, en via okerr hebben we ervoor gezorgd dat de updates op alle servers werden toegepast. (Handig! Ik heb dit type indicator gekozen en meteen is te zien op welke server welke versie draait). Toen we verzekerd waren dat de taak op alle servers was uitgevoerd, hebben we de indicatoren verwijderd.
Een paar keer was er een situatie waarin een probleem ontstond, maar later vanzelf oploste. (Waarschijnlijk herkennen velen dit?). Terwijl je het opmerkt en controleert, is er eigenlijk al niets meer te controleren — alles werkt inmiddels goed. Maar dan gaat het opnieuw mis. Dit hadden we bijvoorbeeld met de producten die we op Amazon Marketplace (MWS) laadden. Op een bepaald moment waren de geladen voorraden onjuist (de aantallen en prijzen klopten niet). We hebben het opgelost. Maar om het op te lossen was het belangrijk om direct van het probleem op de hoogte te zijn. Helaas, MWS is, net als alle Amazone-diensten — een beetje traag, dus er was altijd een vertraging, maar toch — we konden in ieder geval de link tussen het probleem en de scripts die het veroorzaakten ongeveer vaststellen (we hebben een controle gemaakt, deze aan okerr gekoppeld, en controleerden deze direct bij ontvangst van een alert).
Een interessant geval dat recentelijk werd toegevoegd aan onze verzameling, heeft te maken met een grote en dure Europese host die door onze klant wordt gebruikt. Plotseling verdwenen ALLE onze servers van de radar! Eerst merkte de klant zelf (sneller dan Okerr!) op dat de website waarmee hij werkte, niet opende en maakte hij een ticket aan. Maar niet slechts één site viel uit, maar werkelijk allemaal! (Natasja, we hebben alles laten vallen!). Hier begon Okerr lange berichten te sturen met alle indicatoren die voor hen oplichtten. Paniek, paniek, we renden in cirkels (wat kan je anders doen?). Toen alles weer online kwam. Blijkbaar waren er onderhoudswerkzaamheden in het datacenter (eens in de zoveel jaren) en ze hadden ons natuurlijk moeten waarschuwen. Maar er was blijkbaar een miscommunicatie en ze waarschuwden niet. Nou, een infarct meer of minder. Maar na het herstel van alles — moet alles natuurlijk worden gecontroleerd! Ik kan me niet voorstellen hoe ik dit handmatig zou doen. Okerr testte alles in enkele minuten. Het bleek dat het grootste deel van de servers gewoon tijdelijk niet beschikbaar was, maar functioneerde nog steeds. Sommige waren opnieuw opgestart, maar kwamen ook weer online zoals het hoort. Van alle verliezen hebben we twee back-ups verloren, die volgens de cron-job zouden moeten zijn aangemaakt en geüpload terwijl deze volledige chaos aan de gang was. Ik heb ze zelfs niet aangemaakt, slechts een dag later kwamen de meldingen dat alles OK was, de back-ups waren terug. Dit voorbeeld bevalt me heel goed, omdat Okerr zeer nuttig bleek in een situatie waar we zelfs niet van tevoren aan hadden gedacht, maar dat is de taak van monitoring — te anticiperen op het onvoorspelbare.
Voor de sensoren van Okerr gebruiken we de goedkoopste hostingservices (kwaliteit en betrouwbaarheid zijn daar niet belangrijk, ze dekken elkaar). Onlangs vonden we een zeer energieke host die super goedkoop is, de benchmarks zijn geweldig. Maar... soms blijkt dat uitgaande verbindingen vanaf de virtuele machine worden uitgevoerd met een ander (buur) IP. Wonderen. De module client_ip met ontvangt niet het juiste IP. En ook uit de serverlogs van de indicator blijkt dat de update ook van dat buur-IP kwam. We zijn momenteel bezig met de support. Gelukkig hebben we dit op tijd opgemerkt. Maar bijvoorbeeld, het komt vaak voor dat toegang op een whitelist van IP's wordt gegeven — en als de server soms even knippert — kan het heel lang duren om dit probleem te traceren.
En daarnaast — nu we het toch over VPS-hosting hebben — gebruiken we altijd goedkopere (hetzner, ovh, scaleway). Zowel qua benchmarks als stabiliteit — ze bevallen ons heel goed. We gebruiken ook het veel duurdere Amazon EC2 voor andere projecten. Dus, dankzij okerr hebben we een goed onderbouwd oordeel. Beide vallen soms uit. En ik zou niet zeggen dat goedkope hosters zoals hetzner op lange termijnbeduidend minder stabiel zijn dan EC2. Dus, als je niet afhankelijk bent van andere functies van Amazon — waarom meer betalen? 🙂
Wat nu?
Als ik je op dit punt nog niet te veel heb afgeschrikt van Okerr — probeer het dan! Je kunt rechtstreeks via deze link naar (Klik nu!). Maar houd er rekening mee dat de demo-account gedeeld wordt, dus als jij iets doet, kan iemand anders je op datzelfde moment in de weg zitten. Of (beter) registreer je via de link op — het is eenvoudig, zonder SMS. Als je je echte e-mailadres niet wilt gebruiken — je kunt een eenmalig adres gebruiken, zoals mailinator (ik raad aan ). Zulke accounts kunnen na verloop van tijd verwijderd worden — maar ze zijn prima voor testdoeleinden.
Na registratie word je gevraagd om een training te doorlopen (een paar vrij eenvoudige leeropdrachten te voltooien). De oorspronkelijke limieten zijn heel laag, maar voor training of één server zijn ze voldoende. Na het doorlopen van de training worden de limieten (bijvoorbeeld, het maximale aantal indicatoren) verhoogd.
Uit de documentatie — allereerst voor de serverkant en de client (). Maar als iets niet duidelijk is — stuur een e-mail naar support (at) okerr.com of laat een ticket achter — we zullen ons best doen om het snel op te lossen.
Als je serieus gebruik gaat maken van de verhoogde limieten en ze niet voldoende zijn — schrijf ook naar support, we verhogen ze (gratis).
Wil je de okerr-server op je eigen server installeren? Hier is . We raden aan om het op een schone virtuele machine te installeren, dan kan je het eenvoudig installeren met een script. Op je eigen virtuele machine — geen beperkingen :-). En als er iets is — proberen we altijd te helpen.
Wij willen dat dit project van de grond komt, zodat de wereld betrouwbaarder wordt dankzij ons. Dankzij gratis software en diensten is de wereld vriendelijker geworden en ontwikkelt deze zich dynamischer. De bronbestanden kunnen worden opgeslagen in een gratis GitHub-account, voor e-mail kan gratis Gmail worden gebruikt. Wij gebruiken gratis voor ondersteuning. Voor al deze zaken hoeven geen servers betaald te worden, er is geen download of configuratie nodig, en er hoeven geen verschillende operationele problemen opgelost te worden. Elk nieuw project, elk team heeft direct e-mail, repositories en CRM. En dit alles is van hoge kwaliteit, gratis en direct beschikbaar. Wij willen dat monitoring ook zo is: kleine bedrijven en projecten zouden gratis gebruik kunnen maken van Okerr en zelfs in de begin- en groeifase betrouwbaarheid hebben zoals grote, serieuze projecten.
Bron: habr.com
