

Hallo, Habr!
Vandaag wil ik onze ervaring delen met de automatisering van het maken van back-ups van grote gegevensopslag in Nextcloud in verschillende configuraties. Ik werk als CTO bij 'Molniya AK', waar we configuratiemanagement van IT-systemen doen, met Nextcloud voor gegevensopslag. Dit omvat ook een gedistribueerde structuur met redundantie.
De problemen die voortkomen uit de kenmerken van installaties zijn dat er veel gegevens zijn. De versiebeheerfunctie die Nextcloud biedt, back-up, subjectieve oorzaken en andere factoren creëren veel duplicaten.
Achtergrond
Bij het beheren van Nextcloud komt het probleem van het organiseren van een effectieve back-up sterk naar voren, die noodzakelijkerwijs moet worden versleuteld, omdat de gegevens waardevol zijn.
Wij bieden opties voor het opslaan van back-ups bij ons of bij de klant op aparte machines die niet met Nextcloud verbonden zijn, wat een flexibele, geautomatiseerde benadering van administratie vereist.
Er zijn veel klanten, allemaal met verschillende configuraties, en allemaal op hun eigen locaties met hun eigen bijzonderheden. De standaardmethodiek waarbij de hele omgeving jou toebehoort, en back-ups worden gemaakt vanuit cron, is hier niet geschikt.
Laten we beginnen met de inputgegevens. We hebben nodig:
- Schaalbaarheid in termen van één node of meerdere. Voor grote installaties gebruiken we minio als opslag.
- Problemen met het uitvoeren van back-ups herkennen.
- We moeten de back-up opslaan bij de klanten en/of bij ons.
- Problemen snel en gemakkelijk oplossen.
- Klanten en installaties verschillen sterk van elkaar - uniformiteit is moeilijk te bereiken.
- De herstel snelheid moet minimaal zijn voor twee scenario's: volledige herstel (ramp) en één map - per ongeluk gewist.
- Deduplicatiefunctie is vereist.
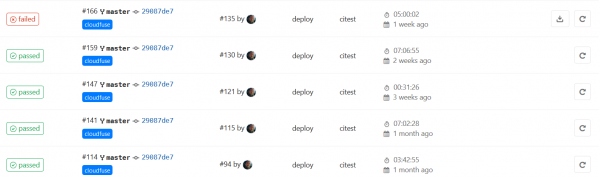
Om de uitdaging van back-upbeheer aan te pakken, hebben we GitLab geïntegreerd. Meer details in de vervolgsectie.
Zeker, we zijn niet de eersten die dit soort problemen oplossen, maar we denken dat onze praktische, doorleefde ervaring interessant kan zijn en we zijn bereid deze te delen.
Aangezien ons bedrijf een open-source beleid hanteert, zochten we specifiek naar een oplossing met open-source code. Wij delen op onze beurt onze ontwikkelingen en publiceren deze. Bijvoorbeeld, op GitHub is er , die we aan klanten aanbieden en die de gegevensbeveiliging versterkt in het geval van per ongeluk of opzettelijk verwijderen.
Back-up middelen
We started searching for solutions by choosing a backup creation tool.
Regular tar + gzip doesn't work well — data gets duplicated. Increments often contain very few actual changes, and a large part of the data within one file is repeated.
There's another issue — redundancy in distributed data storage. We use MinIO and, in principle, its data is redundant. Either we would have to back up through MinIO itself, putting load on it and using all the intermediaries between the file system, and, equally importantly, there’s a risk of forgetting about some buckets and metadata. Or we need to use deduplication.
Open source backup tools with deduplication exist (there were articles on Habr ) and our finalists were en . Below is our comparison of the two applications, but first, let us explain how we organized the entire scheme.
Managing backup creation
Borg and Restic are good, but neither product has a centralized management mechanism. For management and control purposes, we chose a tool that we already have implemented, without which we can’t imagine our work, including automation — the well-known CI/CD – GitLab.
The idea is as follows: a gitlab-runner is installed on each node that stores Nextcloud data. The runner runs a script on a schedule that monitors the backup process, and it triggers Borg or Restic.
What did we achieve? Feedback from the execution, convenient control over changes, and details in case of an error.
Hier is we posted script examples for various tasks, and we ultimately attached it to backup not only for Nextcloud, but also for many other services. There's also a scheduler available if you don’t want to set it up manually (and we don’t want to) and .gitlab-ci.yml
Currently, the GitLab API does not allow changing the CI/CD timeout, and it's quite short. It needs to be increased, say to 1d.
Fortunately, GitLab can trigger not only on commit but also on a schedule, which is exactly what we need.
Now about the wrapper script.
We set the following conditions for this script:
- It must run both as a runner and manually from the console with the same functionality.
- Error handlers must be mandatory:
- return code.
- searching for a line in the log. For us, an error might be a message that the program does not consider critical.
- Timeout handling. The execution time should be reasonable.
- We need detailed logs. But only in case of an error.
- A series of tests is also conducted before starting.
- Small conveniences that we found useful during support:
- Start and end are recorded in the local machine's syslog. This helps link system errors and backup operations.
- Part of the error log, when they occur, is output to stdout, and the entire log is written to a separate file. It's convenient to check in CI immediately and assess the error if it's trivial.
- Debugging modes.
The full log is saved as an artifact in GitLab; if there are no errors, the log is deleted. We write the script in bash.
We welcome any suggestions and feedback on open-source.
Hoe het werkt
A runner with a bash executor is started on the backed-up node. In a special repo, a CI/CD job is scheduled. The runner executes a universal wrapper script for such tasks, which includes checks for the validity of the backup repository, mount points, and anything else we want. Then, backup is performed and old data is cleaned. The final backup is sent to S3.
We operate on this scheme — this is an external provider AWS or a Russian equivalent (it's faster and data doesn't leave Russia). Alternatively, we set up a separate minio cluster for the client on their premises for these purposes. We usually do this for security reasons when the client absolutely does not want data to leave their border.
We didn’t use the feature to send the backup via ssh. It doesn't add security, and the network capabilities of the S3 provider are much higher than those of our single ssh machine.
To protect against a hacker on the local machine — since they can erase data on S3, it's essential to enable versioning.
The backup tool always encrypts the backup.
Borg has a mode without encryption none, but we strongly advise against enabling it. In this mode, not only is there no encryption, but checksums of what is being written are not calculated, meaning integrity can only be verified indirectly, through indices.
A separate scheduler checks backups for the integrity of indices and contents. The check is slow and long, so we run it separately once a month. It may take several days.
Readme in Russian
Belangrijkste functies
is het uitvoeren van het te testen playbook,preparationtestcheckgereedheidscontrolehoofdaanwijzingbasiscommandoforcepostscriptfunctie die aan het einde of bij een fout wordt uitgevoerd. Gebruikt om de partitie af te monteren.
Servicefuncties
is het verwijderen van de instantie.we registreren fouten of wissen het logbestand.checklogwe parseren het log om te controleren op de aanwezigheid van een foutmelding.retexit handler.checktimeouttimeoutcontrole.
Omgeving
VERBOSE=1we geven fouten direct weer op het scherm (stdout).SAVELOGSONSUCCES=1we slaan het log op bij succes.INIT_REPO_IF_NOT_EXIST=1We maken een repository aan als deze nog niet bestaat. Standaard uitgeschakeld.TIMEOUTmaximale tijd voor de hoofdoperatie. Je kunt het als ‘m’, ‘h’ of ‘d’ aan het einde instellen.
Opslagmodus voor oude kopieën. Standaard:
KEEP_DAILY=7KEEP_WEEKLY=4KEEP_MONTHLY=6
Variabelen binnen het script
ERROR_STRING— string voor de controle in het log voor fout.EXTRACT_ERROR_STRING— expressie om de string weer te geven als er een fout is.KILL_TIMEOUT_SIGNAL— signaal om te doden bij timeout.TAIL— hoeveel strings met fouten op het scherm.COLORMSG— kleur van het bericht (standaard geel).
Het script dat wordpress heet, is conditioneel genaamd, zijn kenmerk is dat het ook de mysql-database back-upt. Dit betekent dat het kan worden gebruikt voor tijdelijke installaties van Nexcloud, waar je ook de database kunt back-uppen. Het gemak ligt niet alleen in het feit dat alles op één plek is, maar ook dat de inhoud van de database dicht bij de inhoud van de bestanden ligt, aangezien het tijdsverschil minimaal is.
Restic vs Borg
Vergelijkingen van Borg en Restic zijn ook , en we hadden niet de taak om gewoon nog een te maken, maar onze eigen. Het was voor ons belangrijk hoe dit eruit zou zien met onze gegevens, met onze specificiteit. We brengen ze.
Onze selectiecriteria, naast de eerder genoemde (deduplicatie, snelle herstel, etc.):
- Weerstand tegen onafgemaakte taken. Controle op kill -9.
- Grootte op schijf.
- Eisen aan middelen (CPU, geheugen).
- Grootte van opgeslagen blobs.
- Werken met S3.
- Integriteitscontrole.
Voor de test namen we een klant met echte gegevens en een totale grootte van 1,6TB.
Voorwaarden.
Borg kan niet direct met S3 werken en we monteerden als een fuse-schijf, via . Restic verzond het naar S3 zelf.
Goofys werkt heel snel en goed, en het heeft een , wat het werk verder versnelt. Het bevindt zich in de bètafase en, toegegeven, het viel bij ons met gegevensverlies tijdens de tests (andere). Maar het gemak ligt erin dat de back-upprocedure niet veel lezen vereist, maar voornamelijk schrijven, dus de cache gebruiken we alleen tijdens de integriteitscontrole.
Om de invloed van het netwerk te verminderen, gebruikten we een lokale provider — Yandex Cloud.
Testresultaten van de vergelijking.
- Kill -9 met een daaropvolgende herstart hebben beide succesvol uitgevoerd.
- Grootte op de schijf. Borg kan comprimeren, dus verwachte resultaten.
Backuper
Grootte
Borg
562Gb
Restic
628Gb
- Op CPU
Borg verbruikt op zich weinig met standaardcompressie, maar moet samen met het goofys-proces worden geëvalueerd. In totaal zijn ze vergelijkbaar en gebruiken ze ongeveer 1,2 kern op dezelfde testvirtuele machine. - Geheugen. Restic ongeveer 0,5Gb, Borg ongeveer 200Mb. Maar dit is allemaal verwaarloosbaar in vergelijking met de bestandscache van het systeem. Dus het is wenselijk om meer geheugen toe te wijzen.
- Het verschil in de grootte van blobs bleek aanzienlijk te zijn.
Backuper
Grootte
Borg
ongeveer 500Mb
Restic
ongeveer 5Mb
- Het werken met S3 van Restic is uitstekend. Het werken met Borg via goofys is ook geen probleem, maar het is opgemerkt dat het wenselijk is om na een backup umount uit te voeren om de cache volledig te resetten. Een eigenschap van het werken met S3 is dat niet-geüploade chunks nooit naar de bucket worden verzonden, wat betekent dat niet volledig geüploade gegevens leiden tot grote beschadigingen.
- De integriteitscontrole werkt goed in beide gevallen, maar de snelheid verschilt aanzienlijk.
Restic – 3,5 uur.
Borg, met een bestandscache van 100Gb SSD – 5 uur. Een ongeveer gelijk resultaat qua snelheid als de gegevens op een lokale schijf staan.
Borg leest direct van S3 zonder cache 33 uur. Veel te lang.
In het kort, Borg kan comprimeren en heeft grotere blobs — wat opslag goedkoper maakt en de GET/PUT-operaties in S3. Maar daarvoor moet je betalen met een complexere en tragere controle. Wat de herstelsnelheid betreft — we hebben geen verschil opgemerkt. Latere backups (na de eerste) maakt Restic een beetje langer, maar niet significant.
De grootte van de community stond ook niet op de laatste plaats bij de keuze.
En we hebben Borg gekozen.
Een paar woorden over compressie
Borg heeft een uitstekende nieuwe compressie-algoritme — zstd. Qua compressiekwaliteit is het niet slechter dan gzip, maar aanzienlijk sneller. En vergelijkbaar qua snelheid met de standaard lz4.
Bijvoorbeeld, een dump van een MySQL-database comprimeert ongeveer twee keer beter dan lz4 met dezelfde snelheid. Echter, ervaring met echte gegevens toont aan dat er een zeer klein verschil in compressiegraad is voor de Nextcloud-nodes.
In Borg is er een vrij bonusscompressiemodus — als een bestand een hoge entropie heeft, wordt compressie helemaal niet toegepast, wat de snelheid verhoogt. Dit wordt ingeschakeld met een optie bij het maken van
-C auto,zstd
voor het zstd-algoritme
Dus met deze optie in vergelijking met de standaardcompressie kregen we
560 Gb en 562 Gb respectievelijk. De gegevens uit het bovenstaande voorbeeld, ter herinnering, zonder compressie is het resultaat 628 Gb. Het resultaat van 2 Gb verschil verraste ons een beetje, maar we hebben besloten dat we toch voor dit kiezen. auto,zstd.
Methode voor het controleren van back-ups
Via de planner wordt de virtuele machine uitgevoerd direct bij de provider of bij de klant, wat de netwerkbelasting aanzienlijk vermindert. Dit is in ieder geval goedkoper dan het bij jezelf opzetten en het verkeer te leiden.
goofys --cache "--free:5%:\/mnt\/cache" -o allow_other --endpoint https:\/\/storage.yandexcloud.net --file-mode=0666 --dir-mode=0777 xxxxxxx.com \/mnt\/goofys
export BORG_PASSCOMMAND="cat \/home\/borg\/.borg-passphrase"
borg list \/mnt\/goofys\/borg1\/
borg check --debug -p --verify-data \/mnt\/goofys\/borg1\/
Op dezelfde manier controleren we bestanden met antivirus (achteraf). Gebruikers uploaden immers verschillende bestanden naar Nextcloud en niet iedereen heeft antivirussoftware. Een controle tijdens het uploaden kost te veel tijd en verstoort de bedrijfsvoering.
Schaalbaarheid wordt bereikt door runners op verschillende knooppunten met verschillende tags te starten.
In onze monitoring worden de status van back-ups verzameld via de GitLab API in één venster, problemen worden gemakkelijk opgemerkt en kunnen ook gemakkelijk worden gelokaliseerd.
Conclusie
Als resultaat weten we precies dat we back-ups maken, dat onze back-ups geldig zijn, en de problemen die zich voordoen kosten weinig tijd en worden opgelost op het niveau van de servicedeskbeheerder. Back-ups nemen echt weinig ruimte in vergelijking met tar.gz of Bacula.
Bron: habr.com
