

Hallo iedereen! Ik ben CV-ontwikkelaar bij KROK. Al 3 jaar voeren we projecten uit op het gebied van CV. In die tijd hebben we allerlei dingen gedaan, bijvoorbeeld: we hebben chauffeurs in de gaten gehouden zodat ze tijdens het rijden niet drinken, roken, of bellen, en naar de weg kijken, in plaats van te dromen of naar de wolken; we hebben “specialisten” gefilmd die op busstroken rijden en meerdere parkeerplaatsen in beslag nemen; we hebben ervoor gezorgd dat werknemers helmen, handschoenen en dergelijke droegen; we hebben medewerkers geïdentificeerd die toegang tot het terrein wilden; we hebben alles geteld wat maar mogelijk is.
Waarom vertel ik dit allemaal?
Tijdens de uitvoering van projecten hebben we de nodige problemen ondervonden, veel problemen, waarvan je ofwel vertrouwd mee bent, of je in de toekomst mee zult maken.
Laten we een situatie modelleren
Stel je voor dat we werken voor een jong bedrijf 'N', dat zich bezighoudt met ML. We werken aan een ML (DL, CV) project, en om een of andere reden schakelen we over naar een ander werk, dus we nemen een pauze, en we keren terug naar onze of iemand anders neurale netwerken.
- Het moment van de waarheid breekt aan, we moeten ons herinneren waarop we gestopt zijn, welke hyperparameters we hebben geprobeerd en, het belangrijkste, welke resultaten ze hebben opgeleverd. Er kunnen talloze manieren zijn hoe iedereen informatie over alle runs heeft opgeslagen: in hun hoofd, in configuraties, in een notitieboekje, in de werkomgeving in de cloud. Ik heb een situatie gezien waarbij hyperparameters als gecommentarieerde regels in de code waren opgeslagen, een vrije interpretatie dus. En stel je nu voor dat je niet terugkeert naar je eigen project, maar naar het project van iemand die het bedrijf heeft verlaten, en je hebt de code en het model met de naam model_1.pb geërfd. Om het helemaal af te maken, stel je voor dat je ook nog eens een beginnende professional bent.
- Laten we verder gaan. Voor het uitvoeren van de code hebben wij en iedereen die ermee werkt een omgeving nodig. Vaak geeft men deze ook om de een of andere reden niet mee. Dit kan ook een niet triviale taak zijn. We willen hier niet teveel tijd aan besteden, toch?
- We trainen een model (bijvoorbeeld een autodetector). We komen op het punt waarop het model behoorlijk goed presteert — het is tijd om het resultaat op te slaan. Laten we het car_detection_v1.pb noemen. Vervolgens trainen we nog een model — car_detection_v2.pb. Enkele tijd later trainen onze collega's of wijzelf nog een aantal modellen, met verschillende architecturen. Uiteindelijk ontstaat er een hoop artefacten waarvan we de informatie zorgvuldig moeten verzamelen (maar dat doen we later, we hebben immers op dit moment belangrijkere zaken te doen).
- Nou, dat is alles! We hebben een model! We kunnen beginnen met het trainen van het volgende model, het ontwikkelen van de architectuur voor een nieuwe taak, of kunnen we even gaan thee drinken? En wie gaat het uitrollen?
Problemen identificeren
Het werken aan een project of product is het resultaat van de inspanning van vele mensen. Gedurende de tijd komen er mensen en gaan ze weer, er komen meer projecten bij, en de projecten worden moeilijker. Hoe dan ook, situaties uit de hierboven beschreven cyclus (en niet alleen die) zullen op verschillende manieren terugkomen van iteratie tot iteratie. Dit leidt tot tijdverlies, verwarring, stress, mogelijk ontevredenheid bij de klant, en uiteindelijk — tot gemiste inkomsten. Hoewel we doorgaans steeds weer dezelfde fouten maken, denk ik niet dat iemand deze momenten keer op keer wil ervaren.
Dus, we hebben één ontwikkelingscyclus doorlopen en we zien dat er problemen zijn die moeten worden opgelost. Hiervoor is nodig:
- de resultaten van het werk op een handige manier op te slaan;
- het proces van het betrekken van nieuwe medewerkers eenvoudig te maken;
- het proces van het opzetten van de ontwikkelomgeving te vereenvoudigen;
- het versiebeheer van modellen in te stellen;
- een gemakkelijke manier voor het valideren van modellen te hebben;
- een tool voor modelstatusbeheer te vinden;
- een manier te vinden om modellen in productie te brengen.
Het lijkt nodig om een workflow te bedenken die het mogelijk maakt om deze levenscyclus eenvoudig en handig te beheren? Deze praktijk heeft de naam MLOps.
MLOps, of DevOps voor machine learning, stelt teams van data-analyse en IT-specialisten in staat om samen te werken en de snelheid van ontwikkeling en uitrol van modellen te verhogen door middel van monitoring, verificatie en een managementsysteem voor machine learning-modellen.
Dat kan , wat de jongens van Google hierover denken. Uit het artikel blijkt dat MLOps een vrij omvangrijk onderwerp is.
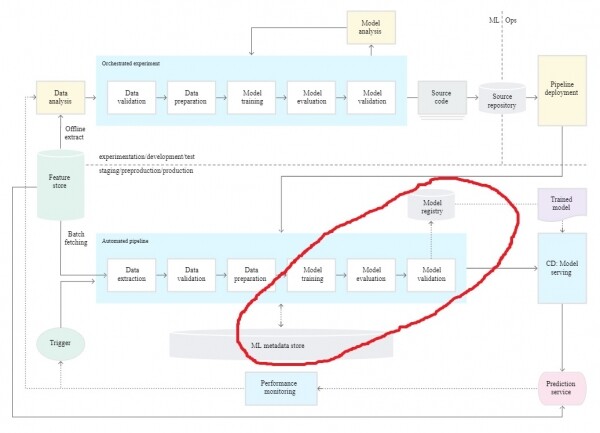
In dit artikel beschrijf ik slechts een deel van het proces. Voor de implementatie maak ik gebruik van de tool MLflow, omdat dit een open-source project is, dat met een beperkte hoeveelheid code kan worden aangesloten en integratie biedt met populaire ML-frameworks. Je kunt op internet naar andere tools zoeken, zoals Kubeflow, SageMaker, Trains, enzovoort, en misschien een vinden die beter bij jouw behoeften past.
"We bouwen" MLOps aan de hand van het voorbeeld van de tool MLFlow
MLFlow is een open-source platform voor het beheren van de levenscyclus van ML-modellen ().
MLflow omvat vier componenten:
- MLflow Tracking — richt zich op het vastleggen van resultaten en parameters die tot deze resultaten hebben geleid;
- MLflow Project — stelt je in staat om code in te pakken en deze op elk platform te reproduceren;
- MLflow Models — is verantwoordelijk voor het implementeren van modellen in productie;
- MLflow Registry — maakt het mogelijk om modellen op te slaan en hun status in een gecentraliseerde opslag te beheren.
MLflow opereert met twee entiteiten:
- run — is de volledige cyclus van training, parameters en metrics die we willen registreren;
- experiment — is het "onderwerp" dat runs verbindt.
Alle stappen van het voorbeeld zijn uitgevoerd op het besturingssysteem Ubuntu 18.04.
1. We zetten de server op
Om ons project eenvoudig te kunnen beheren en alle benodigde informatie te verkrijgen, zetten we een server op. De MLflow tracking server heeft twee belangrijke componenten:
- backend store — is verantwoordelijk voor het opslaan van informatie over geregistreerde modellen (ondersteunt 4 databases: mysql, mssql, sqlite en postgresql);
- artifact store — is verantwoordelijk voor het opslaan van artefacten (ondersteunt 7 opslagmogelijkheden: Amazon S3, Azure Blob Storage, Google Cloud Storage, FTP-server, SFTP-server, NFS, HDFS).
Als artifact store voor de eenvoud nemen we een sftp-server.
- we creëren een groep
$ sudo groupadd sftpg - we voegen een gebruiker toe en stellen een wachtwoord in
$ sudo useradd -g sftpg mlflowsftp $ sudo passwd mlflowsftp - we passen een paar toegangsinstellingen aan
$ sudo mkdir -p /data/mlflowsftp/upload $ sudo chown -R root.sftpg /data/mlflowsftp $ sudo chown -R mlflowsftp.sftpg /data/mlflowsftp/upload - we voegen enkele regels toe aan /etc/ssh/sshd_config
Match Group sftpg ChrootDirectory /data/%u ForceCommand internal-sftp - we herstarten de dienst
$ sudo systemctl restart sshd
Als backend store we nemen postgresql.
$ sudo apt update
$ sudo apt-get install -y postgresql postgresql-contrib postgresql-server-dev-all
$ sudo apt install gcc
$ pip install psycopg2
$ sudo -u postgres -i
# Maak een nieuwe gebruiker: mlflow_user
[postgres@user_name~]$ createuser --interactive -P
Voer naam van rol in om toe te voegen: mlflow_user
Voer wachtwoord in voor nieuwe rol: mlflow
Voer het opnieuw in: mlflow
Moet de nieuwe rol een superuser zijn? (j/n) n
Moet de nieuwe rol databases kunnen aanmaken? (j/n) n
Moet de nieuwe rol meer nieuwe rollen kunnen aanmaken? (j/n) n
# Maak database mlflow_bd eigendom van mlflow_user
$ createdb -O mlflow_user mlflow_db
Om de server te starten, moeten de volgende python-pakketten worden geïnstalleerd (ik raad aan een aparte virtuele omgeving te creëren):
pip install mlflow
pip install pysftp
Laten we onze server starten
$ mlflow server
                 --backend-store-uri postgresql://mlflow_user:mlflow@localhost/mlflow_db
                 --default-artifact-root sftp://mlflowsftp:mlflow@sftp_host/upload
                --host server_host
                --port server_port
2. Tracking toevoegen
Om ervoor te zorgen dat de resultaten van onze trainingen niet verloren gaan, zodat toekomstige ontwikkelaars begrijpen wat er eigenlijk is gebeurd, en zodat oudere collega's en jij het leerproces zonder zorgen kunnen analyseren, moeten we tracking toevoegen. Tracking houdt in dat we parameters, metrics, artifacts en alle aanvullende informatie over de uitvoering van de training, in ons geval, op de server opslaan.
Voor dit voorbeeld heb ik een klein gemaakt met Keras, dat alles segmenteert dat aanwezig is in de . Voor het toevoegen van tracking heb ik het bestand mlflow_training.py gemaakt.
Hier zijn de regels waarin het echt interessant wordt:
def run(self, epochs, lr, experiment_name):
        # het id van het experiment ophalen, een experiment aanmaken indien afwezig
        remote_experiment_id = self.remote_server.get_experiment_id(name=experiment_name)
        # een "run" aanmaken en het id ophalen
        remote_run_id = self.remote_server.get_run_id(remote_experiment_id)

        # aangeven dat we de resultaten op een externe server willen opslaan
        mlflow.set_tracking_uri(self.tracking_uri)
        mlflow.set_experiment(experiment_name)

        with mlflow.start_run(run_id=remote_run_id, nested=False):
            mlflow.keras.autolog()
            self.train_pipeline.train(lr=lr, epochs=epochs)

        try:
            self.log_tags_and_params(remote_run_id)
        except mlflow.exceptions.RestException as e:
            print(e)
Hier is self.remote_server een kleine wrapper om de methoden mlflow.tracking. MlflowClient (die ik voor het gemak heb gemaakt), waarmee ik een experiment en een run op de server creëer. Vervolgens geef ik aan waar de resultaten van de run naartoe moeten worden gestuurd (mlflow.set_tracking_uri(self.tracking_uri)). Ik activeer automatische logging met mlflow.keras.autolog(). Op dit moment ondersteunt MLflow Tracking automatische logging voor TensorFlow, Keras, Gluon XGBoost, LightGBM, Spark. Als je jouw framework of bibliotheek niet hebt gevonden, kun je altijd in detail loggen. We starten de training. We registreren tags en invoerparameters op de externe server.
Een paar regels en u, net als alle anderen, heeft toegang tot informatie over alle runs. Geweldig?
3. Project opzetten
Laten we het zo maken dat het starten van een project een fluitje van een cent is. Daarom voegen we een MLproject-bestand en conda.yaml toe in de root van het project.
MLproject
name: flow_segmentation
conda_env: conda.yaml

entry_points:
  main:
    parameters:
        categories: {help: 'lijst van categorieën uit de coco-dataset'}
        epochs: {type: int, help: 'aantal epochs in training'}

        lr: {type: float, default: 0.001, help: 'leersnelheid'}
        batch_size: {type: int, default: 8}
        model_name: {type: str, default: 'Unet', help: 'Unet, PSPNet, Linknet, FPN'}
        backbone_name: {type: str, default: 'resnet18', help: 'voorbeeld resnet18, resnet50, mobilenetv2 ...'}

        tracking_uri: {type: str, help: 'het serveradres'}
        experiment_name: {type: str, default: 'My_experiment', help: 'naam van experiment op afstand en lokaal'}
    command: "python mlflow_training.py
            --epochs={epochs}
            --categories={categories}
            --lr={lr}
            --tracking_uri={tracking_uri}
            --model_name={model_name}
            --backbone_name={backbone_name}
            --batch_size={batch_size}
            --experiment_name={experiment_name}"
Een MLflow-project heeft verschillende eigenschappen:
- Name — de naam van uw project;
- Environment — in mijn geval wijst conda_env erop dat Anaconda wordt gebruikt voor uitvoering en dat de afhankelijkheden worden beschreven in het bestand conda.yaml;
- Entry Points — geeft aan welke bestanden we kunnen starten en met welke parameters (alle parameters worden automatisch gelogd wanneer de training begint)
conda.yaml
name: flow_segmentation
channels:
  - defaults
  - anaconda
dependencies:
  - python==3.7
  - pip:
    - mlflow==1.8.0
    - pysftp==0.2.9
    - Cython==0.29.19
    - numpy==1.18.4
    - pycocotools==2.0.0
    - requests==2.23.0
    - matplotlib==3.2.1
    - segmentation-models==1.0.1
    - Keras==2.3.1
    - imgaug==0.4.0
    - tqdm==4.46.0
    - tensorflow-gpu==1.14.0
Als runtime-omgeving kun je Docker gebruiken, voor meer informatie, kijk naar .
4. Training starten
Clone het project en ga naar de projectdirectory:
git clone https://github.com/simbakot/mlflow_example.git
cd mlflow_example/
Voor het uitvoeren heb je de bibliotheken nodig
pip install mlflow
pip install pysftp
Aangezien ik in het voorbeeld conda_env gebruik, moet Anaconda op uw computer zijn geïnstalleerd (maar dit kan ook worden omzeild door alle benodigde pakketten zelf te installeren en met de opstartparameters te spelen).
Alle voorbereidende stappen zijn voltooid en we kunnen beginnen met het starten van de training. Vanuit de root van het project:
$ mlflow run -P epochs=10 -P categories=cat,dog -P tracking_uri=http://server_host:server_port .Na het invoeren van het commando zal er automatisch een conda-omgeving worden aangemaakt en zal de training starten.
In het bovenstaande voorbeeld heb ik het aantal epochs voor de training doorgegeven, evenals de categorieën waarop we willen segmenteren (de volledige lijst kan worden bekeken ) en het adres van onze externe server.
Een volledige lijst van mogelijke parameters kan worden bekeken in het MLproject-bestand.
5. We evalueren de trainingsresultaten
Na het einde van de training kunnen we in de browser naar het adres van onze server gaan
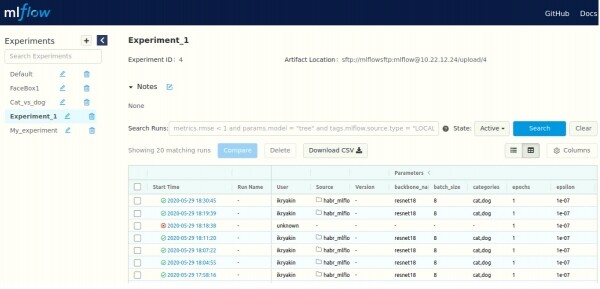
Hier zien we een lijst van alle experimenten (links bovenaan), evenals informatie over de runs (in het midden). We kunnen meer gedetailleerde informatie (parameters, metrics, artefacten en aanvullende informatie) bekijken voor elke run.
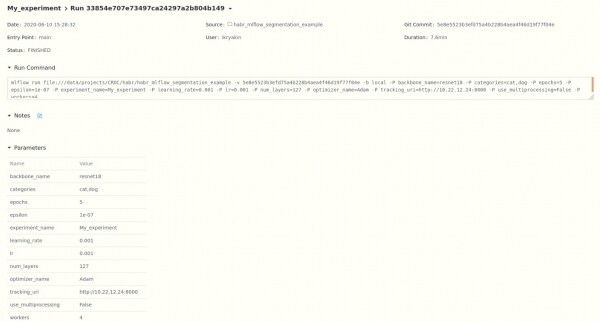
Voor elke metric kunnen we de geschiedenis van veranderingen volgen.
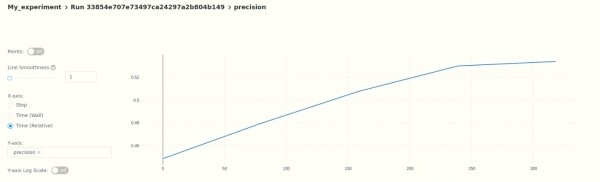
Dat wil zeggen, op dit moment kunnen we de resultaten in 'handmatige' modus analyseren, en u kunt ook automatische validatie instellen met behulp van de MLflow API.
6. We registreren het model
Nadat we ons model hebben geanalyseerd en besloten hebben dat het klaar is voor gebruik, beginnen we met de registratie. Hiervoor kiezen we de juiste run (zoals aangegeven in de vorige sectie) en gaan naar beneden.
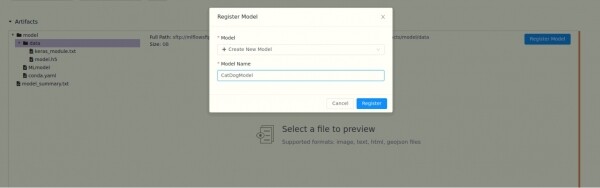
Nadat we onze modelnaam hebben gegeven, ontvangt het een versie. Als we een ander model met dezelfde naam opslaan, zal de versie automatisch worden verhoogd.
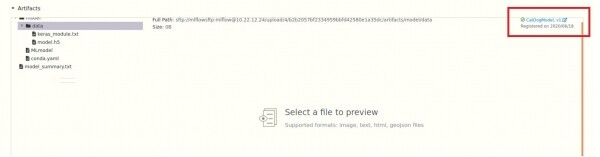
Voor elk model kunnen we een beschrijving toevoegen en een van de drie statussen kiezen (Staging, Production, Archived), waarmee we via de API toegang krijgen tot deze statussen, wat naast versionering extra flexibiliteit biedt.
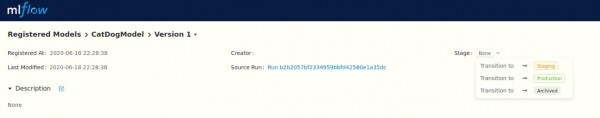
We hebben ook gemakkelijk toegang tot alle modellen
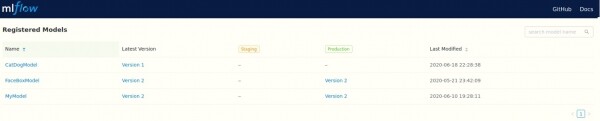
en hun versies.
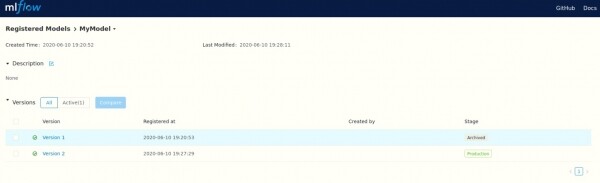
Zoals in de vorige sectie kunnen alle acties worden uitgevoerd met de API.
7. We deployen het model
Op dit punt hebben we al een getraind (keras) model. Een voorbeeld van hoe we het kunnen gebruiken:
class SegmentationModel:
    def __init__(self, tracking_uri, model_name):

        self.registry = RemoteRegistry(tracking_uri=tracking_uri)
        self.model_name = model_name
        self.model = self.build_model(model_name)

    def get_latest_model(self, model_name):
        registered_models = self.registry.get_registered_model(model_name)
        last_model = self.registry.get_last_model(registered_models)
        local_path = self.registry.download_artifact(last_model.run_id, 'model', '.\/')
        return local_path

    def build_model(self, model_name):
        local_path = self.get_latest_model(model_name)

        return mlflow.keras.load_model(local_path)

    def predict(self, image):
        image = self.preprocess(image)
        result = self.model.predict(image)
        return self.postprocess(result)

    def preprocess(self, image):
        image = cv2.resize(image, (256, 256))
        image = image / 255.
        image = np.expand_dims(image, 0)
        return image

    def postprocess(self, result):
        return result
Hier is self.registry weer een kleine wrapper om mlflow.tracking.MlflowClient voor gemak. Het idee is dat ik verbinding maak met de externe server en daar het model met de opgegeven naam zoek, en daarnaast de laatste production versie. Vervolgens download ik het artefact lokaal naar de map .\/model en bouw ik het model op vanuit deze directory mlflow.keras.load_model(local_path). Nu kunnen we ons model gebruiken. CV (ML) ontwikkelaars kunnen zich zonder zorgen richten op het verbeteren van het model en het publiceren van nieuwe versies.
Ter conclusie
Ik heb een systeem voorgesteld dat in staat is om:
- informatie over ML-modellen, trainingsprocessen en -resultaten centraal op te slaan;
- snel een ontwikkelomgeving in te richten;
- de voortgang van modelwerkzaamheden te volgen en te analyseren;
- gemakkelijk versiebeheer te voeren en de status van modellen te beheren;
- ontvangen modellen eenvoudig te implementeren.
Dit voorbeeld is een speelgoed-voorbeeld en dient als startpunt voor het opzetten van uw eigen systeem, dat mogelijk automatisering van resultatenbeoordeling en modelregistratie (p.5 en p.6 respectievelijk) zal omvatten, of dat u versiebeheer voor datasets toevoegt, of misschien iets anders? Ik probeerde het idee over te brengen dat u MLOps in zijn geheel nodig hebt; MLflow is slechts een middel om het doel te bereiken.
Zijn er problemen die u bent tegengekomen die ik niet heb weergegeven?
Wat zou u aan het systeem toevoegen om aan uw behoeften te voldoen?
Welke tools en benaderingen gebruikt u om al uw of een deel van de problemen op te lossen?
P.S. Ik laat een paar links achter:
github-project —
MLflow —
Mijn werk e-mailadres voor vragen — ikryakin@croc.ru
In ons bedrijf worden regelmatig verschillende evenementen voor IT-specialisten georganiseerd, bijvoorbeeld: op 8 juli om 19:00 MSK vindt er een online meetup over CV plaats. Als je geïnteresseerd bent, kun je deelnemen, registratie is vereist. .
Bron: habr.com
