

De vertaling van het artikel is voorbereid ter voorbereiding op de start van de cursus .
Hoe cloudkosten te besparen bij het werken met Kubernetes? Er bestaat geen eenduidige oplossing, maar in dit artikel worden verschillende hulpmiddelen beschreven die u helpen om uw middelen efficiënter te beheren en de kosten voor cloud computing te verlagen.
Ik heb dit artikel geschreven met AWS Kubernetes in gedachten, maar het is (bijna) net zo goed toepasbaar voor andere cloudproviders. Ik ga ervan uit dat uw cluster(s) al is ingesteld voor automatische schaling (). Het verwijderen van resources en het verminderen van de schaal van de implementatie bespaart alleen kosten als dit ook uw park van werkknopen (EC2-instanties) verkleint.
In dit artikel worden de volgende onderwerpen behandeld:
- het opruimen van ongebruikte resources ()
- vermindering van de schaal buiten kantooruren ()
- gebruik van horizontale autoscaling (HPA),
- vermindering van overmatige reservering van resources (, VPA)
- gebruik van Spot-instanties
Opruimen van ongebruikte resources
Werken in een snel veranderende omgeving is geweldig. We willen dat technische organisaties . Snellere softwarelevering betekent ook meer PR-implementaties, omgevingen voor previews, prototypes en analytische oplossingen. Alles wordt geïmplementeerd op Kubernetes. Wie heeft de tijd om handmatig testimplementaties op te ruimen? Het is gemakkelijk om te vergeten om een experiment van een week geleden te verwijderen. De kosten voor de cloud zullen uiteindelijk stijgen omdat we vergeten zijn om te sluiten:
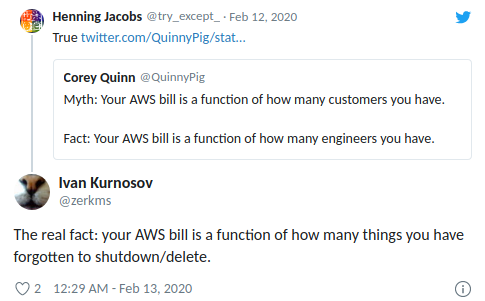
(Henning Jacobs:
Life:
(quote) Cory Quinn:
Mythe: Uw AWS-rekening is afhankelijk van het aantal gebruikers.
Feit: Uw AWS-rekening is afhankelijk van het aantal ingenieurs.
Ivan Kurnosov (in antwoord):
Echt feit: Uw AWS-rekening is afhankelijk van het aantal dingen dat u bent vergeten uit te schakelen/verwijderen.)
(kube-janitor) helpt uw cluster op te ruimen. De configuratie van de janitor is flexibel voor zowel globaal als lokaal gebruik:
- Algemene regels voor de hele cluster kunnen de maximale levensduur (TTL - time-to-live) voor PR/testimplementaties bepalen.
- Losse resources kunnen worden geannoteerd met janitor/ttl, bijvoorbeeld voor het automatisch verwijderen van spike/prototypes na 7 dagen.
Algemene regels worden gedefinieerd in een YAML-bestand. Het pad wordt doorgegeven via de parameter --rules-file in kube-janitor. Hier is een voorbeeldregel voor het verwijderen van alle namespaces met -pr- in de naam na twee dagen:
- id: cleanup-resources-from-pull-requests
  resources:
    - namespaces
  jmespath: "contains(metadata.name, '-pr-')"
  ttl: 2d
Het volgende voorbeeld regelt het gebruik van het label application op Deployment en StatefulSet pods voor alle nieuwe Deployments/StatefulSet in 2020, maar staat tegelijkertijd het uitvoeren van tests zonder dit label gedurende een week toe:
- id: require-application-label
  # verwijder deployments en statefulsets zonder het label "application"
  resources:
    - deployments
    - statefulsets
  # zie http://jmespath.org/specification.html
  jmespath: "!(spec.template.metadata.labels.application) && metadata.creationTimestamp > '2020-01-01'"
  ttl: 7d
Een tijdgebonden demo uitvoeren gedurende 30 minuten in een cluster waar kube-janitor draait:
kubectl run nginx-demo --image=nginx
kubectl annotate deploy nginx-demo janitor/ttl=30m
Een andere bron van toenemende kosten zijn de persistente volumes (AWS EBS). Bij het verwijderen van een Kubernetes StatefulSet worden de persistente volumes (PVC - PersistentVolumeClaim) niet verwijderd. Ongebruikte EBS-volumes kunnen gemakkelijk leiden tot kosten van honderden dollars per maand. Kubernetes Janitor heeft een functie voor het opschonen van ongebruikte PVC's. Bijvoorbeeld, deze regel verwijdert alle PVC's die niet zijn aangekoppeld en waarover geen StatefulSet of CronJob verwijst:
# удалить все PVC, которые не смонтированы и на которые не ссылаются StatefulSets
- id: remove-unused-pvcs
  resources:
  - persistentvolumeclaims
  jmespath: "_context.pvc_is_not_mounted && _context.pvc_is_not_referenced"
  ttl: 24h
Kubernetes Janitor kan je helpen je cluster 'schoon' te houden en langzaam oplopende kosten voor cloud computing te voorkomen. Voor instructies voor implementatie en configuratie volg de .
Schaal terug tijdens inactieve uren
Test- en tussensystemen zijn doorgaans alleen nodig tijdens werkuren. Sommige productietoepassingen, zoals back-office / beheertools, vereisen ook slechts beperkte beschikbaarheid en kunnen 's nachts worden uitgeschakeld.
(kube-downscaler) stelt gebruikers en operators in staat om het systeem buiten de werktijden te verkleinen. Deployments en StatefulSets kunnen worden opgeschaald tot nul replica's. CronJobs kunnen worden gepauseerd. Kubernetes Downscaler is in te stellen voor het hele cluster, voor één of meerdere namespaces of individuele resources. Je kunt ofwel 'downtime' ofwel 'uptime' instellen. Bijvoorbeeld, om de schaalverkleining tot een minimum te beperken gedurende de nacht en in het weekend:
image: hjacobs/kube-downscaler:20.4.3
args:
  - --interval=30
  # schakel infrastructuurcomponenten niet uit
  - --exclude-namespaces=kube-system,infra
  # schakel kube-downscaler niet uit, evenals de Postgres Operator, zodat de uitgesloten databases beheerd kunnen worden
  - --exclude-deployments=kube-downscaler,postgres-operator
  - --default-uptime=Mon-Fri 08:00-20:00 Europe/Berlin
  - --include-resources=deployments,statefulsets,stacks,cronjobs
  - --deployment-time-annotation=deployment-time
Hier is een grafiek van de schaalverkleining van de werkknopen in het cluster tijdens het weekend:
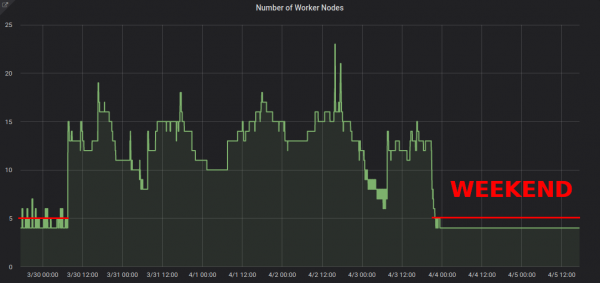
Een schaalverkleining van ~13 naar 4 werkknopen maakt zeker een merkbaar verschil in de AWS-rekening.
Maar wat als ik moet werken tijdens de 'downtime' van het cluster? Bepaalde deployments kunnen permanent worden uitgesloten van schaling door de annotatie downscaler/exclude: true toe te voegen. Deployments kunnen tijdelijk worden uitgesloten met de annotatie downscaler/exclude-until met een absolute timestamp in het formaat JJJJ-MM-DD uu:mm (UTC). Indien nodig kan het hele cluster weer worden opgeschaald door een pod te implementeren met de annotatie downscaler/force-uptime, bijvoorbeeld door een nginx-stub te draaien:
kubectl run scale-up --image=nginx
kubectl annotate deploy scale-up janitor/ttl=1h # verwijder deployment over een uur
kubectl annotate pod $(kubectl get pod -l run=scale-up -o jsonpath="{.items[0].metadata.name}") downscaler/force-uptime=true
Zie , als je geïnteresseerd bent in de implementatiehandleiding en aanvullende opties.
Gebruik horizontale autoscaling
Veel applicaties/diensten hebben te maken met een dynamisch laadprofiel: soms zijn hun modules inactief, en soms draaien ze op volle capaciteit. Werken met een constante vloot van pods om de maximale piekbelasting aan te kunnen is niet kosteneffectief. Kubernetes ondersteunt horizontale autoscaling via de resource (HPA). Het gebruik van CPU is vaak een goede indicator voor schaalvergroting:
apiVersion: autoscaling/v2beta2
kind: HorizontalPodAutoscaler
metadata:
  name: my-app
spec:
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: my-app
  minReplicas: 3
  maxReplicas: 10
  metrics:
  - type: Resource
    resource:
      name: cpu
      target:
        averageUtilization: 100
        type: Utilization
Zalando heeft een component ontwikkeld voor eenvoudige aansluiting van gebruikersspecifieke metrics voor autoscaling: (kube-metrics-adapter) is een universële metrics adapter voor Kubernetes, die gebruikersspecifieke en externe metrics kan verzamelen en aanbieden voor horizontale autoscaling van pods. Het ondersteunt autoscaling op basis van Prometheus metrics, SQS-wachtrijen en andere instellingen. Bijvoorbeeld, om een deployment te schalen voor een gebruikersspecifieke metric, geleverd door de applicatie zelf in JSON-formaat bij /metrics, gebruik:
apiVersion: autoscaling/v2beta2
kind: HorizontalPodAutoscaler
metadata:
  name: myapp-hpa
  annotations:
    # metric-config.<metricType>.<metricName>.<collectorName>/<configKey>
    metric-config.pods.requests-per-second.json-path/json-key: "$.http_server.rps"
    metric-config.pods.requests-per-second.json-path/path: /metrics
    metric-config.pods.requests-per-second.json-path/port: "9090"
spec:
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: myapp
  minReplicas: 1
  maxReplicas: 10
  metrics:
  - type: Pods
    pods:
      metric:
        name: requests-per-second
      target:
        averageValue: 1k
        type: AverageValue
De configuratie van horizontale autoscaling met behulp van HPA zou een van de standaard actiestappen moeten zijn om de efficiëntie te verhogen voor stateless services. Spotify heeft een presentatie met hun ervaringen en aanbevelingen voor HPA: .
Vermindering van overbodige resource-reservering
Kubernetes workloads definiëren hun behoeften aan CPU/geheugen via ‘resource requests’. CPU-resources worden gemeten in virtuele cores of vaker in 'millicores' (millicores), bijvoorbeeld, 500m betekent 50% vCPU. Geheugenresources worden gemeten in bytes, en gebruikelijke suffixen kunnen worden gebruikt, bijvoorbeeld, 500Mi wat betekent 500 megabyte. Resource requests 'belemmeren' de hoeveelheid op de worker nodes, wat betekent dat een module met een CPU-request van 1000m op een node met 4 virtuele CPU's alleen 3 virtuele CPU's beschikbaar laat voor andere modules.
Slack (overmaat reserve) — dit is het verschil tussen de gevraagde middelen en het werkelijke gebruik. Bijvoorbeeld, een pod die 2 GiB geheugen aanvraagt maar slechts 200 MiB gebruikt, heeft ~ 1,8 GiB 'overtollig' geheugen. Overtolligheid kost geld. Je kunt ruwweg schatten dat 1 GiB overtollig geheugen ongeveer ~ 10 dollar per maand kost.
(kube-resource-report) toont overtollige reserves en kan je helpen het potentieel voor besparingen te bepalen:
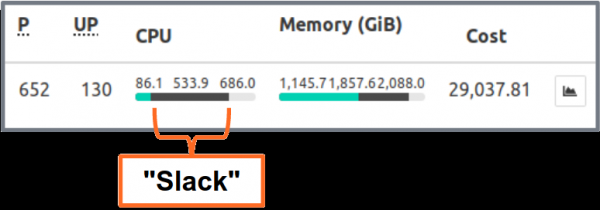
toont de overtolligheid, geaggregeerd door de applicatie en team. Dit maakt het mogelijk om gebieden te vinden waar de resource aanvragen verlaagd kunnen worden. Het gegenereerde HTML-rapport biedt slechts een momentopname van het resourcegebruik. Je moet het CPU/geheugenverbruik in de tijd bekijken om de geschikte resource aanvragen te bepalen. Hier is een Grafana-diagram voor een 'typische' service met een hoge CPU-belasting: alle pods gebruiken beduidend minder dan 3 gevraagde CPU-kernen:
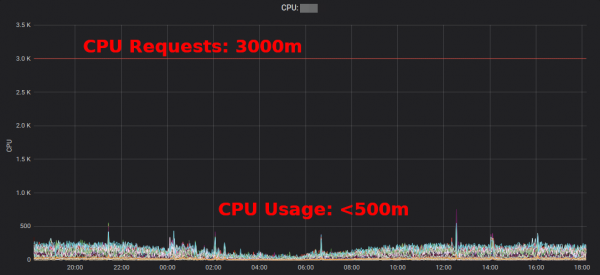
Een verlaging van de CPU-aanvraag van 3000m tot ~400m vrijmaakt middelen voor andere werkbelastingen en de cluster verkleint.
‘De gemiddelde CPU-gebruik van EC2-instanties fluctueert vaak binnen een enkelcijferig percentage’, . Terwijl voor EC2 is het gemakkelijk om sommige resource-aanvragen in het Kubernetes YAML-bestand te wijzigen en kan dit enorme besparingen opleveren.
Maar willen we echt dat mensen waarden in YAML-bestanden aanpassen? Nee, machines kunnen dit veel beter! Kubernetes VPA doet precies dat: past resource-aanvragen en beperkingen aan op basis van de werkbelasting. Hier is een voorbeeldgrafiek van CPU-aanvragen in Prometheus (de dunne blauwe lijn), aangepast door de VPA in de loop van de tijd:
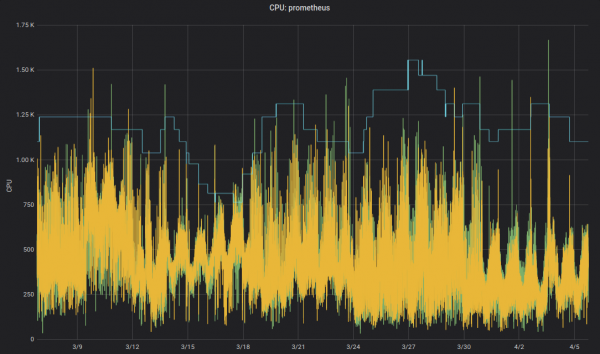
voor infrastructuurcomponenten. Niet-kritische applicaties kunnen ook gebruikmaken van VPA.
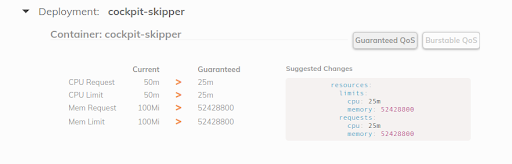
van Fairwind is een tool die VPA genereert voor elke deployment in de namespace en vervolgens de VPA-aanbevelingen op zijn dashboard weergeeft. Het kan ontwikkelaars helpen om de juiste CPU/geheugen aanvragen voor hun applicaties in te stellen:
Ik schreef een korte in 2019, en onlangs werd in de .
Gebruik van EC2 Spot-instanties.
Ten slotte, en niet minder belangrijk, kunnen de kosten van AWS EC2 worden verlaagd door Spot-instanties te gebruiken als werkknopen voor Kubernetes. Spot-instanties zijn beschikbaar met kortingen tot 90% ten opzichte van on-demand prijzen. Kubernetes draaien op EC2 Spot is een goede combinatie: je moet verschillende typen instanties opgeven voor een hogere beschikbaarheid, wat betekent dat je grotere knopen kunt krijgen voor dezelfde of lagere prijs, en de extra capaciteit kan worden gebruikt door de container workloads van Kubernetes.
Hoe Kubernetes op EC2 Spot te draaien? Er zijn verschillende opties: gebruik een externe service zoals SpotInst (nu gewoon „Spot”, vraag me niet waarom), of voeg gewoon een Spot AutoScalingGroup (ASG) toe aan je cluster. Bijvoorbeeld, hier is een fragment van CloudFormation voor een 'capaciteit-geoptimaliseerde' Spot ASG met meerdere instantietypen:
MySpotAutoScalingGroup:
 Properties:
   HealthCheckGracePeriod: 300
   HealthCheckType: EC2
   MixedInstancesPolicy:
     InstancesDistribution:
       OnDemandPercentageAboveBaseCapacity: 0
       SpotAllocationStrategy: capacity-optimized
     LaunchTemplate:
       LaunchTemplateSpecification:
         LaunchTemplateId: !Ref LaunchTemplate
         Version: !GetAtt LaunchTemplate.LatestVersionNumber
       Overrides:
         - InstanceType: "m4.2xlarge"
         - InstanceType: "m4.4xlarge"
         - InstanceType: "m5.2xlarge"
         - InstanceType: "m5.4xlarge"
         - InstanceType: "r4.2xlarge"
         - InstanceType: "r4.4xlarge"
   LaunchTemplate:
     LaunchTemplateId: !Ref LaunchTemplate
     Version: !GetAtt LaunchTemplate.LatestVersionNumber
   MinSize: 0
   MaxSize: 100
   Tags:
   - Key: k8s.io/cluster-autoscaler/node-template/label/aws.amazon.com/spot
     PropagateAtLaunch: true
     Value: "true"
Enkele opmerkingen over het gebruik van Spot met Kubernetes:
- Je moet Spot-onderbrekingen beheren, bijvoorbeeld door de knoop te beëindigen bij het stoppen van een instantie.
- Zalando gebruikt officiële cluster-autoscaling met node pool prioriteiten.
- Spot-knooppunten om ‘registraties’ van workloads te accepteren voor uitvoering in Spot.
Samenvatting
Ik hoop dat je enkele van de gepresenteerde tools nuttig vindt om je cloudkosten te verlagen. Je kunt het meeste van de inhoud van het artikel ook vinden in .
Wat zijn jouw beste praktijken voor het besparen op cloudkosten met Kubernetes? Laat het me weten op .
In feite zullen er minder dan 3 virtuele CPU's overblijven die bruikbaar zijn, omdat de knooppuntbandbreedte vermindert door gereserveerde systeembestanden. Kubernetes onderscheidt de fysieke capaciteit van een knooppunt en de "toegewezen" bronnen ().
Voorbeeld van calculatie: één m5.large instantie met 8 GiB geheugen kost ongeveer ~84 dollar per maand (eu-central-1, On-Demand), dat wil zeggen, de blokkering van 1/8 van een knooppunt kost ongeveer ~10 dollar per maand.
Er zijn nog veel manieren om uw EC2-rekeningen te verlagen, zoals gereserveerde instanties, spaarplannen, enz. — ik zal deze onderwerpen hier niet behandelen, maar u moet daar zeker meer over te weten komen!
Bron: habr.com
