

Als uw IT-infrastructuur te snel groeit, komt u vroeg of laat voor de keuze te staan – het lineair uitbreiden van de menselijke middelen om deze te ondersteunen of het starten van automatisering. Tot op een bepaald moment leefden we in het eerste paradigma, en daarna begon de lange weg naar Infrastructure-as-Code.
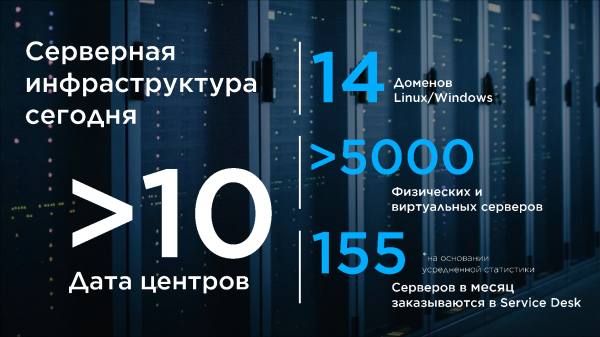
Natuurlijk is NSPK geen start-up, maar zo'n sfeer heerste in het bedrijf in de eerste jaren van zijn bestaan, en dat waren zeer interessante jaren. Mijn naam is , ik ondersteun al meer dan 10 jaar een Linux-infrastructuur met hoge beschikbaarheidseisen. Ik ben in januari 2016 bij het NSPK-team gekomen en, helaas, heb ik het begin van het bestaan van het bedrijf niet meegemaakt, maar ik kwam in een fase van grote veranderingen.
Over het algemeen kan gezegd worden dat ons team 2 producten voor het bedrijf levert. De eerste is de infrastructuur. De e-mail moet functioneren, de DNS moet werken, en de domeincontroles moeten u toegang geven tot de servers, die niet mogen uitvallen. Het IT-landschap van het bedrijf is enorm! Dit zijn business-&mission crucial systemen, waarbij de beschikbaarheidseisen van sommige 99,999 zijn. Het tweede product zijn de servers zelf, zowel fysiek als virtueel. We moeten de bestaande servers in de gaten houden en regelmatig nieuwe leveren aan klanten uit verschillende afdelingen. In dit artikel wil ik benadrukken hoe we de infrastructuur hebben ontwikkeld die verantwoordelijk is voor de levenscyclus servers.
Het begin van de reis
Aan het begin van de reis zag onze techstack eruit als volgt:
OS CentOS 7
Domeincontrollers FreeIPA
Automatisering — Ansible(+Tower), Cobbler
Dit alles bevond zich in 3 domeinen, verspreid over verschillende datacenters. In één datacenter – kantoorsystemen en testomgevingen, in de andere PROD.
Het aanmaken van servers zag er op een gegeven moment zo uit:
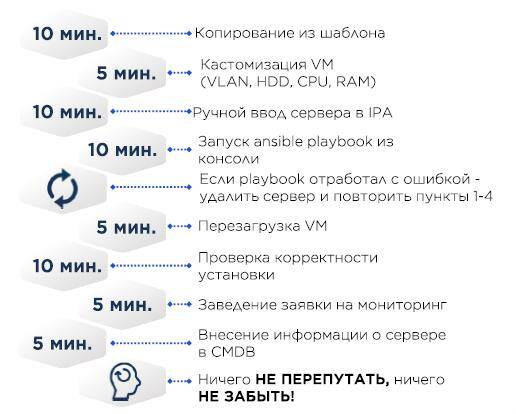
In de VM-sjabloon CentOS minimal en de noodzakelijke minimum zoals een correct /etc/resolv.conf, de rest komt binnen via Ansible.
CMDB – Excel.
Als de server fysiek is, wordt in plaats van het kopiëren van de virtuele machine het OS geïnstalleerd met behulp van Cobbler – de MAC-adressen van de doelsystemen worden aan de Cobbler-configuratie toegevoegd, de server krijgt een IP-adres via DHCP en vervolgens wordt het OS geïnstalleerd.
In het begin probeerden we zelfs enige configuration management in Cobbler te doen. Maar na verloop van tijd begon dit problemen te veroorzaken met de draagbaarheid van configuraties, zowel naar andere datacenters als naar de Ansible-code voor het voorbereiden van VM's.
Veel van ons beschouwden Ansible toen als een handige uitbreiding van Bash en waren niet zuinig met constructies die gebruik maakten van shell, sed. Kortom, Bashsible. Dit leidde er uiteindelijk toe dat als de playbook om wat voor reden dan ook niet werkte op de server, het eenvoudiger was om de server te verwijderen, de playbook te corrigeren en opnieuw uit te voeren. Er was in wezen geen versiebeheer van scripts, en ook de draagbaarheid van configuraties ontbrak.
Bijvoorbeeld, we willen een bepaalde configuratie op alle servers wijzigen:
- We wijzigen de configuratie op bestaande servers in de logische segmenten/centra voor gegevens. Soms niet binnen een dag – eisen aan beschikbaarheid en de wetten van de grote getallen maken het onmogelijk om alle wijzigingen in één keer door te voeren. Sommige wijzigingen zijn potentieel destructief en vereisen het herstarten van iets – van diensten tot het besturingssysteem zelf.
- We corrigeren in Ansible
- We corrigeren in Cobbler
- We herhalen dit N keer voor elk logisch segment/centrum voor gegevens
Om ervoor te zorgen dat alle wijzigingen soepel verlopen, moesten we rekening houden met vele factoren, en de wijzigingen zijn voortdurend aan de gang.
- Refactoring van Ansible-code, configuratiebestanden
- Wijziging van interne best practices
- Wijzigingen naar aanleiding van het onderzoek van incidenten/ongevallen
- Wijzing van veiligheidsnormen, zowel intern als extern. Bijvoorbeeld, PCI DSS wordt elk jaar aangevuld met nieuwe vereisten.
Groeien van de infrastructuur en het begin van de weg
Het aantal servers/logische domeinen/centra voor gegevens nam toe, evenals het aantal fouten in de configuraties. Op een gegeven moment kwamen we tot drie richtingen waarin we configuration management moesten ontwikkelen:
- Automatisering. Waar mogelijk moet de menselijke factor worden vermeden in repetitieve operaties.
- Herhaalbaarheid. Het is veel eenvoudiger om de infrastructuur te beheren wanneer deze voorspelbaar is. De configuratie van servers en de tools voor hun voorbereiding moeten overal identiek zijn. Dit is ook heel belangrijk voor productteams – de applicatie moet gegarandeerd na het testen in de productieomgeving terechtkomen, die op dezelfde manier is ingesteld als de testomgeving.
- Eenvoud en transparantie van wijzigingen in het configuration management.
We moeten nog een paar tools toevoegen.
Als code-opslag hebben we gekozen voor GitLab CE, niet in de laatste plaats vanwege de ingebouwde CI/CD-modules.
Opslag van geheimen — Hashicorp Vault, onder andere vanwege de geweldige API.
Configuratietests en Ansible-rollen – Molecule + Testinfra. Tests gaan veel sneller als je mitogen aan Ansible toevoegt. Tegelijkertijd zijn we begonnen met het schrijven van onze eigen CMDB en orkestrator voor automatische deployment (op de afbeelding boven Cobbler), maar dat is een heel ander verhaal, waar mijn collega en hoofddesigner van deze systemen in de toekomst meer over zal vertellen.
Onze keuze:
Molecule + Testinfra
Ansible + Tower + AWX
Wereld van Servers + DITNET (Eigen ontwikkeling)
Cobbler
GitLab + GitLab Runner
HashiCorp Vault
Over Ansible-rollen gesproken. Eerst was er één, na enkele refactoringen zijn het er 17 geworden. Ik raad ten zeerste aan om een monoliet op te splitsen in idempotente rollen, die je daarna apart kunt uitvoeren; tags kunnen ook worden toegevoegd. We hebben de rollen gebaseerd op functionaliteit – netwerk, logging, pakketten, hardware, molecule, enzovoort. Over het algemeen hebben we ons aan de onderstaande strategie gehouden. Ik beweer niet dat dit de enige waarheid is, maar bij ons heeft het gewerkt.
- Het kopiëren van servers vanuit een “gouden afbeelding” – slecht!Een van de belangrijkste nadelen is dat je precies niet weet in welke staat de beelden zich nu bevinden en dat alle wijzigingen naar alle beelden in alle virtualisatieboerderijen komen.
- Gebruik de standaard configuratiebestanden zo min mogelijk en maak afspraken met andere afdelingen dat jij verantwoordelijk bent voor de belangrijkste systeembestanden., bijvoorbeeld:
- Houd /etc/sysctl.conf leeg; configuraties moeten alleen in /etc/sysctl.d/ liggen. Jouw standaard in één bestand, custom voor de applicatie in een ander.
- Gebruik override-bestanden om systemd-units te bewerken.
- Maak alle configuraties templatiseerbaar en lever ze volledig aan, zo veel mogelijk geen sed en vergelijkbare tools in playbooks.
- Bij het refactoren van de code van het configuratiebeheersysteem:
- Verdeel taken in logische entiteiten en herschrijf de monoliet naar rollen.
- Gebruik linters! Ansible-lint, yaml-lint, enzovoort.
- Verander de aanpak! Geen bashsible. De staat van het systeem moet worden beschreven.
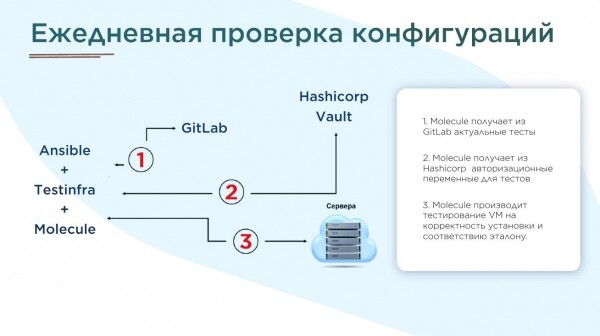
- Voor alle Ansible-rollen moeten tests in Molecule worden geschreven en elke dag rapporten worden gegenereerd.
- In ons geval, na het voorbereiden van de tests (waarvan er meer dan 100 zijn), vonden we ongeveer 70.000 fouten. We hebben er enkele maanden aan gewerkt.

Onze implementatie
Dus, Ansible-rollen waren gereed, getemplate en gecontroleerd door linters. En zelfs de git-repositories waren overal opgezet. Maar de vraag van betrouwbare codelevering naar verschillende segmenten bleef openstaan. We besloten te synchroniseren met scripts. Het ziet er zo uit:
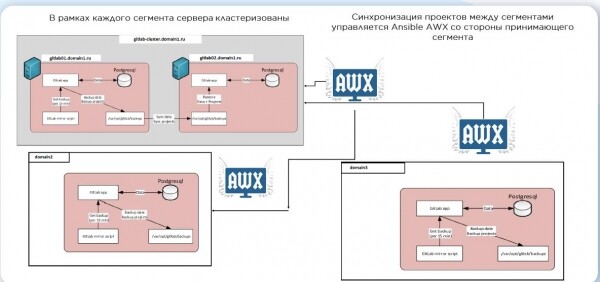
Nadat de wijziging is binnengekomen, wordt CI gestart, een testserver aangemaakt, rollen uitgevoerd en moleculair getest. Als alles goed is, gaat de code naar de producttak. Maar we passen de nieuwe code niet automatisch toe op bestaande servers. Dit is een soort van stop die noodzakelijk is voor de hoge beschikbaarheid van onze systemen. En wanneer de infrastructuur enorm wordt, komt ook de wet van de grote getallen in het spel – zelfs als u zeker bent dat de wijziging onschuldig is, kan het leiden tot droevige gevolgen.
Er zijn ook veel manieren om servers aan te maken. Uiteindelijk hebben we gekozen voor aangepaste scripts in Python. En voor CI Ansible:
- name: create1.yml - Maak een VM aan vanuit een sjabloon
  vmware_guest:
    hostname: "{{datacenter}}".domain.ru
    username: "{{ username_vc }}"
    password: "{{ password_vc }}"
    validate_certs: no
    cluster: "{{cluster}}"
    datacenter: "{{datacenter}}"
    name: "{{ name }}"
    state: poweredon
    folder: "/{{folder}}"
    template: "{{template}}"
    customization:
      hostname: "{{ name }}"
      domain: domain.ru
      dns_servers:
        - "{{ ipa1_dns }}"
        - "{{ ipa2_dns }}"
    networks:
      - name: "{{ network }}"
        type: static
        ip: "{{ip}}"
        netmask: "{{netmask}}"
        gateway: "{{gateway}}"
        wake_on_lan: True
        start_connected: True
        allow_guest_control: True
    wait_for_ip_address: yes
    disk:
      - size_gb: 1
        type: thin
        datastore: "{{datastore}}"
      - size_gb: 20
        type: thin
        datastore: "{{datastore}}"
Dit is waar we zijn gekomen, het systeem blijft leven en ontwikkelen.
- 17 Ansible-rollen voor serverconfiguratie. Elke rol is bedoeld om een afzonderlijke logische taak op te lossen (logging, auditing, gebruikersauthenticatie, monitoring, enz.).
- Testen van rollen. Molecule + TestInfra.
- Eigen ontwikkeling: CMDB + Orkestrator.
- Tijd om een server aan te maken is ongeveer 30 minuten, geautomatiseerd en vrijwel onafhankelijk van de wachtrij van taken.
- Gelijke staat/namen van infrastructuur in alle segmenten – playbooks, repositories, elementen van virtualisatie.
- Dagelijkse controle van de serverstatus met rapportages over afwijkingen van de norm.
Ik hoop dat mijn verhaal nuttig zal zijn voor degenen die aan het begin van hun pad staan. En welke automatiseringsstack gebruiken jullie?
Bron: habr.com
