

Structureren van ongestructureerde gegevens met GROK
Als je de Elastic Stack (ELK) gebruikt en geïnteresseerd bent in het koppelen van gebruikerslogboeken van Logstash aan Elasticsearch, dan is deze post voor jou.
De ELK-stack is een afkorting voor drie open-source projecten: Elasticsearch, Logstash en Kibana. Samen vormen ze een platform voor logbeheer.
- Elasticsearch is een zoek- en analyset systeem.
- Logstash is een server-side gegevensverwerkingspipeline die gegevens gelijktijdig uit meerdere bronnen accepteert, deze transformeert en vervolgens naar een 'repository' zoals Elasticsearch verzendt.
- Kibana stelt gebruikers in staat om gegevens te visualiseren met behulp van diagrammen en grafieken in Elasticsearch.
Beats werd later geïntroduceerd en is een lichte gegevenszender. De introductie van Beats transformeerde de ELK Stack in de Elastic Stack, maar dat is niet het belangrijkste.
Dit artikel is gewijd aan Grok, wat een functie in Logstash is die je logboeken kan transformeren voordat ze naar de repository worden verzonden. Voor onze doeleinden zal ik me alleen richten op het verwerken van gegevens van Logstash naar Elasticsearch.
Grok is een filter binnen Logstash dat wordt gebruikt om ongestructureerde gegevens te parseren naar iets gestructureerds en doorzoekbaars. Het is gebaseerd op reguliere expressies (regex) en gebruikt tekstpatronen om lijnen in logbestanden te matchen.
Zoals we in de volgende secties zullen zien, is het gebruik van Grok van groot belang voor effectief logbeheer.
Zonder Grok zijn je loggegevens ongestructureerd.
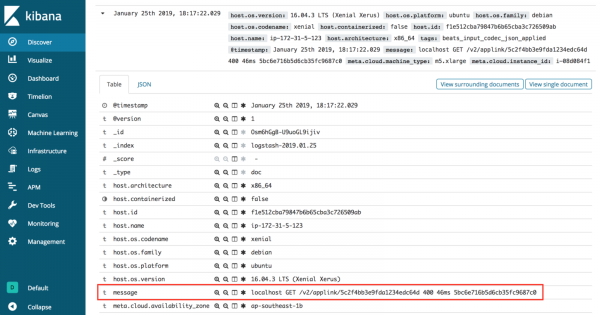
Zonder Grok, wanneer logboeken van Logstash naar Elasticsearch worden verzonden en in Kibana worden weergegeven, verschijnen ze alleen in de message value.
Het opvragen van betekenisvolle informatie in deze situatie is problematisch, omdat alle loggegevens in één sleutel zijn opgeslagen. Het zou beter zijn als logberichten beter georganiseerd waren.
Ongestructureerde gegevens uit logs
localhost GET /v2/applink/5c2f4bb3e9fda1234edc64d 400 46ms 5bc6e716b5d6cb35fc9687c0Als je nauwkeurig naar de ruwe gegevens kijkt, zie je dat ze eigenlijk uit verschillende delen bestaan, die elk door een spatie zijn gescheiden.
Voor meer ervaren ontwikkelaars kun je waarschijnlijk raden wat elk van de delen betekent en dat dit logbericht van een API-aanroep is. De weergave van elk punt is hieronder uiteengezet.
De gestructureerde weergave van onze gegevens
- localhost == omgeving
- GET == methode
- /v2/applink/5c2f4bb3e9fda1234edc64d == url
- 400 == response_status
- 46ms == response_time
- 5bc6e716b5d6cb35fc9687c0 == user_id
Zoals we zien in de gestructureerde gegevens, is er een volgorde voor ongestructureerde logboeken. De volgende stap is de programmeerbare verwerking van de ruwe gegevens. Dit is waar Grok uitblinkt.
Grok-sjablonen
Grok wordt geleverd met meer dan 100 ingebouwde sjablonen voor het structureren van ongestructureerde gegevens. U moet hier zeker gebruik van maken wanneer mogelijk voor algemene systeemaantekeningen, zoals apache, linux, haproxy, aws, enz.
Maar wat gebeurt er als u aangepaste logboeken heeft, zoals in het bovenstaande voorbeeld? U moet uw eigen Grok-sjabloon bouwen.
Aangepaste Grok-sjablonen
Je moet experimenteren om je eigen Grok-sjabloon te bouwen. Ik heb gebruik gemaakt van
Grok Debugger en .
%{SYNTAX:SEMANTIC} Het eerste wat ik probeerde te doen, was naar het tabblad
Ontdek in de Grok-debugger te gaan. Ik dacht dat het geweldig zou zijn als dit hulpmiddel automatisch een Grok-sjabloon kon genereren, maar dat was niet echt nuttig, omdat het slechts twee overeenkomsten vond. Met deze ontdekking begon ik mijn eigen sjabloon te maken in de Grok-debugger, gebruikmakend van de syntaxis gevonden op de Elastic GitHub-pagina.
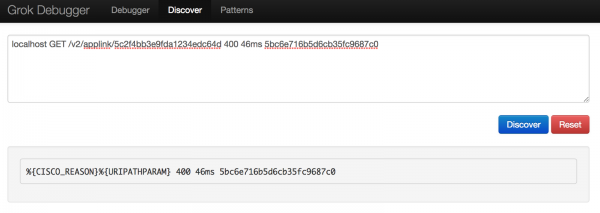
Door te spelen met verschillende syntaxes, kon ik uiteindelijk de loggegevens structureren zoals ik wilde.
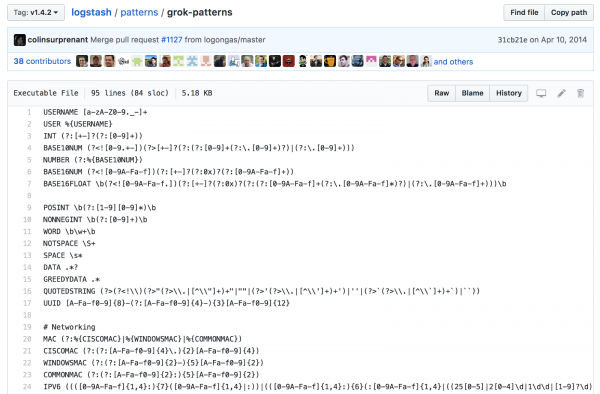
Link naar de Grok-debugger
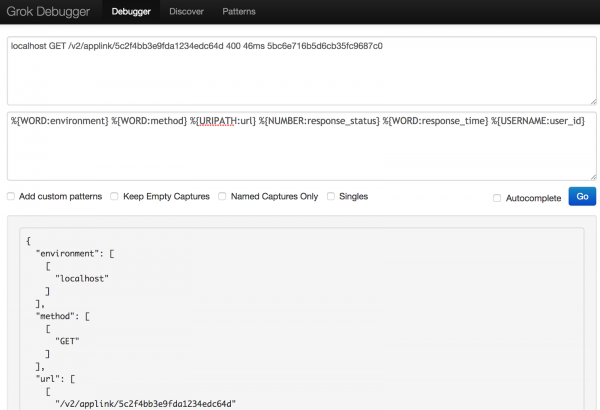
Originele tekst:
Patroon:
localhost GET /v2/applink/5c2f4bb3e9fda1234edc64d 400 46ms 5bc6e716b5d6cb35fc9687c0%{WORD:environment} %{WORD:method} %{URIPATH:url} %{NUMBER:response_status} %{WORD:response_time} %{USERNAME:user_id}
Dit is wat er uiteindelijk uitkwam{ "environment": [ [ "localhost" ] ], "method": [ [ "GET" ] ], "url": [ [ "/v2/applink/5c2f4bb3e9fda1234edc64d" ] ], "response_status": [ [ "400" ] ], "BASE10NUM": [ [ "400" ] ], "response_time": [ [ "46ms" ] ], "user_id": [ [ "5bc6e716b5d6cb35fc9687c0" ] ] }
Met het Grok-sjabloon en de overeenkomende gegevens in handen, is de laatste stap om het toe te voegen aan Logstash.Logstash.conf-configuratiebestand bijwerken
Op de server waar u de ELK-stack hebt geïnstalleerd, navigeer naar de configuratie van Logstash:
sudo vi /etc/logstash/conf.d/logstash.conf
Voeg de wijzigingen toe.input { file { path => "/your_logs/*.log" } } filter{ grok { match => { "message" => "%{WORD:environment} %{WORD:method} %{URIPATH:url} %{NUMBER:response_status} %{WORD:response_time} %{USERNAME:user_id}"} } } output { elasticsearch { hosts => [ "localhost:9200" ] } }
input {
  file {
    path => "/your_logs/*.log"
  }
}
filter{
  grok {
    match => { "message" => "%{WORD:environment} %{WORD:method} %{URIPATH:url} %{NUMBER:response_status} %{WORD:response_time} %{USERNAME:user_id}"}
  }
}
output {
  elasticsearch {
    hosts => [ "localhost:9200" ]
  }
}
Na het opslaan van de wijzigingen, start Logstash opnieuw en controleer de status om te bevestigen dat het nog steeds actief is.
sudo service logstash restart
sudo service logstash status
Om ervoor te zorgen dat de wijzigingen van kracht zijn, moet je de Elasticsearch-index voor Logstash in Kibana bijwerken!
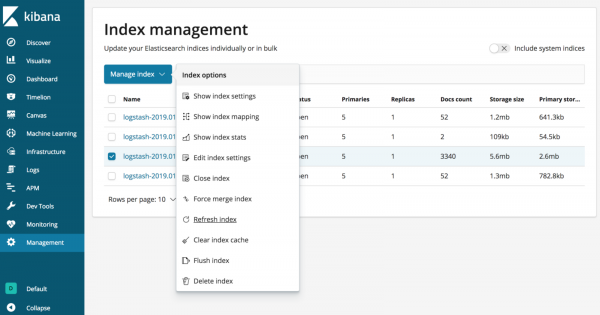
Met Grok zijn je loggegevens gestructureerd!
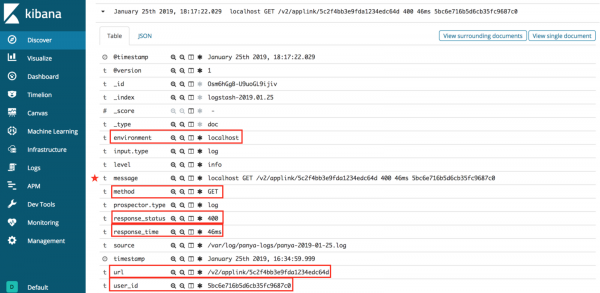
Zoals we op de afbeelding hierboven zien, kan Grok gegevens automatisch koppelen aan Elasticsearch. Dit vergemakkelijkt het beheer van logs en het snel opvragen van informatie. In plaats van in logbestanden te graven voor debugging, kun je eenvoudig filteren op wat je zoekt, zoals de omgeving of een URL.
Probeer Grok-expressies een kans te geven! Als je een andere manier hebt om dit te doen of als je problemen hebt met de bovenstaande voorbeelden, laat dan gewoon een opmerking hieronder achter om me hierover te informeren.
Bedankt voor het lezen — en volg me alsjeblieft hier op Medium voor meer interessante artikelen over software-engineering!
Hulpmiddelen
P.S
Telegram-kanaal over
Bron: habr.com
