

Sinds 2019 geldt in Rusland de wet op de verplichte etikettering. Deze wet is niet van toepassing op alle productgroepen, en de inwerkingtredingsdata voor de verplichte etikettering verschillen per productgroep. De eerste producten die onder de verplichte etikettering vallen zijn tabak, schoenen en medicijnen; later zullen andere producten zoals parfums, textiel en melk worden toegevoegd. Deze wetgeving heeft geleid tot de ontwikkeling van nieuwe IT-oplossingen die het mogelijk maken om de gehele levenscyclus van een product te volgen, vanaf productie tot aankoop door de eindklant, voor alle betrokken partijen: zowel de staat als alle organisaties die producten met verplichte etikettering verkopen.
Bij X5 kreeg het systeem dat producten met etikettering zal volgen en gegevens uitwisselen met de staat en leveranciers de naam 'Markus'. We vertellen je in volgorde wie het heeft ontwikkeld, welke technologie wordt gebruikt en waarom we trots kunnen zijn.
Echte HighLoad
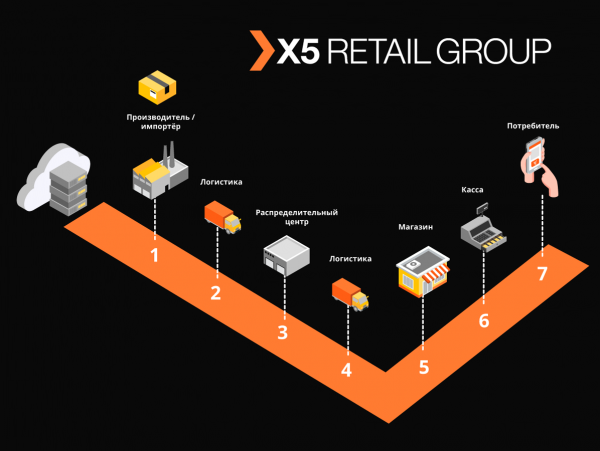
‘Markus’ lost vele taken op, waarvan de belangrijkste de integratie tussen de informatiesystemen van X5 en het staats-informatiesysteem voor geëtiketteerde producten (GIS MP) is, om de beweging van geëtiketteerde producten te volgen. Het platform slaat ook alle codes van de etiketten die we hebben ontvangen en de volledige geschiedenis van deze codes op, en helpt om fouten in de etikettering van producten te elimineren. Neem bijvoorbeeld tabaksproducten, die tot de eerste groepen van geëtiketteerde goederen behoren; slechts één vrachtwagen met sigaretten bevat ongeveer 600.000 verpakkingen, elk met een unieke code. Onze taak is om de legaliteit van de verplaatsing van elke verpakking tussen magazijnen en winkels te volgen en uiteindelijk te verifiëren of de verkoop aan de eindklant toegestaan is. We registreren ongeveer 125.000 kassatransacties per uur, en we moeten ook vastleggen hoe elke verpakking in de winkel is gekomen. Gezien de totale verplaatsingen tussen de objecten verwachten we tientallen miljarden registraties per jaar.
Team M
Hoewel "Marcus" binnen X5 als een project wordt beschouwd, wordt het uitgevoerd met een productgerichte aanpak. Het team werkt volgens Scrum. Het project is begonnen in de zomer van vorig jaar, maar de eerste resultaten kwamen pas in oktober — het team werd volledig samengesteld, de systeemarchitectuur is ontwikkeld en de apparatuur is aangeschaft. Op dit moment bestaat het team uit 16 personen, waarvan zes zich bezighouden met backend- en frontend-ontwikkeling, en drie met systemanalyse. Nog eens zes personen zijn verantwoordelijk voor handmatige, load- en geautomatiseerde tests, evenals productondersteuning. Daarnaast hebben we een SRE-specialist.
De code in ons team wordt niet alleen geschreven door ontwikkelaars, bijna iedereen kan programmeren en schrijft autotests, load-scripts en automatiseringsscripts. We hechten hier veel waarde aan, omdat zelfs productondersteuning een hoge mate van automatisering vereist. Collega's die eerder niet geprogrammeerd hebben, proberen we altijd te adviseren en te helpen door hen kleine taken aan te bieden.
Vanwege de coronaviruspandemie hebben we het hele team op afstand laten werken; het hebben van alle benodigde tools voor het beheer van de ontwikkeling en de workflow die is opgezet in Jira en GitLab, maakten het gemakkelijk om deze fase door te komen. De maanden die op afstand zijn doorgebracht, toonden aan dat de productiviteit van het team er niet onder leed, en voor velen was het werkcomfort verhoogd; het enige dat ontbreekt, is persoonlijke interactie.
Teamvergadering vóór de thuiswerkperiode
Vergaderingen tijdens de thuiswerkperiode
Technologische stack van de oplossing
De standaardrepository en CI/CD-tool voor X5 is GitLab. We gebruiken het voor het opslaan van code, continue testen en uitrollen op test- en productieservers. Ook maken we gebruik van de praktijk van code review, waarbij minimaal twee collega's akkoord moeten geven voor de wijzigingen die door de ontwikkelaar in de code zijn aangebracht. Statistische code-analysetools zoals SonarQube en JaCoCo helpen ons om de code schoon te houden en het vereiste niveau van unit testdekking te waarborgen. Alle wijzigingen in de code moeten noodzakelijkerwijs door deze controles gaan. Alle testscenario's die handmatig worden uitgevoerd, worden later geautomatiseerd.
Voor het succesvolle verloop van de zakelijke processen van "Marcus" moesten we een aantal technologische vraagstukken oplossen, elk in volgorde.
Taak 1. De noodzaak van horizontale schaalbaarheid van het systeem
Om dit probleem op te lossen, hebben we gekozen voor een microservices-architectuur. Het was daarbij erg belangrijk om de verantwoordelijkheidsgebieden van de services te begrijpen. We hebben geprobeerd ze op te splitsen volgens bedrijfsactiviteiten met oog voor de specificiteit van de processen. Bijvoorbeeld, de ontvangst in het magazijn is geen zeer frequente, maar wel een zeer omvangrijke operatie, waarbij het van groot belang is om zo snel mogelijk informatie over de ontvangen eenheden goederen van de overheid te verkrijgen, waarvan het aantal in één levering kan oplopen tot 600.000, de toelaatbaarheid van de ontvangst van deze goederen in het magazijn te controleren en alle benodigde informatie aan het magazijnautomatiseringssysteem te geven. Aan de andere kant heeft het uitladen van magazijnen een veel grotere intensiteit, maar werkt het met kleinere hoeveelheden gegevens.
We implementeren alle services volgens het stateless-principe en proberen zelfs interne bewerkingen op te splitsen in stappen, waarbij we, zoals we het noemen, self-topics van Kafka gebruiken. Dit is wanneer een microservice een bericht naar zichzelf stuurt, wat helpt om de belasting bij meer resource-intensieve operaties te balanceren en het onderhoud van het product te vereenvoudigen, maar daarover later meer.
We hebben besloten om modules voor interactie met externe systemen in aparte services onder te brengen. Dit heeft het probleem van vaak wijzigende API's van externe systemen opgelost, praktisch zonder invloed op de services met bedrijfsfunctionaliteit.
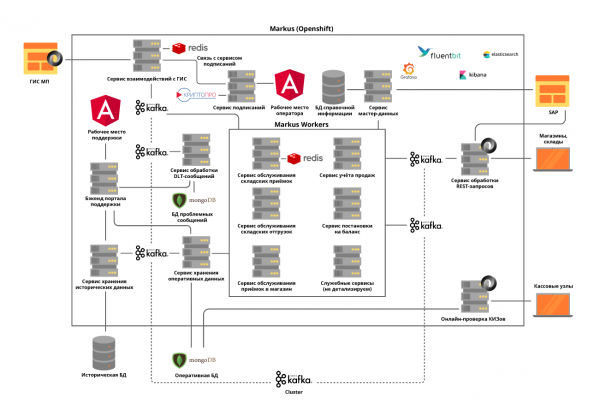
Alle microservices worden uitgerold in een OpenShift-cluster, dat zowel het probleem van de schaalbaarheid van elke microservice oplost als ons in staat stelt geen externe Service Discovery-tools te gebruiken.
Taak 2. De noodzaak om hoge belasting en zeer intensieve gegevensuitwisseling tussen de services van het platform te ondersteunen: alleen in de opstartfase van het project worden ongeveer 600 operaties per seconde uitgevoerd. We verwachten dat deze waarde zal stijgen tot 5000 op/s naarmate er meer commerciële objecten op ons platform worden aangesloten.
Deze uitdaging werd aangepakt door een Kafka-cluster in te zetten en vrijwel volledig af te zien van synchrone interactie tussen de microservices van het platform. Dit vereist een zorgvuldige analyse van de systeemvereisten, aangezien niet alle bewerkingen asynchroon kunnen zijn. We verzenden niet alleen gebeurtenissen via de broker, maar ook alle benodigde bedrijfsinformatie in het bericht. Hierdoor kan de berichtgrootte oplopen tot enkele honderden kilobytes. De beperking in de berichtgrootte in Kafka vereist dat we de grootte van de berichten accuraat voorspellen, en indien nodig splitsen we ze, maar deze splitsing is logisch en gerelateerd aan bedrijfsoperaties.
Bijvoorbeeld, goederen die in een auto zijn aangekomen, splitsen we op dozen. Voor synchrone operaties worden aparte microservices aangemaakt en wordt er grondig prestatietests uitgevoerd. Het gebruik van Kafka heeft ons voor een andere uitdaging gesteld - het testen van onze service rekening houdend met de integratie van Kafka maakt al onze unittests asynchroon. Deze uitdaging hebben we opgelost door eigen hulpfuncties te schrijven met behulp van de Embedded Kafka Broker. Dit annuleert de noodzaak om unittests voor afzonderlijke methoden te schrijven niet, maar voor complexe gevallen geven we de voorkeur aan testen met behulp van Kafka.
We hebben veel aandacht besteed aan het traceren van logs, zodat hun TraceId niet verloren gaat bij het optreden van uitzonderingen tijdens de werking van de services of bij het werken met Kafka-batches. En als er bij de eerste niet veel vragen waren, moesten we in het tweede geval alle TraceId die bij de batch kwamen in de log vastleggen en er een kiezen om de tracing voort te zetten. Dan kan de gebruiker bij het zoeken op de oorspronkelijke TraceId gemakkelijk ontdekken waar de tracing is voortgezet.
Taak 3. De noodzaak om een groot aantal gegevens op te slaan: meer dan 1 miljard labelingen per jaar alleen al voor tabak komt binnen bij X5. Hierbij is constante en snelle toegang vereist. In totaal moet het systeem ongeveer 10 miljard records verwerken met de geschiedenis van de beweging van gemarkeerde producten.
Voor het oplossen van de derde taak werd gekozen voor de NoSQL-database MongoDB. We hebben een shard gebouwd van 5 nodes en in elke node een Replica Set van 3 servers. Dit maakt het mogelijk om het systeem horizontaal te schalen door nieuwe servers toe te voegen. nieuwe servers in de cluster en de uitvalbestendigheid te waarborgen. Hier kwamen we een ander probleem tegen: het waarborgen van transactie-integriteit in de mongo-cluster met inachtneming van het gebruik van horizontaal schalende microservices. Bijvoorbeeld, een van de taken van ons systeem is het identificeren van pogingen tot het opnieuw verkopen van producten met dezelfde identificatiecodes. Hier ontstaan problemen met foutieve scans of foutieve kassatransacties. We ontdekten dat dergelijke duplicaten zowel binnen één verwerkte Kafka-batch als binnen twee parallel verwerkte batches kunnen ontstaan. Een controle op de aanwezigheid van duplicaten door middel van een databasequery leverde niets op. Voor elk van de microservices hebben we het probleem afzonderlijk aangepakt, gebaseerd op de bedrijfslogica van die service. Bijvoorbeeld, voor bonnetjes hebben we een controle binnen de batch toegevoegd en een aparte verwerking voor de detectie van duplicaten bij invoegingen.
Om te zorgen dat gebruikers met de historische gegevens geen invloed uitoefenen op het belangrijkste — de werking van onze bedrijfsprocessen, hebben we alle historische gegevens naar een aparte service met een aparte database overgebracht, die ook informatie via Kafka ontvangt. Op deze manier werken gebruikers met een geïsoleerde service, zonder invloed uit te oefenen op de services die de gegevens van huidige transacties verwerken.
Taak 4. Herverwerking van wachtrijen en monitoring:
In gedistribueerde systemen ontstaan onvermijdelijk problemen en fouten bij de beschikbaarheid van databases, wachtrijen en externe gegevensbronnen. In het geval van ‘Markus’ is de bron van dergelijke fouten de integratie met externe systemen. Het was noodzakelijk om een oplossing te vinden die het mogelijk maakt om herhaalde verzoeken te doen op foutieve antwoorden met een bepaalde tijdslimiet, zonder de verwerking van succesvolle verzoeken in de hoofdwachtrij te onderbreken. Hiervoor werd de zogenaamde 'topic based retry'-concept gekozen. Voor elk hoofdtopic wordt een of meer retry-topics aangemaakt, waarin foutieve berichten worden gestuurd, terwijl de verwerking van berichten uit het hoofdtopic niet wordt vertraagd. Het interactieschema is —
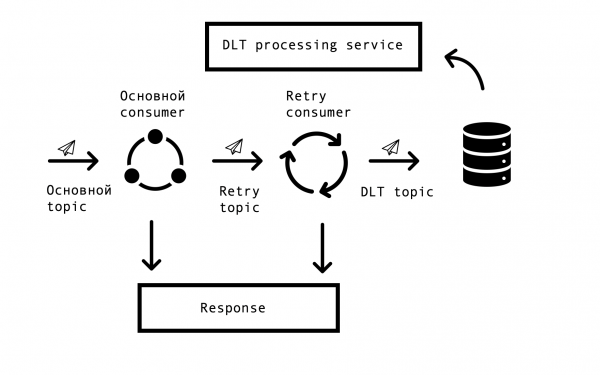
Voor de implementatie van dit schema hadden we het volgende nodig: integratie van deze oplossing met Spring en het vermijden van code duplicatie. Op het internet kwamen we een soortgelijke oplossing tegen, gebaseerd op Spring BeanPostProcessor, maar deze leek ons te omslachtig. Ons team heeft een eenvoudigere oplossing ontwikkeld die zich aansluit op de Spring-cyclus voor het creëren van consumers en waarmee we extra Retry Consumers kunnen toevoegen. De prototype van onze oplossing hebben we aan het Spring-team gepresenteerd; deze kan bekeken worden. . Het aantal Retry Consumers en het aantal pogingen van elke consumer zijn in te stellen via parameters, afhankelijk van de behoeften van het businessproces, en om alles te laten werken, hoeft men alleen de bekende annotatie voor Spring-ontwikkelaars, org.springframework.kafka.annotation.KafkaListener, toe te voegen.
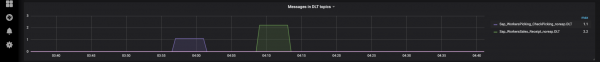
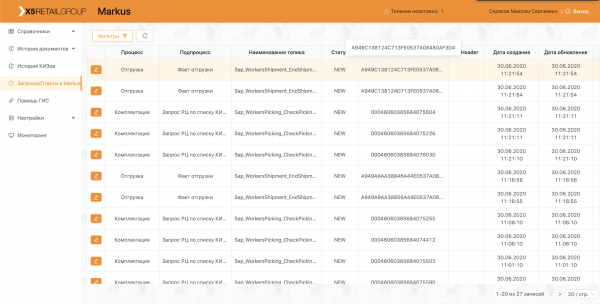
Indien een bericht niet kon worden verwerkt na alle retry-pogingen, komt het in de DLT (dead letter topic) terecht met behulp van de Spring DeadLetterPublishingRecoverer. Op verzoek van de support hebben we deze functionaliteit uitgebreid en een aparte service ontwikkeld die het mogelijk maakt om berichten die in de DLT zijn beland, stackTrace, traceId en andere nuttige informatie te bekijken. Bovendien zijn er monitoring en alerts toegevoegd voor alle DLT-topics, en momenteel is het verschijnen van een bericht in de DLT-topic in principe een aanleiding voor onderzoek en het aanmaken van een defect. Dit is zeer handig — aan de naam van het topic kunnen we onmiddellijk begrijpen op welk punt in het proces het probleem zich heeft voorgedaan, wat het opsporen van de onderliggende oorzaak aanzienlijk versnelt.
Kortgeleden hebben we een interface geïmplementeerd waarmee onze support berichten opnieuw kan verzenden na het oplossen van hun oorzaken (bijvoorbeeld het herstel van de functionaliteit van een extern systeem) en natuurlijk het aanmaken van het bijbehorende defect voor analyse. Hier kwamen onze self-topics van pas, om een lange verwerkingsketen niet opnieuw te starten, kan deze vanaf het juiste punt opnieuw worden opgestart.
Exploitatiefase van het platform
Het platform is inmiddels in productie, dagelijks voeren we leveringen en verzendingen uit, en sluiten we nieuwe distributiecentra en winkels aan. In het kader van de pilot werkt het systeem met de productgroepen ‘Tabak’ en ‘Schoenen’.
Ons hele team neemt deel aan de uitvoering van de pilots, analyseert de opkomende problemen en doet voorstellen ter verbetering van ons product, van het verbeteren van logs tot aanpassingen in processen.
Om herhaling van fouten te voorkomen, worden alle gevallen die tijdens de pilot zijn gevonden weerspiegeld in geautomatiseerde tests. De aanwezigheid van een groot aantal autotests en unit-tests maakt het mogelijk regressietests uit te voeren en hotfixes letterlijk binnen enkele uren door te voeren.
Momenteel blijven we onze platform ontwikkelen en perfectioneren, en stuiten we voortdurend op nieuwe uitdagingen. Als u geïnteresseerd bent, vertellen we in de volgende artikelen over onze oplossingen.
Bron: habr.com
