

Decryptie van het rapport van 2020 van Bruce Momjian "Unlocking the Postgres Lock Manager".
(Opmerking: Alle SQL-query's uit de dia's kunt u verkrijgen via deze link: )
Hallo! Het is geweldig om weer hier in Rusland te zijn. Het spijt me dat ik vorig jaar niet kon komen, maar Ivan en ik hebben grote plannen voor dit jaar. Ik hoop dat ik hier veel vaker kan zijn. Ik hou ervan om naar Rusland te komen. Ik zal Tyumen en Tver bezoeken. Ik ben erg blij dat ik deze steden kan bezoeken.
Mijn naam is Bruce Momjian. Ik werk bij EnterpriseDB en werk al meer dan 23 jaar met Postgres. Ik woon in Philadelphia, VS. Ik reis ongeveer 90 dagen per jaar. En ik bezoek zo'n 40 conferenties. Mijn , die de dia's bevat die ik u nu ga laten zien. Daarom kunt u ze na de conferentie van mijn persoonlijke site downloaden. Er staan ook ongeveer 30 presentaties op. Daarnaast zijn er video's en een grote hoeveelheid blogberichten, meer dan 500. Dit is een vrij waardevolle bron. En als u geïnteresseerd bent in dit materiaal, nodig ik u uit om het te gebruiken.
Ik was vroeger docent, professor voordat ik met Postgres begon te werken. En ik ben erg blij dat ik u nu kan vertellen wat ik van plan ben te vertellen. Dit is een van mijn interessantste presentaties. En deze presentatie bevat 110 dia's. We beginnen met eenvoudige dingen, en tegen het einde wordt de lezing steeds moeilijker en complexer.
Dit is een behoorlijk ongemakkelijk onderwerp. Locking is niet het meest populaire onderwerp. We willen dat dit verdwijnt. Het is net als naar de tandarts gaan.
- Locking is een probleem voor veel mensen die met databases werken en die tegelijkertijd meerdere processen hebben. Ze hebben locking nodig. Dat wil zeggen, vandaag geef ik u basiskennis over locking.
- Transactie-identificatoren. Dit is een behoorlijk saaie deel van de presentatie, maar het is belangrijk om het te begrijpen.
- Vervolgens zullen we het hebben over de soorten locking. Dit is een vrij mechanisch deel.
- En dan zullen we enkele voorbeelden van locking geven. En dit zal vrij moeilijk te begrijpen zijn.
Laten we het over locking hebben.
De terminologie bij ons is vrij complex. Hoeveel van jullie weten waar deze passage vandaan komt? Twee mensen. Het is uit een spel dat 'Colossale Avontuur in de Grot' heet. Het was een tekstgebaseerd computerspel in de jaren '80, geloof ik. Je moest een grot ingaan, in een doolhof, en de tekst veranderde, maar de inhoud was eigenlijk elke keer ongeveer hetzelfde. Zo herinner ik me dit spel.
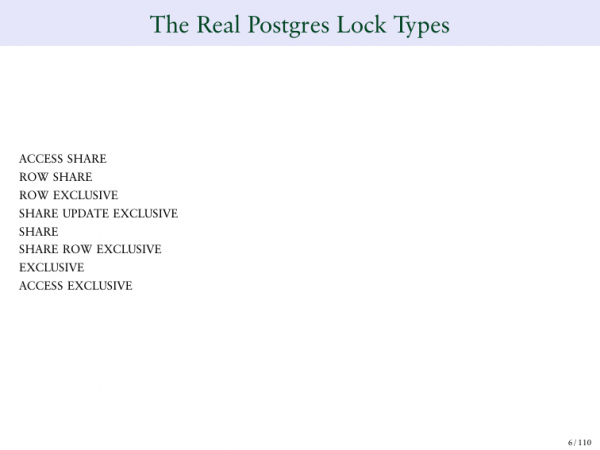
En hier zien we de namen van de lockmechanismen die van Oracle naar ons zijn gekomen. We gebruiken ze.
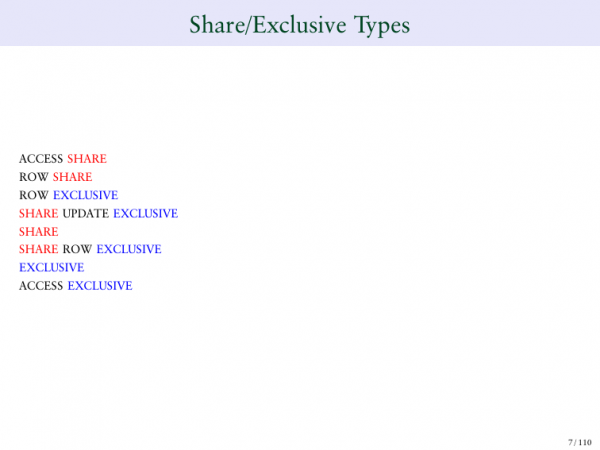
Hier zien we termen die mij in de war brengen. Bijvoorbeeld, SHARE UPDATE EXCLUSIVE. Verder SHARE RAW EXCLUSIVE. Eerlijk gezegd zijn deze namen niet erg duidelijk. We zullen ze in meer detail bekijken. Sommige bevatten het woord 'share', dat betekent – zich afscheiden. Sommige bevatten het woord 'exclusive' — exclusief. En sommige bevatten beide woorden. Ik zou willen beginnen met hoe deze locks werken.
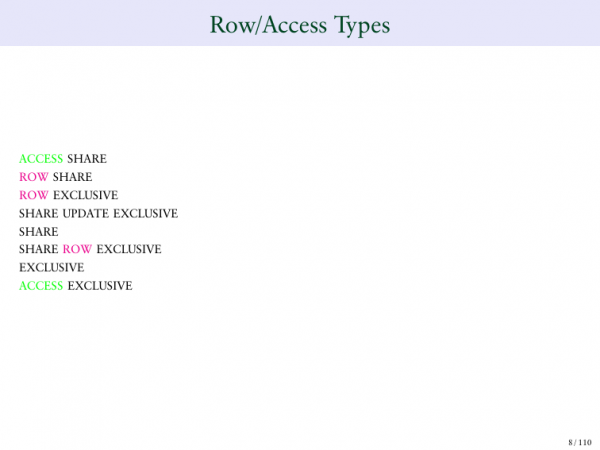
En ook heel belangrijk is het woord 'toegang' — access. En het woord 'row' — rij. Dat is, de verdeling van toegang, de verdeling van rijen.
Een ander probleem dat begrepen moet worden in Postgres, waarover ik helaas niet kan vertellen tijdens mijn presentatie, is MVCC. Ik heb daar een aparte presentatie over op mijn website. En als je denkt dat deze presentatie moeilijk is, dan is MVCC waarschijnlijk mijn meest complexe. En als je geïnteresseerd bent, kun je het op de site bekijken. Je kunt de video bekijken.
Een ander punt dat we moeten begrijpen zijn de transactiekenmerken. Veel transacties kunnen niet functioneren zonder unieke identificatoren. En hier bieden we een uitleg over wat een transactie is. In Postgres zijn er twee systemen voor het nummeren van transacties. Ik weet dat het geen erg mooie oplossing is.
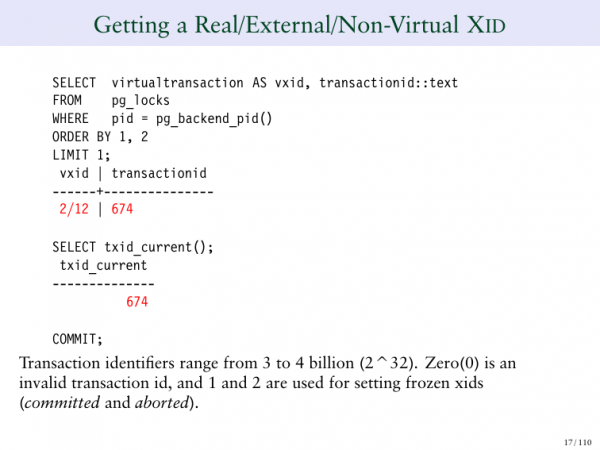
Houd er ook rekening mee dat de dia's vrij complex zullen zijn om te begrijpen, dus het is belangrijk om aandacht te besteden aan wat in het rood is gemarkeerd.
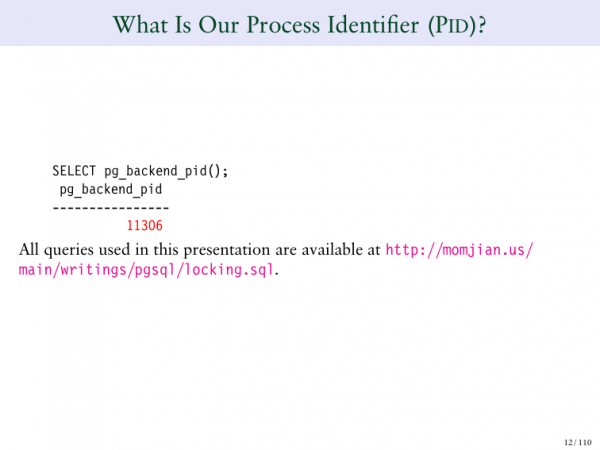
Laten we kijken. Het transactie nummer is in het rood gemarkeerd. Hier wordt de functie SELECT pg_back getoond. Het retourneert mijn transactie en de ID van deze transactie.
Nog een punt: als u deze presentatie leuk vindt en deze in uw database wilt starten, kunt u de link volgen die in het roze is gemarkeerd en de SQL voor deze presentatie downloaden. En u kunt het gewoon in uw PSQL uitvoeren en de hele presentatie verschijnt onmiddellijk op uw scherm. Het zal geen kleuren bevatten, maar minstens kunnen we het zien.
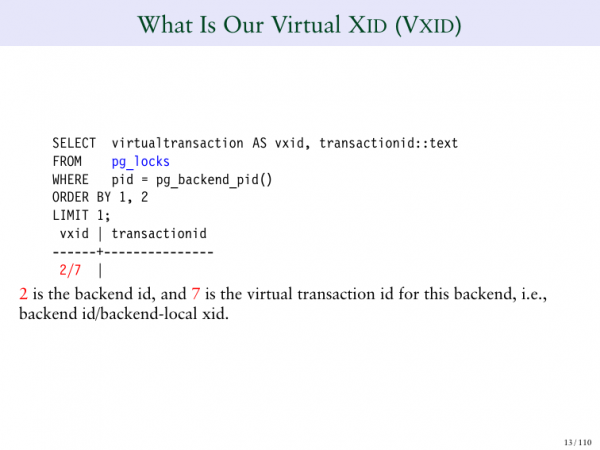
In dit geval zien we de transactie-ID. Dit is het nummer dat we eraan hebben toegekend. En er is nog een type transactie-ID in Postgres, dat de virtuele transactie-ID wordt genoemd.
En we moeten dit begrijpen. Het is heel belangrijk, anders kunnen we de blokkering in Postgres niet begrijpen.
De virtuele transactie-ID is de transactie-ID die geen vaste waarden bevat. Bijvoorbeeld, als ik de SELECT-opdracht uitvoer, zal ik waarschijnlijk de database niet veranderen, ik zal niets blokkeren. Daarom, wanneer we een eenvoudige SELECT uitvoeren, geven we deze transactie geen vaste ID. We geven hem alleen een virtuele ID.
En dit verhoogt de prestaties van Postgres, verbetert de opruimcapaciteiten, daarom bestaat de virtuele transactie-ID uit twee getallen. Het eerste getal vóór de schuine streep is de back-end-ID. Aan de rechterkant zien we gewoon een teller.
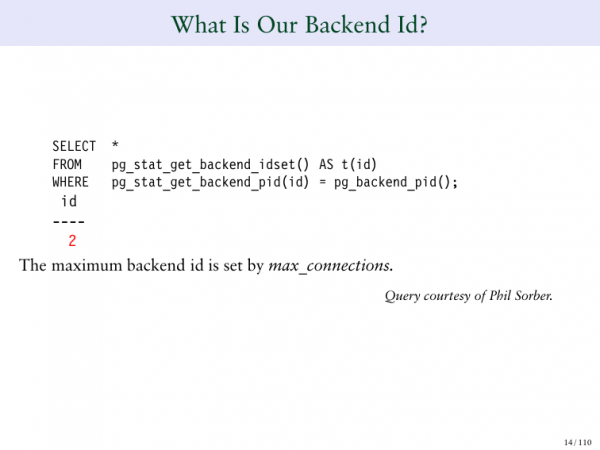
Dus als ik een query uitvoer, zegt hij dat de back-end-ID 2 is.
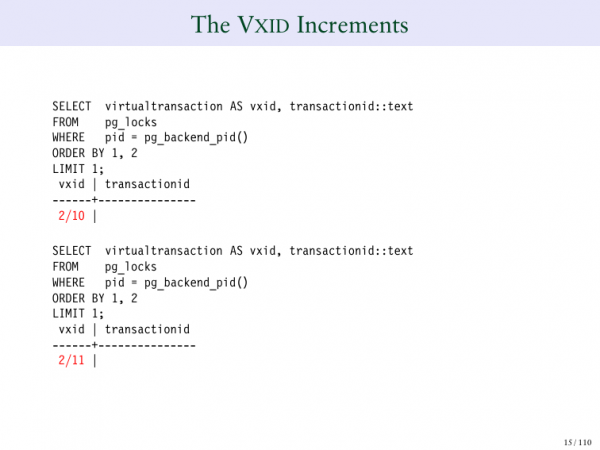
En als ik een reeks van zulke transacties uitvoer, zien we dat de teller elke keer toeneemt wanneer ik een query uitvoer. Bijvoorbeeld, wanneer ik de query 2/10, 2/11, 2/12, enzovoort uitvoer.
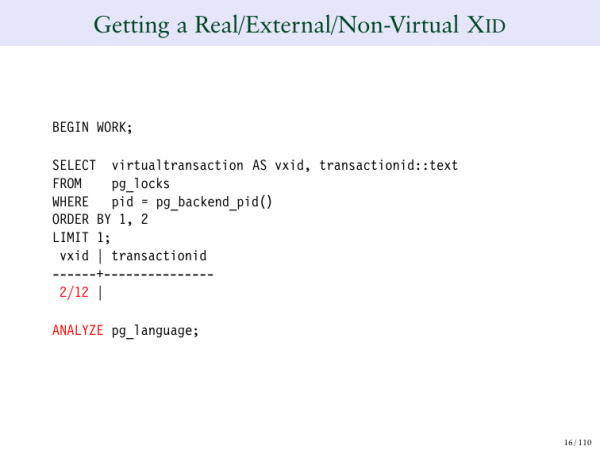
Houd er rekening mee dat hier twee kolommen zijn. Aan de linkerkant zien we de virtuele transactie-ID - 2/12. En aan de rechterkant hebben we de vaste transactie-ID. En dit veld is leeg. En deze transactie wijzigt de database niet. Daarom ken ik er geen vaste transactie-ID aan toe.
Zodra ik de opdracht analyseer (ANALYZE) uitvoer, geeft dezelfde query me een vaste transactie-ID. Kijk, hoe dit is veranderd. Eerder had ik deze ID niet, nu is hij er.
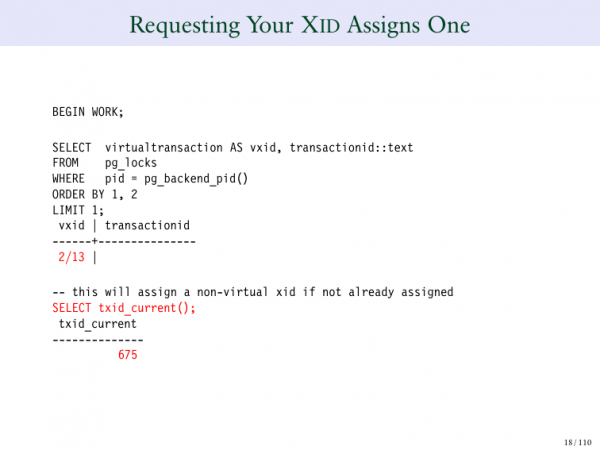
Dus hier is nog een query, nog een transactie. Het virtuele transactie-ID is 2/13. En als ik om de vaste transactie-ID vraag, krijg ik deze wanneer ik de query uitvoer.
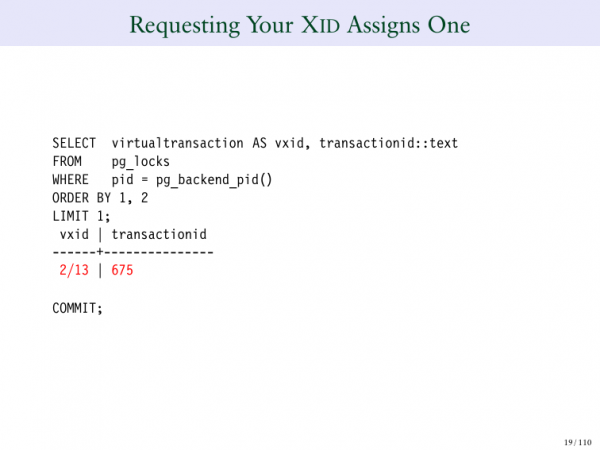
Dus nogmaals. We hebben de virtuele transactie-ID en de vaste transactie-ID. Begrijp dit punt simpelweg om het gedrag van Postgres te begrijpen.
We gaan verder met het derde gedeelte. Hier zullen we verschillende soorten locks in Postgres doornemen. Dit is niet erg interessant. Het laatste gedeelte zal veel interessanter zijn. Maar we moeten de basis dingen bekijken, anders begrijpen we niet wat er daarna gaat komen.
We zullen dit gedeelte doornemen, kijken naar elk type lock. En ik zal je voorbeelden laten zien van hoe ze worden ingesteld, hoe ze werken, en ik zal je enkele queries tonen die je kunt gebruiken om te zien hoe locking in Postgres werkt.
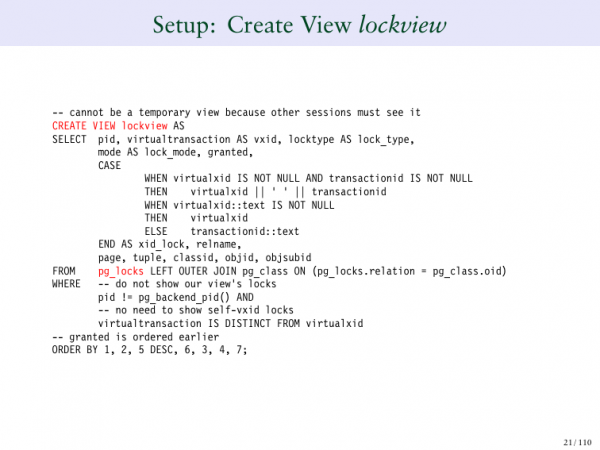
Om een query te maken en te zien wat er gebeurt in Postgres, moeten we een query uitvoeren op de system view. In dit geval is pg_lock in het rood gemarkeerd. Pg_lock is een system tabel die ons vertelt welke locks momenteel in Postgres worden gebruikt.
Toch is het erg moeilijk voor mij om je pg_lock zelf te tonen, omdat het nogal complex is. Daarom heb ik een view gemaakt die pg_locks toont. En het doet ook een beetje werk voor mij, waardoor ik het beter kan begrijpen. Dat wil zeggen, het sluit mijn locks, mijn eigen sessie, enz. uit. Het is gewoon standaard SQL en het stelt me in staat om je beter te laten zien wat er gebeurt.
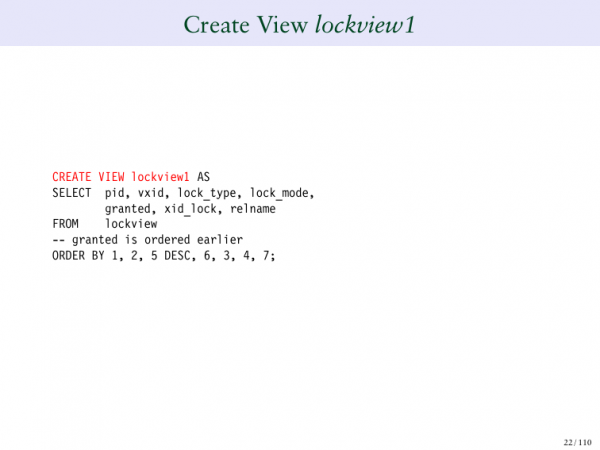
Een ander probleem is dat deze view erg breed is, dus moet ik een tweede maken – lockview2.
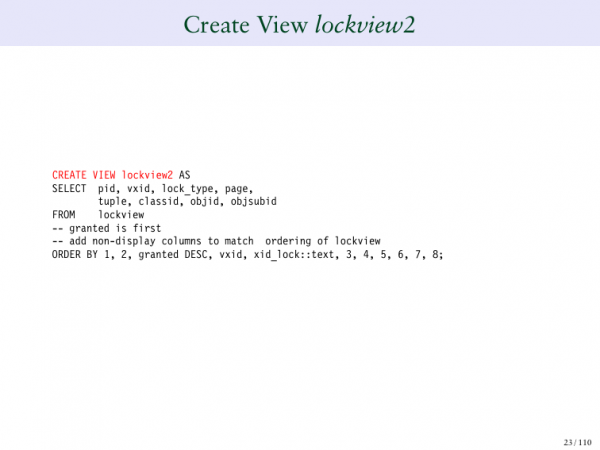 En het toont me nog enkele kolommen van de tabel. En nog een, die me de overige kolommen toont. Dit is vrij complex, dus ik heb geprobeerd het zo eenvoudig mogelijk te presenteren.
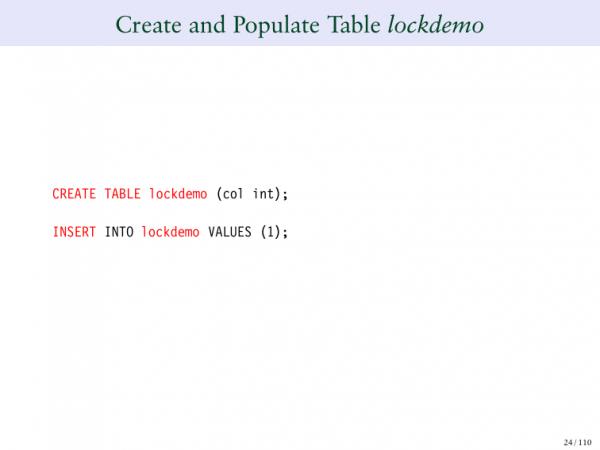
Dus, we hebben een tabel gemaakt die Lockdemo heet. En we hebben daar één rij gemaakt. Dit is onze voorbeeldtabel. En we zullen secties maken om je gewoon voorbeelden van locks te tonen.
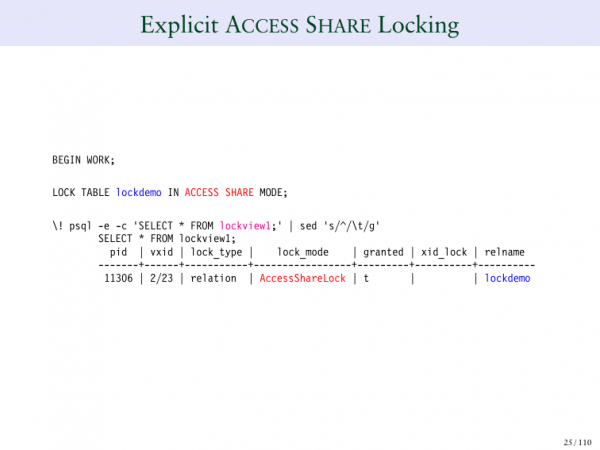
Dus, één rij, één kolom. Het eerste type lock heet ACCESS SHARE. Dit is de minst beperkende lock. Dit betekent dat het vrijwel niet in conflict komt met andere locks.
Als we expliciet een blokkade willen definiëren, voeren we de opdracht «lock table» uit. Dit blokkeert expliciet, dat wil zeggen in de ACCESS SHARE modus voeren we lock table uit. En als ik PSQL op de achtergrond draai, start ik op deze manier een tweede sessie vanuit mijn eerste sessie. Wat doe ik hier? Ik ga naar de andere sessie en zeg haar: «toon me lockview voor deze aanvraag». En hier heb ik AccessShareLock in deze tabel. Dit is precies wat ik heb aangevraagd. En hij zegt dat de blokkade is toegewezen. Heel eenvoudig.
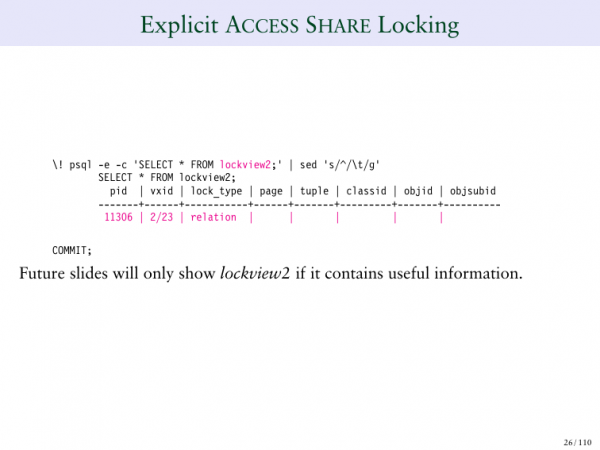
Verder, als we naar de tweede kolom kijken, zien we dat deze leeg is. Ze zijn leeg.
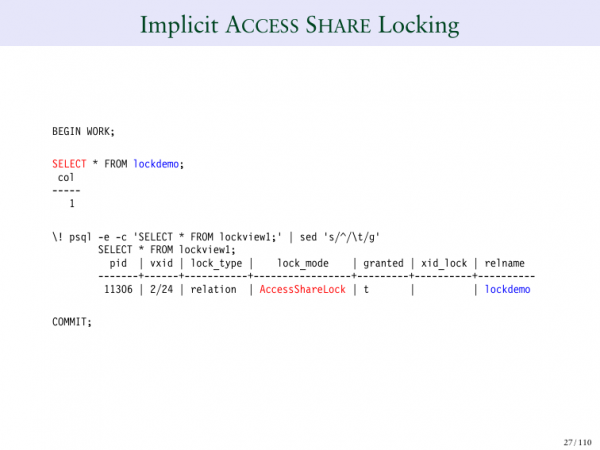
En als ik de opdracht «SELECT» uitvoer, is dat een impliciete (expliciete) manier om een AccessShareLock aan te vragen. Daarom laat ik mijn tabel los en voer ik de aanvraag uit, en de aanvraag retourneert een paar rijen. En in een van de rijen zien we AccessShareLock. Dus SELECT roept AccessShareLock aan in de tabel. En het conflicteert praktisch met niets, omdat het een laagniveau blokkade is.
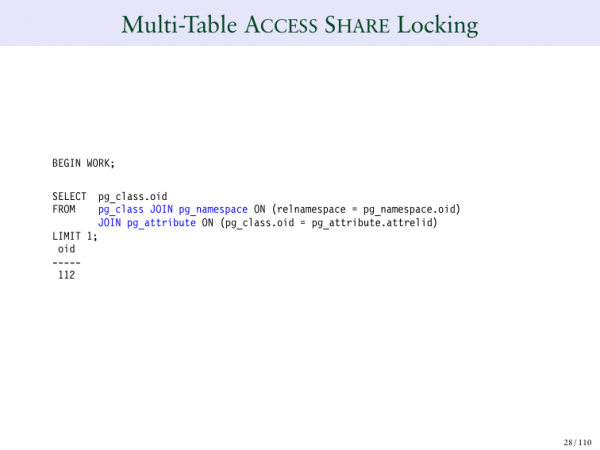
Wat als ik SELECT uitvoer en ik heb drie verschillende tabellen? Eerder voerde ik slechts één tabel uit, nu voer ik er drie uit: pg_class, pg_namespace en pg_attribute.
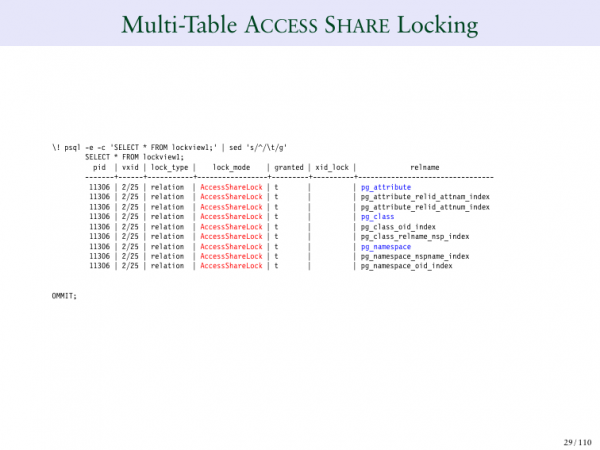
En nu, wanneer ik naar de aanvraag kijk, zie ik 9 AccessShareLocks in de drie tabellen. Waarom? De drie tabellen zijn blauw gemarkeerd: pg_attribute, pg_class, pg_namespace. Maar je kunt ook zien dat alle indexen die door deze tabellen zijn gedefinieerd ook een AccessShareLock hebben.
En dit is een blokkade die praktisch niet met andere conflicteert. En het enige wat het doet, is ons gewoon verhinderen de tabel opnieuw in te stellen terwijl we deze selecteren. Dit is logisch. Dat wil zeggen, als we een tabel selecteren en deze in dat moment verdwijnt, is dat verkeerd, daarom AccessShare is een laagniveau blokkade die ons zegt: "verwijder deze tabel niet terwijl ik aan het werk ben".. In wezen is dit alles wat het doet.
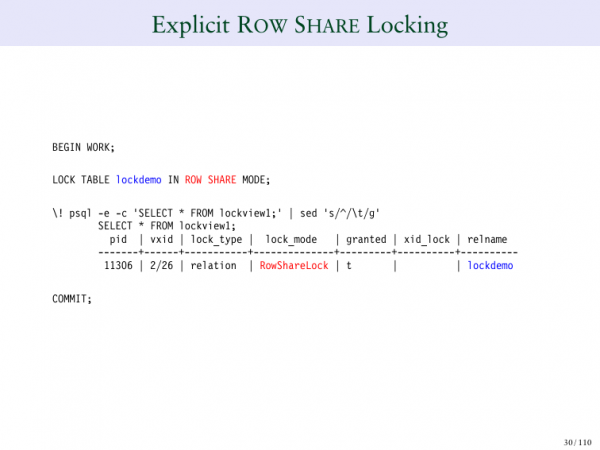
ROW SHARE is een blokkade die iets anders is.
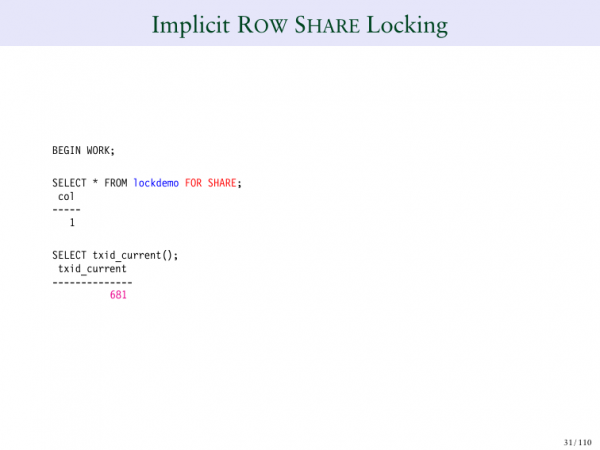
Laten we een voorbeeld nemen. SELECT ROW SHARE is een manier om elke rij afzonderlijk te blokkeren.. Hierdoor kan niemand ze verwijderen of wijzigen terwijl we ze aan het bekijken zijn.
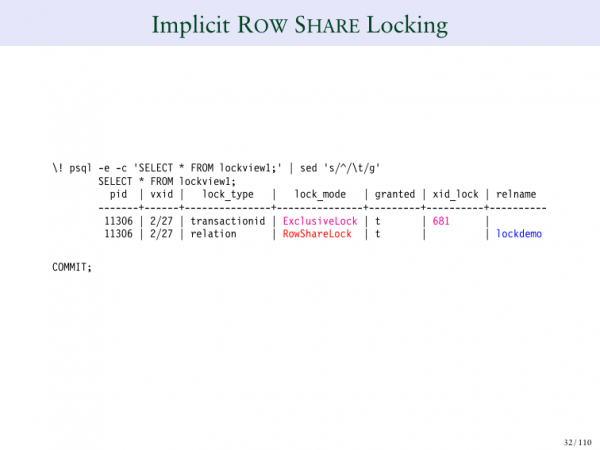 Dus, wat doet SHARE LOCK? We zien dat de transactie-ID 681 is voor de SELECT. En dat is interessant. Wat hebben we hier? Voor de eerste keer zien we een nummer in het veld 'Lock'. We nemen de transactie-ID en deze geeft aan dat hij deze in exclusieve modus blokkeert. Alles wat hij doet, is zeggen dat ik een rij heb die technisch gezien ergens in de tabel is geblokkeerd. Maar hij zegt niet waar precies. Later zullen we hier dieper op ingaan.
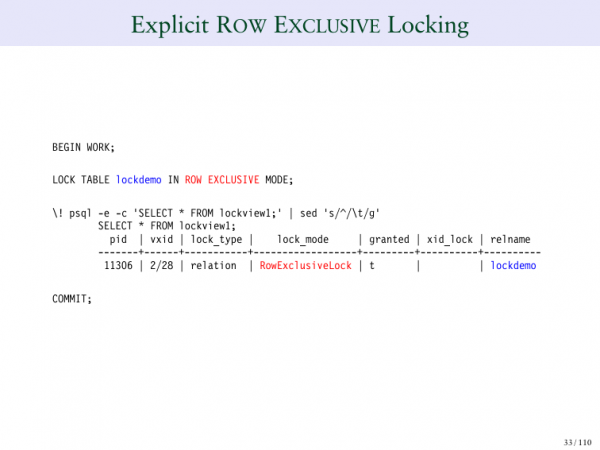
Hier zeggen we dat de lock door ons wordt gebruikt.
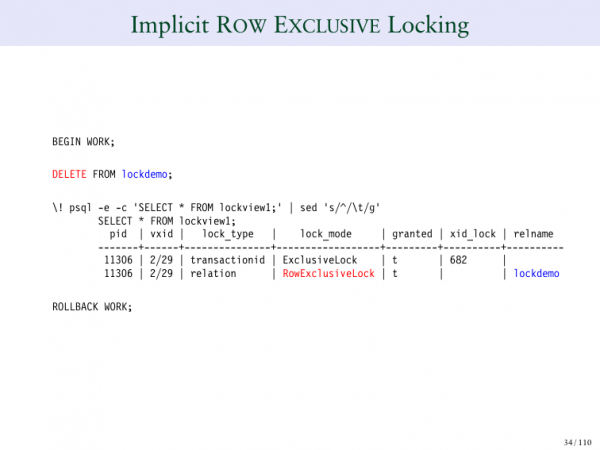
Dus, exclusieve lock geeft expliciet aan dat het exclusief is. En ook als je een rij in deze tabel verwijdert, dan zal dat gebeuren, zoals je kunt zien.
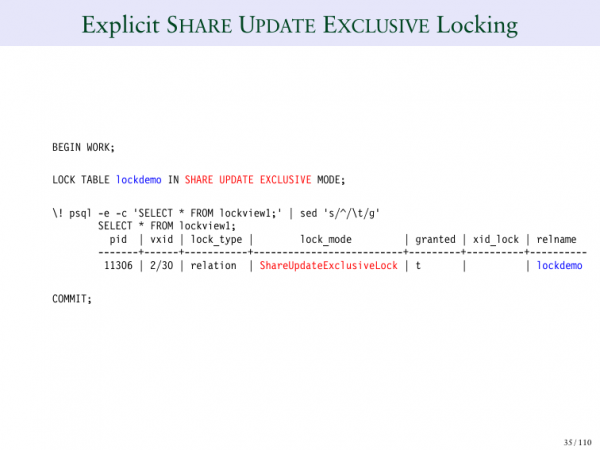
SHARE EXCLUSIVE – dit is een langere lock.
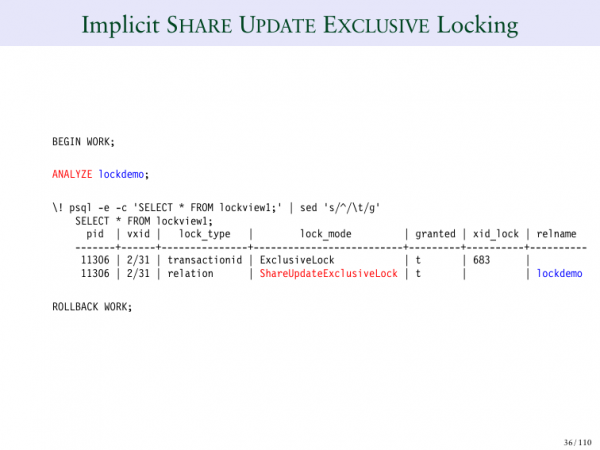
Dit is de (ANALYZE) analyzer command die zal worden gebruikt.
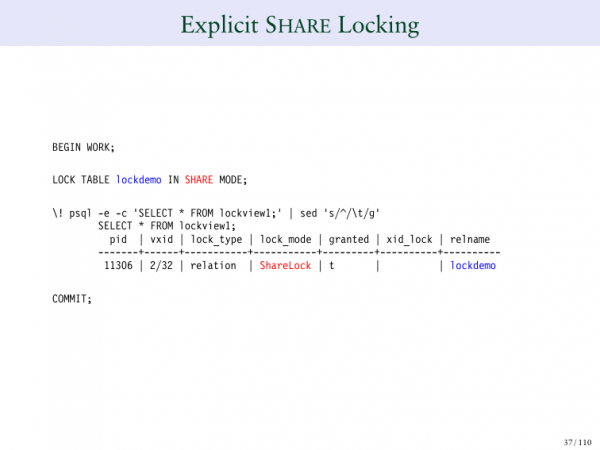
SHARE LOCK – je kunt expliciet vergrendelen in share modus.
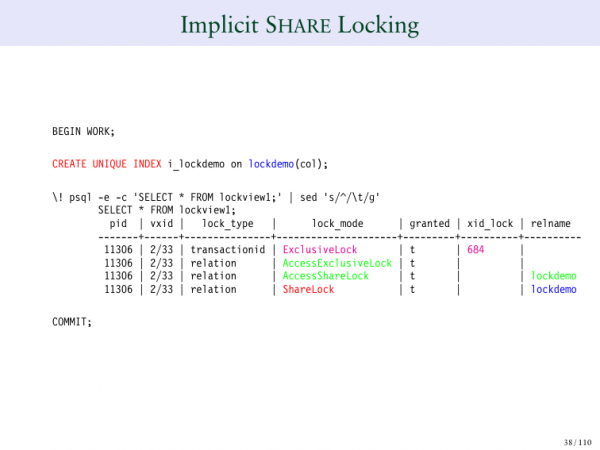
Je kunt ook een unieke index aanmaken. En daar kun je SHARE LOCK zien, dat een deel ervan is. En het blokkeert de tabel en stelt erop SHARE LOCK in.
Standaard betekent SHARE LOCK op de tabel dat andere mensen de tabel kunnen lezen, maar niemand kan deze wijzigen. En dat is wat er gebeurt wanneer je een unieke index aanmaakt.
Als ik een unique concurrently index aanmaak, dan heb ik een ander type lock, want zoals je je herinnert, verlaagt het gebruik van concurrently indices de lock vereisten. En als ik een normale lock, een normale index gebruik, dan zal ik op deze manier het schrijven naar de index tabel tijdens het aanmaken daarvan voorkomen. Als ik gebruik maak van een concurrently index, dan moet ik een ander type lock gebruiken.
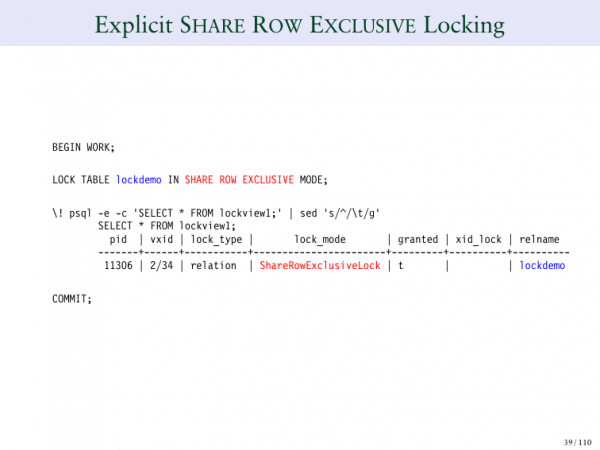
SHARE ROW EXCLUSIVE – deze kan weer expliciet worden ingesteld.
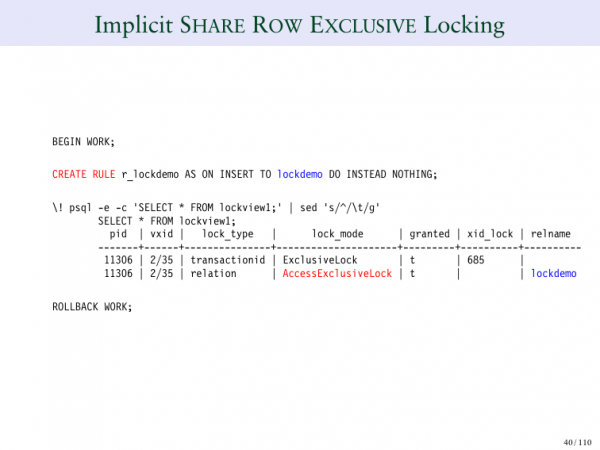
Of we kunnen een regel maken, dat wil zeggen een specifieke situatie nemen waarin deze zal worden gebruikt.
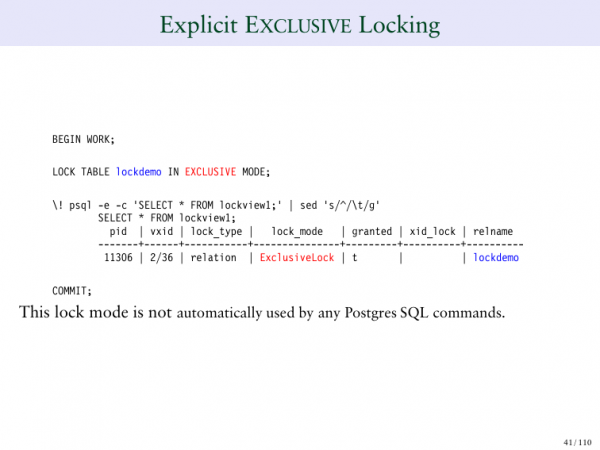
EXCLUSIVE lock betekent dat niemand anders de tabel kan wijzigen.
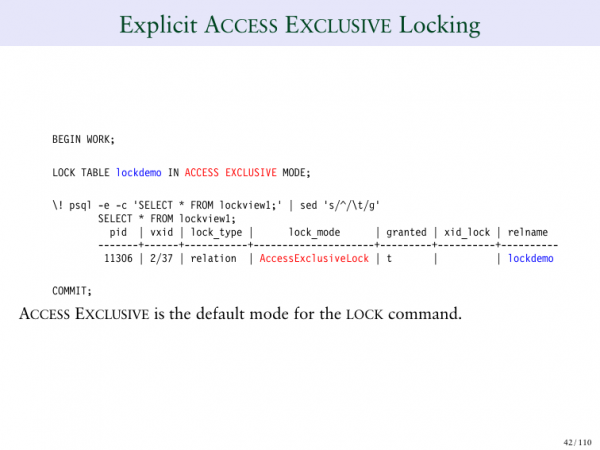
Hier zien we verschillende types locks.
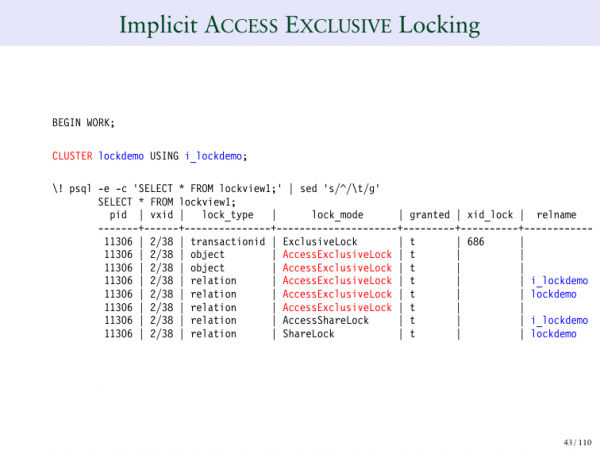
ACCESS EXCLUSIVE, bijvoorbeeld, dat is het lock commando. Bijvoorbeeld als je doet CLUSTER table, dan betekent dat dat niemand daar kan schrijven. En het blokkeert niet alleen de tabel zelf, maar ook de indices.
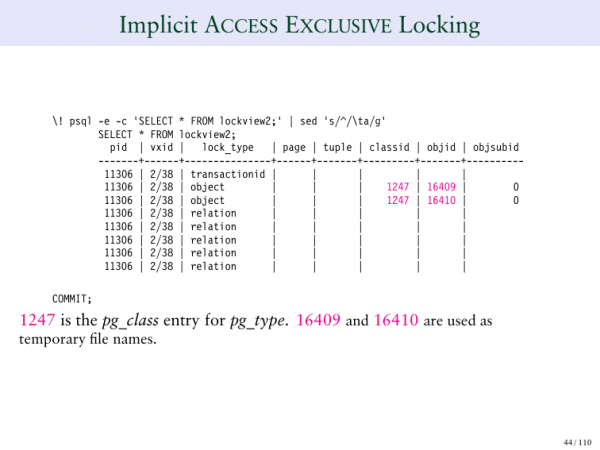
Dit is de tweede pagina van de ACCESS EXCLUSIVE lock, waar we specifiek zien wat het in de tabel blokkeert. Het blokkeert afzonderlijke rijen in de tabel, wat vrij interessant is.
Dit is alle basisinformatie die ik wilde geven. We hebben het gehad over blokkades, over transactie-ID's, we spraken over virtuele transactie-ID's, over permanente transactie-ID's.
En nu gaan we voorbeelden van blokkades doornemen. Dit is het meest interessante deel. We zullen zeer interessante gevallen bekijken. Mijn doel in deze presentatie is om u een beter begrip te geven van wat Postgres werkelijk doet wanneer het probeert bepaalde zaken te blokkeren. Ik denk dat het heel goed is in het blokkeren van specifieke onderdelen.
Laten we specifieke voorbeelden bekijken.
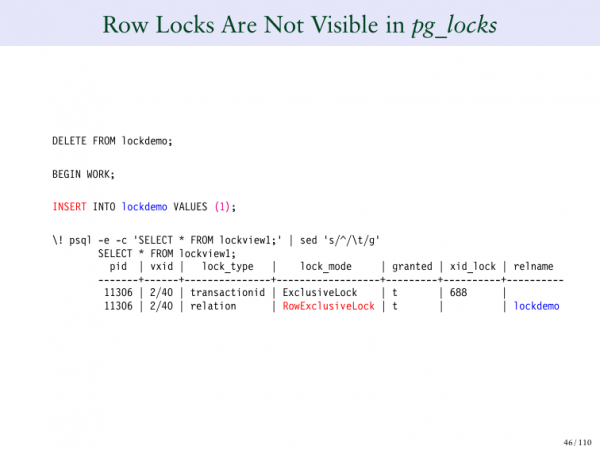
We beginnen met tabellen en met één rij in een tabel. Wanneer ik iets invoeg, zie ik een ExclusiveLock, een transactie-ID en een ExclusiveLock op de tabel.
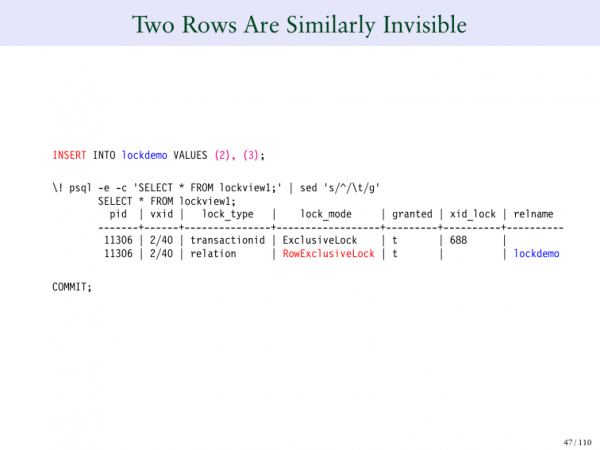
Maar wat als ik nog twee rijen invoeg? En nu hebben we drie rijen in onze tabel. Ik heb één rij ingevoegd en kreeg dit als output. En als ik nog twee rijen invoeg, wat is hier vreemd aan? Er is iets vreemds aan de hand, want ik heb drie rijen aan deze tabel toegevoegd, maar ik heb nog steeds twee rijen in de blokkadetabel. En dit is in wezen het fundamentele gedrag van Postgres.
Veel mensen denken dat als je 100 rijen in de database blokkeert, je 100 invoeren voor blokkades moet creëren. Als ik tegelijkertijd 1.000 rijen blokkeer, dan heb ik 1.000 van zulke verzoeken nodig. En als ik miljoenen of miljarden moet blokkeren. Maar als we het zo gaan doen, zal dat niet goed werken. Als je een systeem zou gebruiken dat invoeren voor blokkades maakt voor elke afzonderlijke rij, dan zie je dat dit ingewikkeld is. Omdat je moet bepalen dat de blokkadetabel op een gegeven moment vol kan raken, maar Postgres doet dat niet.
En op deze dia is het belangrijk dat hier duidelijk wordt aangetoond dat er nog een systeem is dat binnen MVCC werkt, dat afzonderlijke rijen blokkeert. Dus, wanneer je miljarden rijen blokkeert, dan maakt Postgres niet miljard afzonderlijke opdrachten voor blokkades aan. En dit is zeer gunstig voor de prestaties.
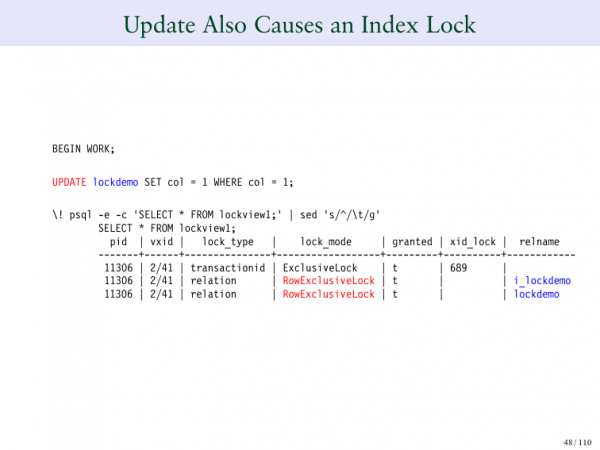
Wat betreft de update? Ik ben momenteel bezig met het bijwerken van een rij, en je kunt merken dat het meteen twee verschillende bewerkingen heeft uitgevoerd. Het heeft tegelijkertijd de tabel vergrendeld, maar ook de index. En het moest de index vergrendelen omdat er unieke beperkingen op deze tabel zijn. En we willen ervoor zorgen dat niemand het wijzigt, dus vergrendelen we het.
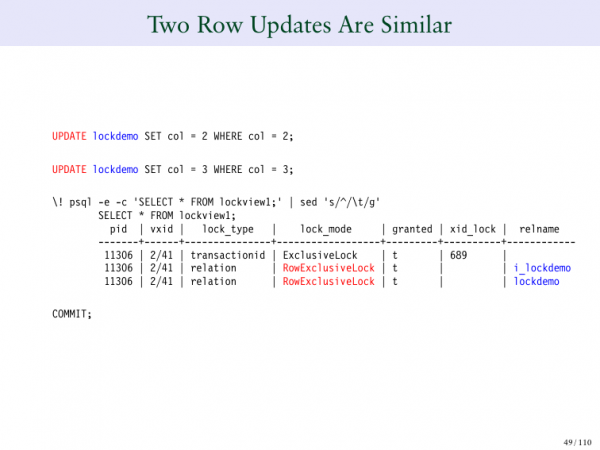
En wat gebeurt er als ik twee rijen wil bijwerken? En we zien dat het zich op dezelfde manier gedraagt. We voeren twee keer zoveel updates uit, maar hetzelfde aantal rijen is vergrendeld.
Als je benieuwd bent hoe Postgres dit doet, moet je luisteren naar mijn presentaties over MVCC, om te leren hoe Postgres intern de rijen markeert die het wijzigt. Postgres heeft een manier om dit te doen, maar het gebeurt niet op het niveau van tabelvergrendeling; het gebeurt op een lager en efficiënter niveau.
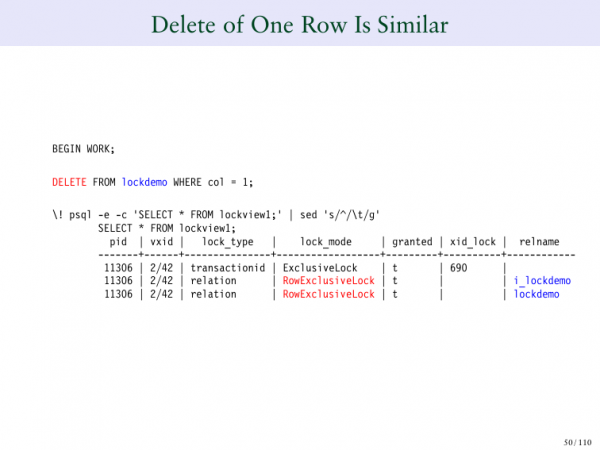
En als ik iets wil verwijderen? Als ik bijvoorbeeld één rij verwijder en ik heb nog steeds mijn twee invoer voor vergrendeling, dan blijven ze daar ook aanwezig, zelfs als ik ze allemaal wil verwijderen.
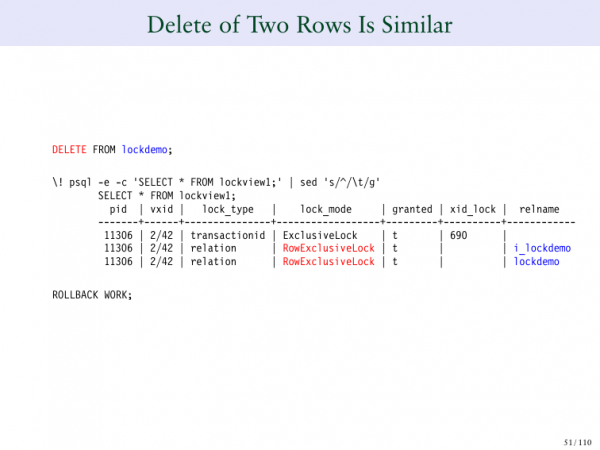
Als ik bijvoorbeeld 1000 rijen wil invoegen en vervolgens of verwijderen of nog eens 1000 rijen wil invoegen, dan worden de individuele rijen die ik toevoeg of wijzig niet hier geregistreerd. Ze worden geregistreerd op een lager niveau binnen de rij zelf. En tijdens de presentatie over MVCC heb ik dit in detail besproken. Maar het is erg belangrijk, wanneer je vergrendelingen analyseert, om ervoor te zorgen dat je een vergrendeling op tabelniveau hebt en dat je hier niet ziet hoe individuele rijen worden geregistreerd.
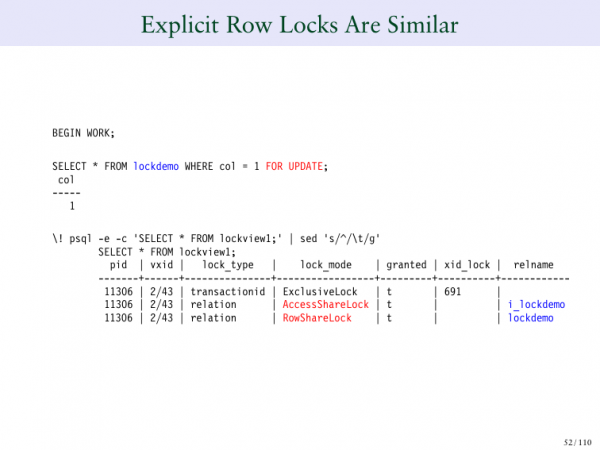
En hoe zit het met expliciete vergrendeling?
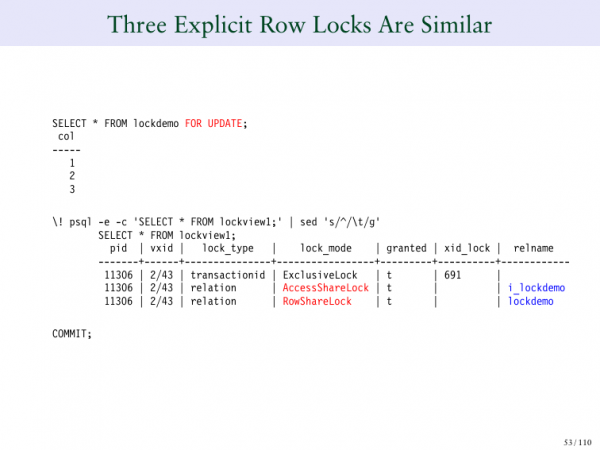
Als ik op 'bijwerken' druk, heb ik twee vergrendelde rijen. En als ik ze allemaal selecteer en op 'overal bijwerken' klik, blijven er nog steeds twee vergrendelingsrecords over.
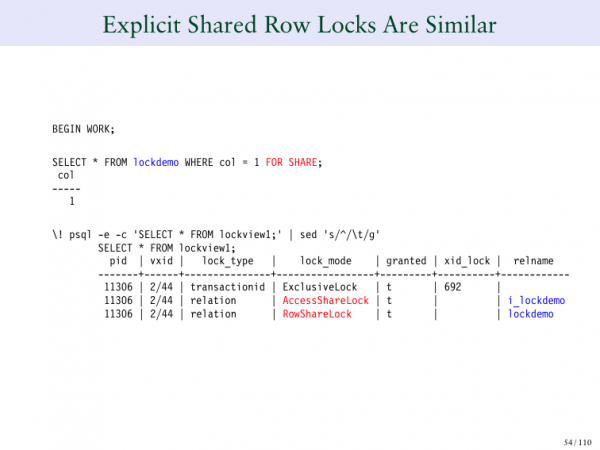
We maken geen aparte records voor elke individuele rij. Want dan zou de prestatie afnemen, er kan te veel van zijn. En we kunnen in een vervelende situatie terechtkomen.
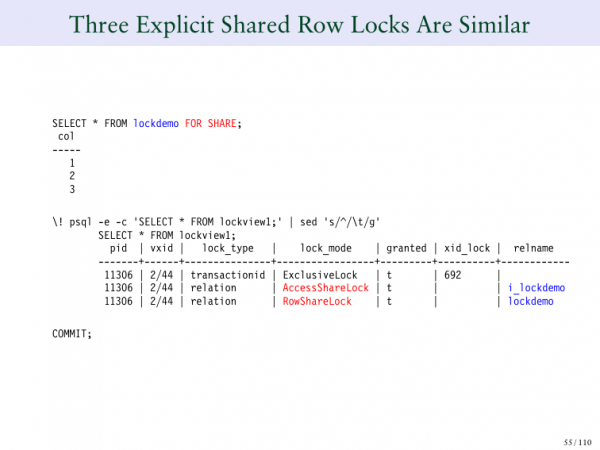
En hetzelfde geldt als we shared doen, we kunnen dat voor alle 30 keer doen.
We herstellen onze tabel, verwijderen alles, en voegen daarna weer één rij toe.
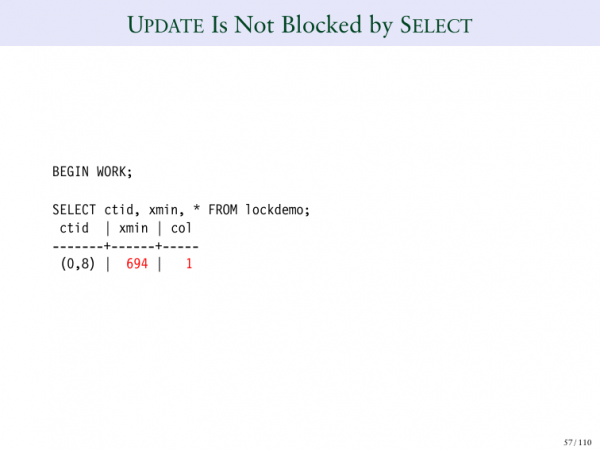
Een ander soort gedrag dat je in Postgres ziet, is het zeer bekende en gewenste gedrag - je kunt zowel een update als een select uitvoeren. En je kunt dit tegelijkertijd doen. En selecties blokkeren de updates niet en vice versa. We zeggen tegen de lezer om de schrijver niet te blokkeren, en de schrijver blokkeert de lezer niet.
Ik zal je hier een voorbeeld van geven. Ik ga nu een selectie maken. We zullen daarna een INSERT doen. En je zult dan kunnen zien - 694. Je kunt het ID zien van de transactie die deze invoeging heeft uitgevoerd. En zo werkt het.
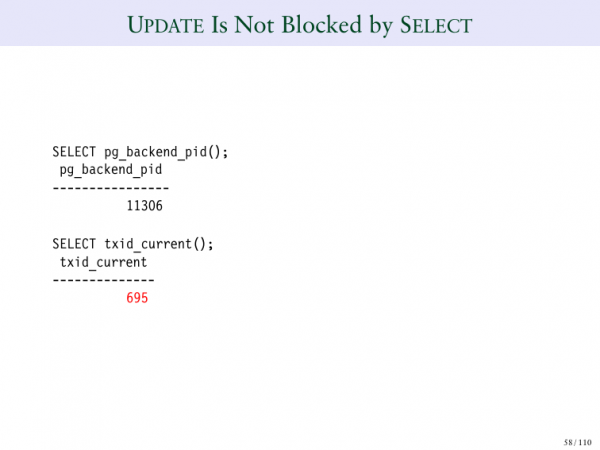
En als ik nu kijk naar mijn backend ID, dan is het nu - 695.
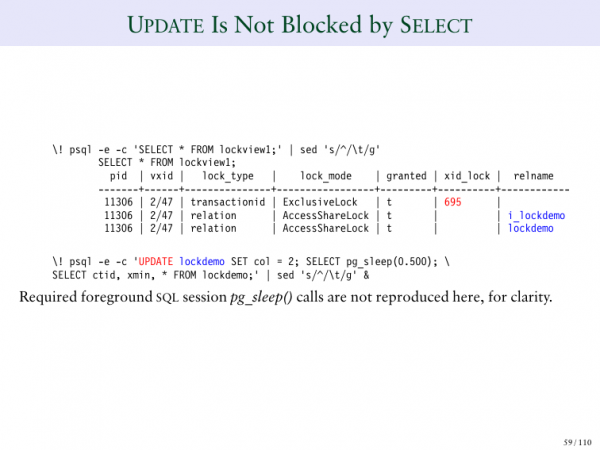
En ik kan zien dat 695 verschijnt in mijn tabel.
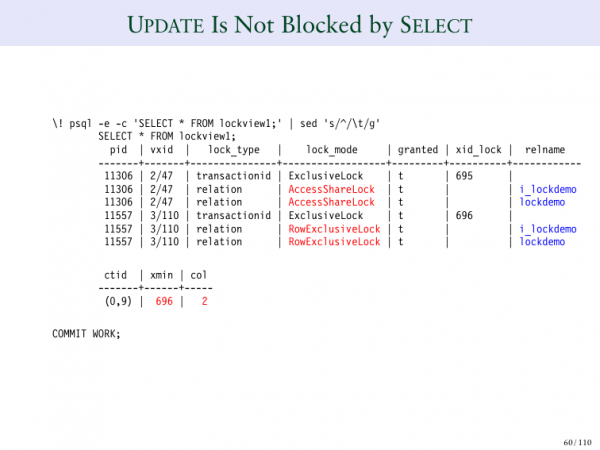
En als ik hier een update uitvoer zoals dit, krijg ik een ander geval. In dit geval is 695 een exclusieve blokkering, en updates hebben hetzelfde gedrag, maar er ontstaat geen conflict tussen hen, wat vrij ongebruikelijk is.
En je kunt opmerken dat bovenaan - dit is een ShareLock, en hieronder - dit is een ExclusiveLock. En beide transacties zijn succesvol.
En je moet mijn presentatie over MVCC horen om te begrijpen hoe dit gebeurt. Maar dit is een illustratie dat je dit tegelijkertijd kunt doen, dat wil zeggen, tegelijkertijd SELECT en UPDATE uitvoeren.
Laten we resetten en nog een keer een bewerking uitvoeren.
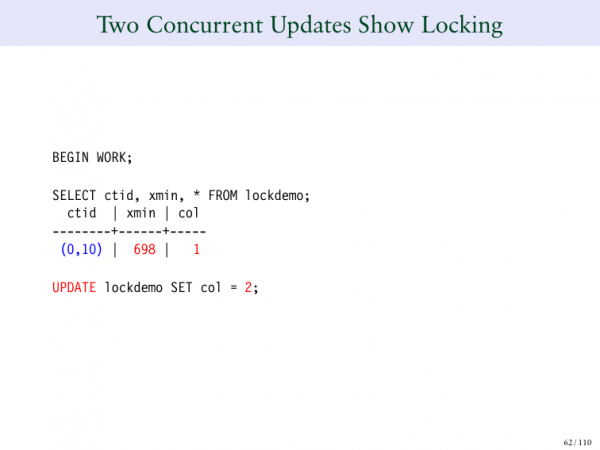
Als je probeert om tegelijkertijd twee updates op dezelfde rij uit te voeren, zal dit worden geblokkeerd. En herinner je, ik zei dat de lezer de schrijver niet blokkeert, en de schrijver de lezer niet blokkeert, maar een schrijver blokkeert de andere schrijver. Dat wil zeggen, we kunnen niet toestaan dat twee mensen tegelijkertijd dezelfde rij bijwerken. Ze moeten wachten totdat één van hen klaar is.
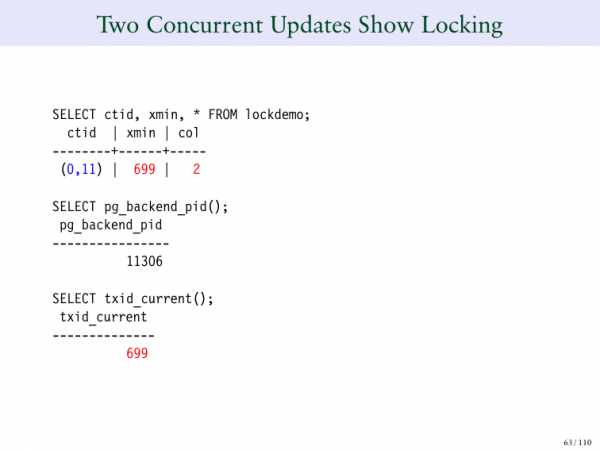
En om dit te illustreren zal ik naar de Lockdemo-tabel kijken. En we zullen naar één rij kijken. Naar transactie 698.
We hebben dit bijgewerkt naar 2. 699 - dit is de eerste update. En het is succesvol of het bevindt zich in een wachtende transactie en wacht tot we bevestigen of annuleren.
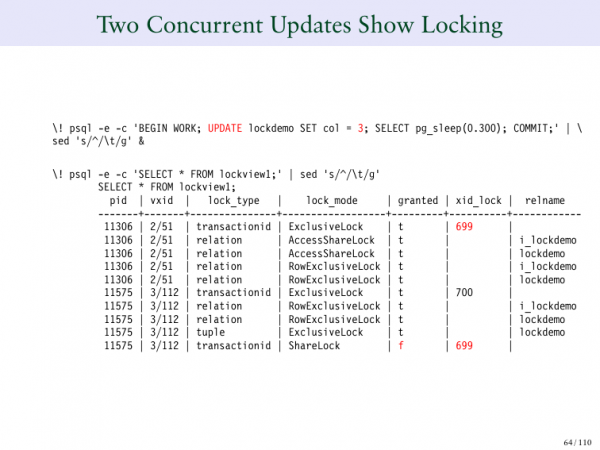
Maar kijk eens naar iets anders – 2/51 – dit is onze eerste transactie, onze eerste sessie. 3/112 – dit is de tweede aanvraag die bovenaan verscheen en die deze waarde veranderde naar 3. En als je goed kijkt, zie je dat de bovenste zichzelf blokkeerde, namelijk 699. Maar 3/112 heeft geen blokkering verleend. In de kolom Lock_mode staat dat hij aan het wachten is. Hij wacht op 699. En als je kijkt waar 699 is, staat hij hoger. En wat deed de eerste sessie? Hij creëerde een exclusieve blokkering op zijn eigen transactie-ID. Dit is hoe Postgres dit doet. Het blokkeert zijn eigen transactie-ID. En als je wilt wachten tot iemand bevestigt of annuleert, moet je wachten op de actieve transactie. Daarom kunnen we deze vreemde regel zien.
Laten we nog eens kijken. Links zien we ons proces-ID. In de tweede kolom zien we onze virtuele transactie-ID, en in de derde de lock_type. Wat betekent dit? In wezen zegt het dat het de transactie-ID blokkeert. Maar let op, in alle rijen onderaan staat relation. En daarom heb je twee soorten blokkeringen in de tabel. Er is een relation-blokkering. En er is ook een transactionid-blokkering, waarbij je jezelf blokkeert, dat is precies wat er gebeurt in de eerste rij of helemaal beneden, waar de transactionid is, waar we wachten tot 699 zijn operatie heeft voltooid.
Ik kijk naar wat hier gebeurt. En hier vinden tegelijkertijd twee dingen plaats. Je kijkt naar de blokkering op de transactie-ID in de eerste rij, die zichzelf blokkeert. En het blokkeert zichzelf om mensen te dwingen te wachten.
Als je kijkt naar de 6e regel, zie je dat dezelfde opname als de eerste is. En daarom wordt transactie 699 geblokkeerd. 700 blokkeert ook zichzelf. En dan zie je in de onderste rij dat we wachten tot 699 zijn operatie heeft voltooid.
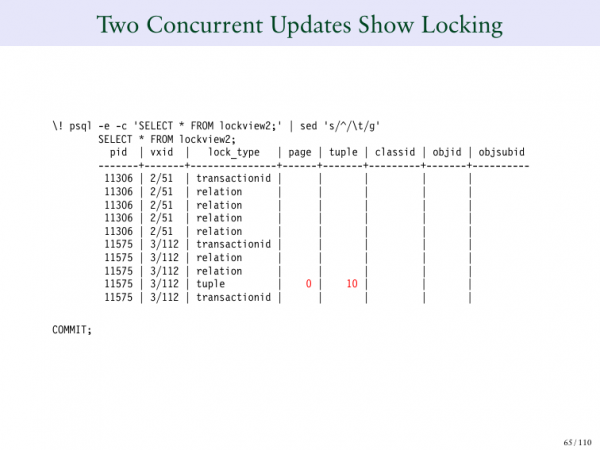
En in lock_type, tuple zie je de nummers.
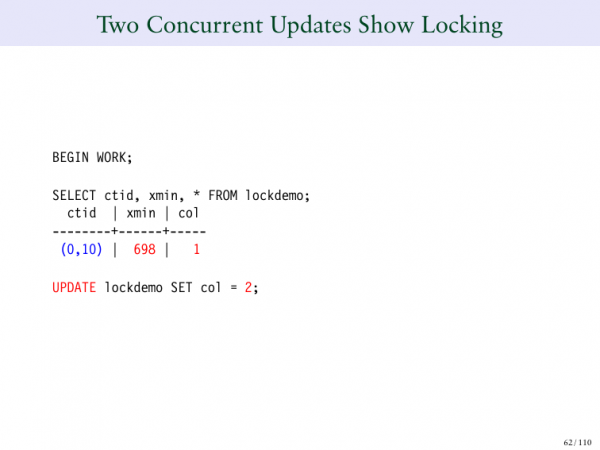
Je kunt zien dat dit 0/10 is. En dit is het paginanummer, en ook de offset van deze specifieke rij.
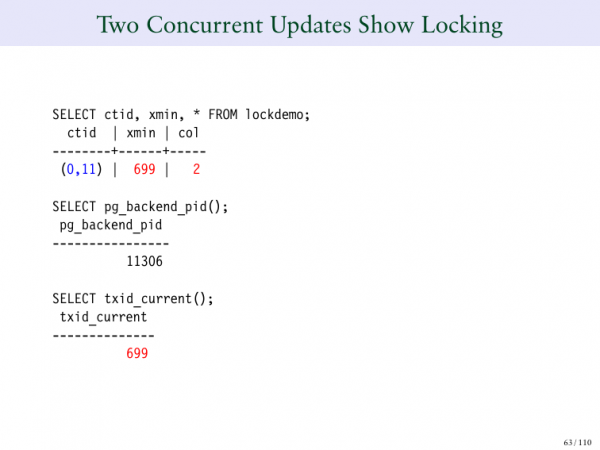
En je ziet dat het 0/11 wordt wanneer we bijwerken.
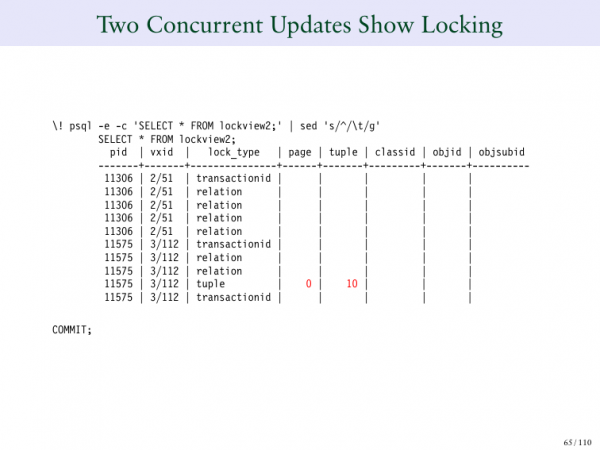
Maar in feite is het 0/10, omdat we wachten op deze operatie. We hebben de mogelijkheid om te zien dat dit de rij is waar ik op wacht om te bevestigen.
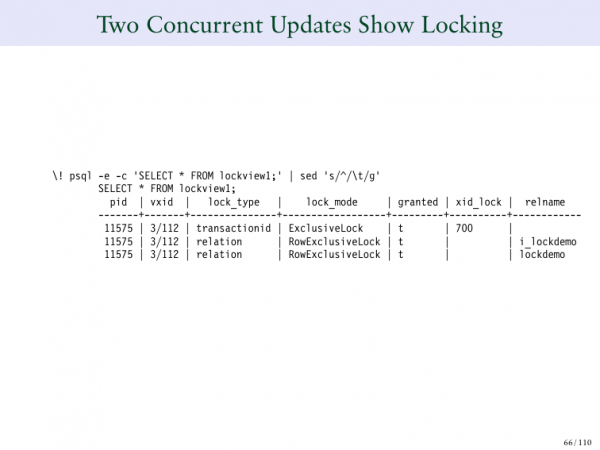
Zodra we het hebben bevestigd en op commit hebben gedrukt, en wanneer de update is voltooid, is dit wat we opnieuw krijgen. Transactie 700 is de enige blokkering, deze wacht niet meer op iemand anders omdat deze gecommit is. Het wacht gewoon tot de transactie is voltooid. Zodra 699 is afgelopen, wachten we op niets meer. En nu zegt transactie 700 dat alles goed is, dat alle blokkeringen die nodig zijn, in alle toegestane tabellen zijn.
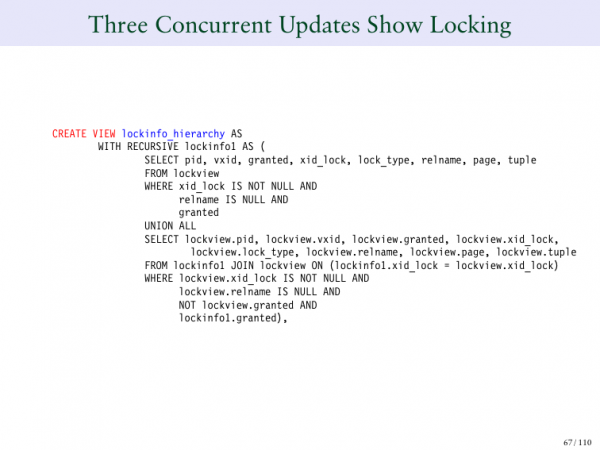
En om dit allemaal nog ingewikkelder te maken, creëren we een andere view, die ons deze keer een hiërarchie zal geven. Ik verwacht niet dat je deze query zult begrijpen. Maar het zal ons een duidelijker beeld geven van wat er aan de hand is.
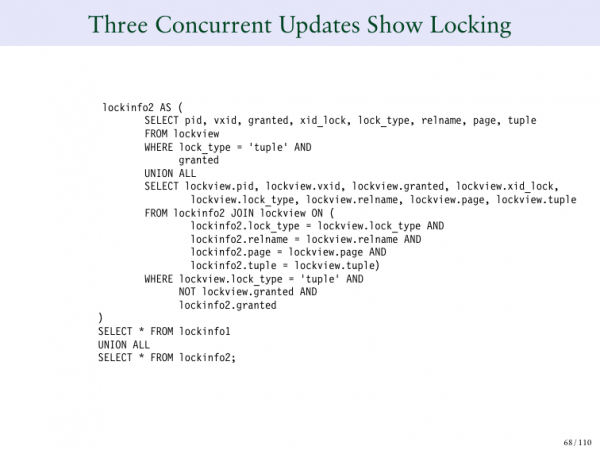
Dit is een recursieve view, die ook nog een andere sectie heeft. En dan voegt het alles weer samen. Laten we dit gebruiken.
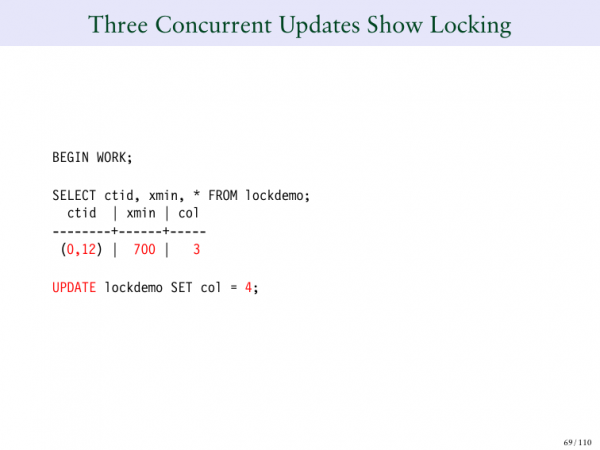
Wat als we drie gelijktijdige updates doen en zeggen dat de rij nu drie is. En we veranderen 3 in 4.
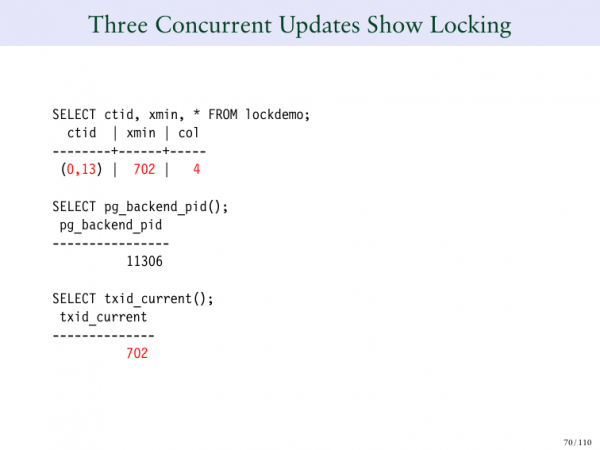
En hier zien we 4. En de transactietekening ID 702.
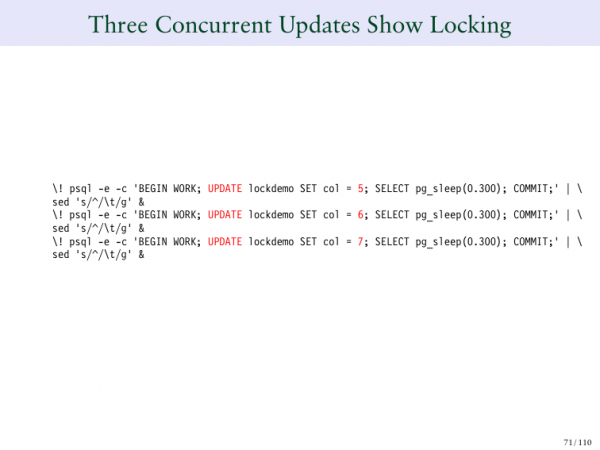
En dan verander ik 4 in 5. En 5 in 6, en 6 in 7. En ik stel een rij mensen op die zullen wachten totdat deze ene transactie is voltooid.
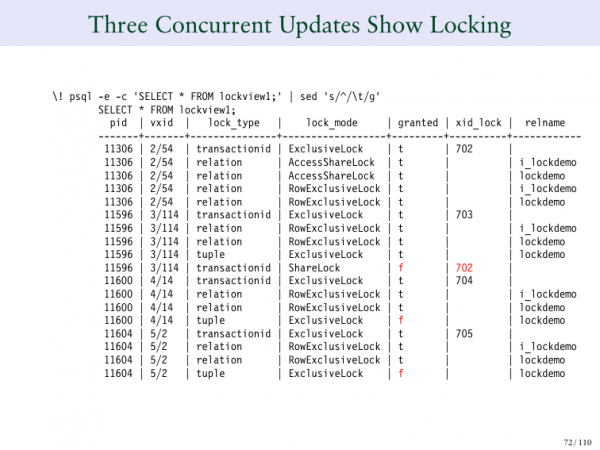
En alles wordt duidelijk. Wat is de eerste rij? Dat is 702. Dit is de transactietekening ID die deze waarde oorspronkelijk heeft ingesteld. En wat heb ik in de kolom Granted staan? Ik heb stippen. f. Dit zijn mijn updates (5, 6, 7) die niet goedgekeurd kunnen worden omdat we wachten tot de transactietekening ID 702 is voltooid. Daar hebben we een blokkering van de transactietekening ID. En er zijn 5 transactiebalkeringen IDs.
En als je naar 704, naar 705 kijkt, is daar nog niets geschreven, omdat ze nog niet weten wat er aan de hand is. Ze schrijven gewoon dat ze niet weten wat er aan de hand is. En ze zullen gewoon in slaap vallen omdat ze wachten totdat iemand klaar is en hen wakker maakt wanneer ze de rij kunnen wijzigen.
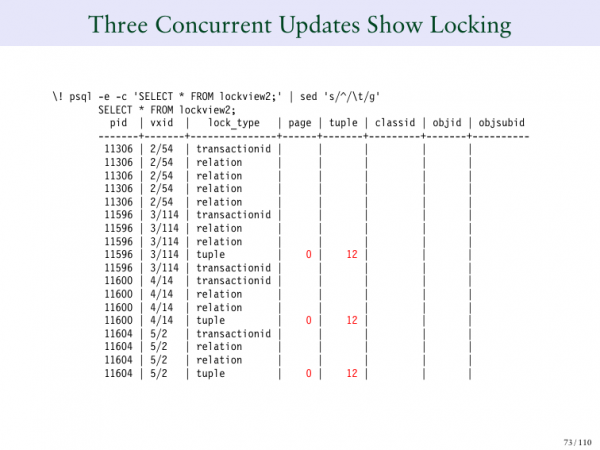
Zo ziet het eruit. Het is duidelijk dat ze allemaal op regel 12 wachten.
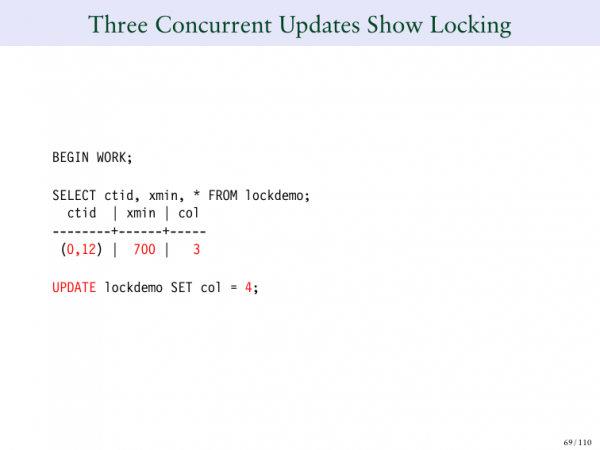
Dit is wat we hier hebben gezien. Hier is 0/12.
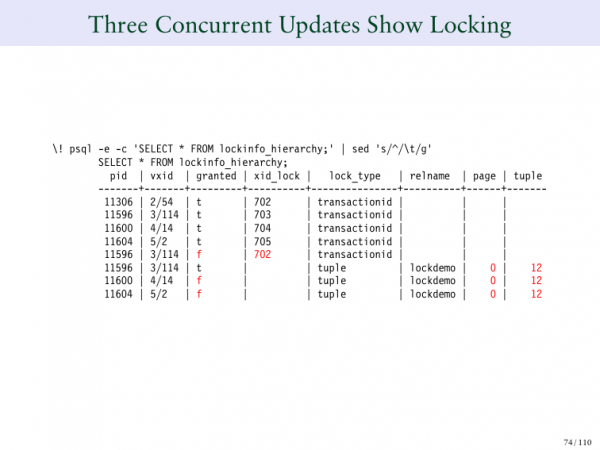
Dus zodra de eerste transactie is goedgekeurd, kun je hier zien hoe de hiërarchie werkt. En nu wordt alles duidelijk. Ze worden allemaal vrij. En ze zijn eigenlijk nog steeds in afwachting.
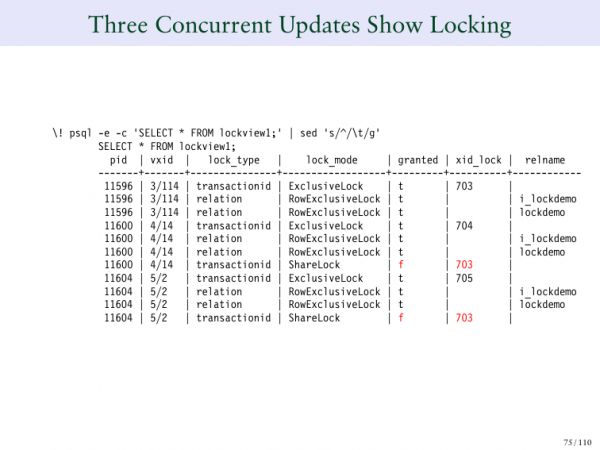
Dit is wat er gebeurt. 702 commit. En nu krijgt 703 deze rijblokkade, en daarna begint 704 te wachten totdat 703 commit. En 705 wacht er ook op. En wanneer dit allemaal afgelopen is, reinigen ze zichzelf. En ik wil erop wijzen dat ze allemaal in de rij staan. Dit lijkt veel op een file, waarbij iedereen wacht op de eerste auto. De eerste auto stopt, en iedereen vormt een lange lijn. Dan beweegt hij, en dan kan de volgende auto naar voren komen en zijn blokkade krijgen, enzovoort.
En als dit je nog niet ingewikkeld genoeg lijkt, dan gaan we het nu hebben over deadlocks. Ik weet niet wie van jullie hiermee te maken heeft gehad. Dit is een vrij algemeen probleem in databasesystemen. Maar deadlocks zijn die situatie waarin de ene sessie wacht zodat de andere sessie iets kan uitvoeren. En op dat moment wacht de andere sessie zodat de eerste sessie iets kan uitvoeren.
Bijvoorbeeld, als Ivan zegt: 'Geef me iets', en ik zeg: 'Nee, ik geef je dit alleen als je me iets anders geeft'. En hij zegt: 'Nee, ik geef je dit niet als je me dat niet geeft'. En we komen in een deadlock-situatie. Ik weet zeker dat Ivan dit niet zal doen, maar je begrijpt de essentie: twee mensen willen iets krijgen en zijn niet bereid het te geven totdat de ander hen geeft wat ze willen. En er is geen oplossing.
In feite moet jouw database dit identificeren. En dan moet het één van de sessies beëindigen of afsluiten, want anders blijven ze daar voor altijd zitten. We zien dit in databases, we zien dit in besturingssystemen. En op alle plaatsen waar we parallelle processen hebben, kan dit gebeuren.
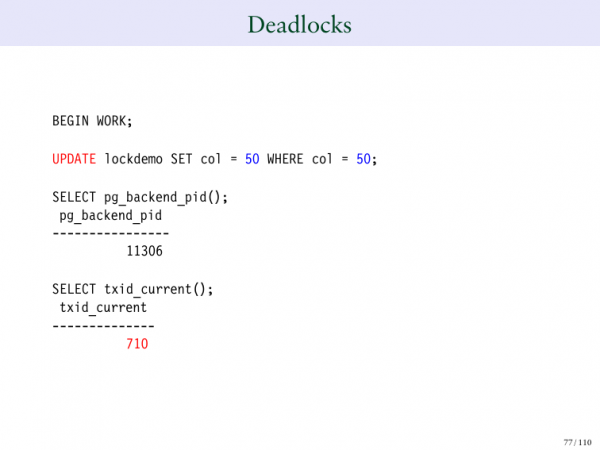
We gaan nu twee deadlocks creëren. We zetten 50 en 80. In de eerste rij doe ik een update van 50 naar 50. Ik krijg transactie nummer 710.
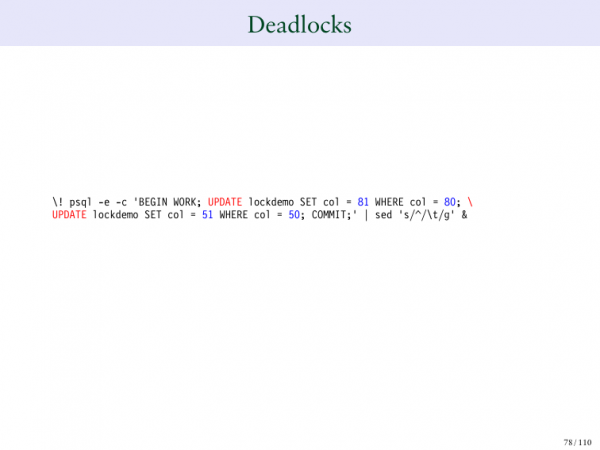
En dan zal ik 80 naar 81 veranderen, en 50 naar 51.
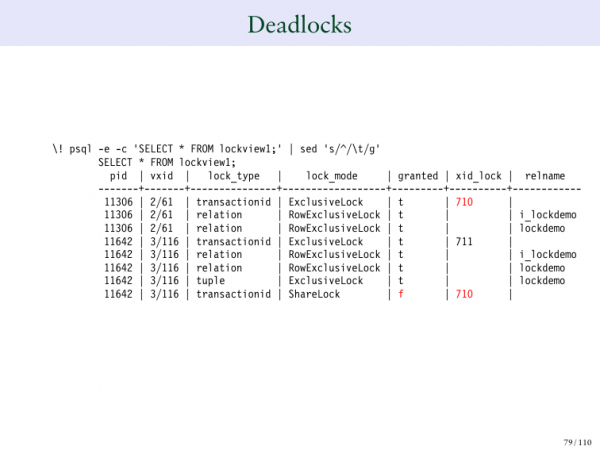
En zo zal dit eruit zien. Daarom heeft 710 een rijblokkade, terwijl 711 op bevestiging wacht. We hebben dit gezien tijdens de update. 710 is de eigenaar van onze rij. En 711 wacht tot 710 de transactie heeft voltooid.
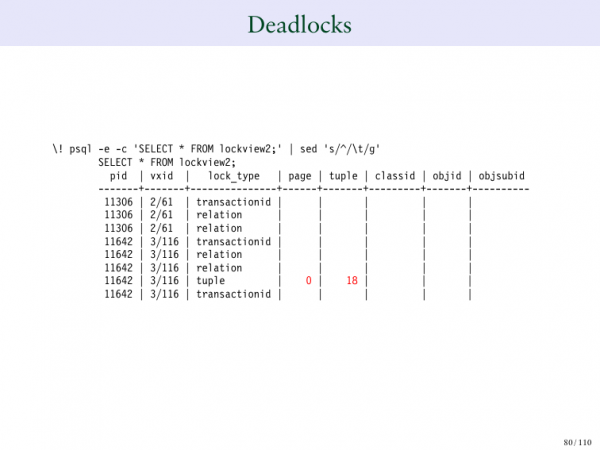
En daar staat zelfs op welke rij we een deadlock hebben. En dit is waar het vreemd begint te worden.
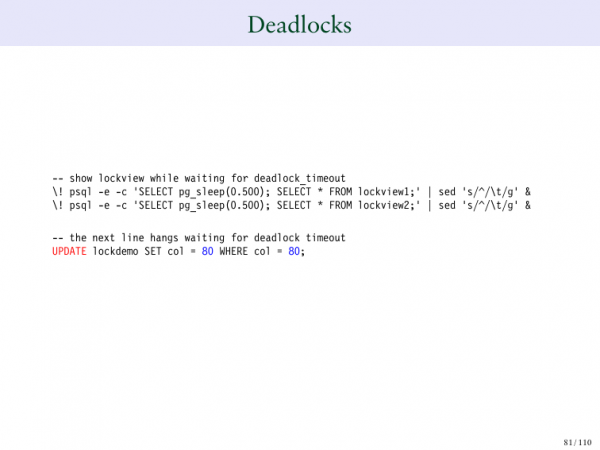
Nu updaten we 80 naar 80.
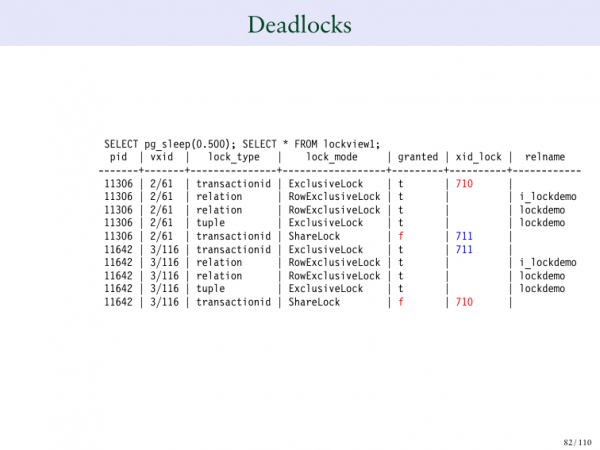
En hier beginnen de deadlocks. 710 wacht op een reactie van 711, terwijl 711 op 710 wacht. En dit zal slecht aflopen. Er is geen uitweg. En ze zullen op elkaar blijven wachten.
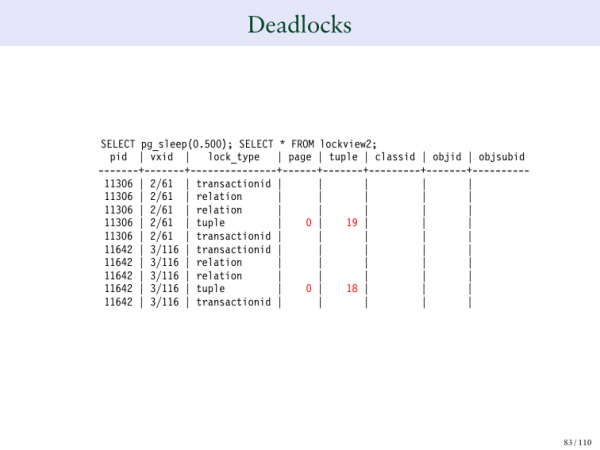
En dit begint gewoon alles te vertragen. En dat willen we niet.
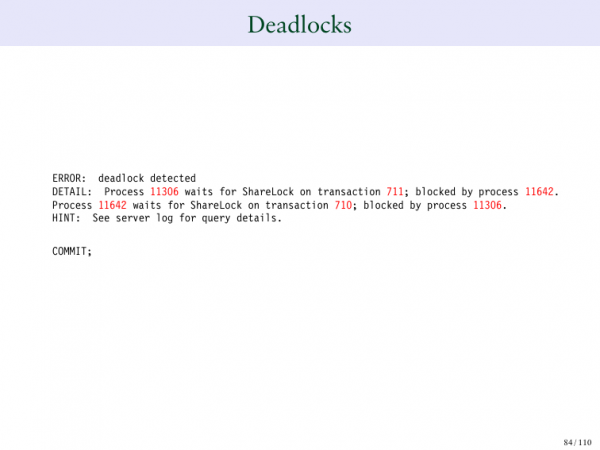
En in Postgres zijn er manieren om op te merken wanneer dit gebeurt. En wanneer dit gebeurt, krijg je zo'n foutmelding. Het is duidelijk dat een bepaald proces op een SHARE LOCK wacht van een ander proces, dat wil zeggen dat proces 711 het blokkeert. En dat proces wacht om een SHARE LOCK te krijgen op een bepaalde transactie-ID en wordt geblokkeerd door een ander proces. Daarom is er hier sprake van een deadlock.
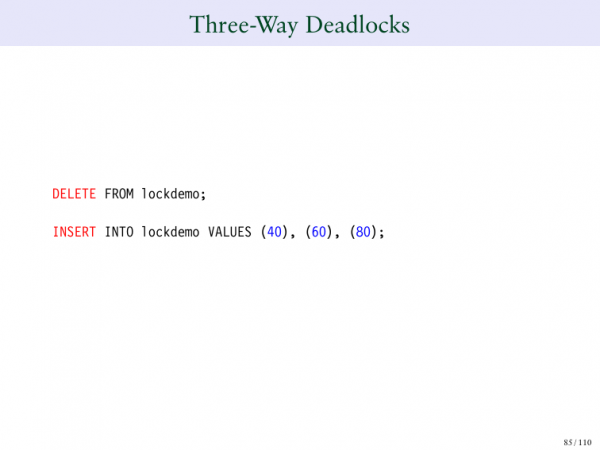
Maar is er zoiets als een driedubbele deadlock? Is dat mogelijk? Ja.
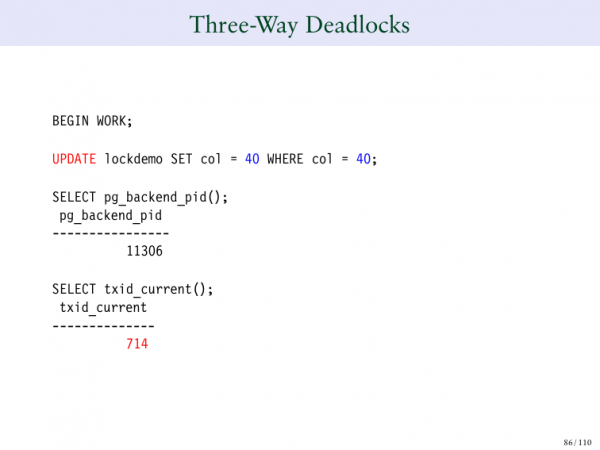
We voeren deze nummers in de tabel in. We veranderen 40 in 40, we maken de vergrendeling.
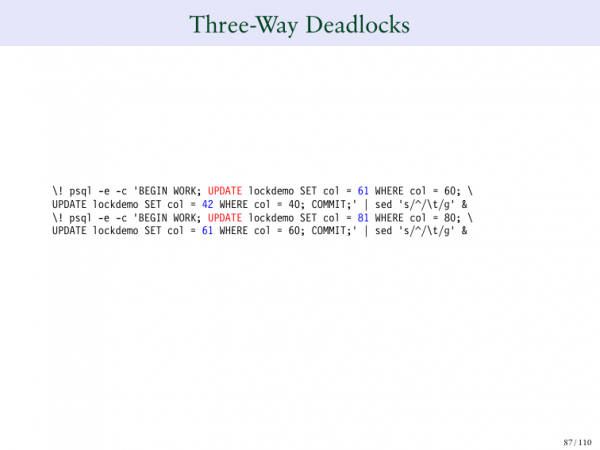
We veranderen 60 in 61, 80 in 81.
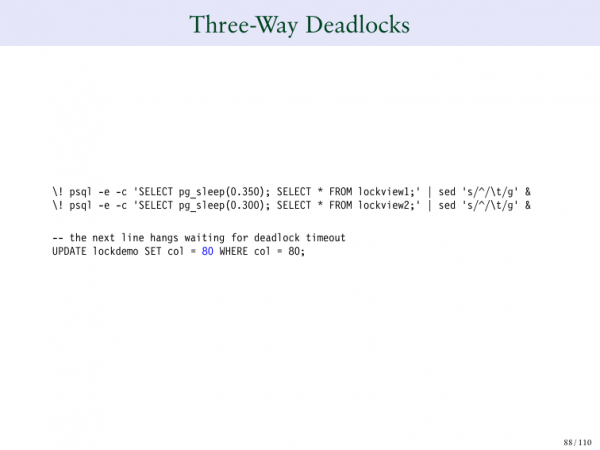
En dan veranderen we 80, en dan – bam!
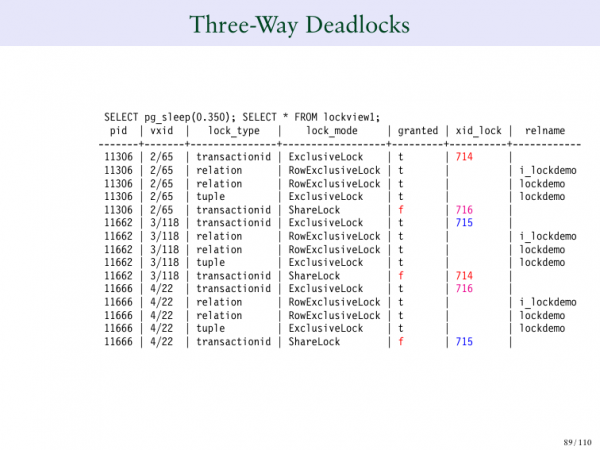
Nu wacht 714 op 715. 716 wacht op 715. En hier is niets meer aan te doen.
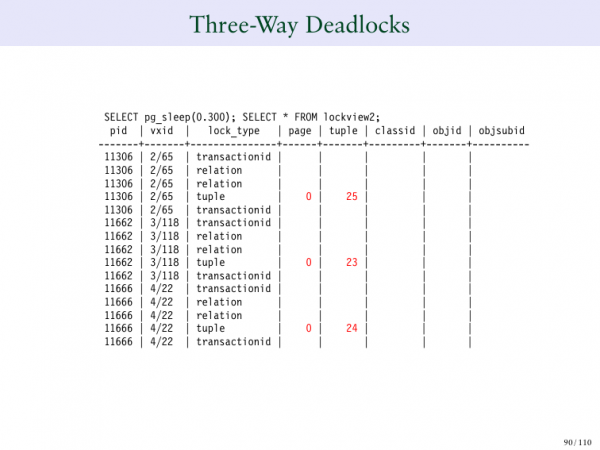
Hier zijn het al niet twee mensen, maar drie mensen. Ik wil iets van jou, deze wil iets van de derde persoon, en de derde persoon wil iets van mij. En we komen in een driedubbele wachtende situatie, omdat we allemaal wachten tot de ander is klaar met wat hij moet doen.
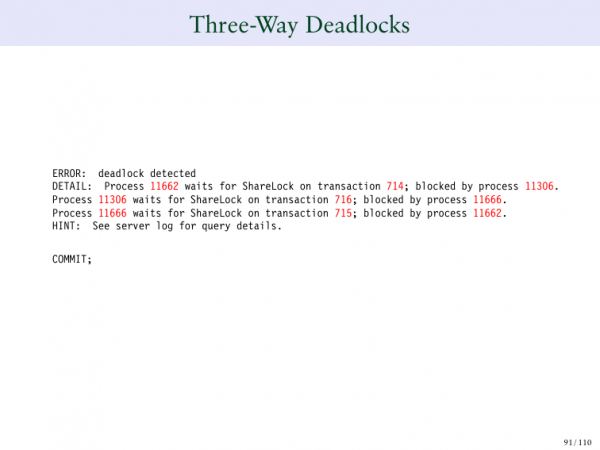
En Postgres weet op welke rij dit gebeurt. Daarom geeft het je de volgende melding, die aantoont dat je een probleem hebt waar drie invoeren elkaar blokkeren. En er zijn geen beperkingen. Dit kan gebeuren in een situatie waar 20 records elkaar blokkeren.
Het volgende probleem is serializable.
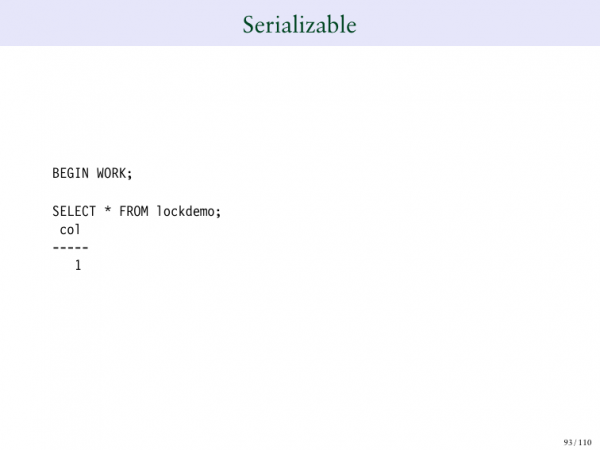
Als er een speciale serializable vergrendeling is.
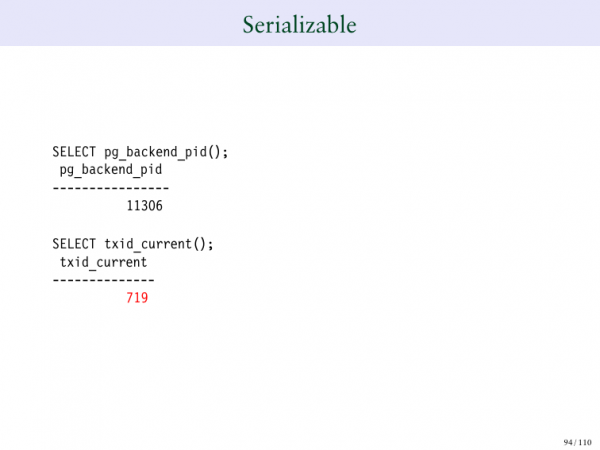
En we keren terug naar 719. Het heeft een heel normale uitvoer.
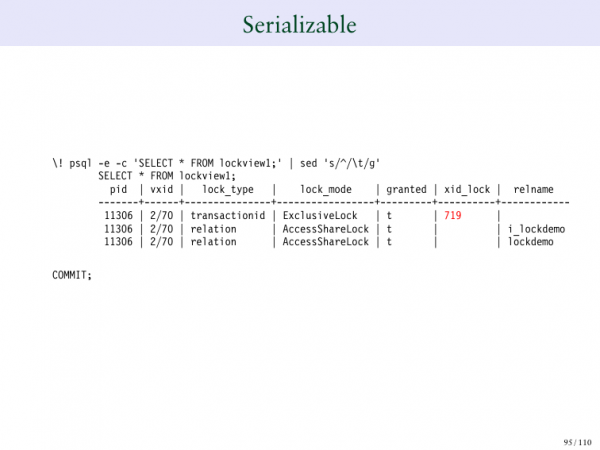
En je kunt klikken om een transactie uit de serializable uit te voeren.
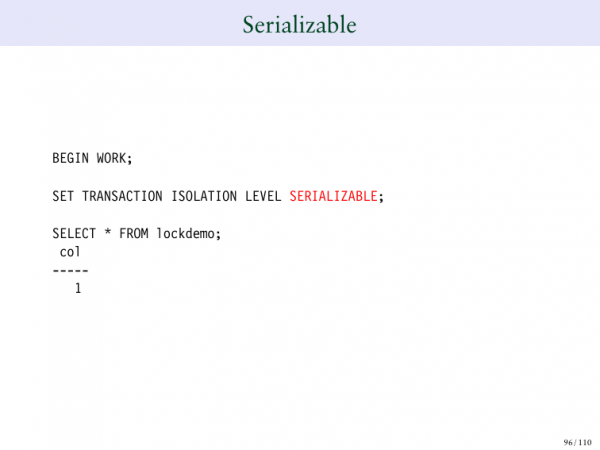
En je begrijpt dat je nu een ander type vergrendeling SA hebt - dat betekent serializable.
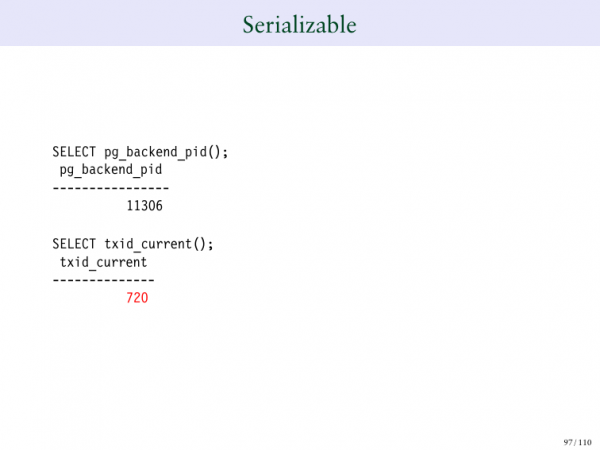
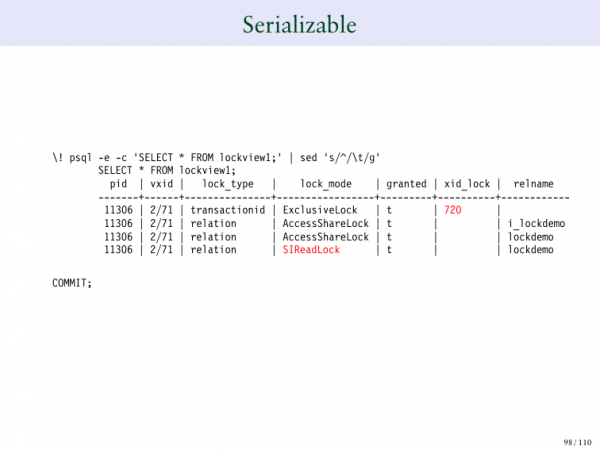
En daarom hebben we een nieuw type vergrendeling dat SARieadLock heet, dat een seriële vergrendeling is en het mogelijk maakt om seriële nummers in te voeren.
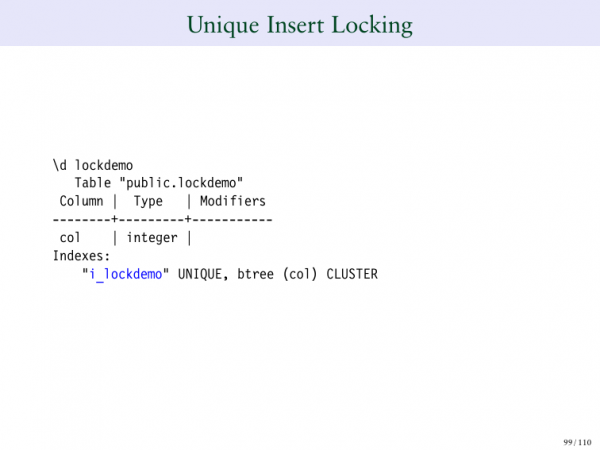
En je kunt ook unieke indexen invoegen.
In deze tabel hebben we unieke indexen.
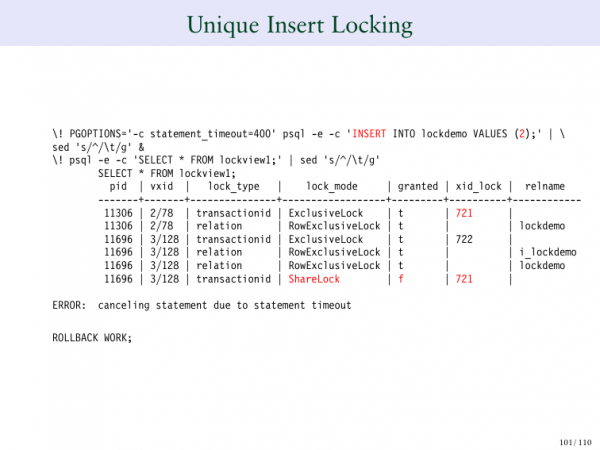
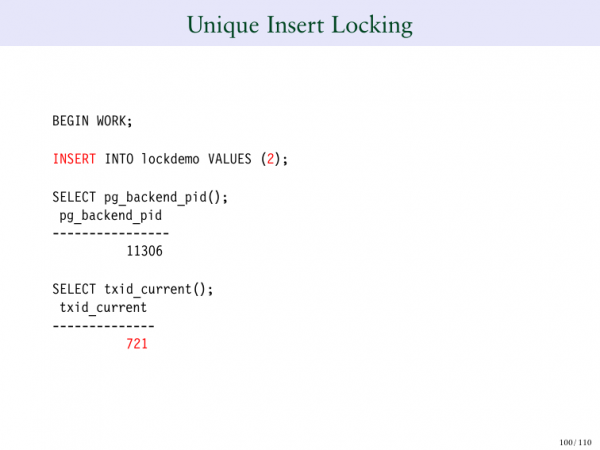
Dus als ik hier het nummer 2 invoer, dan heb ik 2. Maar helemaal bovenaan voeg ik nog een 2 toe. En je kunt zien dat 721 een exclusieve vergrendeling heeft. Maar nu wacht 722 tot 721 zijn operatie heeft voltooid, omdat hij 2 niet kan invoegen totdat hij weet wat er met 721 gaat gebeuren.
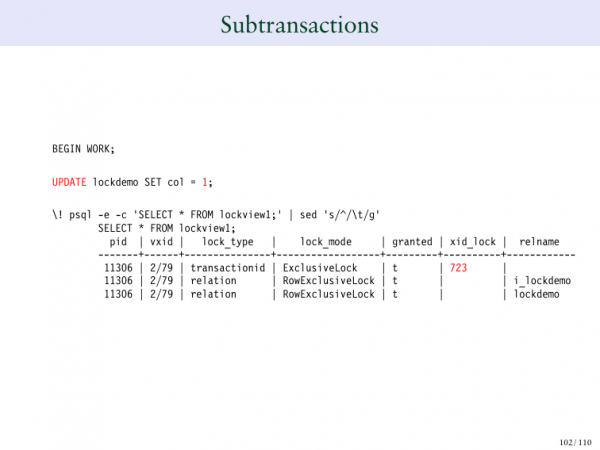
En als we een subtransactie maken.
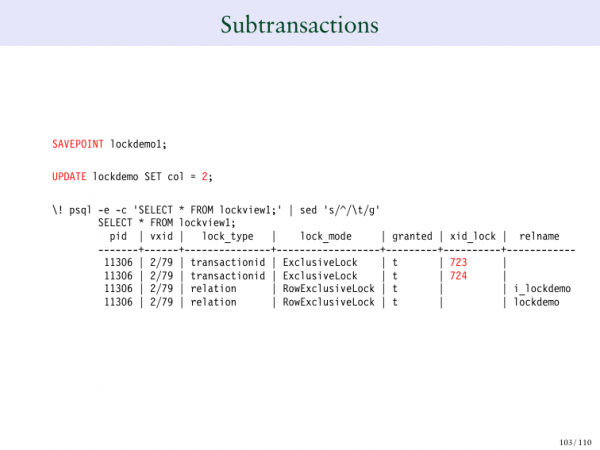
Hier hebben we 723.
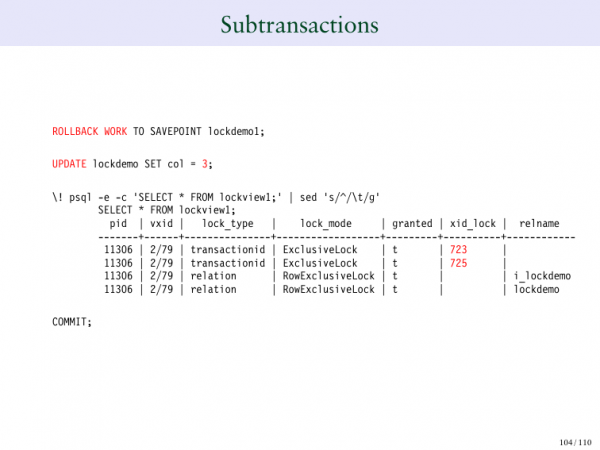
En als we het ID behouden en het vervolgens bijwerken, krijgen we een nieuw transactie-ID. Dit is nog een gedragskenmerk dat je moet weten. Als we dit teruggeven, gaat het transactie-ID weg. 724 verdwijnt. Maar nu krijgen we 725.
En wat probeer ik hier te doen? Ik probeer je voorbeelden te laten zien van ongebruikelijke blokkeringen die je kunt tegenkomen: of het nu serializable blokkeringen zijn of SAVEPOINT – dit zijn verschillende soorten blokkeringen die in de blokkeringstabel zullen verschijnen.
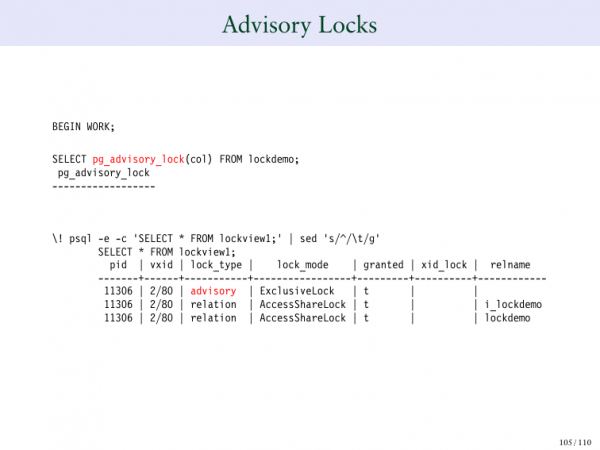
Dit betreft het creëren van expliciete blokkeringen, met pg_advisory_lock.
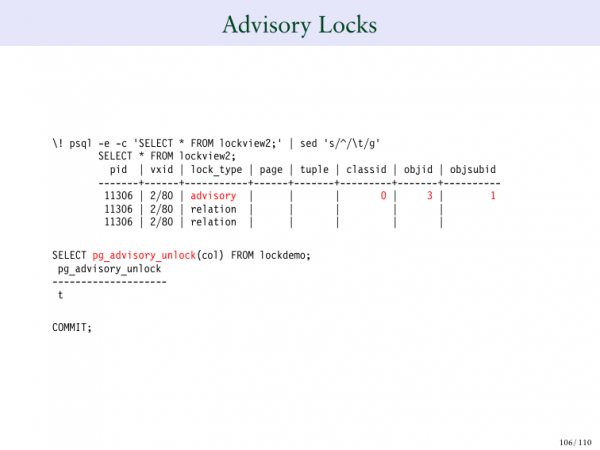
En je ziet dat het type blokkering hier wordt vermeld als advisory. En hier staat in het rood 'advisory'. En je kunt tegelijkertijd zo blokkeren met pg_advisory_unlock.
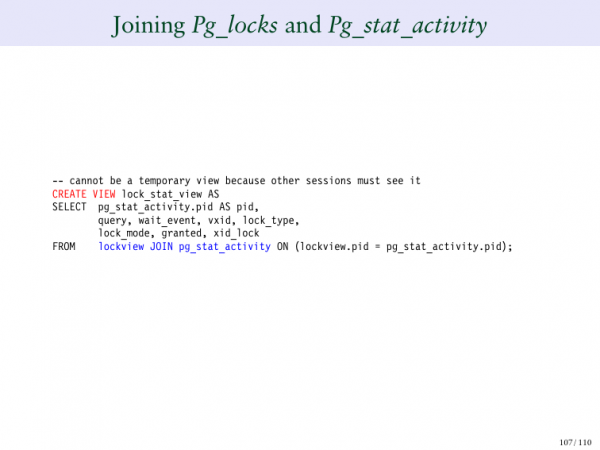
En als afsluiting wil ik je nog één verbazingwekkend iets laten zien. Ik zal een ander type maken. Maar ik zal de pg_locks-tabel verbinden met de pg_stat_activity-tabel. En waarom wil ik dit doen? Omdat dit me in staat stelt om alle huidige sessies te bekijken en te zien welke blokkeringen ze precies verwachten. En dit is vrij interessant, wanneer we de blokkeringstabel en de aanvraagtabel samenvoegen.
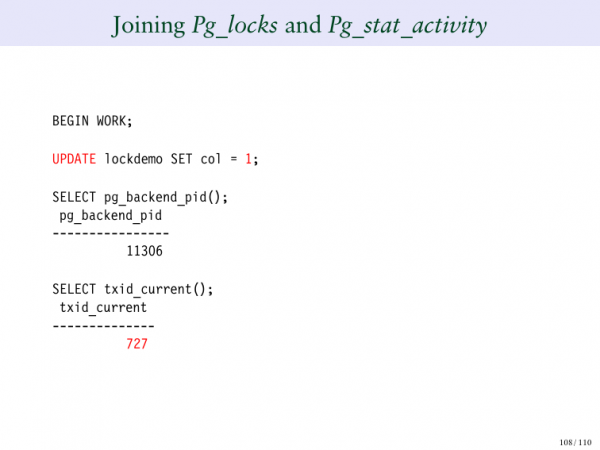
En hier creëren we pg_stat_view.
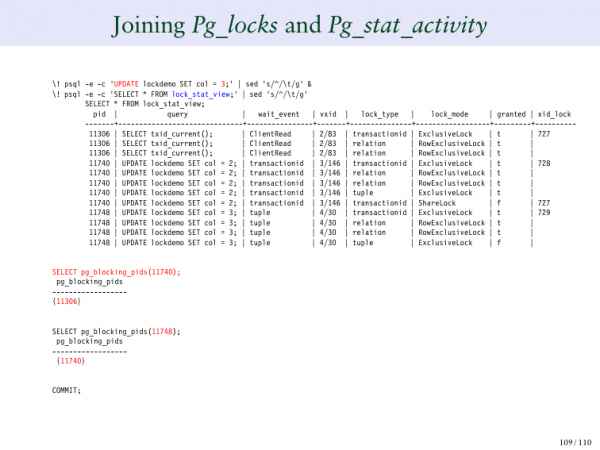
En we updaten de rij met één. En hier zien we 724. Vervolgens werken we onze rij bij naar drie. En wat zie je hier nu? Dit zijn de aanvragen, d.w.z. je ziet de hele lijst van aanvragen die aan de linkerkant zijn opsomming. En aan de rechterkant kun je de blokkeringen zien en wat ze creëren. En dit kan duidelijker voor je zijn, zodat je niet elke keer hoeft terug te gaan naar elke sessie en te kijken – of je je bij die sessie moet voegen of niet. Dit wordt voor ons gedaan.
Een andere functie die zeer nuttig is, is pg_blocking_pidsJe hebt er waarschijnlijk nog nooit van gehoord. Wat doet het? Het stelt ons in staat om te zeggen dat voor deze sessie 11740, welke specifieke proces-ID's het verwacht. En je kunt zien dat 11740 724 verwacht. En 724 staat helemaal bovenaan. En 11306 is jouw proces-ID. In wezen doorloopt deze functie jouw vergrendelingstabel. En ik weet dat het een beetje ingewikkeld is, maar je lijkt het te begrijpen. In wezen doorloopt deze functie deze vergrendelingstabel en probeert te vinden waar deze proces-ID is, rekening houdend met de vergrendelingen die hij verwacht. En probeert ook te berekenen welke specifieke proces-ID het heeft, van het proces dat op vergrendelingen wacht. Dus je kunt deze functie uitvoeren. pg_blocking_pids.
En dit is enorm handig. We hebben dit pas toegevoegd sinds versie 9.6, dus deze functie is pas 5 jaar oud, maar hij is erg en erg nuttig. Hetzelfde geldt voor de tweede query. Deze laat precies zien wat we moeten zien.
Dit is waarover ik met jullie wilde praten. En zoals ik al verwachtte, hebben we al onze tijd gebruikt, omdat er zoveel dia's waren. En de dia's zijn beschikbaar om te downloaden. Ik wil je bedanken dat je hier was. Ik weet zeker dat je geniet van de rest van de conferentie, heel erg bedankt!
Vragen:
Bijvoorbeeld, als ik probeer rijen bij te werken, terwijl een andere sessie probeert de hele tabel te verwijderen. Zoals ik het begrijp, moet er iets zijn zoals een intent lock. Heeft Postgres dat?
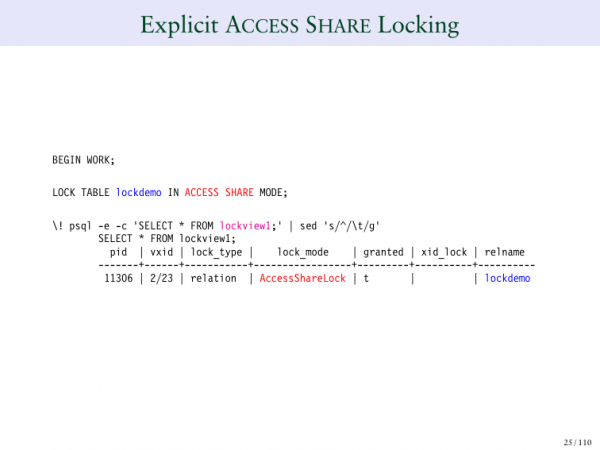
Laten we helemaal teruggaan naar het begin. Misschien herinner je je dat wanneer je iets doet, bijvoorbeeld wanneer je SELECT doet, we een AccessShareLock geven. Dit voorkomt het verwijderen van de tabel. Dus als je bijvoorbeeld een rij in de tabel wilt bijwerken of een rij wilt verwijderen, kan iemand de hele tabel niet tegelijkertijd verwijderen, omdat je deze AccessShareLock boven de hele tabel en de rij vasthoudt. En zodra je klaar bent, kunnen ze het verwijderen. Maar zolang je daar iets aan het wijzigen bent, kunnen ze dat niet doen.
Laten we het nog eens bekijken. Laten we overgaan naar het voorbeeld van het verwijderen. En je ziet hoe er op de rij een exclusieve lock is boven de hele tabel.
Het zal eruitzien als een lock exclusive, toch?
Ja, dat lijkt erop. Ik begrijp waar je het over hebt. Je zegt dat als ik een SELECT uitvoer, ik ShareExclusive heb, en als ik dit naar een Row Exclusive-toestand omzet, wordt dit dan een probleem? Maar verrassend genoeg vormt dit geen probleem. Het lijkt op het verhogen van het niveau van de blokkering, maar in essentie heb ik een lock die verwijdering voorkomt. En nu, wanneer ik deze lock krachtiger maak, voorkomt het nog steeds verwijdering. Dus het is niet zo dat ik naar boven ga. Met andere woorden, het voorkwam dit ook toen het op een lager niveau was, dus wanneer ik het niveau verhoog, voorkomt het nog steeds het verwijderen van de tabel.
Ik begrijp waar je het over hebt. Er is hier geen sprake van het verhogen van het niveau van de blokkering, waarbij je probeert een lock op te geven om een krachtigere in te voeren. Hier verhoogt dit simpelweg dat voorkomen, waardoor er geen conflict ontstaat. Maar dat is een goede vraag. Heel erg bedankt dat je dat hebt gevraagd!
Wat moeten we doen om een deadlock-situatie te vermijden wanneer we veel sessies en een groot aantal gebruikers hebben?
Postgres merkt automatisch deadlock-situaties op en zal automatisch een van de sessies verwijderen. De enige manier om deadlocks te vermijden is door mensen in dezelfde volgorde te blokkeren. Dus wanneer je naar je applicatie kijkt, is de oorzaak van deadlocks vaak... Laten we zeggen dat ik twee verschillende dingen wil blokkeren. Eén applicatie blokkeert tabel 1, terwijl een andere applicatie tabel 2 blokkeert, en vervolgens tabel 1. De eenvoudigste manier om deadlocks te vermijden, is door naar je applicatie te kijken en ervoor te zorgen dat de blokkering in dezelfde volgorde in al je applicaties gebeurt. Dit voorkomt doorgaans 80% van de problemen, omdat verschillende mensen deze applicaties schrijven. En als je ze in dezelfde volgorde blokkeert, zal je niet tegen een deadlock-situatie aanlopen.
Heel erg bedankt voor je presentatie! Je sprak over vacuum full en als ik het goed begrijp, dan vervormt vacuum full de volgorde van de records in de aparte opslag, zodat de huidige records ongewijzigd blijven. Maar waarom vereist vacuum full exclusieve lock-toegang en waarom botst het met schrijfoperaties?
Dat is een goede vraag. De reden is dat vacuum full de tabel in beslag neemt. En we creëren in wezen een nieuwe versie van de tabel. De tabel zal nieuw zijn. Dit betekent dat het een volledig nieuwe versie van de tabel zal zijn. Het probleem is dat wanneer we dit doen, we niet willen dat mensen dit lezen, omdat we willen dat ze de nieuwe tabel zien. Daarom sluit dit aan bij de vorige vraag. Als we tegelijkertijd konden lezen, zouden we het niet kunnen verplaatsen en mensen naar de nieuwe tabel begeleiden. We zouden moeten wachten tot iedereen klaar is met het lezen van deze tabel, en daarom is dit in wezen een exclusieve vergrendelingssituatie.
We zeggen gewoon dat we vanaf het begin vergrendelen, omdat we weten dat we aan het eind een exclusieve vergrendeling nodig zullen hebben om iedereen naar een nieuwe kopie te verplaatsen. Daarom kunnen we dit potentieel oplossen. En we doen dit met gelijktijdige indexering. Maar dat is veel moeilijker te doen. Dit heeft sterk betrekking op uw vorige vraag over exclusieve vergrendeling.
Is het mogelijk om een locking timeout in Postgres toe te voegen? In Oracle kan ik bijvoorbeeld 'select for update' schrijven en 50 seconden wachten tot de update. Dit werkte goed voor de toepassing. Maar in Postgres moet ik dit ofwel meteen doen en helemaal niet wachten, of wachten tot een bepaalde tijd.
Ja, u kunt een timeout voor uw vergrendelingen instellen. U kunt ook het commando no way geven, wat zal …, als u de vergrendeling niet onmiddellijk kunt krijgen. Dus ofwel lock timeout, of iets anders dat u dat kan laten doen. Dit gebeurt niet op syntactisch niveau. Dit gebeurt als een variabele op de server. Soms kan dit niet worden gebruikt.
Kun je de 75e dia openen?
Ja.
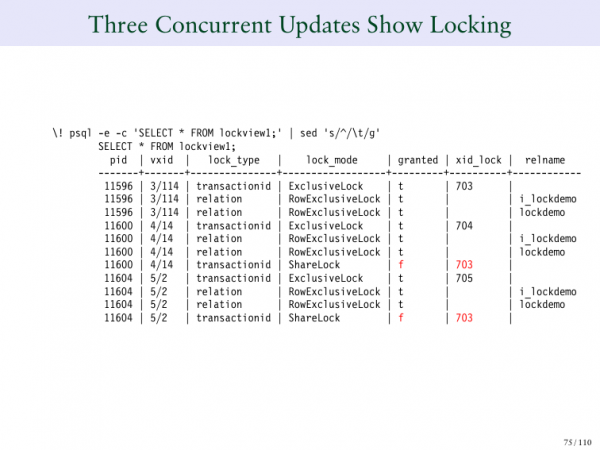
En mijn volgende vraag is. Waarom wachten beide updateprocessen op 703?
En dat is een uitstekende vraag. Ik begrijp niet waarom Postgres dit doet. Maar toen 703 werd aangemaakt, verwachtte het 702. En wanneer 704 en 705 verschijnen, lijkt het alsof ze niet weten wat ze wachten, omdat er nog niets is. En Postgres doet het zo: wanneer je geen lock kunt krijgen, schrijft hij: "Wat is de zin om jullie te verwerken?", omdat je al op iemand wacht. Dus laten we het maar gewoon in de lucht hangen, hij werkt dit helemaal niet bij. Maar wat gebeurde hier? Zodra 702 het proces beëindigde en 703 zijn lock kreeg, werd het systeem weer teruggebracht. En zei, dat we nu twee mensen hebben die aan het wachten zijn. Laten we ze samen bijwerken. En geven aan dat beiden wachten.
Ik weet niet waarom Postgres dit doet. Maar er is een probleem dat f... wordt genoemd. Het lijkt mij geen term in het Russisch te zijn. Dit is wanneer iedereen op dezelfde lock wacht, zelfs als er 20 instanties zijn die op de lock wachten. En ineens worden ze allemaal tegelijk wakker. En iedereen begint te proberen te reageren. Maar het systeem zorgt ervoor dat iedereen op 703 wacht. Omdat ze allemaal wachten, zetten we ze meteen allemaal in een rij. En als er een andere nieuwe aanvraag binnenkomt, die na dit is gecreëerd, zoals 707, dan zal er weer leegte zijn.
En het lijkt mij dat dit gedaan wordt zodat er gezegd kan worden dat op dit punt 702 wacht op 703, en alle anderen die daarna komen, hebben geen enkele vermelding in dit veld. Maar zodra de eerste wachtende vertrekt, krijgen alle anderen die op dat moment wachtten voor de update dezelfde marker. En daarom denk ik dat dit gedaan is, zodat we het op volgorde kunnen verwerken, zodat ze correct geordend zijn.
Ik heb hier altijd naar gekeken als een vrij vreemd fenomeen. Omdat we hier bijvoorbeeld niemand opsommen. Maar, ik denk dat elke keer wanneer we een nieuwe lock geven, we kijken naar al diegenen die in de wachtrij zitten. Dan zetten we ze allemaal in een rij. En elke nieuwe die komt, komt alleen in de rij zodra de volgende persoon is verwerkt. Een hele goede vraag. Heel erg bedankt voor de vraag!
Het lijkt mij veel logischer wanneer 705 wacht op 704.
Maar het probleem is als volgt. Technisch gezien kun je of de een of de ander wakker maken. En daarom zullen we de een of de ander wakker maken. Maar wat gebeurt er in de werking van het systeem? Je ziet dat 703 helemaal bovenin zijn eigen transactionele ID heeft geblokkeerd. Zo werkt Postgres. En 703 wordt geblokkeerd door zijn eigen transactionele ID, en dus, als iemand wil wachten, dan zal hij op 703 wachten. En in wezen voltooit 703. En pas na zijn voltooiing wordt een van de processen wakker. En we weten niet welk proces dat zal zijn. Vervolgens verwerken we alles geleidelijk. Maar het is niet duidelijk welk proces als eerste wakker wordt, omdat het elk van deze processen kan zijn. In wezen hadden we een planner die zei dat we nu elk van deze processen kunnen wakker maken. We kiezen er gewoon eentje willekeurig. Daarom moeten we ze allebei markeren, omdat we elk van hen kunnen wakker maken.
En het probleem is dat we CP-oneindigheid hebben. En daarom is het heel goed mogelijk dat we de latere kunnen wakker maken. En als we bijvoorbeeld de latere wakker maken, dan zullen we wachten op degene die net de blokkering heeft gekregen, dus we bepalen niet wie precies als eerste wakker zal worden. We creëren gewoon zo'n situatie, en het systeem zal hen in willekeurige volgorde wakker maken.
Er is . Kijk, ze zijn ook interessant en nuttig. Het onderwerp is natuurlijk vreselijk complex. Heel erg bedankt, Bruce!
Bron: habr.com
