

Achtergrond
Als een liefhebber van retro hardware heb ik op een gegeven moment een ZX Spectrum+ gekocht van een verkoper uit het Verenigd Koninkrijk. Bij de computer kreeg ik verschillende audiocassettes met games (in de originele verpakking met instructies), evenals programma's die op cassettes zonder duidelijke aanduidingen waren opgenomen. Tot mijn verbazing konden de gegevens van de 40 jaar oude cassettes goed worden gelezen en lukte het me om bijna alle games en programma's ervan te laden.
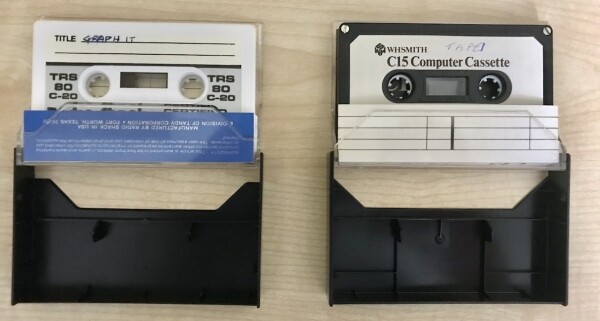
Echter, op sommige cassettes ontdekte ik opnames die duidelijk niet afkomstig waren van een ZX Spectrum. Ze klonken volkomen anders en begonnen, in tegenstelling tot de opnames van genoemde computer, niet met een korte BASIC bootloader, die normaal gesproken aanwezig is in de opnames van alle programma's en games.
Een tijdlang maakte dit me ongerust - ik wilde heel graag weten wat erin verborgen zat. Als het mogelijk was om het audiosignaal als een reeks bytes te lezen, zou ik kunnen zoeken naar symbolen of iets dat op de oorsprong van het signaal wijst. Een soort retro-archeologie.
Nu, nu ik deze hele weg heb afgelegd en kijk naar de labels van de cassettes zelf, glimlach ik, omdat
het antwoord al die tijd recht voor mijn ogen was.
Op het label van de linker cassette staat de naam van de computer TRS-80, en iets lager de naam van de fabrikant: ‘Manufactured by Radio Shack in USA’
(Als je de spanning tot het einde wilt bewaren, ga dan niet naar de spoiler)
Vergelijking van audiosignalen
Laten we eerst de audiobestanden digitaliseren. Je kunt luisteren hoe dit klinkt:
En hoe de opname van de ZX Spectrum gewoonlijk klinkt:
In beide gevallen is er aan het begin van de opname een zogenaamde pilot toon — een geluid van één frequentie (in de eerste opname is het heel kort <1 sec, maar wel hoorbaar). De pilot toon dient als een signaal voor de computer om zich voor te bereiden op het ontvangen van gegevens. Gewoonlijk herkent elke computer alleen zijn 'eigen' pilot toon op basis van de vorm van het signaal en de frequentie.
Ik moet iets zeggen over de vorm van het signaal. Bijvoorbeeld, op de ZX Spectrum is de vorm rechthoekig:
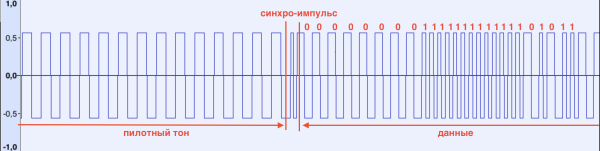
Wanneer de pilot toon wordt gedetecteerd, toont de ZX Spectrum afwisselend rode en blauwe strepen in de rand van het scherm, wat aangeeft dat het signaal is herkend. De pilot toon eindigt met een synchronisatiepuls., die de computer signaleert om te beginnen met het ontvangen van gegevens. Het heeft een kortere duur (vergeleken met de pilottoon en de daaropvolgende gegevens) (zie afbeelding)
Nadat de synchronisatiepuls is ontvangen, registreert de computer elke stijging/daling van het signaal en meet het de duur ervan. Als de duur onder een bepaalde grens ligt, wordt bit 1 in het geheugen opgeslagen, anders 0. De bits worden samengevoegd in bytes en het proces herhaalt zich totdat er N bytes zijn ontvangen. Het aantal N wordt meestal uit de header van het te laden bestand gehaald. De volgorde van laden is als volgt:
- pilot toon
- header (van vaste lengte), bevat de grootte van de te laden gegevens (N), naam en type bestand
- pilot toon
- de gegevens zelf
Om te verifiëren dat de gegevens correct zijn geladen, leest de ZX Spectrum het zogenaamde pariteitsbyte , dat wordt berekend bij het opslaan van het bestand met de XOR-operatie over alle bytes van de opgeslagen gegevens. Bij het lezen van het bestand berekent de computer het pariteitsbyte uit de ontvangen gegevens en als het resultaat verschilt van het opgeslagen resultaat, wordt er een foutmelding weergegeven: "R Tape loading error". Strikt genomen kan de computer deze melding eerder geven als het het signaal niet kan herkennen tijdens het lezen (overgeslagen of de duur komt niet overeen met bepaalde grenzen)
Laten we nu eens kijken hoe het onbekende signaal eruitziet:
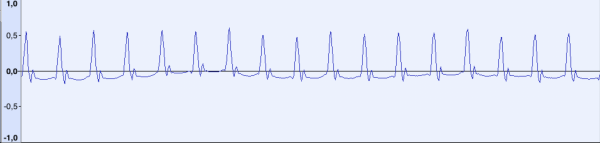
Dit is de pilottoon. De vorm van het signaal is aanzienlijk anders, maar het is duidelijk dat het signaal bestaat uit herhaalde korte pulsen van een bepaalde frequentie. Bij een samplefrequentie van 44100 Hz is de afstand tussen de "pieken" ongeveer 48 samples (wat overeenkomt met een frequentie van ~918 Hz) We onthouden dit cijfer.
Laten we nu eens kijken naar een fragment met gegevens:
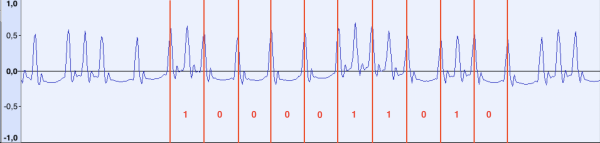
Als we de afstand tussen de afzonderlijke pulsen meten, blijkt dat de afstand tussen de "lange" pulsen nog steeds ~48 samples is, terwijl deze tussen de korte pulsen ~24 is. Een beetje vooruitlopend, kan ik zeggen dat er uiteindelijk bleek dat de "referentie" pulsen met een frequentie van 918 Hz continu volgen, van het begin tot het einde van het bestand. We kunnen aannemen dat als er een extra puls tussen de referentiepulsen verschijnt, deze als bit 1 wordt geteld, anders als 0.
Wat is er met de synchronisatiepuls? Laten we naar het begin van de gegevens kijken:
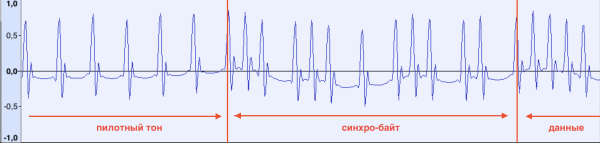
De piloottoon eindigt en de data begint onmiddellijk. Iets later, na het analyseren van verschillende audio-opnames, bleek dat de eerste byte van de data altijd hetzelfde is (10100101b, A5h). Misschien begint de computer de data te lezen nadat deze deze heeft ontvangen.
We kunnen ook de verschuiving van de eerste referentie-impuls, direct na de laatste 1 in de sync-byte, opmerken. Deze is veel later ontdekt tijdens de ontwikkeling van het programma voor gegevensherkenning, toen de gegevens aan het begin van het bestand niet betrouwbaar konden worden gelezen.
Laten we nu proberen een algoritme te beschrijven dat het audio-bestand zal verwerken en de gegevens zal laden.
Gegevens laden
Laten we eerst een paar aannames bekijken om het algoritme niet te compliceren:
- We beschouwen alleen bestanden in WAV-formaat;
- Het audio-bestand moet beginnen met een piloottoon en mag geen stilte aan het begin bevatten.
- Het oorspronkelijke bestand moet een samplefrequentie van 44100 Hz hebben. In dat geval is de afstand tussen de referentie-impulsen in 48 samples al bepaald en hoeven we deze niet programmatisch te berekenen;
- Het sampleformaat kan willekeurig zijn (8/16 bit/float) - want bij het lezen kunnen we het omzetten naar het vereiste formaat;
- We nemen aan dat het oorspronkelijke bestand is genormaliseerd op amplitude, wat het resultaat zou moeten stabiliseren;
Het leesalgoritme is als volgt:
- We lezen het bestand in het geheugen en zetten tegelijkertijd het sampleformaat om naar 8 bit;
- We bepalen de positie van de eerste impuls in de audiogegevens. Hiervoor moeten we het nummer van de sample met de maximale amplitude berekenen. Voor de eenvoud rekenen we deze één keer met de hand. We slaan het op in de variabele prev_pos;
- We voegen 48 toe aan de positie van de laatste impuls (pos := prev_pos + 48)
- Omdat de verhoging van de positie met 48 niet garandeert dat we binnen de volgende referentie-impuls komen (bandfouten, onbetrouwbaar functioneren van de banddoorvoermechanismen, enzovoort), moet de positie van de impuls pos worden gecorrigeerd. Hiervoor nemen we een klein gegevenssegment (pos-8; pos+8) en vinden we het maximum van de amplitude binnen dat segment. De positie die overeenkomt met het maximum wordt opgeslagen in pos. Hier is 8 = 48/6 — een experimenteel verkregen constante die garandeert dat we het juiste maximum bepalen en andere impulsen die in de buurt kunnen liggen, niet raken. In zeer slechte gevallen, wanneer de afstand tussen de impulsen veel kleiner of groter is dan 48, kan een geforceerde zoektocht naar impulsen worden uitgevoerd, maar in het kader van dit artikel zal ik dat niet beschrijven in het algoritme.
- In de vorige stap moet ook worden gecontroleerd of de referentie-impuls überhaupt is gevonden. Dat betekent dat simpelweg het maximum zoeken niet garandeert dat er een impuls aanwezig is in dit segment. In mijn laatste implementatie van het leesprogramma controleer ik het verschil tussen de maximale en minimale amplitude in het segment, en als dit een bepaalde grens overschrijdt, beschouw ik de impuls als aanwezig. De vraag is ook wat te doen als de referentie-impuls niet is gevonden. Hier zijn 2 opties: of de gegevens zijn op, en er volgt stilte, of dit moet worden gezien als een leesfout. Laten we dit echter voor de vereenvoudiging van het algoritme negeren.
- In de volgende stap moeten we de aanwezigheid van gegevensimpulsen (bit 0 of 1) bepalen. Hiervoor nemen we het midden van het segment (prev_pos; pos) middle_pos gelijk aan middle_pos := (prev_pos + pos) / 2 en in een bepaalde buurt rond middle_pos binnen het segment (middle_pos-8; middle_pos+8) berekenen we het maximum en minimum van de amplitude. Als het verschil tussen hen groter is dan 10, noteren we bit 1 als resultaat, anders 0. 10 is een constant die experimenteel is verkregen.
- We slaan de huidige positie op in prev_pos (prev_pos := pos).
- We herhalen vanaf stap 3 totdat we het hele bestand hebben gelezen.
- De verkregen bitarray moet worden opgeslagen als een set bytes. Aangezien we de synchronisatiebyte niet hebben meegeteld bij het lezen, kan het aantal bits niet deelbaar zijn door 8, en ook de benodigde offset in bits is onbekend. In de eerste implementatie van het algoritme wist ik niet van het bestaan van de synchronisatiebyte en bewaarde ik gewoon 8 bestanden met een verschillende hoeveelheid bitoffsets. Een van hen bevatte de juiste gegevens. In het uiteindelijke algoritme verwijder ik gewoon alle bits tot A5h, wat het mogelijk maakt om meteen een correct bestand te krijgen als output.
Algoritme in Ruby, voor wie geïnteresseerd is.
Als programmeertaal koos ik Ruby, omdat ik het grootste deel van de tijd daarop programmeer. De variant is niet hoogperformant, maar de taak om de leessnelheid zo snel mogelijk te maken staat niet op de agenda.
# Используем gem 'wavefile'
require 'wavefile'

reader = WaveFile::Reader.new('input.wav')
samples = []
format = WaveFile::Format.new(:mono, :pcm_8, 44100)

# Читаем WAV файл, конвертируем в формат Mono, 8 bit
# Массив samples будет состоять из байт со значениями 0-255
reader.each_buffer(10000) do |buffer|
  samples += buffer.convert(format).samples
end

# Позиция первого импульса (вместо 0)
prev_pos = 0
# Расстояние между импульсами
distance = 48
# Значение расстояния для окрестности поиска локального максимума
delta = (distance / 6).floor
# Биты будем сохранять в виде строки из "0" и "1"
bits = ""

loop do
  # Рассчитываем позицию следующего импульса
  pos = prev_pos + distance

  # Выходим из цикла если данные закончились
  break if pos + delta >= samples.size

  # Корректируем позицию pos обнаружением максимума на отрезке [pos - delta;pos + delta]
  (pos - delta..pos + delta).each { |p| pos = p if samples[p] > samples[pos] }

  # Находим середину отрезка [prev_pos;pos]
  middle_pos = ((prev_pos + pos) / 2).floor

  # Берем окрестность в середине
  sample = samples[middle_pos - delta..middle_pos + delta]

  # Определяем бит как "1" если разница между максимальным и минимальным значением на отрезке превышает 10
  bit = sample.max - sample.min > 10
  bits += bit ? "1" : "0"
end

# Определяем синхро-байт и заменяем все предшествующие биты на 256 бит нулей (согласно спецификации формата)
bits.gsub! /^[01]*?10100101/, ("0" * 256) + "10100101"

# Сохраняем выходной файл, упаковывая биты в байты
File.write "output.cas", [bits].pack("B*")
Resultaat
Na verschillende algoritmen en constanten geprobeerd te hebben, had ik het geluk iets extreem interessants te krijgen:
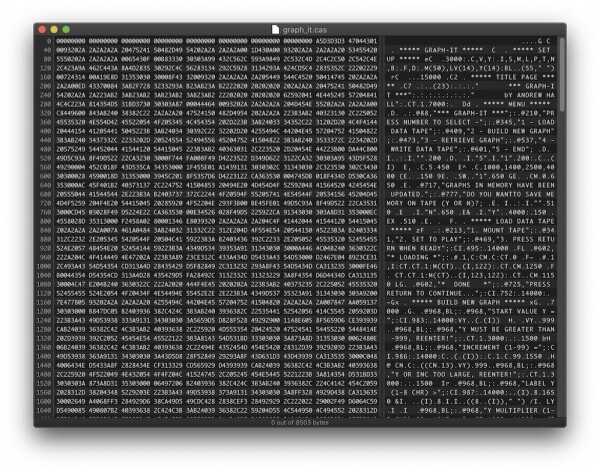
Dus, te oordelen naar de tekenreeksen, hebben we een programma voor het maken van grafieken. Echter, in de programmatekst ontbreken de sleutelwoorden. Alle sleutelwoorden zijn gecodeerd als bytes (waardes groter dan 80h). Nu moeten we uitzoeken welke computer uit de jaren '80 programma's in dit formaat kon opslaan.
Het lijkt eigenlijk erg veel op een programma in de taal BASIC. Ongeveer in hetzelfde formaat slaat de computer ZX Spectrum programma's in het geheugen op en schrijft ze naar tape. Voor de zekerheid heb ik de sleutelwoorden vergeleken met Echter, het resultaat was duidelijk negatief.
Daarnaast heb ik de sleutelwoorden van BASIC van populaire computers uit die tijd, zoals Atari, Commodore 64 en enkele anderen waarvoor ik documentatie kon vinden, gecontroleerd, maar zonder succes — mijn kennis van varianten van retrocomputers bleek niet zo uitgebreid.
Toen besloot ik verder te gaan met , en toen viel mijn blik op de naam van de fabrikant Radio Shack en de computer TRS-80. Deze namen stonden op de etiketten van de cassettes die op mijn bureau lagen! Ik kende deze namen niet eerder en was niet bekend met de computer TRS-80, dus het leek me logisch dat Radio Shack een fabrikant van audiocassettes was, zoals BASF, Sony of TDK, en TRS-80 — speeltijd. Waarom niet?
Computer Tandy/Radio Shack TRS-80
Het is zeer waarschijnlijk dat de audio-opname die ik in het begin van het artikel als voorbeeld heb gegeven, gemaakt is op zo'n computer:
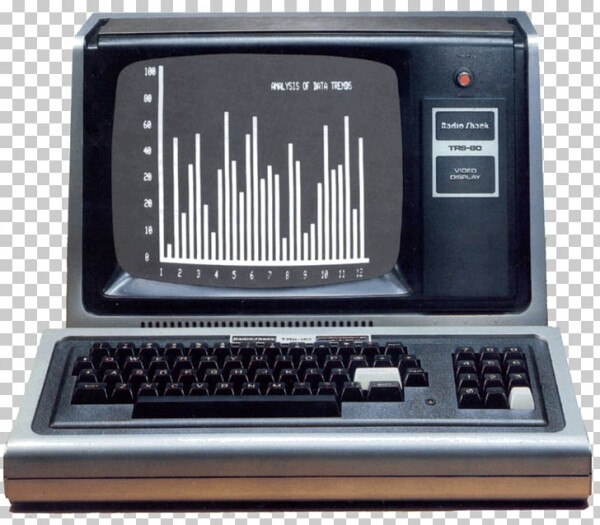
Het bleek dat deze computer en zijn varianten (Model I/Model III/Model IV enz.) in hun tijd zeer populair waren (uiteraard niet in Rusland). Opvallend is dat de processor die erin werd gebruikt — ook de Z80. Over deze computer is op het internet veel te vinden . In de jaren '80 werd informatie over de computer verspreid via . Momenteel zijn er verschillende van de computer voor verschillende platformen.
Ik heb de emulator gedownload en het was de eerste keer dat ik kon zien hoe deze computer werkte. Natuurlijk ondersteunde de computer geen kleuruitvoer, de schermresolutie was slechts 128x48 pixels, maar er waren veel uitbreidingen en modificaties die de schermresolutie konden verhogen. Ook waren er veel verschillende besturingssystemen voor deze computer en versies van de BASIC-taal (die, in tegenstelling tot de ZX Spectrum, in sommige modellen zelfs niet 'in de firmware' was ingebrand en elke versie kon van een floppy worden geladen, net als het besturingssysteem zelf)
Ook vond ik voor het converteren van audiobestanden naar het CAS-formaat, dat door de emulators wordt ondersteund, maar om de een of andere reden lukte het niet om met hun hulp opnames van mijn cassettes te lezen.
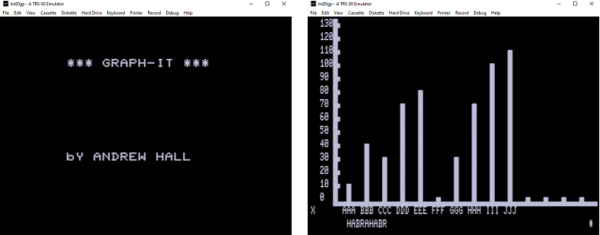
Toen ik de CAS-bestandsindeling uitpluisde (die gewoon een bit-by-bit kopie bleek te zijn van de gegevens van de tape die ik al had, met uitzondering van de header met de aanwezigheid van een synchronisatiebyte), heb ik een paar wijzigingen in mijn programma aangebracht en kon ik een werkend CAS-bestand genereren dat in de emulator (TRS-80 Model III) werkte:
De laatste versie van het hulpprogramma voor conversie met automatische detectie van de eerste puls en afstand tussen referentiepulsen heb ik gemaakt als een GEM-pakket, de broncode is beschikbaar op .
Conclusie
De weg die ik heb afgelegd bleek een fascinerende reis in het verleden te zijn en ik ben blij dat ik uiteindelijk het mysterie heb ontrafeld. Verder heb ik:
- de indeling van het opslaan van gegevens in de ZX Spectrum begrepen en de in de firmware ingebouwde subroutines voor het opslaan/lezen van gegevens van audiocassettes bestudeerd
- me vertrouwd gemaakt met de TRS-80 computer en zijn varianten, het besturingssysteem bestudeerd, voorbeelden van programma's bekeken en zelfs de kans gehad om debugging in machinecode te doen (de mnemonic van de Z80 zijn me tenslotte goed bekend)
- Ik heb een volledige tool geschreven voor het converteren van audio-opnamen naar het CAS-formaat, die gegevens kan lezen die niet door de "officiële" tool worden herkend.
Bron: habr.com
