

Monitoring is becoming an increasingly important component of growing cloud solutions as distributed systems become more complex. It is essential for understanding their behavior. Scalable tools are needed to collect data from all services and provide specialists with a unified interface for performance analysis, error demonstration, availability, and logs.
These tools must also be effective and efficient. In this article, we will explore two popular technology stacks: EFK (Elasticsearch) and PLG (Loki), and examine their architectures and differences.
EFK stack
You may have already heard of the well-known ELK or EFK. The stack consists of several distinct parts: Elasticsearch (object storage), Logstash or FluentD (log collection and aggregation), and Kibana for visualization.
A typical workflow looks like this:
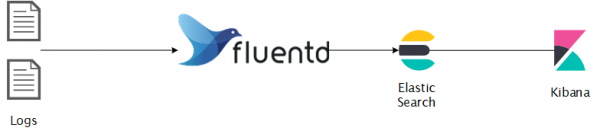
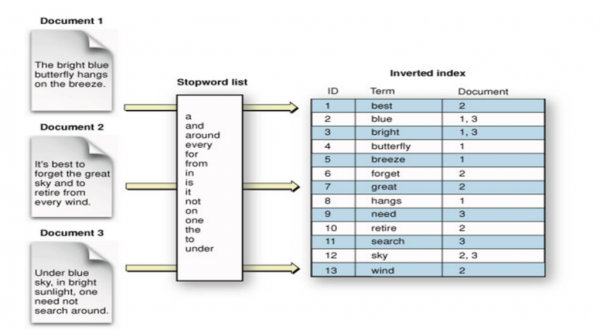
Elasticsearch — a distributed object storage with real-time search and analytics. An excellent solution for semi-structured data, such as logs. Information is stored as JSON documents, indexed in real-time, and distributed across the nodes of the cluster. An inverted index is used, containing all unique words and their associated documents for full-text search, which is based on the Apache Lucene search engine.
FluentD — is a data collector that performs data unification upon collection and consumption. It aims to structure data in JSON format as much as possible. Its architecture is extensible, and there are more than , supported by the community, for all kinds of scenarios.
Kibana — a data visualization tool for Elasticsearch with various additional features, such as time series analysis, graphing, machine learning, and more.
Elasticsearch Architecture
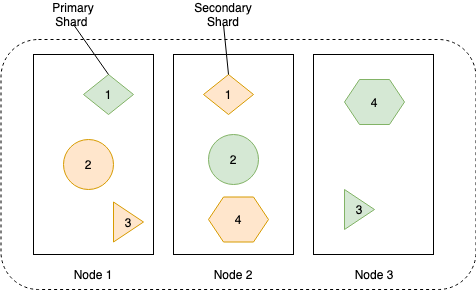
Data in the Elasticsearch cluster is stored spread across all its nodes. The cluster consists of multiple nodes to improve availability and resilience. Any node can perform all cluster roles, but in large scalable deployments, nodes are typically assigned specific tasks.
Cluster node types:
- master node — manages the cluster; a minimum of three is needed, with one always active;
- data node — stores indexed data and performs various tasks with it;
- ingest node — organiseert pijpleidingen voor het transformeren van gegevens vóór indexatie;
- coordinating node — routering van verzoeken, verkorting van de zoekverwerking, coördinatie van grootschalige indexatie;
- alerting node — start taken voor notificaties;
- machine learning node — verwerking van machine learning-taken.
In de onderstaande diagram wordt getoond hoe gegevens worden opgeslagen en gerepliceerd over nodes voor een hogere beschikbaarheid van gegevens.
Gegevens van elke replica worden opgeslagen in een omgekeerde index, het schema hieronder toont hoe dit gebeurt:
Installatie
Details zijn te bekijken , ik ga helm chart gebruiken:
$ helm install efk-stack stable/elastic-stack --set logstash.enabled=false --set fluentd.enabled=true --set fluentd-elasticsPLG-stack
Het is niet verwonderlijk als je deze acroniem niet kunt vinden, want het staat beter bekend als Grafana Loki. Hoe dan ook, deze stack wint aan populariteit omdat het zorgvuldig geselecteerde technische oplossingen toepast. Je hebt misschien al gehoord van Grafana, een populaire visualisatietool. De makers ervan, geïnspireerd door Prometheus, ontwikkelden Loki, een horizontaal schaalbare, hoogpresterende systeem voor logaggregatie. Loki indexeert alleen metadata, maar niet de logs zelf; deze technische oplossing maakte het eenvoudig te gebruiken en kosteneffectief.
Promtail — agent voor het verzenden van logs vanuit het besturingssysteem naar de Loki-cluster. Grafana — visualisatietool gebaseerd op gegevens van Loki.
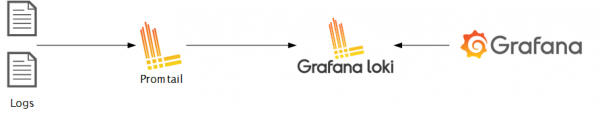
Loki is gebouwd op dezelfde principes als Prometheus, waardoor het goed geschikt is voor het opslaan en analyseren van Kubernetes-logs.
Architectuur van Loki
Loki kan zowel in één procesmodus als in meerdere processen worden uitgevoerd, waardoor horizontale schaalbaarheid wordt gegarandeerd.
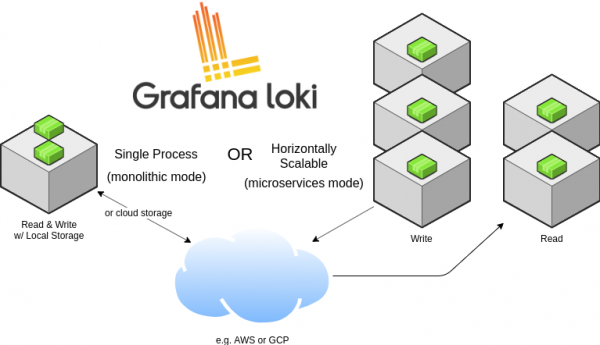
Het kan ook functioneren als een monolithische applicatie of als een microservice. Het uitvoeren in één proces kan nuttig zijn voor lokale ontwikkeling of voor kleinere monitoring. Voor industriële implementatie en schaalbare belasting wordt de microservice-optie aanbevolen. De paden voor het schrijven en lezen van gegevens zijn gescheiden, zodat het vrij nauwkeurig kan worden aangepast en geschaald indien nodig.
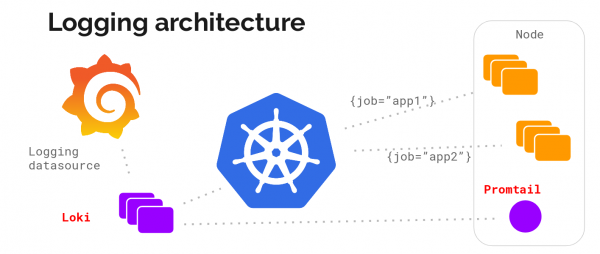
Laten we kijken naar de architectuur van het logverzamelingssysteem zonder in detail te treden:
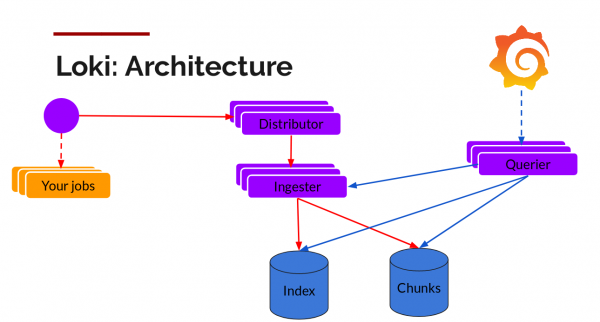
En hier is een beschrijving (microservice-architectuur):
Onderdelen:
Promtail — agent, geïnstalleerd op knooppunten (in de vorm van een set services), haalt logs uit taken en roept de API van Kubernetes aan om metadata te verkrijgen, waarmee de logs zullen worden gemarkeerd. Vervolgens verzendt het de log naar de belangrijkste service Loki. Voor het koppelen van metadata worden dezelfde regels voor labeling ondersteund als in Prometheus.
Distributor — service-distributeur, die fungeert als buffer. Voor het verwerken van miljoenen records verpakt het inkomende gegevens, waarbij het deze in blokken comprimeert naarmate ze binnenkomen. Meerdere data-ontvangers werken tegelijkertijd, maar logs die tot één stroom van inkomende gegevens behoren, moeten zich slechts in één van hen bevinden voor al zijn blokken. Dit is georganiseerd in de vorm van een ring van ontvangers en sequentieel hashen. Voor fouttolerantie en redundantie wordt dit n keer gedaan (3, als het niet geconfigureerd is).
Ingester — service-ontvanger. Datablokken komen gecomprimeerd binnen met toegevoegde logs. Zodra een blok groot genoeg is, wordt het blok naar de database geschreven. Metadata komt in de index, en gegevens van het logblok komen in Chunks (meestal objectopslag). Na het schrijven creëert de ontvanger een nieuw blok, waarin nieuwe records zullen worden toegevoegd.
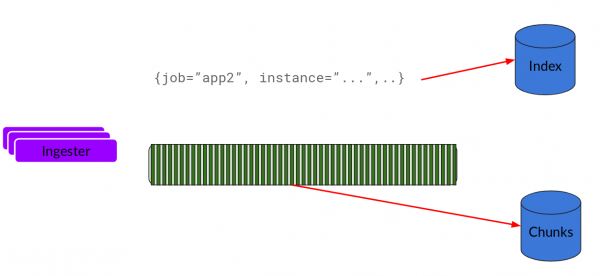
Index — database zoals DynamoDB, Cassandra, Google BigTable en meer.
Chunks — blokken logs in gecomprimeerde vorm, meestal opgeslagen in objectopslag, zoals S3.
Querier — leespad, dat al het zware werk doet. Het bekijkt het tijdsbereik en de labels, daarna bekijkt het de index voor overeenkomsten. Vervolgens leest het de datablokken en filtert deze om de resultaten te verkrijgen.
Laten we nu alles in actie bekijken.
Installatie
Voor installatie in Kubernetes is het het eenvoudigst om helm te gebruiken. We nemen aan dat je het al hebt geïnstalleerd en geconfigureerd ( opmerking van de vertaler)
Voeg de repository toe en installeer de stack.
$ helm repo add loki https://grafana.github.io/loki/charts
$ helm repo update
$ helm upgrade --install loki loki/loki-stack --set grafana.enabled=true,prometheus.enabled=true,prometheus.alertmanager.persistentVolume.enabled=false,prometheus.server.persistentVolume.enabled=false
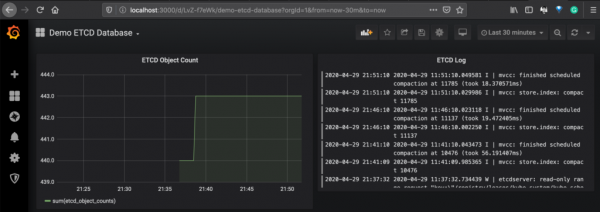
Hieronder is een voorbeeld van een dashboard dat gegevens uit Prometheus toont voor metrics van Etcd en Loki voor logs van Etcd-pods.
Laten we nu de architectuur van beide systemen bespreken en hun mogelijkheden met elkaar vergelijken.
Vergelijking
Querytaal
In Elasticsearch wordt de Query DSL en de Lucene query language gebruikt, die de mogelijkheid biedt voor full-text zoekopdrachten. Dit is een gevestigde krachtige zoekmachine met brede ondersteuning voor operators. Hiermee kun je contextueel zoeken en sorteren op relevantie.
Aan de andere kant van de ring is LogQL, dat wordt toegepast in Loki, de opvolger van PromQL (Prometheus query language). Het gebruikt loglabels om logs te filteren en te selecteren. Er is de mogelijkheid om enkele operators en reconstructies te gebruiken, zoals beschreven , maar qua mogelijkheden blijft het achter bij de Elastic-taal.
Aangezien de aanvragen in Loki verbonden zijn met labels, kunnen ze gemakkelijk worden gekoppeld aan metrics, waardoor ze eenvoudiger een operationele monitoring kunnen organiseren.
Schaalbaarheid
Beide stacks zijn horizontaal schaalbaar, maar bij Loki is dit eenvoudiger, omdat het lees- en schrijfprocessen van gegevens gescheiden zijn, en het een microservices-architectuur heeft. Loki kan worden geconfigureerd volgens uw behoeften en kan worden gebruikt voor zeer grote hoeveelheden loggegevens.
Multi-tenant
Multi-tenancy van de cluster is een algemeen thema voor het verminderen van OPEX; beide stacks bieden multi-tenancy. Voor Elasticsearch zijn er verschillende om klanten te scheiden: een aparte index voor elke klant, routering op basis van klant, unieke klantvelden, zoekfilters. In Loki is er in de vorm van de HTTP-header X-Scope-OrgID.
Cost
Loki is zeer kosteneffectief omdat het geen gegevens indexeert, maar alleen metadata. Hierdoor wordt er en geheugen (cache), aangezien objectopslag goedkoper is dan de blokopslag die wordt gebruikt in Elasticsearch-clusters.
Conclusie
De EFK-stack kan voor verschillende doeleinden worden gebruikt, waardoor maximale flexibiliteit en een multifunctionele interface in Kibana voor analytics, visualisaties en queries wordt geboden. Dit kan verder worden verbeterd met machine learning-functionaliteiten.
De Loki-stack is nuttig in het Kubernetes-ecosysteem vanwege het mechanisme voor het ontdekken van metadata. Gegevens voor tijdreeksmonitoring kunnen eenvoudig worden gekoppeld in Grafana en logs.
Als het gaat om kosten en langdurige opslag van logs, is Loki een uitstekende keuze voor toegang tot cloudoplossingen.
Er zijn meer alternatieven op de markt - sommige kunnen beter voor jou zijn. Bijvoorbeeld, voor GKE is er Stackdriver-integratie die een uitstekende oplossing biedt voor monitoring. We hebben ze niet in onze analyse in dit artikel opgenomen.
Links:
Dit artikel is vertaald en voorbereid voor Habr door medewerkers van — intensives, videocursussen en bedrijfsopleidingen van ervaren professionals (Kubernetes, DevOps, Docker, Ansible, Ceph, SRE, Agile)
Bron: habr.com
