

Beste lezers, goedemiddag. Vandaag gaan we het een beetje hebben over Apache Spark en de toekomst ervan.
In de moderne wereld van Big Data is Apache Spark de facto de standaard voor het ontwikkelen van batchverwerkingsoplossingen. Daarnaast wordt het ook gebruikt voor het creëren van streamingtoepassingen, die werken volgens het micro-batchconcept en gegevens in kleine porties verwerken en verzenden (Spark Structured Streaming). Traditioneel maakte het deel uit van de algemene Hadoop-stack, waarbij YARN als resource manager werd gebruikt (of in sommige gevallen Apache Mesos). Tegen 2020 staat het gebruik ervan in traditionele vorm voor de meeste bedrijven zwaar ter discussie vanwege het ontbreken van fatsoenlijke Hadoop-distributies — de ontwikkeling van HDP en CDH is gestopt, CDH is onvoldoende uitgewerkt en heeft hoge kosten, en andere Hadoop-leveranciers zijn ofwel gestopt met bestaan of hebben een onzekere toekomst. Daarom wekt de implementatie van Apache Spark via Kubernetes steeds meer interesse bij de gemeenschap en grote bedrijven — als standaard voor containerorkestratie en resource management in private en publieke cloudomgevingen, lost het de problemen op met het ongemakkelijke resourcebeheer van Spark-taken op YARN en biedt het een consistent evoluerend platform met tal van commerciële en open source-distributies voor bedrijven van alle soorten en maten. Bovendien heeft de populariteit ervoor gezorgd dat de meeste bedrijven al een paar eigen installaties hebben opgezet en expertise in zijn gebruik hebben opgebouwd, wat de overstap vereenvoudigt.
Vanaf versie 2.3.0 heeft Apache Spark officiële ondersteuning gekregen voor het uitvoeren van taken in een Kubernetes-cluster en vandaag gaan we het hebben over de huidige volwassenheid van deze aanpak, verschillende gebruiksmogelijkheden en de valkuilen waarmee men te maken krijgt bij de implementatie.
Laten we eerst het proces van het ontwikkelen van taken en applicaties op basis van Apache Spark bekijken en de typische gevallen benadrukken waarin het nodig is om een taak op een Kubernetes-cluster uit te voeren. Bij het voorbereiden van deze post wordt OpenShift gebruikt als distributie en worden de commando's gegeven die relevant zijn voor zijn commandoregelhulpmiddel (oc). Voor andere Kubernetes-distributies kunnen de betreffende commando's van de standaard Kubernetes-commandoregelhulpmiddel (kubectl) of hun tegenhangers (bijvoorbeeld voor oc adm policy) worden gebruikt.
De eerste gebruikswijze is spark-submit
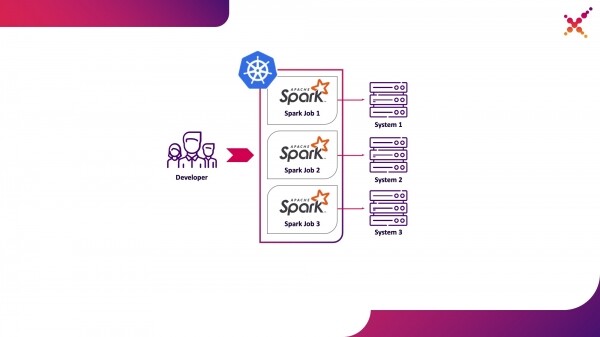
Tijdens de ontwikkeling van taken en applicaties moet de ontwikkelaar taken starten om datatransformaties te debuggen. In theorie kunnen voor deze doeleinden stubs worden gebruikt, maar de ontwikkeling met echte (ook al zijn het test-) instanties van de eindsystemen heeft in deze taakklasse bewezen sneller en van hogere kwaliteit te zijn. Wanneer we debuggen op echte instanties van eindsystemen, zijn er twee werkscenario's mogelijk:
- de ontwikkelaar start de Spark-taak lokaal in standalone modus;

- de ontwikkelaar start de Spark-taak in een Kubernetes-cluster in een testomgeving.
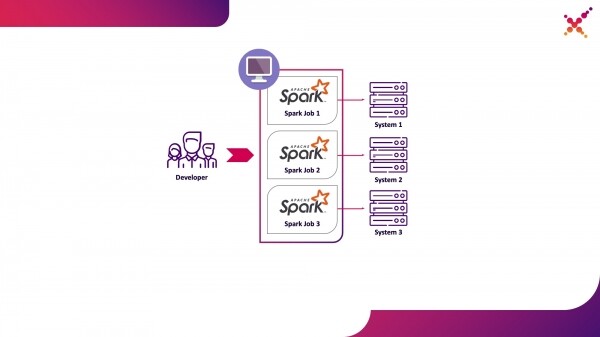
De eerste optie is valide, maar brengt een aantal nadelen met zich mee:
- voor elke ontwikkelaar moet toegang worden geboden van zijn werkplek tot alle noodzakelijke exemplaren van eindsystemen;
- er is voldoende middelen op de werkmachine nodig om de ontwikkelde taak uit te voeren.
De tweede optie heeft deze nadelen niet, omdat het gebruik van een Kubernetes-cluster het mogelijk maakt om de benodigde pool van middelen voor het draaien van taken toe te wijzen en ook de noodzakelijke toegangen tot de exemplaren van eindsystemen te bieden, waarbij toegang flexibel wordt verstrekt via het rolmodel van Kubernetes voor alle leden van het ontwikkelingsteam. We benoemen dit als de eerste gebruikswijze — het draaien van Spark-taken vanaf de lokale machine van de ontwikkelaar op een Kubernetes-cluster in een testomgeving.
Laten we dieper ingaan op het proces van het instellen van Spark voor lokale uitvoering. Om Spark te gebruiken, moet het worden geïnstalleerd:
mkdir /opt/spark
cd /opt/spark
wget http://mirror.linux-ia64.org/apache/spark/spark-2.4.5/spark-2.4.5.tgz
tar zxvf spark-2.4.5.tgz
rm -f spark-2.4.5.tgz
We verzamelen de noodzakelijke pakketten voor het werken met Kubernetes:
cd spark-2.4.5/
./build/mvn -Pkubernetes -DskipTests clean package
Een volledige build kost veel tijd, en voor het creëren van Docker-afbeeldingen en hun uitvoering op een Kubernetes-cluster zijn in werkelijkheid alleen de jar-bestanden uit de «assembly/»-directory nodig, daarom kan alleen dit subproject worden gebouwd:
./build/mvn -f ./assembly/pom.xml -Pkubernetes -DskipTests clean package
Voor het starten van Spark-taken in Kubernetes is het nodig om een Docker-afbeelding te maken die als basis wordt gebruikt. Hier zijn 2 benaderingen mogelijk:
- De gemaakte Docker-afbeelding bevat de uitvoerbare code van de Spark-taak.
- Het gemaakte beeld omvat alleen Spark en de benodigde afhankelijkheden, de uitvoerbare code wordt op afstand opgeslagen (bijvoorbeeld in HDFS).
Laten we beginnen met het bouwen van een Docker-image dat een testvoorbeeld van een Spark-taak bevat. Voor het maken van Docker-images heeft Spark een bijbehorende tool genaamd 'docker-image-tool'. Laten we de handleiding doornemen:
./bin/docker-image-tool.sh --help
Met deze tool kunnen Docker-images worden gemaakt en naar externe registers worden geüpload, maar standaard heeft het een aantal nadelen:
- het creëert altijd 3 Docker-images — voor Spark, PySpark en R;
- het laat niet toe om een image-naam op te geven.
Daarom zullen we een gemodificeerde versie van deze tool gebruiken, die hieronder wordt gegeven:
vi bin/docker-image-tool-upd.sh
#!/usr/bin/env bash

function error {
  echo "$@" 1>&2
  exit 1
}

if [ -z "${SPARK_HOME}" ]; then
  SPARK_HOME="$(cd "`dirname "$0"`"/..; pwd)"
fi
. "${SPARK_HOME}/bin/load-spark-env.sh"

function image_ref {
  local image="$1"
  local add_repo="${2:-1}"
  if [ $add_repo = 1 ] && [ -n "$REPO" ]; then
    image="$REPO/$image"
  fi
  if [ -n "$TAG" ]; then
    image="$image:$TAG"
  fi
  echo "$image"
}

function build {
  local BUILD_ARGS
  local IMG_PATH

  if [ ! -f "$SPARK_HOME/RELEASE" ]; then
    IMG_PATH=$BASEDOCKERFILE
    BUILD_ARGS=(
      ${BUILD_PARAMS}
      --build-arg
      img_path=$IMG_PATH
      --build-arg
      datagram_jars=datagram/runtimelibs
      --build-arg
      spark_jars=assembly/target/scala-$SPARK_SCALA_VERSION/jars
    )
  else
    IMG_PATH="kubernetes/dockerfiles"
    BUILD_ARGS=(${BUILD_PARAMS})
  fi

  if [ -z "$IMG_PATH" ]; then
    error "Cannot find docker image. This script must be run from a runnable distribution of Apache Spark."
  fi

  if [ -z "$IMAGE_REF" ]; then
    error "Cannot find docker image reference. Please add -i arg."
  fi

  local BINDING_BUILD_ARGS=(
    ${BUILD_PARAMS}
    --build-arg
    base_img=$(image_ref $IMAGE_REF)
  )
  local BASEDOCKERFILE=${BASEDOCKERFILE:-"$IMG_PATH/spark/docker/Dockerfile"}

  docker build $NOCACHEARG "${BUILD_ARGS[@]}"
    -t $(image_ref $IMAGE_REF)
    -f "$BASEDOCKERFILE" .
}

function push {
  docker push "$(image_ref $IMAGE_REF)"
}

function usage {
  cat <<EOF
Usage: $0 [options] [command]
Builds or pushes the built-in Spark Docker image.

Commands:
  build       Build image. Requires a repository address to be provided if the image will be
              pushed to a different registry.
  push        Push a pre-built image to a registry. Requires a repository address to be provided.

Options:
  -f file               Dockerfile to build for JVM based Jobs. By default builds the Dockerfile shipped with Spark.
  -p file               Dockerfile to build for PySpark Jobs. Builds Python dependencies and ships with Spark.
  -R file               Dockerfile to build for SparkR Jobs. Builds R dependencies and ships with Spark.
  -r repo               Repository address.
  -i name               Image name to apply to the built image, or to identify the image to be pushed.
  -t tag                Tag to apply to the built image, or to identify the image to be pushed.
  -m                    Use minikube's Docker daemon.
  -n                    Build docker image with --no-cache
  -b arg      Build arg to build or push the image. For multiple build args, this option needs to
              be used separately for each build arg.

Using minikube when building images will do so directly into minikube's Docker daemon.
There is no need to push the images into minikube in that case, they'll be automatically
available when running applications inside the minikube cluster.

Check the following documentation for more information on using the minikube Docker daemon:

  https://kubernetes.io/docs/getting-started-guides/minikube/#reusing-the-docker-daemon

Examples:
  - Build image in minikube with tag "testing"
    $0 -m -t testing build

  - Build and push image with tag "v2.3.0" to docker.io/myrepo
    $0 -r docker.io/myrepo -t v2.3.0 build
    $0 -r docker.io/myrepo -t v2.3.0 push
EOF
}

if [[ "$@" = *--help ]] || [[ "$@" = *-h ]]; then
  usage
  exit 0
fi

REPO=
TAG=
BASEDOCKERFILE=
NOCACHEARG=
BUILD_PARAMS=
IMAGE_REF=
while getopts f:mr:t:nb:i: option
do
 case "${option}"
 in
 f) BASEDOCKERFILE=${OPTARG};;
 r) REPO=${OPTARG};;
 t) TAG=${OPTARG};;
 n) NOCACHEARG="--no-cache";;
 i) IMAGE_REF=${OPTARG};;
 b) BUILD_PARAMS=${BUILD_PARAMS}" --build-arg "${OPTARG};;
 esac
done

case "${@: -1}" in
  build)
    build
    ;;
  push)
    if [ -z "$REPO" ]; then
      usage
      exit 1
    fi
    push
    ;;
  *)
    usage
    exit 1
    ;;
esac
Hiermee bouwen we een basis Spark-image dat een testtaak bevat voor het berekenen van het getal Pi met Spark (hierbij is {docker-registry-url} de URL van uw Docker-register, {repo} de naam van de repository binnen het register die overeenkomt met het project in OpenShift, {image-name} de naam van het image (als er een driedelige scheiding van images wordt gebruikt, bijvoorbeeld zoals in het geïntegreerde images register van Red Hat OpenShift), {tag} de tag van deze versie van het image):
./bin/docker-image-tool-upd.sh -f resource-managers/kubernetes/docker/src/main/dockerfiles/spark/Dockerfile -r {docker-registry-url}/{repo} -i {image-name} -t {tag} build
We loggen in op de OKD-cluster met behulp van de commandoregel tool (hierbij is {OKD-API-URL} de URL van de API van de OKD-cluster):
oc login {OKD-API-URL}
We krijgen het token van de huidige gebruiker voor autorisatie in de Docker Registry:
oc whoami -t
We loggen in op de interne Docker Registry van de OKD-cluster (gebruik het token, verkregen met de vorige opdracht, als wachtwoord):
docker login {docker-registry-url}
We uploaden het gebouwde Docker-image naar de OKD Docker Registry:
./bin/docker-image-tool-upd.sh -r {docker-registry-url}/{repo} -i {image-name} -t {tag} push
Laten we controleren of het gebouwde image beschikbaar is in OKD. Om dit te doen, openen we in de browser de URL met de lijst van images van het betreffende project (hierbij is {project} de naam van het project binnen de OpenShift-cluster, {OKD-WEBUI-URL} de URL van de OpenShift-webconsole) — https://{OKD-WEBUI-URL}/console/project/{project}/browse/images/{image-name}.
Voor het uitvoeren van taken moet er een serviceaccount worden aangemaakt met de bevoegdheid om pods als root te starten (we zullen dit punt later bespreken):
oc create sa spark -n {project}
oc adm policy add-scc-to-user anyuid -z spark -n {project}
We voeren de spark-submit-opdracht uit om de Spark-taak in de OKD-cluster te publiceren, waarbij we het aangemaakte serviceaccount en het Docker-image opgeven:
/opt/spark/bin/spark-submit --name spark-test --class org.apache.spark.examples.SparkPi --conf spark.executor.instances=3 --conf spark.kubernetes.authenticate.driver.serviceAccountName=spark --conf spark.kubernetes.namespace={project} --conf spark.submit.deployMode=cluster --conf spark.kubernetes.container.image={docker-registry-url}/{repo}/{image-name}:{tag} --conf spark.master=k8s://https://{OKD-API-URL} local:///opt/spark/examples/target/scala-2.11/jars/spark-examples_2.11-2.4.5.jar
Hier:
--name — de naam van de taak, die zal bijdragen aan het genereren van de namen van de Kubernetes-pods;
—class — de klasse van het uitvoerbare bestand dat wordt aangeroepen bij het starten van de taak;
—conf — configuratieparameters van Spark;
spark.executor.instances — het aantal opstartende Spark-executors;
spark.kubernetes.authenticate.driver.serviceAccountName — de naam van de Kubernetes-serviceaccount die wordt gebruikt bij het starten van pods (voor het bepalen van de beveiligingscontext en mogelijkheden bij interactie met de Kubernetes API);
spark.kubernetes.namespace — de Kubernetes-namespace waarin de pods van de driver en executors zullen worden uitgevoerd;
spark.submit.deployMode — de manier van het starten van Spark (voor de standaard spark-submit wordt 'cluster' gebruikt, voor Spark Operator en latere versies van Spark 'client');
spark.kubernetes.container.image — de Docker-afbeelding die wordt gebruikt om de pods te starten;
spark.master — de URL van de Kubernetes API (dit wordt extern opgegeven wanneer verbinding wordt gemaakt vanaf de lokale machine);
local:// — pad naar het uitvoerbare bestand van Spark binnen de Docker-afbeelding.
Ga naar het desbetreffende OKD-project en bekijk de gemaakte pods — https://{OKD-WEBUI-URL}/console/project/{project}/browse/pods.
Voor het vereenvoudigen van het ontwikkelingsproces kan nog een andere optie worden gebruikt, waarbij een gemeenschappelijke basisafbeelding van Spark wordt gemaakt, die door alle taken wordt gebruikt voor uitvoering, en snapshots van uitvoerbare bestanden worden gepubliceerd in een externe opslag (bijvoorbeeld Hadoop) en worden opgegeven bij het aanroepen van spark-submit als links. In dit geval kunnen verschillende versies van Spark-taken worden uitgevoerd zonder de Docker-afbeeldingen opnieuw te bouwen, met het publiceren van afbeeldingen via bijvoorbeeld WebHDFS. We sturen een aanvraag om een bestand te maken (hier {host} — de host van de WebHDFS-service, {port} — de poort van de WebHDFS-service, {path-to-file-on-hdfs} — het gewenste pad naar het bestand op HDFS):
curl -i -X PUT "http://{host}:{port}/webhdfs/v1/{path-to-file-on-hdfs}?op=CREATE
Hierbij wordt een antwoord verkregen van de vorm (hier {location} — de URL die moet worden gebruikt voor het uploaden van het bestand):
HTTP/1.1 307 TEMPORARY_REDIRECT
Location: {location}
Content-Length: 0
Upload het uitvoerbare bestand van Spark naar HDFS (hier {path-to-local-file} — het pad naar het uitvoerbare bestand van Spark op de huidige host):
curl -i -X PUT -T {path-to-local-file} "{location}"
Daarna kunnen we spark-submit uitvoeren met het bestand van Spark dat naar HDFS is geüpload (hier {class-name} — de naam van de klasse die moet worden uitgevoerd voor de taak):
/opt/spark/bin/spark-submit --name spark-test --class {class-name} --conf spark.executor.instances=3 --conf spark.kubernetes.authenticate.driver.serviceAccountName=spark --conf spark.kubernetes.namespace={project} --conf spark.submit.deployMode=cluster --conf spark.kubernetes.container.image={docker-registry-url}/{repo}/{image-name}:{tag} --conf spark.master=k8s://https://{OKD-API-URL} hdfs://{host}:{port}/{path-to-file-on-hdfs}
Hierbij moet worden opgemerkt dat voor toegang tot HDFS en het waarborgen van de werking van de taak mogelijk wijzigingen in de Dockerfile en het entrypoint.sh-script nodig zijn — voeg een richtlijn toe aan de Dockerfile om de afhankelijkheidsbibliotheken naar de map /opt/spark/jars te kopiëren en voeg het configuratiebestand van HDFS toe aan SPARK_CLASSPATH in entrypoint.sh.
De tweede gebruiksmethode is Apache Livy
Wanneer de taak is ontwikkeld en het resultaat moet worden getest, rijst de vraag over het starten ervan binnen het CI/CD-proces en het volgen van de uitvoeringsstatussen. Natuurlijk kan het worden gestart met behulp van een lokale oproep via spark-submit, maar dit maakt de CI/CD-infrastructuur complexer, omdat het installatie en configuratie van Spark op de CI-serveragents/runners vereist en toegangsinstellingen voor de Kubernetes API. In dit geval is ervoor gekozen om Apache Livy te gebruiken als REST API voor het starten van Spark-taken, gehost binnen een Kubernetes-cluster. Hiermee kunnen Spark-taken op het Kubernetes-cluster worden gestart met behulp van gewone cURL-oproepen, wat gemakkelijk implementeerbaar is op elk CI-oplossing, en het plaatsen binnen het Kubernetes-cluster lost het authenticatieprobleem op bij interactie met de Kubernetes API.
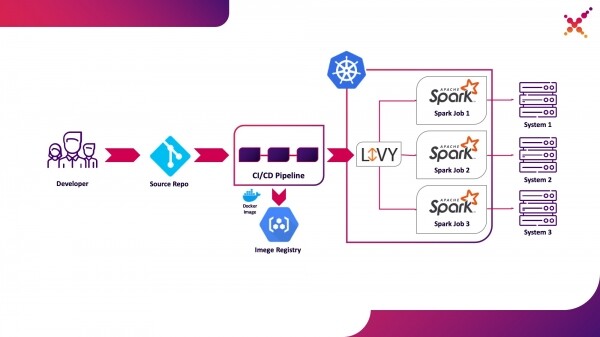
Laten we dit als de tweede gebruiksmethode benadrukken — het starten van Spark-taken binnen het CI/CD-proces op een Kubernetes-cluster in een testomgeving.
Een beetje over Apache Livy — het fungeert als een HTTP-server die een webinterface en RESTful API biedt waarmee spark-submit op afstand kan worden gestart met de benodigde parameters. Traditioneel werd het geleverd als onderdeel van de HDP-distributie, maar het kan ook worden uitgerold in OKD of elke andere Kubernetes-installatie met behulp van het juiste manifest en een set Docker-images, bijvoorbeeld deze — . Voor onze situatie is een vergelijkbare Docker-image samengesteld, inclusief Spark versie 2.4.5 uit de volgende Dockerfile:
FROM java:8-alpine

ENV SPARK_HOME=/opt/spark
ENV LIVY_HOME=/opt/livy
ENV HADOOP_CONF_DIR=/etc/hadoop/conf
ENV SPARK_USER=spark

WORKDIR /opt

RUN apk add --update openssl wget bash &&
    wget -P /opt https://downloads.apache.org/spark/spark-2.4.5/spark-2.4.5-bin-hadoop2.7.tgz &&
    tar xvzf spark-2.4.5-bin-hadoop2.7.tgz &&
    rm spark-2.4.5-bin-hadoop2.7.tgz &&
    ln -s /opt/spark-2.4.5-bin-hadoop2.7 /opt/spark

RUN wget http://mirror.its.dal.ca/apache/incubator/livy/0.7.0-incubating/apache-livy-0.7.0-incubating-bin.zip &&
    unzip apache-livy-0.7.0-incubating-bin.zip &&
    rm apache-livy-0.7.0-incubating-bin.zip &&
    ln -s /opt/apache-livy-0.7.0-incubating-bin /opt/livy &&
    mkdir /var/log/livy &&
    ln -s /var/log/livy /opt/livy/logs &&
    cp /opt/livy/conf/log4j.properties.template /opt/livy/conf/log4j.properties

ADD livy.conf /opt/livy/conf
ADD spark-defaults.conf /opt/spark/conf/spark-defaults.conf
ADD entrypoint.sh /entrypoint.sh

ENV PATH="/opt/livy/bin:${PATH}"

EXPOSE 8998

ENTRYPOINT ["/entrypoint.sh"]
CMD ["livy-server"]
De gemaakte afbeelding kan worden samengesteld en geüpload naar uw bestaande Docker-repository, zoals de interne OKD-repository. Voor de uitrol wordt het volgende manifest gebruikt ({registry-url} - URL van de Docker-image registry, {image-name} - naam van de Docker-image, {tag} - tag van de Docker-image, {livy-url} - gewenste URL waar de Livy-server beschikbaar zal zijn; het manifest "Route" wordt toegepast als Red Hat OpenShift als Kubernetes-distributie wordt gebruikt, anders wordt het bijbehorende Ingress- of NodePort-service manifest gebruikt):
---
apiVersion: apps/v1
kind: Deployment
metadata:
  labels:
    component: livy
  name: livy
spec:
  progressDeadlineSeconds: 600
  replicas: 1
  revisionHistoryLimit: 10
  selector:
    matchLabels:
      component: livy
  strategy:
    rollingUpdate:
      maxSurge: 25%
      maxUnavailable: 25%
    type: RollingUpdate
  template:
    metadata:
      creationTimestamp: null
      labels:
        component: livy
    spec:
      containers:
        - command:
            - livy-server
          env:
            - name: K8S_API_HOST
              value: localhost
            - name: SPARK_KUBERNETES_IMAGE
              value: 'gnut3ll4/spark:v1.0.14'
          image: '{registry-url}/{image-name}:{tag}'
          imagePullPolicy: Always
          name: livy
          ports:
            - containerPort: 8998
              name: livy-rest
              protocol: TCP
          resources: {}
          terminationMessagePath: /dev/termination-log
          terminationMessagePolicy: File
          volumeMounts:
            - mountPath: /var/log/livy
              name: livy-log
            - mountPath: /opt/.livy-sessions/
              name: livy-sessions
            - mountPath: /opt/livy/conf/livy.conf
              name: livy-config
              subPath: livy.conf
            - mountPath: /opt/spark/conf/spark-defaults.conf
              name: spark-config
              subPath: spark-defaults.conf
        - command:
            - /usr/local/bin/kubectl
            - proxy
            - '--port'
            - '8443'
          image: 'gnut3ll4/kubectl-sidecar:latest'
          imagePullPolicy: Always
          name: kubectl
          ports:
            - containerPort: 8443
              name: k8s-api
              protocol: TCP
          resources: {}
          terminationMessagePath: /dev/termination-log
          terminationMessagePolicy: File
      dnsPolicy: ClusterFirst
      restartPolicy: Always
      schedulerName: default-scheduler
      securityContext: {}
      serviceAccount: spark
      serviceAccountName: spark
      terminationGracePeriodSeconds: 30
      volumes:
        - emptyDir: {}
          name: livy-log
        - emptyDir: {}
          name: livy-sessions
        - configMap:
            defaultMode: 420
            items:
              - key: livy.conf
                path: livy.conf
            name: livy-config
          name: livy-config
        - configMap:
            defaultMode: 420
            items:
              - key: spark-defaults.conf
                path: spark-defaults.conf
            name: livy-config
          name: spark-config
---
apiVersion: v1
kind: ConfigMap
metadata:
  name: livy-config
data:
  livy.conf: |-
    livy.spark.deploy-mode=cluster
    livy.file.local-dir-whitelist=/opt/.livy-sessions/
    livy.spark.master=k8s://http://localhost:8443
    livy.server.session.state-retain.sec = 8h
  spark-defaults.conf: 'spark.kubernetes.container.image        "gnut3ll4/spark:v1.0.14"'
---
apiVersion: v1
kind: Service
metadata:
  labels:
    app: livy
  name: livy
spec:
  ports:
    - name: livy-rest
      port: 8998
      protocol: TCP
      targetPort: 8998
  selector:
    component: livy
  sessionAffinity: None
  type: ClusterIP
---
apiVersion: route.openshift.io/v1
kind: Route
metadata:
  labels:
    app: livy
  name: livy
spec:
  host: {livy-url}
  port:
    targetPort: livy-rest
  to:
    kind: Service
    name: livy
    weight: 100
  wildcardPolicy: None
Na de implementatie en succesvolle lancering van de pod is de grafische interface van Livy toegankelijk via de link: http://{livy-url}/ui. Met Livy kunnen we onze Spark-taak publiceren via een REST-aanroep, bijvoorbeeld vanuit Postman. Een voorbeeldcollectie met verzoeken wordt hieronder weergegeven (in de array «args» kunnen configuratie-argumenten met variabelen voor de uitvoering van de taak worden doorgegeven):
{
    "info": {
        "_postman_id": "be135198-d2ff-47b6-a33e-0d27b9dba4c8",
        "name": "Spark Livy",
        "schema": "https://schema.getpostman.com/json/collection/v2.1.0/collection.json"
    },
    "item": [
        {
            "name": "1 Indienen van een taak met jar",
            "request": {
                "method": "POST",
                "header": [
                    {
                        "key": "Content-Type",
                        "value": "application/json"
                    }
                ],
                "body": {
                    "mode": "raw",
                    "raw": "{nt\"file\": \"local://opt/spark/examples/target/scala-2.11/jars/spark-examples_2.11-2.4.5.jar\", nt\"className\": \"org.apache.spark.examples.SparkPi\",nt\"numExecutors\":1,nt\"name\": \"spark-test-1\",nt\"conf\": {ntt\"spark.jars.ivy\": \"/tmp/.ivy\",ntt\"spark.kubernetes.authenticate.driver.serviceAccountName\": \"spark\",ntt\"spark.kubernetes.namespace\": \"{project}\",ntt\"spark.kubernetes.container.image\": \"{docker-registry-url}/{repo}/{image-name}:{tag}\"nt}n}"
                },
                "url": {
                    "raw": "http://{livy-url}/batches",
                    "protocol": "http",
                    "host": [
                        "{livy-url}"
                    ],
                    "path": [
                        "batches"
                    ]
                }
            },
            "response": []
        },
        {
            "name": "2 Indienen van een taak zonder jar",
            "request": {
                "method": "POST",
                "header": [
                    {
                        "key": "Content-Type",
                        "value": "application/json"
                    }
                ],
                "body": {
                    "mode": "raw",
                    "raw": "{nt\"file\": \"hdfs://{host}:{port}/{path-to-file-on-hdfs}\", nt\"className\": \"{class-name}\",nt\"numExecutors\":1,nt\"name\": \"spark-test-2\",nt\"proxyUser\": \"0\",nt\"conf\": {ntt\"spark.jars.ivy\": \"/tmp/.ivy\",ntt\"spark.kubernetes.authenticate.driver.serviceAccountName\": \"spark\",ntt\"spark.kubernetes.namespace\": \"{project}\",ntt\"spark.kubernetes.container.image\": \"{docker-registry-url}/{repo}/{image-name}:{tag}\"nt},nt\"args\": [ntt\"HADOOP_CONF_DIR=/opt/spark/hadoop-conf\",ntt\"MASTER=k8s://https://kubernetes.default.svc:8443\"nt]n}"
                },
                "url": {
                    "raw": "http://{livy-url}/batches",
                    "protocol": "http",
                    "host": [
                        "{livy-url}"
                    ],
                    "path": [
                        "batches"
                    ]
                }
            },
            "response": []
        }
    ],
    "event": [
        {
            "listen": "prerequest",
            "script": {
                "id": "41bea1d0-278c-40c9-ad42-bf2e6268897d",
                "type": "text/javascript",
                "exec": [
                    ""
                ]
            }
        },
        {
            "listen": "test",
            "script": {
                "id": "3cdd7736-a885-4a2d-9668-bd75798f4560",
                "type": "text/javascript",
                "exec": [
                    ""
                ]
            }
        }
    ],
    "protocolProfileBehavior": {}
}
We zullen de eerste aanvraag uit de collectie uitvoeren, naar de OKD-interface gaan en controleren of de taak succesvol is gestart — https://{OKD-WEBUI-URL}/console/project/{project}/browse/pods. In de Livy-interface (http://{livy-url}/ui) verschijnt een sessie waarin je met behulp van de Livy API of de grafische interface de voortgang van de taak kunt volgen en de sessielogs kunt bekijken.
Laten we nu het werkmechanisme van Livy laten zien. Hiervoor bestuderen we de logs van de Livy-container binnen de pod met de Livy-server — https://{OKD-WEBUI-URL}/console/project/{project}/browse/pods/{livy-pod-name}?tab=logs. Hieruit blijkt dat bij het aanroepen van de Livy REST API in de container met de naam 'livy' de spark-submit wordt uitgevoerd, vergelijkbaar met wat we hierboven hebben gebruikt (waarbij {livy-pod-name} de naam is van de gemaakte pod met de Livy-server). In de collectie is ook een tweede verzoek opgenomen, waarmee taken kunnen worden uitgevoerd met een extern gehosted uitvoerbaar bestand van Spark via de Livy-server.
De derde gebruiksmogelijkheid — Spark Operator
Nu de taak is getest, rijst de vraag naar de reguliere uitvoering ervan. De native manier voor het regelmatig uitvoeren van taken in een Kubernetes-cluster is de CronJob-entiteit, en deze kan gebruikt worden. Maar op dit moment is het gebruik van operators voor applicatiebeheer in Kubernetes erg populair, en er bestaat een vrij volwassen operator voor Spark, die ook wordt gebruikt in Enterprise-oplossingen (bijvoorbeeld Lightbend FastData Platform). We raden aan om deze te gebruiken — de huidige stabiele versie van Spark (2.4.5) heeft vrij beperkte configuratiemogelijkheden voor het starten van Spark-taken in Kubernetes, terwijl in de volgende grote versie (3.0.0) volledige ondersteuning voor Kubernetes wordt aangekondigd, maar de releasedatum is nog onbekend. De Spark Operator compenseert dit gebrek door belangrijke configuratieparameters toe te voegen (bijvoorbeeld het monteren van ConfigMap met de toegangsc configuratie voor Hadoop in de Spark-pods) en de mogelijkheid om taken op schema regelmatig te starten.
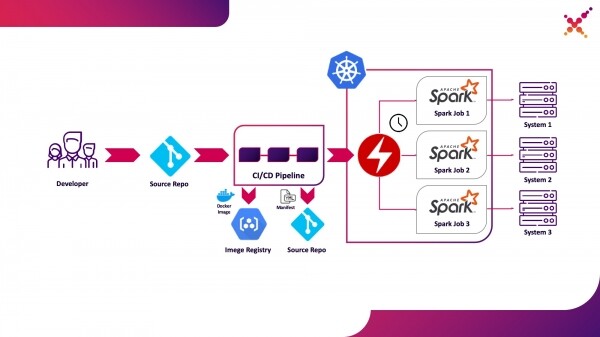
We onderscheiden dit als de derde gebruiksmogelijkheid — de reguliere uitvoering van Spark-taken in een Kubernetes-cluster in een productieomgeving.
Spark Operator heeft open source-code en wordt ontwikkeld in het kader van Google Cloud Platform — . De installatie kan op 3 manieren worden uitgevoerd:
- Binnen de installatie van Lightbend FastData Platform/Cloudflow;
- Met behulp van Helm:
helm repo add incubator http://storage.googleapis.com/kubernetes-charts-incubator helm install incubator/sparkoperator --namespace spark-operator - Door gebruik te maken van manifesten uit de officiële repository (https://github.com/GoogleCloudPlatform/spark-on-k8s-operator/tree/master/manifest), dient men het volgende op te merken: de Cloudflow omvat een operator met API-versie v1beta1. Als dit installatie type wordt gebruikt, moeten de beschrijvingen van de Spark-applicatiemanifesten zijn gebaseerd op voorbeelden in de tags in Git met de bijbehorende API-versie, bijvoorbeeld "v1beta1-0.9.0-2.4.0". De versies van de operator kunnen worden bekeken in de beschrijving van de CRD in de woordenlijst "versions":
oc get crd sparkapplications.sparkoperator.k8s.io -o yaml
Als de operator correct is geïnstalleerd, verschijnt er een actieve pod met de Spark-operator in het bijbehorende project (bijvoorbeeld cloudflow-fdp-sparkoperator in de Cloudflow-ruimte voor de Cloudflow-installatie) en zal het bijbehorende type Kubernetes-bronnen met de naam "sparkapplications" worden weergegeven. Bestaande Spark-applicaties kunnen worden bekeken met de volgende opdracht:
oc get sparkapplications -n {project}
Om taken uit te voeren met de Spark Operator, moeten er 3 dingen worden gedaan:
- een Docker-image maken die alle benodigde libraries en configuratie- en uitvoerbestanden bevat. In de doelstelling is dit het image dat is gemaakt in de CI/CD-fase en getest op het testcluster;
- de Docker-image publiceren naar een register dat toegankelijk is vanuit het Kubernetes-cluster;
- een manifest opstellen van het type "SparkApplication" en een beschrijving van de uit te voeren taak. Voorbeelden van manifesten zijn beschikbaar in de officiële repository (bijvoorbeeld, ). Het is belangrijk om enkele punten met betrekking tot het manifest op te merken:
- in het woordenboek "apiVersion" moet de API-versie worden opgegeven die overeenkomt met de versie van de operator;
- in het woordenboek "metadata.namespace" moet de naamruimte worden opgegeven waarin de applicatie zal worden uitgevoerd;
- in het woordenboek "spec.image" moet het adres van de gemaakte Docker-image in het beschikbare register worden opgegeven;
- in het woordenboek "spec.mainClass" moet de Spark-taakklasse worden opgegeven die moet worden uitgevoerd tijdens het opstarten van het proces;
- in het woordenboek "spec.mainApplicationFile" moet het pad naar het uitvoerbare jar-bestand worden opgegeven;
- in het woordenboek "spec.sparkVersion" moet de gebruikte versie van Spark worden opgegeven;
- in het woordenboek "spec.driver.serviceAccount" moet de serviceaccount binnen de bijbehorende Kubernetes-naamruimte worden opgegeven die zal worden gebruikt voor het uitvoeren van de applicatie;
- in het woordenboek "spec.executor" moet het aantal resources worden opgegeven dat aan de applicatie is toegewezen;
- In het woordenboek «spec.volumeMounts» moet de lokale directory worden aangegeven waarin de lokale bestanden van de Spark-taak worden aangemaakt.
Voorbeeld van het opstellen van een manifest (hier is {spark-service-account} het service-account binnen de Kubernetes-cluster voor het uitvoeren van Spark-taken):
apiVersion: "sparkoperator.k8s.io/v1beta1"
kind: SparkApplication
metadata:
  name: spark-pi
  namespace: {project}
spec:
  type: Scala
  mode: cluster
  image: "gcr.io/spark-operator/spark:v2.4.0"
  imagePullPolicy: Always
  mainClass: org.apache.spark.examples.SparkPi
  mainApplicationFile: "local:///opt/spark/examples/jars/spark-examples_2.11-2.4.0.jar"
  sparkVersion: "2.4.0"
  restartPolicy:
    type: Never
  volumes:
    - name: "test-volume"
      hostPath:
        path: "/tmp"
        type: Directory
  driver:
    cores: 0.1
    coreLimit: "200m"
    memory: "512m"
    labels:
      version: 2.4.0
    serviceAccount: {spark-service-account}
    volumeMounts:
      - name: "test-volume"
        mountPath: "/tmp"
  executor:
    cores: 1
    instances: 1
    memory: "512m"
    labels:
      version: 2.4.0
    volumeMounts:
      - name: "test-volume"
        mountPath: "/tmp"
In dit manifest wordt het service-account aangegeven waarvoor voorafgaand aan de publicatie van het manifest de benodigde rolbindingen moeten worden aangemaakt, die de noodzakelijke toegangsrechten bieden voor de interactie van de Spark-applicatie met de Kubernetes API (indien nodig). In ons geval heeft de applicatie rechten nodig om Pods te maken. Laten we de benodigde rolbinding creëren:
oc adm policy add-role-to-user edit system:serviceaccount:{project}:{spark-service-account} -n {project}
Het is ook vermeldenswaard dat in de specificatie van dit manifest de parameter «hadoopConfigMap» kan worden opgegeven, waarmee een ConfigMap met Hadoop-configuratie kan worden aangegeven, zonder dat het bijbehorende bestand vooraf in het Docker-image hoeft te worden geplaatst. Het is ook geschikt voor het regelmatig uitvoeren van taken - met de parameter «schedule» kan een tijdschema voor het uitvoeren van deze taak worden opgegeven.
Daarna slaan we ons manifest op in het bestand spark-pi.yaml en passen we het toe op onze Kubernetes-cluster:
oc apply -f spark-pi.yaml
Hierdoor wordt een object van het type «sparkapplications» aangemaakt:
oc get sparkapplications -n {project}
> NAME       AGE
> spark-pi   22h
Hierdoor wordt een pod met de applicatie aangemaakt, waarvan de status wordt weergegeven in de aangemaakte «sparkapplications». Dit kan met de volgende opdracht worden bekeken:
oc get sparkapplications spark-pi -o yaml -n {project}
Na het voltooien van de taak zal de POD overgaan in de status «Completed», die ook wordt bijgewerkt in de «sparkapplications». De logs van de applicatie kunnen in de browser of met de volgende opdracht worden bekeken (hier is {sparkapplications-pod-name} de naam van de pod van de uitgevoerde taak):
oc logs {sparkapplications-pod-name} -n {project}
Het beheren van Spark-taken kan ook gedaan worden met een gespecialiseerde tool genaamd sparkctl. Voor de installatie klonen we de repository met de broncode, installeren we Go en bouwen we deze tool:
git clone https://github.com/GoogleCloudPlatform/spark-on-k8s-operator.git
cd spark-on-k8s-operator/
wget https://dl.google.com/go/go1.13.3.linux-amd64.tar.gz
tar -xzf go1.13.3.linux-amd64.tar.gz
sudo mv go /usr/local
mkdir $HOME/Projects
export GOROOT=/usr/local/go
export GOPATH=$HOME/Projects
export PATH=$GOPATH/bin:$GOROOT/bin:$PATH
go -version
cd sparkctl
go build -o sparkctl
sudo mv sparkctl /usr/local/bin
Laten we de lijst met actieve Spark-taken bekijken:
sparkctl list -n {project}
Laten we een beschrijving voor een Spark-taak maken:
vi spark-app.yaml
apiVersion: "sparkoperator.k8s.io/v1beta1"
kind: SparkApplication
metadata:
  name: spark-pi
  namespace: {project}
spec:
  type: Scala
  mode: cluster
  image: "gcr.io/spark-operator/spark:v2.4.0"
  imagePullPolicy: Always
  mainClass: org.apache.spark.examples.SparkPi
  mainApplicationFile: "local:///opt/spark/examples/jars/spark-examples_2.11-2.4.0.jar"
  sparkVersion: "2.4.0"
  restartPolicy:
    type: Never
  volumes:
    - name: "test-volume"
      hostPath:
        path: "/tmp"
        type: Directory
  driver:
    cores: 1
    coreLimit: "1000m"
    memory: "512m"
    labels:
      version: 2.4.0
    serviceAccount: spark
    volumeMounts:
      - name: "test-volume"
        mountPath: "/tmp"
  executor:
    cores: 1
    instances: 1
    memory: "512m"
    labels:
      version: 2.4.0
    volumeMounts:
      - name: "test-volume"
        mountPath: "/tmp"
Laten we de beschreven taak starten met sparkctl:
sparkctl create spark-app.yaml -n {project}
Laten we de lijst met actieve Spark-taken bekijken:
sparkctl list -n {project}
Laten we de lijst met gebeurtenissen van de actieve Spark-taak bekijken:
sparkctl event spark-pi -n {project} -f
Laten we de status van de actieve Spark-taak bekijken:
sparkctl status spark-pi -n {project}
Tot slot willen we de ontdekt nadelen van de huidige stabiele versie van Spark (2.4.5) in Kubernetes bespreken:
- Het eerste en misschien wel grootste nadeel is het gebrek aan Data Locality. Ondanks de tekortkomingen had YARN ook voordelen, zoals het principe van het leveren van code naar de data (en niet andersom). Hierdoor werden Spark-taken uitgevoerd op de knooppunten waar de gegevens zich bevonden die betrokken waren bij de berekeningen, en dit verminderde de tijd die nodig was om gegevens via het netwerk te verzenden aanzienlijk. Bij het gebruik van Kubernetes stuiten we op de noodzaak om gegevens die betrokken zijn bij de taak via het netwerk te verplaatsen. Als deze groot genoeg zijn, kan de uitvoeringstijd van de taak aanzienlijk toenemen, evenals de hoeveelheid schijfruimte die aan Spark-instanties moet worden toegewezen voor tijdelijke opslag. Dit nadeel kan worden verminderd door gespecialiseerde softwaretools te gebruiken die data localiteit in Kubernetes garanderen (bijvoorbeeld Alluxio), maar dit betekent feitelijk dat er een volledige kopie van de gegevens op de Kubernetes-clusters moet worden opgeslagen.
- Het tweede belangrijke nadeel is de beveiliging. Standaard zijn functies met betrekking tot de beveiliging van het uitvoeren van Spark-taken uitgeschakeld. Het gebruik van Kerberos wordt in de officiële documentatie niet behandeld (hoewel de relevante parameters zijn toegevoegd in versie 3.0.0, wat extra aandacht vereist). In de documentatie over beveiliging bij het gebruik van Spark (https://spark.apache.org/docs/2.4.5/security.html) worden alleen YARN, Mesos en Standalone Cluster als opslagplaatsen voor sleutels genoemd. Bovendien kan de gebruiker waaronder de Spark-taken worden uitgevoerd niet direct worden opgegeven; we stellen alleen een service-account in onder welke deze zal werken, en de gebruiker wordt geselecteerd op basis van de ingestelde beveiligingsbeleid. Hierom wordt ofwel de root-gebruiker gebruikt, wat niet veilig is in een productieomgeving, of een gebruiker met een willekeurige UID, wat ongemakkelijk is bij het toewijzen van toegangsrechten tot gegevens (opgelost door PodSecurityPolicies te creëren en deze te koppelen aan de betreffende service-accounts). Op dit moment wordt het probleem opgelost door alle benodigde bestanden direct in de Docker-image op te nemen of het opstartscript van Spark te wijzigen om het mechanisme voor het opslaan en ophalen van geheimen te gebruiken dat binnen uw organisatie is aangenomen.
- Het starten van Spark-taken met behulp van Kubernetes is nog steeds officieel in experimentele fase en in de toekomst zijn er mogelijk aanzienlijke wijzigingen in de gebruikte artefacten (configuratiebestanden, Docker-images en startscripts). En inderdaad – bij de voorbereiding van het materiaal werden de versies 2.3.0 en 2.4.5 getest, en het gedrag verschild aanzienlijk.
We wachten op updates – recent is er een nieuwe versie van Spark (3.0.0) uitgebracht, die betekenisvolle wijzigingen in de werking van Spark op Kubernetes heeft gebracht, maar die de experimentele status van de ondersteuning voor deze resource manager heeft behouden. Mogelijk zullen de volgende updates echt de mogelijkheid bieden om volledig aan te bevelen om YARN los te laten en Spark-taken op Kubernetes uit te voeren, zonder je zorgen te maken over de veiligheid van jouw systeem en zonder de noodzaak om functionele componenten zelf aan te passen.
Einde.
Bron: habr.com
