

De CAP-theorema is de hoeksteen van de theorie van gedistribueerde systemen. Natuurlijk zwellen de discussies hierover aan: de definities zijn niet canoniek en er is geen strikt bewijs… Toch, vaststaand in de positie van alledaagse gezond verstand™, begrijpen we intuïtief dat de stelling waar is.
Het enige wat niet duidelijk is, is de betekenis van de letter "P". Wanneer een cluster wordt gesplitst, beslist het of het niet zal reageren totdat er een quorum is bereikt, of dat het de gegevens die er zijn zal geven. Afhankelijk van de uitkomsten van deze keuze wordt het systeem geclassificeerd als ofwel CP ofwel AP. Cassandra kan bijvoorbeeld zowel het een als het ander doen, afhankelijk van de parameters van elk specifiek verzoek, niet alleen van de clusterinstellingen. Maar als het systeem niet "P" is en het is gesplitst, wat dan?
Het antwoord op deze vraag is enigszins onverwacht: een CA-cluster kan niet splitsen.
Wat voor cluster is dit dat niet kan splitsen?
Een essentieel kenmerk van zo'n cluster is een gemeenschappelijk datasysteem. In de overgrote meerderheid van de gevallen betekent dit aansluiting via SAN, wat het gebruik van CA-oplossingen beperkt tot grote bedrijven die een SAN-infrastructuur kunnen onderhouden. Om ervoor te zorgen dat meerdere servers met dezelfde gegevens kunnen werken, is een clusterbestandsysteem noodzakelijk. Dergelijke bestanden systemen zijn beschikbaar in de portefeuilles van HPE (CFS), Veritas (VxCFS) en IBM (GPFS).
Oracle RAC
De optie Real Application Cluster verscheen voor het eerst in 2001 in de release van Oracle 9i. In zo'n cluster werken meerdere instanties de server met dezelfde database.
Oracle kan zowel met een clusterbestandsysteem als met zijn eigen oplossing werken – ASM, Automatic Storage Management.
Elke instantie houdt zijn eigen logboek bij. Een transactie wordt uitgevoerd en vastgelegd door één instantie. In geval van een storing leest een van de overlevende knooppunten van het cluster (instanties) zijn logboek en herstelt de verloren gegevens – hierdoor wordt de beschikbaarheid gegarandeerd.
Alle instanties hebben hun eigen cache, en dezelfde pagina's (blokken) kunnen tegelijkertijd in de caches van meerdere instanties aanwezig zijn. Bovendien, als een bepaalde pagina nodig is voor één instantie en deze in de cache van een andere instantie aanwezig is, kan deze deze van de "buur" verkrijgen via een mechanisme genaamd cache fusion in plaats van vanaf de schijf te lezen.
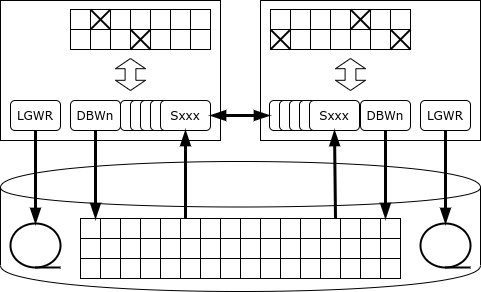
Maar wat gebeurt er als een van de instanties gegevens moet wijzigen?
Een kenmerk van Oracle is dat het geen aparte blokkeringsdienst heeft: als de server een rij wil blokkeren, wordt de blokkering rechtstreeks op die pagina in het geheugen geplaatst waar de geblokkeerde rij zich bevindt. Dankzij deze aanpak is Oracle de kampioen qua prestaties onder monolithische databases: de blokkeringsservice wordt nooit een bottleneck. Maar in een clusterconfiguratie kan deze architectuur leiden tot intensieve netwerkcommunicatie en wederzijdse blokkeringen.
Zodra een vermelding geblokkeerd is, stelt de instantie alle andere instanties op de hoogte dat de pagina waarin deze vermelding is opgeslagen, in de monopolmodus is vergrendeld. Als een andere instantie de vermelding op dezelfde pagina moet wijzigen, moet deze wachten totdat de wijzigingen op de pagina zijn vastgelegd, dat wil zeggen, de informatie over de wijziging is geschreven naar het log op de schijf (terwijl de transactie kan doorgaan). Het kan ook voorkomen dat de pagina achtereenvolgens door verschillende instanties wordt gewijzigd, en dan moet bij het schrijven van de pagina naar de schijf worden vastgesteld wie de actuele versie van deze pagina heeft.
Toevallige updates van dezelfde pagina's via verschillende RAC-knopen leiden tot een aanzienlijke daling van de databaseprestaties - tot het punt dat de prestaties van het cluster lager kunnen zijn dan die van een enkele instantie.
Correct gebruik van Oracle RAC is de fysieke scheiding van gegevens (bijvoorbeeld door middel van een mechanisme voor gepartitioneerde tabellen) en toegang tot elke reeks secties via een toegewezen knoop. Het belangrijkste doel van RAC is niet horizontale schaling, maar het waarborgen van de fouttolerantie.
Als een knoop niet meer reageert op de heartbeat, start de knoop die dit als eerste opmerkt een stemprocedure op de schijf. Als ook hier de verloren knoop zich niet meldt, neemt een van de knopen de verantwoordelijkheden voor het herstel van de gegevens over:
- «bevriest» alle pagina's die in de cache van de verloren knoop waren;
- leest de logs (redo) van de verloren knoop en past de wijzigingen die in deze logs zijn vastgelegd opnieuw toe, terwijl ook wordt gecontroleerd of andere knopen geen recentere versies van de gewijzigde pagina's hebben.
- het draait onvoltooide transacties terug.
Om de overschakeling tussen knooppunten te vergemakkelijken, introduceert Oracle het concept van een service - een virtueel exemplaar. Een exemplaar kan meerdere services bedienen en een service kan tussen knooppunten verhuizen. Een applicatie-exemplaar dat een bepaald deel van de database bedient (bijvoorbeeld een groep klanten) werkt met één service, en de service die verantwoordelijk is voor dit deel van de database verhuist naar een ander knooppunt wanneer een knooppunt uitvalt.
IBM Pure Data Systems for Transactions
De clusteroplossing voor databases kwam in 2009 in het portfolio van de Blauwe Reus. Ideologisch gezien is het een opvolger van de parallelle Sysplex-cluster, gebouwd op 'normale' hardware. In 2009 werd het product DB2 pureScale gelanceerd, dat een softwarepakket vertegenwoordigt, en in 2012 biedt IBM een software-hardwarepakket (appliance) aan dat Pure Data Systems for Transactions heet. Dit moet niet worden verward met Pure Data Systems for Analytics, dat niets anders is dan een hernoeming van Netezza.
De pureScale-architectuur lijkt op het eerste gezicht op Oracle RAC: op dezelfde manier zijn meerdere knooppunten aangesloten op een gemeenschappelijk gegevensopslagsysteem, en op elk knooppunt draait zijn eigen exemplaar van de database met zijn eigen geheugen en transactielogs. Maar in tegenstelling tot Oracle heeft DB2 een speciale vergrendelservice, vertegenwoordigd door een set processen db2LLM*. In een clusterconfiguratie wordt deze service op een afzonderlijk knooppunt geplaatst, dat in Parallel Sysplex een coupling facility (CF) wordt genoemd, en in Pure Data - PowerHA.
PowerHA biedt de volgende services:
- vergrendelmanager;
- globale buffer cache;
- gebied voor interprocesscommunicatie.
Voor het verzenden van gegevens van PowerHA naar de databaseknooppunten en terug wordt er gebruik gemaakt van remote memory access, daarom moet de clusterinterconnect het RDMA-protocol ondersteunen. PureScale kan zowel Infiniband als RDMA over Ethernet gebruiken.
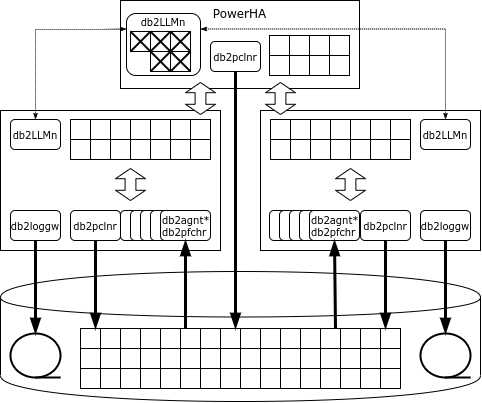
Als een knooppunt een pagina nodig heeft en deze niet in de cache staat, vraagt het knooppunt de pagina aan in de global cache, en enkel als het daar ook niet staat, leest het deze van de schijf. In tegenstelling tot Oracle gaat de aanvraag alleen naar PowerHA, en niet naar aangrenzende knooppunten.
Als een instantie van plan is om een rij te wijzigen, vergrendelt deze deze in exclusieve modus en de pagina waarop de rij zich bevindt in gedeelde modus. Alle vergrendelingen worden geregistreerd in de globale vergrendelmanager. Wanneer de transactie is voltooid, stuurt de knooppunt een bericht naar de vergrendelmanager, die de gewijzigde pagina naar de globale cache kopieert, de vergrendelingen opheft en de gewijzigde pagina in de caches van andere knooppunten ongeldig maakt.
Als de pagina waarop de wijzigbare rij zich bevindt al is vergrendeld, leest de vergrendelmanager de gewijzigde pagina uit het geheugen van het knooppunt dat de wijzigingen heeft aangebracht, heft de vergrendeling op, maakt de gewijzigde pagina in de caches van andere knooppunten ongeldig en geeft de vergrendeling van de pagina terug aan het knooppunt dat deze heeft aangevraagd.
"Vervuilde", dat wil zeggen gewijzigde, pagina's kunnen zowel vanaf een reguliere knooppunt als vanaf PowerHA (castout) op de schijf worden geschreven.
Bij uitval van een van de knooppunten is de herstel mogelijkheid beperkt tot alleen die transacties die op het moment van de storing nog niet waren voltooid: pagina's die door dit knooppunt in voltooide transacties zijn gewijzigd, bevinden zich in de globale cache op PowerHA. Het knooppunt wordt opnieuw opgestart in een beperkte configuratie op een van de servers van het cluster, rolt onvoltooide transacties terug en maakt vergrendelingen vrij.
PowerHA werkt op twee servers, en het primaire knooppunt replicateert zijn status synchroon. Bij uitval van het primaire knooppunt blijft het PowerHA-cluster werken met het reserve knooppunt.
Natuurlijk, als men toegang heeft tot een dataset via één knooppunt, zal de algehele prestaties van het cluster beter zijn. PureScale kan zelfs opmerken dat een bepaald gebied van gegevens door één knooppunt wordt verwerkt, en dan worden alle vergrendelingen die betrekking hebben op dit gebied lokaal door het knooppunt afgehandeld zonder communicatie met PowerHA. Maar zodra de applicatie probeert toegang te krijgen tot deze gegevens via een ander knooppunt, zal de gecentraliseerde verwerking van vergrendelingen worden hervat.
Interne belastingstests van IBM, bestaande uit 90% lezen en 10% schrijven, wat zeer lijkt op echte industriële belasting, tonen bijna lineaire schaalvergroting tot 128 knooppunten. De testomstandigheden worden helaas niet openbaar gemaakt.
HPE NonStop SQL
Hewlett-Packard Enterprise heeft ook zijn eigen hoogbeschikbare platform. Dit is het NonStop-platform, dat in 1976 op de markt werd gebracht door Tandem Computers. In 1997 werd het bedrijf overgenomen door Compaq, dat op zijn beurt in 2002 opging in Hewlett-Packard.
NonStop wordt gebruikt voor het bouwen van kritische toepassingen, zoals HLR of bankkaartenverwerking. Het platform wordt geleverd als een software-hardwarepakket (appliance), dat rekenknooppunten, opslag- en communicatieapparatuur omvat. Het ServerNet-netwerk (in moderne systemen - Infiniband) dient zowel voor de uitwisseling tussen knooppunten als voor toegang tot de opslagapparatuur.
In vroegere versies van het systeem werden proprietaire processors gebruikt die met elkaar gesynchroniseerd waren: alle bewerkingen werden synchroon uitgevoerd door meerdere processors, en zodra een van de processors fouten maakte, werd deze uitgeschakeld terwijl de andere bleef werken. Later schakelde het systeem over op reguliere processors (eerder MIPS, daarna Itanium en uiteindelijk x86), en werden andere mechanismen voor synchronisatie gebruikt:
- berichten: elke systeemproces heeft een dubbele 'schaduw', aan wie het actieve proces periodiek berichten over zijn status verstuurt; bij een storing van het hoofdproces begint het schaduwproces te werken vanaf het punt dat in het laatste bericht is gedefinieerd;
- stemmen: het opslag systeem heeft een speciale hardwarecomponent die meerdere identieke aanvragen ontvangt en deze alleen uitvoert als de aanvragen overeenkomen; in plaats van fysieke synchronisatie werken de processors asynchroon, en de resultaten van hun werk worden alleen vergeleken op momenten van invoer/uitvoer.
Sinds 1987 draait er een relationele DBMS op het NonStop-platform - eerst SQL/MP en later SQL/MX.
De hele database is verdeeld in delen, en elke deel wordt beheerd door zijn eigen Data Access Manager (DAM). Deze zorgt voor het schrijven van gegevens, caching en een mechanisme voor het vergrendelen. De gegevensverwerking wordt uitgevoerd door uitvoeringsprocessen (Executor Server Process), die draaien op dezelfde knooppunten als de bijbehorende gegevensmanagers. De SQL/MX planner verdeelt de taken tussen de uitvoerders en voegt de resultaten samen. Voor het aanbrengen van coherente wijzigingen wordt een tweefasige commit-protocol gebruikt, dat wordt ondersteund door de TMF (Transaction Management Facility) bibliotheek.
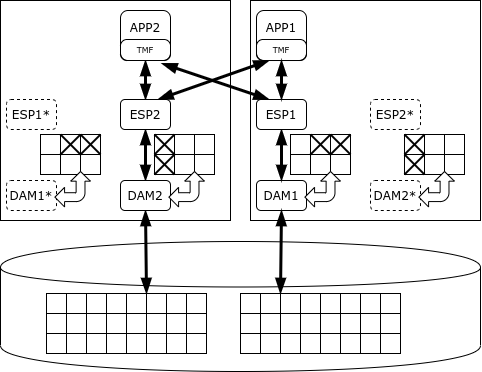
NonStop SQL kan processen prioriteren zodat lange analytische queries de uitvoering van transacties niet verstoren. Het is echter bedoeld voor de verwerking van korte transacties, en niet voor analyse. De ontwikkelaar garandeert de beschikbaarheid van het NonStop-cluster op een niveau van vijf 'nines', wat betekent dat de downtime slechts 5 minuten per jaar bedraagt.
SAP HANA
De eerste stabiele release van de HANA-database (1.0) vond plaats in november 2010, en het SAP ERP-pakket is in mei 2013 overgestapt naar HANA. Het platform is gebaseerd op aangekochte technologieën: TREX Search Engine (voor zoeken in een kolomopslag), de P*TIME-database en MAX DB.
Het woord 'HANA' is een acroniem voor High performance ANalytical Appliance. Deze database wordt geleverd als code die op elke x86-server kan draaien, maar industriële installaties zijn alleen toegestaan op hardware die gecertificeerd is. Er zijn oplossingen van HP, Lenovo, Cisco, Dell, Fujitsu, Hitachi en NEC. Bepaalde configuraties van Lenovo staan zelfs exploitatie zonder SAN toe; de rol van een gedeelde opslagomgeving wordt vervuld door de GPFS-cluster op lokale schijven.
In tegenstelling tot de hierboven genoemde platforms is HANA een in-memory database, wat betekent dat de primaire gegevensrepresentatie in het RAM wordt opgeslagen, terwijl alleen de logboeken en periodieke snapshots op de schijf worden geschreven - voor herstel in geval van een storing.
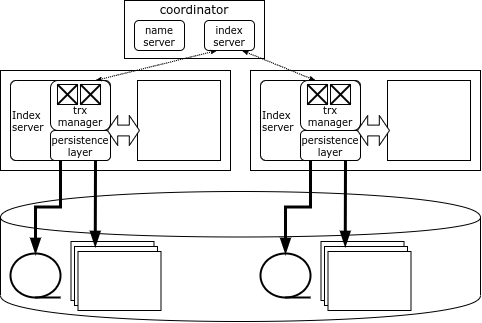
Elke knoop van het HANA-cluster is verantwoordelijk voor zijn eigen gegevensdeel, en de gegevenskaart wordt opgeslagen in een speciaal component - de Name Server, die zich op de coördinatorknoop bevindt. Gegevens worden niet gedupliceerd tussen knopen. Informatie over vergrendelingen wordt ook op elke knoop opgeslagen, maar er is een globale deadlock-detector in het systeem.
De HANA-client laadt de topologie van het cluster bij het verbinden en kan vervolgens rechtstreeks communiceren met elke knoop, afhankelijk van de benodigde gegevens. Als een transactie betrekking heeft op de gegevens van een enkele knoop, kan deze lokaal door die knoop worden uitgevoerd. Maar als er gegevens van meerdere knopen worden gewijzigd, wendt de initiërende knoop zich tot de coördinatorknoop, die de gedistribueerde transactie opent en coördineert, en deze vastlegt met behulp van een geoptimaliseerd protocol voor twee-fasen bevestiging.
De coördinatorknoop is gedupliceerd, zodat bij uitval van de coördinator een reserveknop onmiddellijk in werking treedt. Als echter een knoop met gegevens uitvalt, is de enige manier om toegang te krijgen tot die gegevens door de knoop opnieuw op te starten. Gewoonlijk wordt er in HANA-clusters een reserve (spare) server gehouden om de verloren knoop zo snel mogelijk opnieuw op te starten.
Bron: habr.com
